
Andersons vinkel
AI-assistert objektredigering med Googles Imagic og Runways Erase and Replace

 Legg til Unite.AI blant dine foretrukne kilder på Google

Viktige punkterImagic finjusterer diffusjonsmodeller for detaljerte objektreduigeringer, i motsetning…
Vis mer
- Imagic finjusterer diffusjonsmodeller for detaljerte objektreduigeringer, i motsetning til Runways Erase and Replace, som bare erstatter.
- Runways Erase and Replace erstatter objekter raskt, men kan ikke redigere eksisterende innhold, bare erstatte det.
- Imagics per-bilde-optimalisering tar åtte minutter på to TPUV4-brikker, noe som begrenser den til API-bruk.
Denne uken byr to nye, men ulike, AI-drevne grafikkalgoritmer på nye måter for sluttbrukere å gjøre svært presise og effektive endringer av objekter i bilder.
Den første er Imagic fra Google Research, utviklet i samarbeid med Israel Institute of Technology og Weizmann Institute of Science. Imagic tilbyr tekststyrt, detaljert redigering av objekter ved hjelp av finjustering av diffusjonsmodeller.

Endre det du vil, og la resten være – Imagic lover presis redigering av bare de delene du ønsker å endre. Kilde: https://arxiv.org/pdf/2210.09276.pdf
Alle som noen gang har prøvd å endre bare ett element i en nygenerering med Stable Diffusion, vet altfor godt at systemet endrer fem ting du likte akkurat slik de var, for hver vellykkede redigering. Denne svakheten gjør at mange av de dyktigste SD-entusiastene stadig veksler mellom Stable Diffusion og Photoshop for å rette opp slike «følgeskader». Bare ut fra dette perspektivet virker Imagic-resultatene bemerkelsesverdige.
Da dette skrives, har Imagic ennå ikke engang en introduksjonsvideo, og med tanke på Googles varsomme holdning til å lansere verktøy for ubegrenset bildesyntese er det usikkert om, og i hvilken grad, vi får mulighet til å teste systemet.
Det andre tilbudet er den langt mer tilgjengelige funksjonen Erase and Replace fra Runway ML, en ny funksjon i delen «AI Magic Tools» i selskapets utelukkende nettbaserte pakke med verktøy for visuelle effekter basert på maskinlæring.
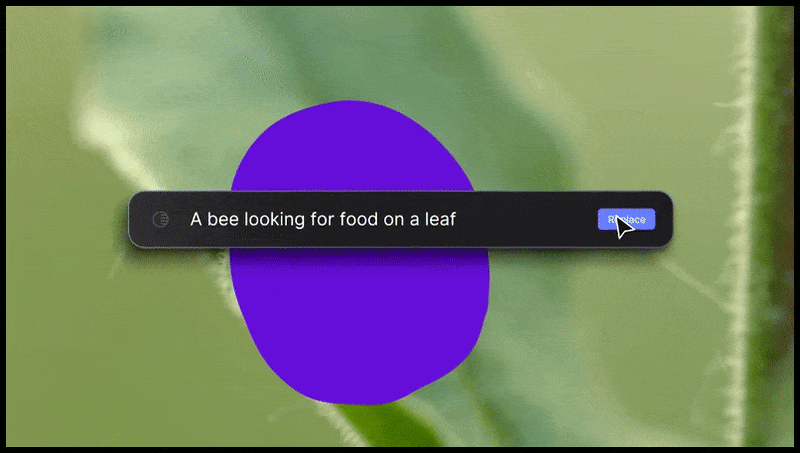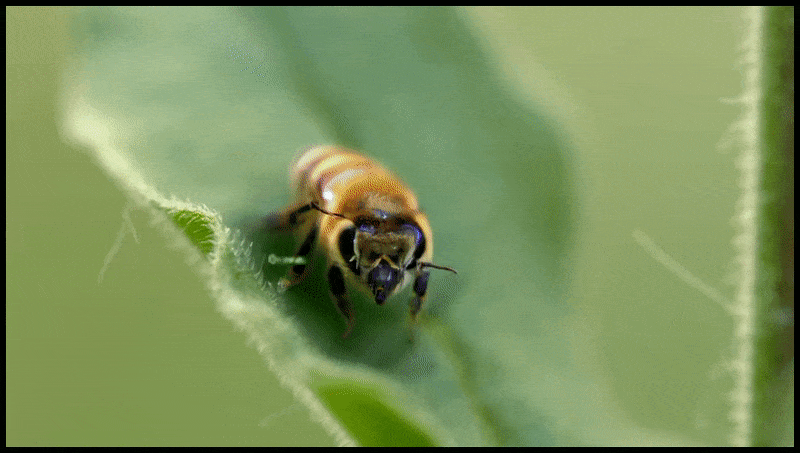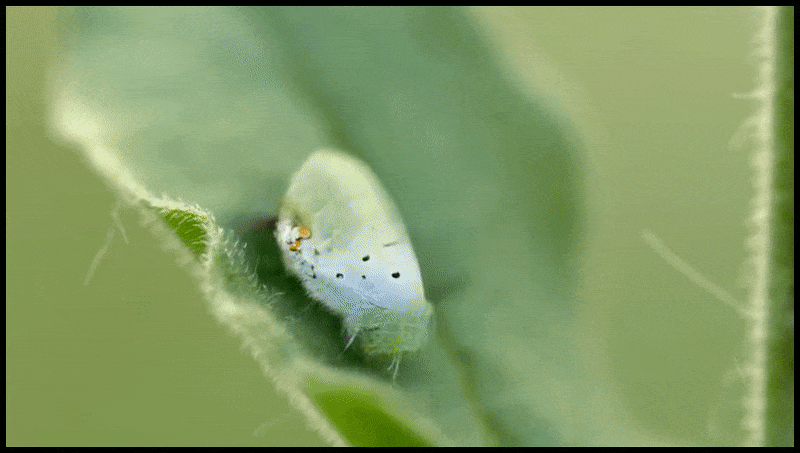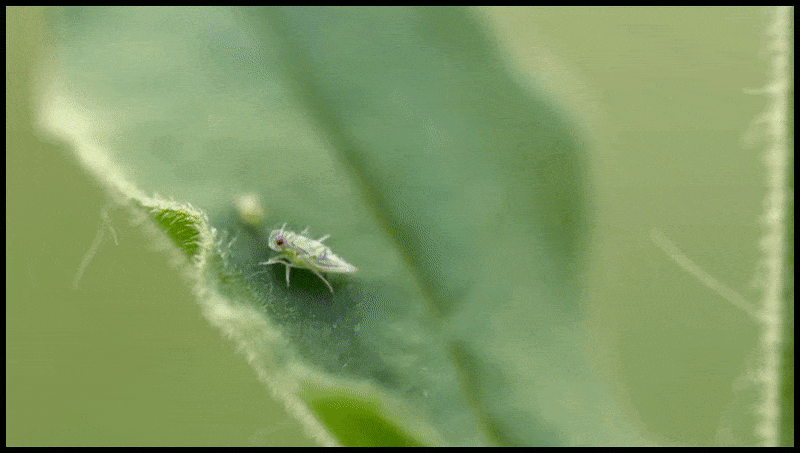
Runway MLs Erase and Replace-funksjon, som allerede er vist i en forhåndsvisning av et redigeringssystem for tekst-til-video.
La oss først se nærmere på Runways løsning.
Erase and Replace
I likhet med Imagic håndterer Erase and Replace bare stillbilder, selv om Runway har forhåndsvist den samme funksjonaliteten i en løsning for redigering av tekst-til-video som ennå ikke er lansert:
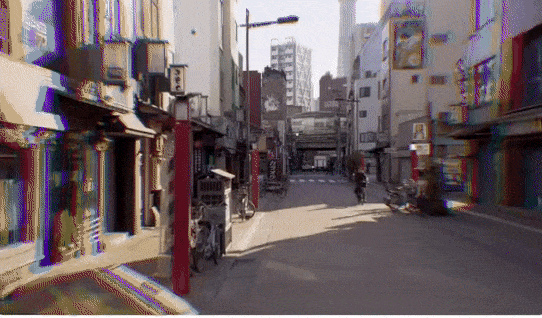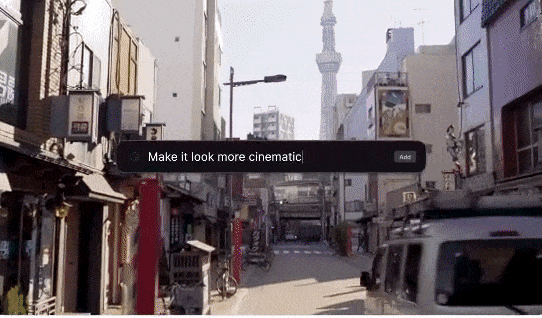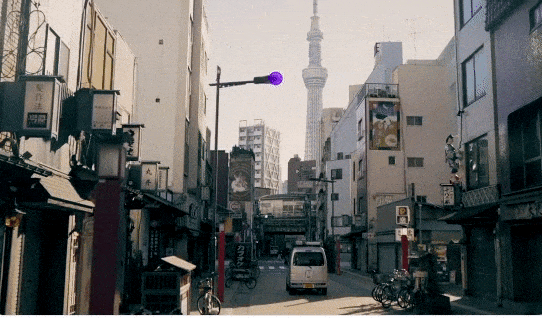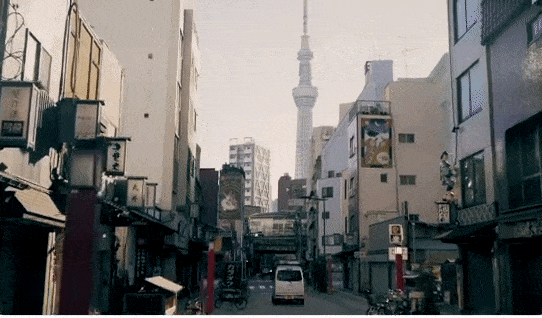
Alle kan prøve den nye Erase and Replace på bilder, men videoversjonen er ennå ikke offentlig tilgjengelig. Kilde: https://twitter.com/runwayml/status/1568220303808991232
Runway ML har ikke offentliggjort detaljer om teknologien bak Erase and Replace, men hastigheten det tar å bytte ut en potteplante med en nokså overbevisende byste av Ronald Reagan, tyder på at en diffusjonsmodell som Stable Diffusion (eller, langt mindre sannsynlig, en DALL-E 2 som er lisensiert ut) står bak og finner opp objektet du velger i Erase and Replace.

Det går ikke fullt så raskt å bytte ut en potteplante med en byste av The Gipper, men det går ganske fort. Kilde: https://app.runwayml.com/
Systemet har enkelte begrensninger av samme type som DALL-E 2: Bilder eller tekst som utløser filtrene i Erase and Replace, fører til en advarsel om mulig suspensjon av kontoen ved nye brudd – i praksis en nærmest ordrett kopi av OpenAIs gjeldende retningslinjer for DALL-E 2.
Mange av resultatene har ikke de typiske skavankene til Stable Diffusion. Runway ML er investorer og forskningspartnere innen SD, og det er mulig at de har trent en proprietær modell som er bedre enn de åpne modellvektene i sjekkpunkt 1.4, som resten av oss nå strever med (samtidig trener eller finjusterer mange andre utviklingsgrupper, både amatører og profesjonelle, Stable Diffusion-modeller).
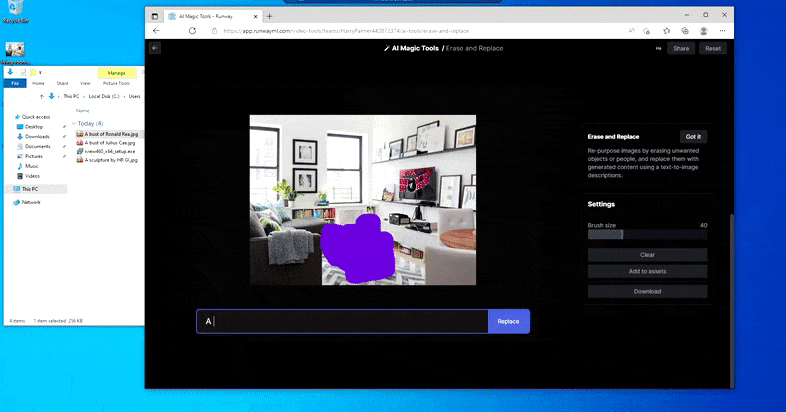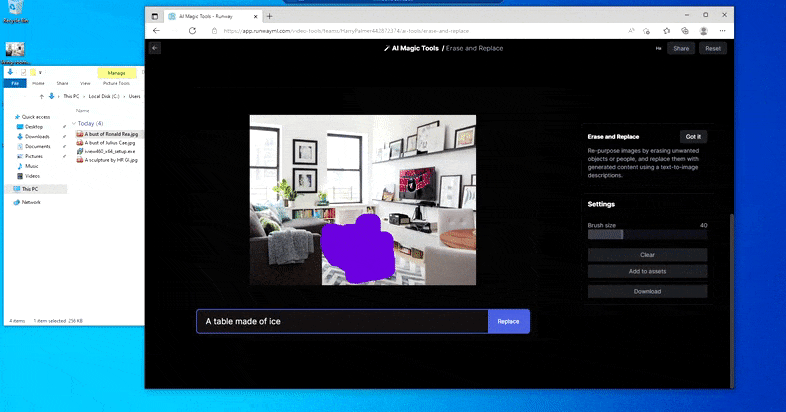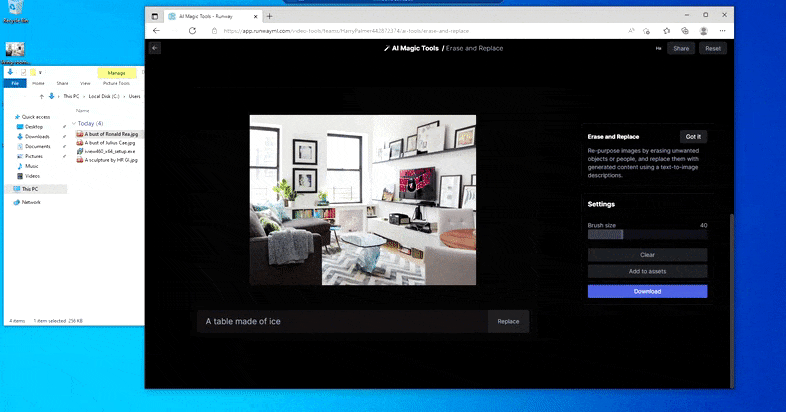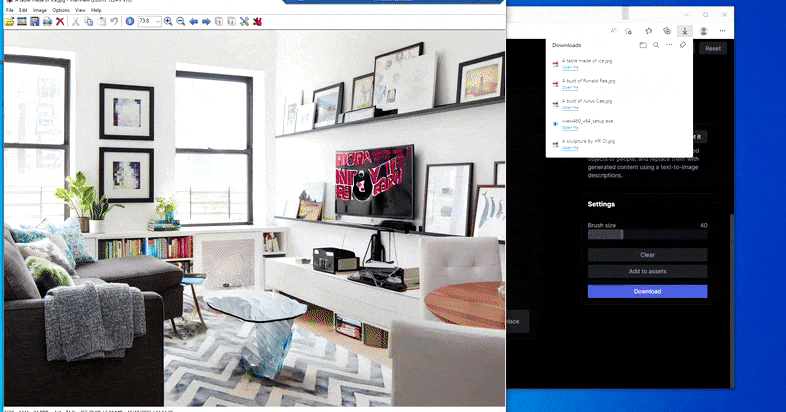
Et vanlig bord byttes ut med et «bord laget av is» i Runway MLs Erase and Replace.
I likhet med Imagic (se nedenfor) er Erase and Replace «objektorientert», så å si – du kan ikke bare viske ut en «tom» del av bildet og male den inn med resultatet av tekstprompten. I en slik situasjon vil systemet ganske enkelt følge konturen til det nærmeste synlige objektet langs maskens siktlinje (for eksempel en vegg eller en TV) og bruke transformasjonen der.
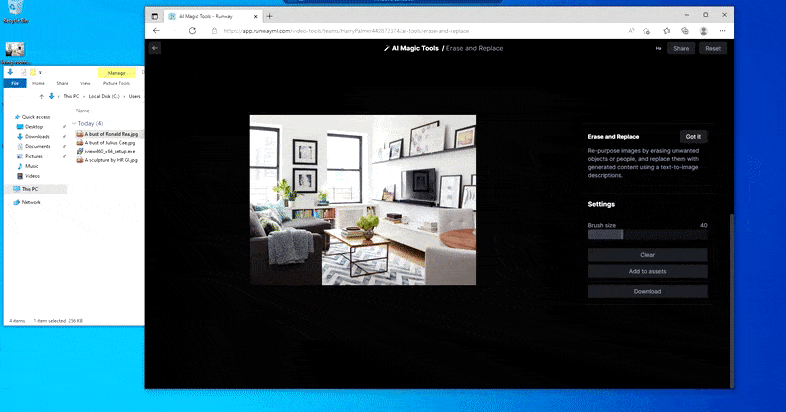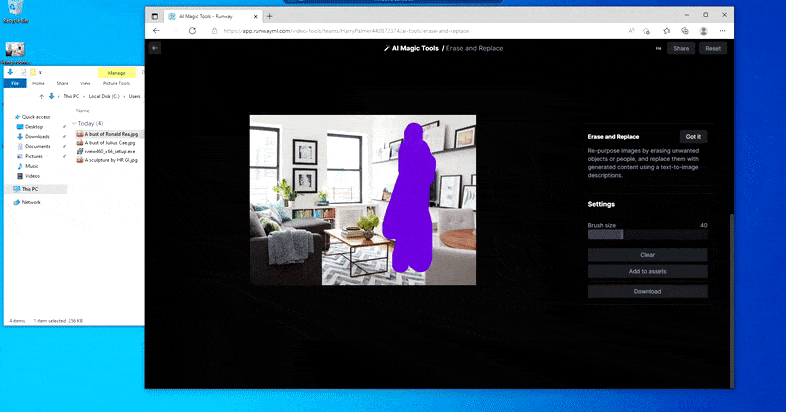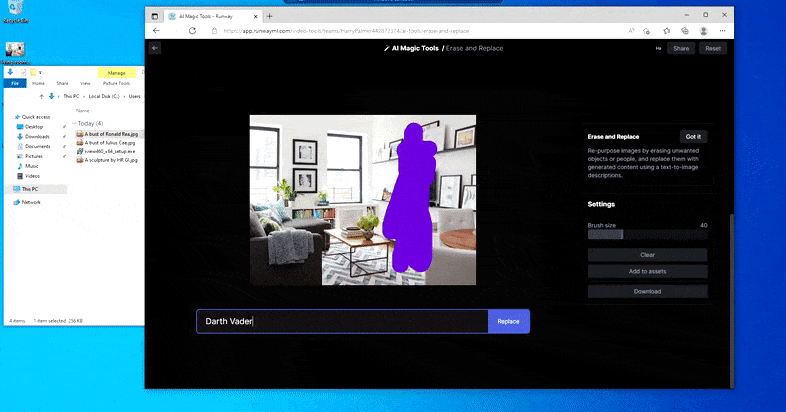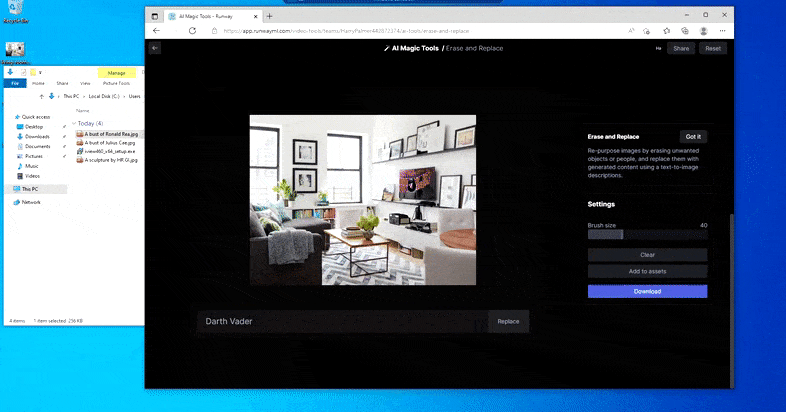
Som navnet tilsier, kan du ikke sette inn objekter i tomrom med Erase and Replace. Her fører et forsøk på å hente fram den mest berømte av Sith-herrene til et merkelig Vader-relatert veggmaleri på TV-en, omtrent der «erstatningsområdet» ble tegnet.
Det er vanskelig å si om Erase and Replace unngår å bruke opphavsrettsbeskyttede bilder (som fortsatt i stor grad blokkeres i DALL-E 2, om enn med varierende hell), eller om modellen som brukes i gjengivelsesmotoren i bakgrunnen, rett og slett ikke er optimalisert for den typen oppgaver.

Det litt upassende «veggmaleriet av Nicole Kidman» tyder på at diffusjonsmodellen det er snakk om (antakelig) mangler DALL-E 2s tidligere systematiske avvisning av å gjengi realistiske ansikter eller vågalt innhold. Resultatene av forsøk på å fremkalle opphavsrettsbeskyttede verk spenner fra det tvetydige («xenomorph») til det absurde («jerntronen»). Kildebildet er innfelt nederst til høyre.
Det ville vært interessant å vite hvilke metoder Erase and Replace bruker for å isolere objektene som systemet kan erstatte. Bildet kjøres antakelig gjennom en variant av CLIP, der enkeltobjektene identifiseres ved hjelp av objektgjenkjenning og deretter segmenteres semantisk. Ingen av disse operasjonene fungerer på langt nær like godt i en vanlig standardinstallasjon av Stable Diffusion.
Men ingenting er perfekt – noen ganger ser det ut til at systemet visker ut uten å erstatte, selv når (som vi har sett på bildet ovenfor) den underliggende gjengivelsesmekanismen utvilsomt forstår hva en tekstprompt betyr. I dette tilfellet viser det seg umulig å gjøre et sofabord om til en xenomorph – bordet bare forsvinner.
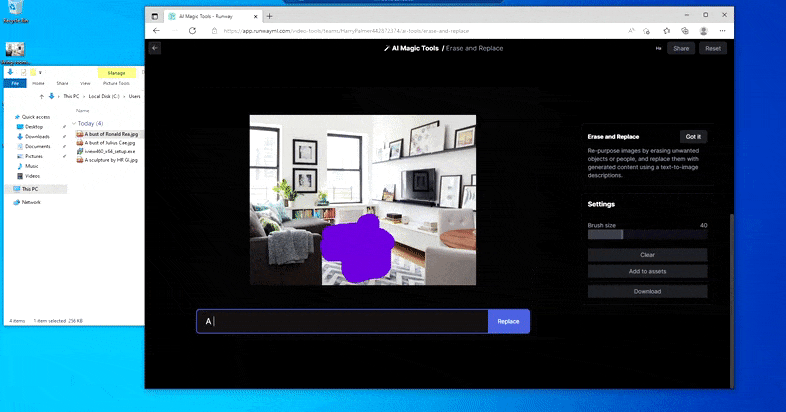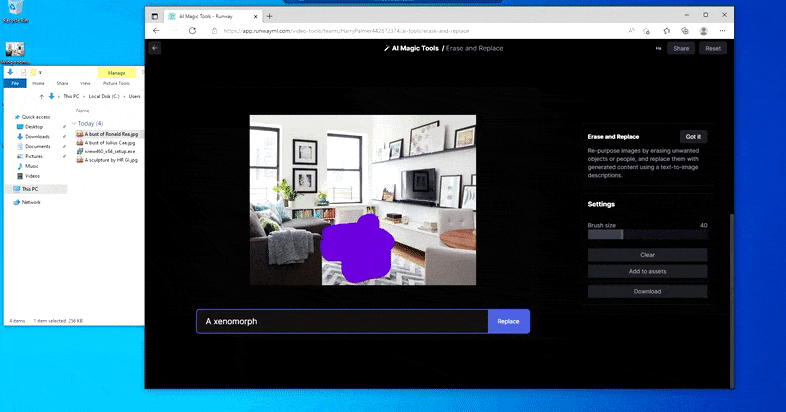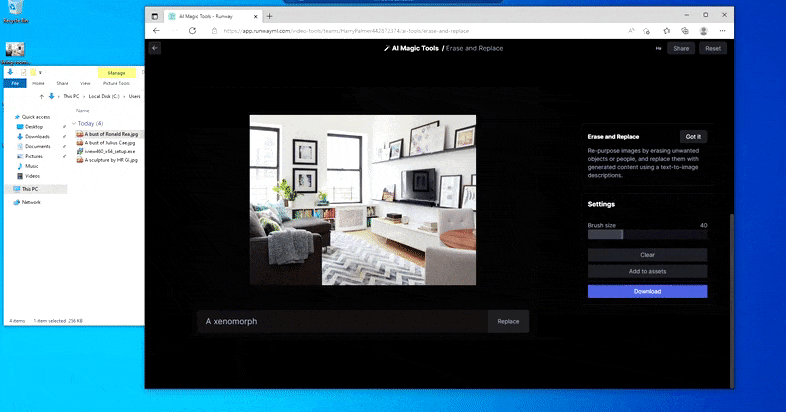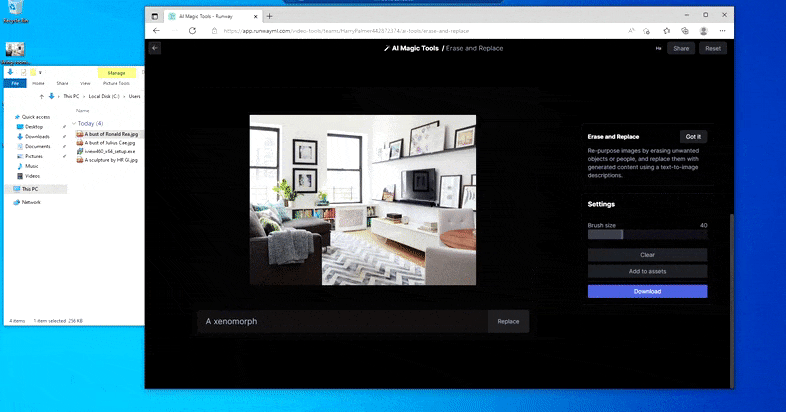
En skumlere variant av «Where’s Waldo», ettersom Erase and Replace ikke klarer å lage et romvesen.
Erase and Replace ser ut til å være et effektivt system for å erstatte objekter, med svært god bildeinnfylling. Det kan imidlertid ikke redigere objekter det allerede har identifisert, bare erstatte dem. Å endre eksisterende bildeinnhold uten å påvirke omgivelsene er sannsynligvis en langt vanskeligere oppgave, og henger sammen med datasynsforskningens langvarige forsøk på å oppnå frikobling i de ulike latente rommene i de populære rammeverkene.
Imagic
Det er en oppgave Imagic tar sikte på å løse. Den nye forskningsartikkelen viser en rekke eksempler på redigeringer som endrer enkelte aspekter ved et foto, samtidig som resten av bildet forblir urørt.

I Imagic har de endrede bildene ikke den karakteristiske strekkingen, forvrengningen og «gjettingen» av tildekte områder som kjennetegner deepfake-puppeteering, der man bruker begrensede forhåndsantakelser utledet fra ett enkelt bilde.
Systemet bruker en prosess i tre trinn: optimalisering av tekstembeddingen, finjustering av modellen og til slutt generering av det endrede bildet.

Imagic koder måltekstprompten for å hente ut den innledende tekstembeddingen og optimaliserer deretter resultatet for å gjenskape inndatabildet. Deretter finjusteres den generative modellen med utgangspunkt i kildebildet, og en rekke parametere legges til før modellen brukes til den ønskede interpoleringen.
Det er ikke overraskende at rammeverket bygger på Googles Imagen-arkitektur for tekst-til-video, selv om forskerne opplyser at prinsippene bak systemet kan brukes i vidt omfang på latente diffusjonsmodeller.
Imagen har en arkitektur i tre trinn, i motsetning til oppsettet med sju trinn i selskapets nyere tekst-til-video-versjon av programvaren. De tre modulene består av en generativ diffusjonsmodell som arbeider med en oppløsning på 64x64px, en superoppløsningsmodell som oppskalerer dette resultatet til 256x256px, og enda en superoppløsningsmodell som øker oppløsningen helt opp til 1024×1024.
Imagic griper inn på det tidligste trinnet i denne prosessen og optimaliserer den ønskede tekstembeddingen på 64px-trinnet med Adam-optimalisering og en fast læringsrate på 0.0001.

Et mesterstykke i frikobling: Sluttbrukere som har forsøkt å endre noe så enkelt som fargen på et gjengitt objekt i en diffusjons-, GAN- eller NeRF-modell, vet hvor betydningsfullt det er at Imagic kan utføre slike endringer uten å «rive i stykker» sammenhengen i resten av bildet.
Finjusteringen utføres deretter på Imagen-basismodellen, med 1500 trinn per inndatabilde, basert på den reviderte embeddingen. Samtidig optimaliseres det sekundære laget på 64px>256px parallelt med det betingede bildet. Forskerne påpeker at en tilsvarende optimalisering av det siste laget på 256px>1024px har «liten eller ingen effekt» på sluttresultatene, og har derfor ikke implementert den.
Artikkelen oppgir at optimaliseringsprosessen tar omtrent åtte minutter for hvert bilde på to TPUV4-brikker. Den endelige gjengivelsen utføres i Imagen-kjernen med DDIM-samplingsmetoden.
I likhet med tilsvarende finjusteringsprosesser for Googles DreamBooth kan de resulterende embeddingene også brukes til stilisering, samt til fotorealistiske redigeringer som inneholder informasjon fra den bredere underliggende databasen som driver Imagen (for, som den første kolonnen nedenfor viser, inneholder ikke kildebildene noe av det nødvendige innholdet for å gjennomføre disse transformasjonene).

Med Imagic kan man få fram fleksible, fotorealistiske bevegelser og redigeringer, mens de utledede og frikoblede kodene som oppnås i prosessen, like gjerne kan brukes til stiliserte resultater.
Forskerne sammenlignet Imagic med tidligere arbeider: SDEdit, en GAN-basert metode fra 2021 utviklet i samarbeid mellom Stanford University og Carnegie Mellon University, og Text2Live, et samarbeid fra april 2022 mellom Weizmann Institute of Science og NVIDIA.

En visuell sammenligning av Imagic, SDEdit og Text2Live.
Det er tydelig at de førstnevnte metodene sliter, men i nederste rad, der posituren endres dramatisk, klarer de etablerte metodene ikke i det hele tatt å omforme kildematerialet, i motsetning til Imagic, som lykkes bemerkelsesverdig godt.
Imagic krever mye ressurser og har lang treningstid per bilde, selv om dette er lite sammenlignet med hva slike prosesser vanligvis krever. Derfor er det lite sannsynlig at løsningen blir inkludert i et lokalt bilderedigeringsprogram for personlige datamaskiner, og det er uklart hvor mye finjusteringsprosessen kan skaleres ned for forbrukermarkedet.
Slik løsningen foreligger nå, er Imagic et imponerende tilbud som egner seg bedre for API-er – et miljø Google Research, som er på vakt mot kritikk for å legge til rette for deepfake-produksjon, kanskje uansett føler seg mest komfortabel med.
Først publisert 18. oktober 2022.


