
Andersons hoek
UniTune: Googles alternatieve neurale beeldbewerkingstechniek

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Belangrijkste puntenUniTune verfijnt een diffusiemodel op een enkele afbeelding om nauwkeurige…
Meer weergeven
- UniTune verfijnt een diffusiemodel op een enkele afbeelding om nauwkeurige, tekstgestuurde bewerkingen mogelijk te maken.
- In tegenstelling tot DreamBooth of Textual Inversion verwerpt UniTune beide benaderingen voor een betere detailbehoud.
- De methode bereikt een hoge semantische ontvlechting, waarbij gezichten intact blijven tijdens radicale achtergrondtransformaties.
Google Research lijkt text-gebaseerde beeldbewerking vanuit verschillende hoeken aan te vallen en wacht waarschijnlijk af wat ‘het beste werkt’. Kort na de release van hun Imagic-paper heeft het bedrijf een aanvullende latent diffusie-gebaseerde methode voorgesteld voor het uitvoeren van anders onmogelijke AI-gebaseerde bewerkingen op afbeeldingen via tekstopdrachten, deze keer genaamd UniTune.
Op basis van de voorbeelden in het nieuwe paper van het project, heeft UniTune een buitengewone mate van disentanglement van semantische pose en idee van de daadwerkelijke harde afbeeldingsinhoud bereikt:

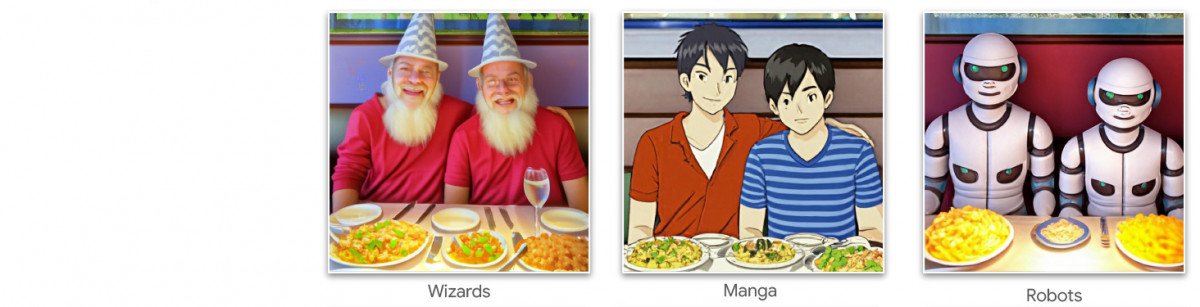

UniTune beheerst de semantische compositie uitstekend. Let op hoe de gezichten van de twee personen in de bovenste rij niet zijn vervormd door de ingrijpende verandering van de rest van de bronafbeelding (rechts). Source: https://arxiv.org/pdf/2210.09477.pdf
Stable Diffusion-fans hebben ondertussen wel door dat het toepassen van bewerkingen op gedeelten van een afbeelding zonder de rest van de afbeelding te verstoren, een lastige en soms onmogelijke operatie kan zijn. Hoewel populaire distributies zoals AUTOMATIC1111 masks kunnen maken voor lokale en beperkte bewerkingen, is het proces omslachtig en vaak onvoorspelbaar.
Het voor de hand liggende antwoord, tenminste voor een computer vision-practitioner, is om een laag van semantische segmentatie te plaatsen die in staat is om objecten in een afbeelding te herkennen en te isoleren zonder tussenkomst van de gebruiker, en er zijn inderdaad verschillende nieuwe initiatieven geweest in deze richting.
Een andere mogelijkheid om rommelige en verstrengelde neurale beeldbewerkingsoperaties te vergrendelen, is om OpenAI’s invloedrijke Contrastive Language-Image Pre-training (CLIP) module te gebruiken, dat centraal staat in latent diffusie-modellen zoals DALL-E 2 en Stable Diffusion, om te fungeren als filter op het punt waarop een tekst-naar-afbeelding-model klaar is om een geïnterpreteerde render terug te sturen naar de gebruiker. In deze context zou CLIP moeten fungeren als een sentinel en kwaliteitscontrole-module, die misvormde of anderszins ongeschikte renders afwijst. Dit wordt spoedig ingesteld (Discord-link) bij Stability.ai’s DreamStudio API-gebaseerde portal.
Echter, aangezien CLIP zowel de dader als de oplossing is in een dergelijke scenario (omdat het ook de manier waarop de afbeelding is geëvolueerd, heeft geïnformeerd), en aangezien de hardware-eisen mogelijk hoger zijn dan wat waarschijnlijk beschikbaar is voor een eindgebruiker, kan deze aanpak niet ideaal zijn.
Gecomprimeerde taal
Het voorgestelde UniTune ‘fine-tuned’ een bestaand diffusiemodel – in dit geval Google’s eigen Imagen, hoewel de onderzoekers verklaren dat de methode compatibel is met andere latent diffusie-architecturen – zodat een unieke token in het model wordt geïnjecteerd, die kan worden opgeroepen door deze op te nemen in een tekstprompt.
Op het eerste gezicht klinkt dit als Google DreamBooth, momenteel een obsessie onder Stable Diffusion-fans en -ontwikkelaars, die in staat is om nieuwe personages of objecten in een bestaand checkpoint te injecteren, vaak in minder dan een uur, op basis van een handvol bronafbeeldingen; of als Textual Inversion, dat ‘sidecar’-bestanden voor een checkpoint maakt, die vervolgens worden behandeld alsof ze oorspronkelijk in het model waren getraind, en die kunnen profiteren van de uitgebreide middelen van het model door de tekstclassificator te modificeren, waardoor een klein bestand ontstaat (in vergelijking met de minimum 2GB gesnoeide checkpoints van DreamBooth).
In feite beweren de onderzoekers dat UniTune deze benaderingen heeft afgewezen. Ze vonden dat Textual Inversion te veel belangrijke details oversloeg, terwijl DreamBooth ‘slechter presteerde en langer duurde’ dan de oplossing die ze uiteindelijk kozen.
Toch, UniTune gebruikt dezelfde ingekapselde semantische ‘metaprompt’-aanpak als DreamBooth, met getrainde veranderingen die worden opgeroepen door unieke woorden die zijn gekozen door de trainer, die niet in conflict komen met enige termen die momenteel bestaan in een zorgvuldig getraind openbaar model.
QUOTEOPEN‘Om de bewerking uit te voeren, samplen we de fijnafgestelde modellen met de prompt “[rare_tokens] edit_prompt” (bijvoorbeeld “beikkpic twee honden in een restaurant” of “beikkpic een minion”).’QUOTECLOSE
Het proces
Hoewel het verwarrend is waarom twee bijna identieke papers, in termen van hun eindfunctionaliteit, van Google in dezelfde week zouden verschijnen, is er, ondanks een groot aantal overeenkomsten tussen de twee initiatieven, tenminste één duidelijk verschil tussen UniTune en Imagic – de laatste gebruikt ‘ongecomprimeerde’ natuurlijke taalprompts om beeldbewerkingsoperaties te leiden, terwijl UniTune getrainde unieke tokens in de stijl van DreamBooth gebruikt.
Daarom, als je met Imagic zou bewerken en een transformatie van deze aard zou willen uitvoeren…

Uit de UniTune-paper: UniTune wordt vergeleken met SDEdit, Googles favoriete concurrerende neurale bewerkingsraamwerk. De resultaten van UniTune staan helemaal rechts; het geschatte masker staat op de tweede afbeelding van links.
.. in Imagic, zou je ‘de derde persoon, zittend op de achtergrond, als een schattig harig monster’ invoeren.
Het equivalent UniTune-commando zou zijn ‘Man achteraan als [x]’, waar x het unieke woord is dat is gebonden aan het fijngetrainde concept dat is geassocieerd met het furry monster-personage.
Terwijl DreamBooth en Textual Inversion meerdere afbeeldingen ontvangen om een deepfake-achtige abstractie te maken die in verschillende houdingen kan worden opgeroepen, ontvangen UniTune en Imagic slechts één afbeelding: het originele, ongerepte beeld.
Dit is vergelijkbaar met de manier waarop veel GAN-gebaseerde bewerkingsgereedschappen van de afgelopen jaren hebben gewerkt – door een invoerbeeld om te zetten in latent codes in de latent ruimte van de GAN en vervolgens die codes aan te spreken en naar andere delen van de latent ruimte te sturen voor modificatie (d.w.z. invoeren van een afbeelding van een jonge donkerharige persoon en projecteren door latent codes geassocieerd met ‘oud’ of ‘blond’, enz.).
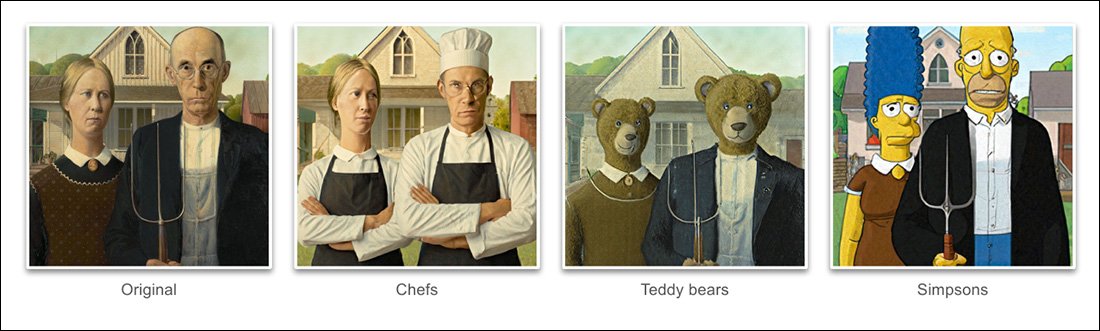
Echter, de resultaten, in een diffusiemodel, en met deze methode, zijn vrijwel verrassend nauwkeurig in vergelijking, en veel minder dubbelzinnig:
Het fijnafstemmingsproces
De UniTune-methode zendt de originele afbeelding essentieel door een diffusiemodel met een set instructies over hoe het moet worden gewijzigd, met behulp van de uitgebreide repositories van beschikbare gegevens die in het model zijn getraind. In feite kun je dit nu doen met Stable Diffusions img2img-functionaliteit – maar niet zonder de delen van de afbeelding die je wilt behouden, te verstoren of te veranderen.
Tijdens het UniTune-proces wordt het systeem fijngetuned, wat betekent dat UniTune het model dwingt om de training te hervatten, met de meeste van zijn lagen onbevroren (zie hieronder). In de meeste gevallen zal fijnafstemming de algehele algemene verlieswaarden van een met veel moeite verkregen hoogwaardig model verlagen ten gunste van het injecteren of verfijnen van een ander aspect dat gewenst is om te creëren of te versterken.
Echter, met UniTune lijkt het erop dat het modelkopie dat wordt bewerkt, hoewel het enkele gigabytes of meer kan wegen, zal worden behandeld als een wegwerpbare tussenproduct en zal worden weggegooid aan het einde van het proces, nadat het een enkel doel heeft gediend. Dit soort nonchalante datatonnage wordt een alledaagse opslagcrisis voor DreamBooth-fans, wiens eigen modellen, zelfs wanneer ze zijn gesnoeid, niet minder dan 2GB per onderwerp zijn.
Net als bij Imagic gebeurt de belangrijkste afstemming in UniTune op de onderste twee van de drie lagen in Imagen (basis 64px, 64px>256px en 256px>1024px). In tegenstelling tot Imagic zien de onderzoekers enige potentieel waarde in het optimaliseren van de afstemming ook voor deze laatste en grootste super-resolutie-laag (hoewel ze dit nog niet hebben geprobeerd).
Voor de laagste 64px-laag is het model tijdens de training gebiaseerd naar de basisafbeelding, met meerdere duplicaatparen van afbeelding/tekst die in het systeem worden gevoerd voor 128 iteraties bij een batchgrootte van 4, en met Adafactor als verliesfunctie, opererend bij een leersnelheid van 0,0001. Hoewel alleen de T5-encoder wordt bevroren tijdens deze fijnafstemming, wordt deze ook bevroren tijdens de primaire training van Imagen
Deze bovenstaande bewerking wordt vervolgens herhaald voor de 64>256px-laag, met behulp van dezelfde ruisaugmentatieprocedure die werd gebruikt in de oorspronkelijke training van Imagen.
Sampling
Er zijn veel mogelijke steekproefmethoden waarmee de wijzigingen die zijn aangebracht, kunnen worden afgeleid uit het fijngetune model, waaronder Classifier Free Guidance (CFG), een hoofdonderdeel van Stable Diffusion. CFG definieert in wezen de mate waarin het model vrij is om ‘zijn verbeelding te volgen’ en de renderingmogelijkheden te verkennen – of anders, bij lagere instellingen, de mate waarin het moet vasthouden aan de invoergegevens en minder omvattende of dramatische veranderingen moet maken.

Net als Textual Inversion (en in mindere mate DreamBooth) kan UniTune duidelijke grafische stijlen op originele afbeeldingen toepassen, evenals meer fotorealistische bewerkingen.
De onderzoekers hebben ook geëxperimenteerd met SDEdit‘s ‘late start’-techniek, waarbij het systeem wordt aangemoedigd om originele details te behouden door slechts gedeeltelijk ‘ruis’ vanaf het begin, maar in plaats daarvan de essentiële kenmerken te behouden. Hoewel de onderzoekers dit alleen op de laagste laag (64px) hebben gebruikt, geloven ze dat het een nuttige aanvullende steekproeftechniek kan zijn in de toekomst.
De onderzoekers hebben ook prompt-to-prompt als een aanvullende tekstuele techniek gebruikt om het model te conditioneren:
QUOTEOPEN‘Bij de instelling “prompt to prompt” vonden we een techniek die we Prompt Guidance noemen bijzonder nuttig om getrouwheid en expressiviteit af te stemmen. QUOTECLOSEQUOTEOPEN‘Prompt Guidance lijkt op Classifier Free Guidance, maar gebruikt een andere prompt als uitgangspunt in plaats van het ongeconditioneerde model. Dit stuurt het model naar het verschil tussen de twee prompts.’QUOTECLOSE

Prompt-to-prompt in UniTune isoleert doeltreffend de gebieden die moeten veranderen.
Hoewel prompt-guidance, volgens de auteurs, alleen af en toe nodig was in gevallen waarin CFG niet het gewenste resultaat opleverde.
Een andere novatieve steekproefaanpak die tijdens de ontwikkeling van UniTune werd ontdekt, was interpolatie, waarbij delen van de afbeelding voldoende verschillend zijn dat zowel de originele als de gewijzigde afbeelding zeer vergelijkbaar zijn in compositie, waardoor een meer ‘naïeve’ interpolatie kan worden gebruikt.

Interpolatie kan de zwaardere processen van UniTune overbodig maken als de te veranderen gebieden afzonderlijk en duidelijk afgebakend zijn.
De auteurs suggereren dat interpolatie potentieel zo goed kan werken, voor een groot aantal doelafbeeldingen, dat het kan worden gebruikt als standaardinstelling, en merken ook op dat het de kracht heeft om buitengewone transformaties te veroorzaken in gevallen waarin complexe occlusies niet hoeven te worden onderhandeld door intensievere methoden.
UniTune kan lokale bewerkingen uitvoeren met of zonder bewerkingsmasks, maar kan ook unilateraal bepalen waar bewerkingen moeten worden geplaatst, met een ongebruikelijke combinatie van interpretatieve kracht en robuuste essentialisatie van de invoergegevens:

In de bovenste afbeelding van de tweede kolom heeft UniTune de gevraagde rode trein op de achtergrond op een passende en authentieke plek gezet. Let in de andere voorbeelden op hoe de semantische samenhang met de bron bewaard blijft ondanks ingrijpende veranderingen in pixelinhoud en basisstijl.
Latentie
Hoewel de eerste iteratie van een nieuw systeem altijd langzaam zal zijn, en hoewel het mogelijk is dat ofwel communitybetrokkenheid of corporate-inzet (het is meestal niet beide) uiteindelijk het resource-intensieve proces zal versnellen en optimaliseren, voeren zowel UniTune als Imagic enkele vrij grote machine learning-manoeuvres uit om deze verbazingwekkende bewerkingen te creëren, en het is twijfelachtig in hoeverre een dergelijk resource-hongerig proces ooit kan worden geschaald naar huishoudelijk gebruik, in plaats van API-gebaseerde toegang (hoewel de laatste wellicht meer wenselijk is voor Google).
Op dit moment is de rondreis van invoer tot resultaat ongeveer 3 minuten op een T4 GPU, met ongeveer 30 seconden extra voor inferentie (zoals elke inferentieroutine). De auteurs geven toe dat dit een hoge latentie is en nauwelijks als ‘interactief’ kan worden beschouwd, maar ze merken ook op dat het model beschikbaar blijft voor verdere bewerkingen zodra het eenmaal is afgestemd, totdat de gebruiker klaar is met het proces, wat de bewerkingstijd per bewerking vermindert.
Voor het eerst gepubliceerd op 21 oktober 2022.


