
Andersons hoek
AI-ondersteunde objectbewerking met Google’s Imagic en Runway’s ‘Erase and Replace’

 Voeg Unite.AI toe aan je voorkeursbronnen op Google

Deze week bieden twee nieuwe, maar contrasterende AI-gedreven grafische algoritmen nieuwe manieren voor eindgebruikers om zeer gedetailleerde en effectieve wijzigingen aan objecten in foto’s aan te brengen.
De eerste is Imagic, van Google Research, in samenwerking met het Israëlische Institute of Technology en het Weizmann Institute of Science. Imagic biedt tekstgeconditioneerde, fijnmazige bewerking van objecten via het fijn afstellen van diffusie‑modellen.

Verander wat je wilt, en laat de rest – Imagic belooft granulaire bewerking van alleen die delen die je wilt wijzigen. Bron: https://arxiv.org/pdf/2210.09276.pdf
Wie ooit heeft geprobeerd slechts één element in een Stable Diffusion‑herrendering te wijzigen, weet maar al te goed dat bij elke geslaagde bewerking het systeem vijf dingen wijzigt die je juist zo goed vond. Het is een tekortkoming die momenteel veel van de meest getalenteerde SD‑enthousiastelingen dwingt constant te schakelen tussen Stable Diffusion en Photoshop om dit soort ‘neveneffecten’ te herstellen. Alleen al vanuit dit perspectief lijken de prestaties van Imagic opmerkelijk.
Op het moment van schrijven heeft Imagic nog geen promotievideo, en gezien Google’s voorzichtige houding ten aanzien van het vrijgeven van onbeperkte beeldsynthetisatietools, is het onzeker in hoeverre – zo niet helemaal – we de kans krijgen het systeem te testen.
Het tweede aanbod is Runway ML’s veel toegankelijkere Erase and Replace-functie, een nieuwe functie in de sectie ‘AI Magic Tools’ van de uitsluitend online suite van op machine learning gebaseerde visuele‑effecten‑hulpmiddelen.
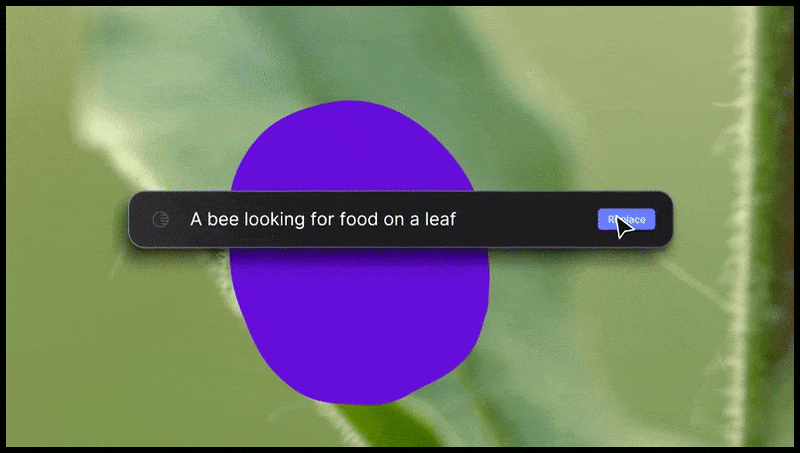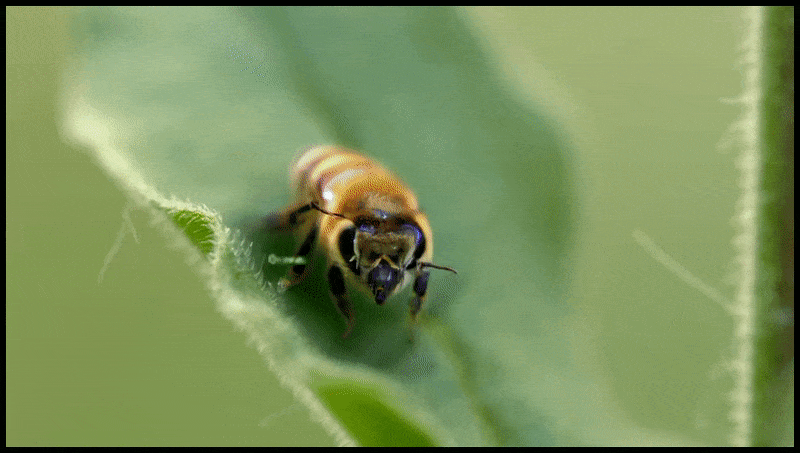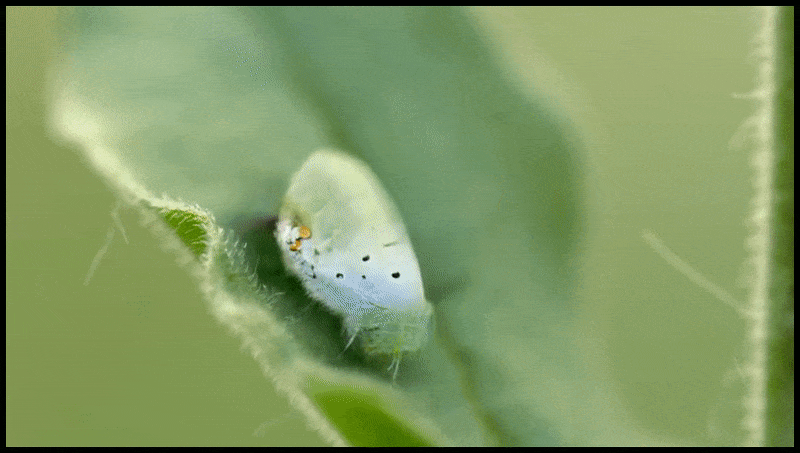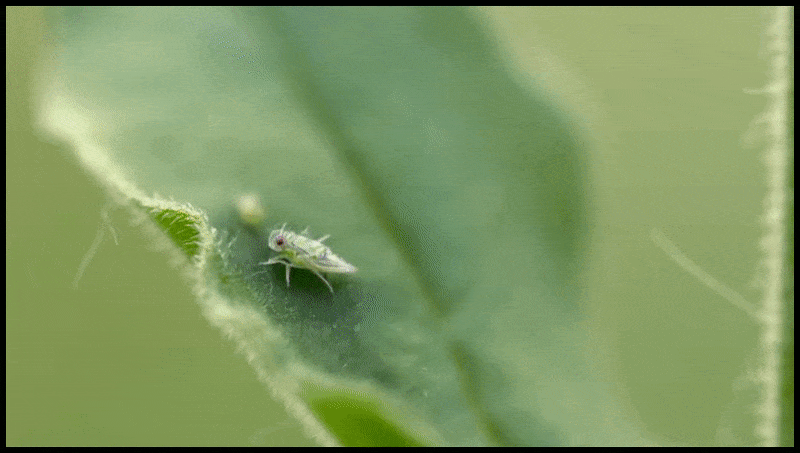
Runway ML’s Erase and Replace-functie, al gezien in een preview van een tekst-naar-video‑bewerkingssysteem.
Laten we eerst een kijkje nemen naar Runway’s uitkomst.
Erase and Replace
Net als Imagic werkt Erase and Replace uitsluitend met stilstaande beelden, hoewel Runway de zelfde functionaliteit heeft gepreviewd in een tekst-naar-video‑bewerkingsoplossing die nog niet is uitgebracht:
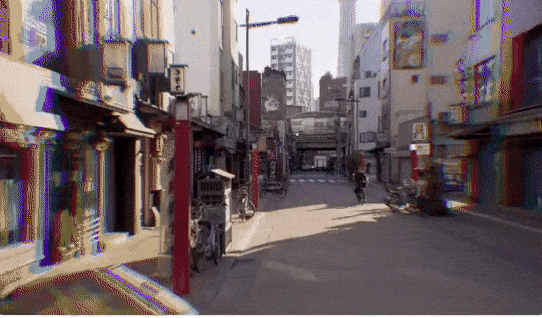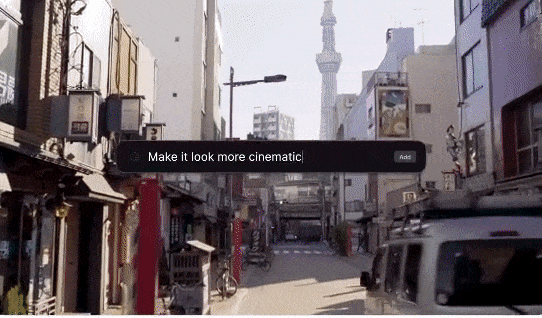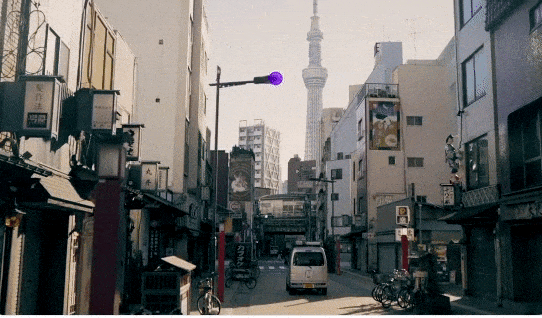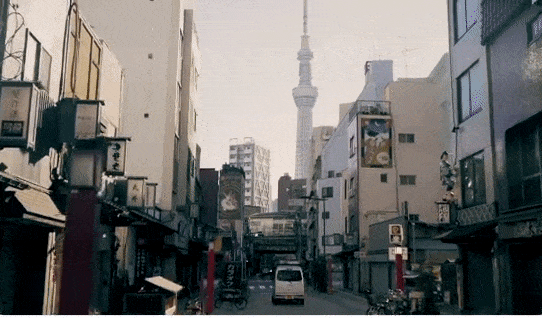
Hoewel iedereen de nieuwe Erase and Replace op afbeeldingen kan uitproberen, is de video‑versie nog niet publiek beschikbaar. Bron: https://twitter.com/runwayml/status/1568220303808991232
Hoewel Runway ML geen details heeft vrijgegeven over de technologieën achter Erase and Replace, suggereert de snelheid waarmee je een kamerplant kunt vervangen door een redelijk overtuigend bust van Ronald Reagan dat een diffusiemodel zoals Stable Diffusion (of, veel minder waarschijnlijk, een gelicentieerde DALL‑E 2) de motor is die het object van jouw keuze in Erase and Replace opnieuw creëert.

Het vervangen van een kamerplant door een bust van The Gipper is niet helemaal zo snel als dit, maar het is behoorlijk snel. Bron: https://app.runwayml.com/
Het systeem kent enkele DALL‑E 2‑achtige beperkingen – afbeeldingen of tekst die de Erase and Replace-filters activeren, zullen een waarschuwing veroorzaken over mogelijke account‑schorsing bij verdere overtredingen – praktisch een standaardklon van OpenAI’s lopende beleid voor DALL‑E 2.
Veel van de resultaten missen de typische ruwe randjes van Stable Diffusion. Runway ML zijn investeerders en onderzoekspartners in SD, en het is mogelijk dat ze een propriëtair model hebben getraind dat superieur is aan de open‑source 1.4‑checkpoint‑gewichten waar de rest van ons momenteel mee worstelt (net als vele andere ontwikkelingsgroepen, zowel hobbyisten als professionals, die momenteel Stable Diffusion-modellen trainen of fijn afstellen).
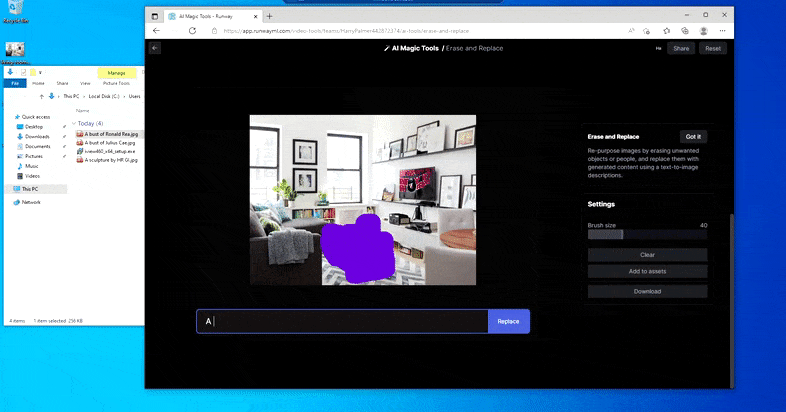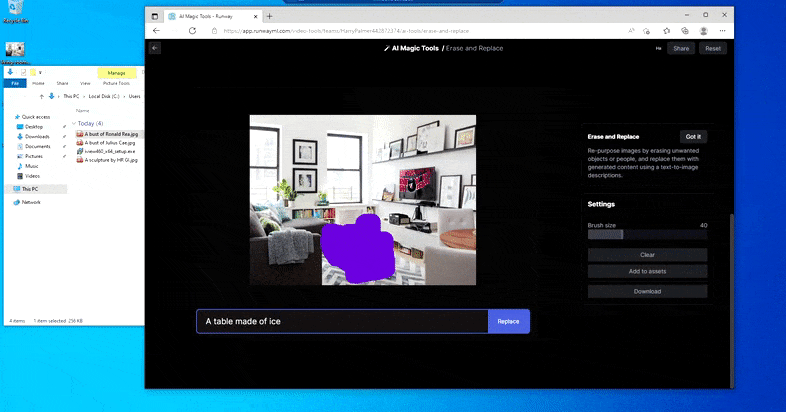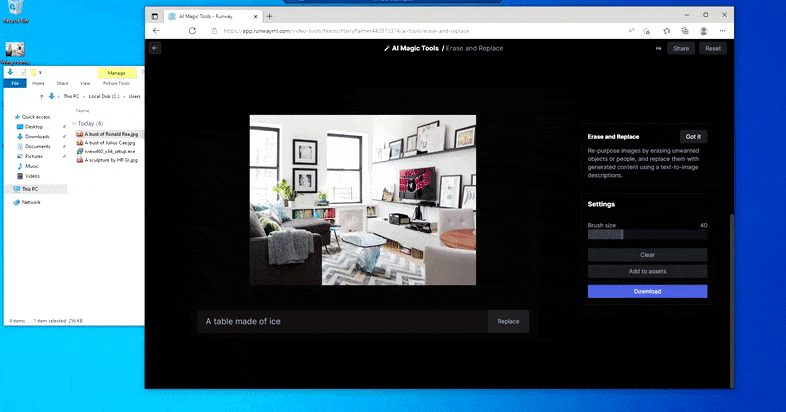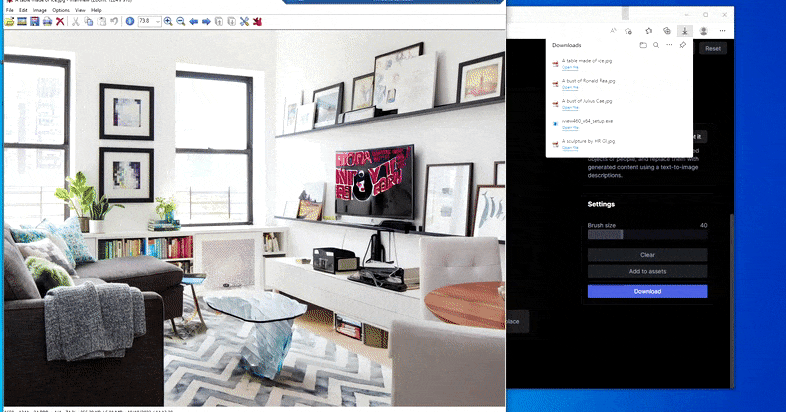
Een huishoudelijke tafel vervangen door een ‘tafel van ijs’ in Runway ML’s Erase and Replace.
Net als bij Imagic (zie hieronder) is Erase and Replace ‘objectgeoriënteerd’, zo gezegd – je kunt niet zomaar een ‘lege’ deel van de afbeelding wissen en het vervolgens invullen met het resultaat van je tekstprompt; in dat scenario zal het systeem simpelweg het dichtstbijzijnde zichtbare object langs de maskerlijn volgen (zoals een muur of een televisie) en de transformatie daar toepassen.
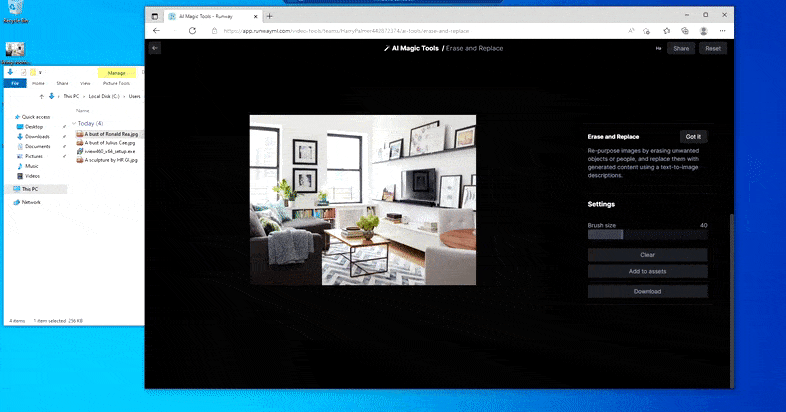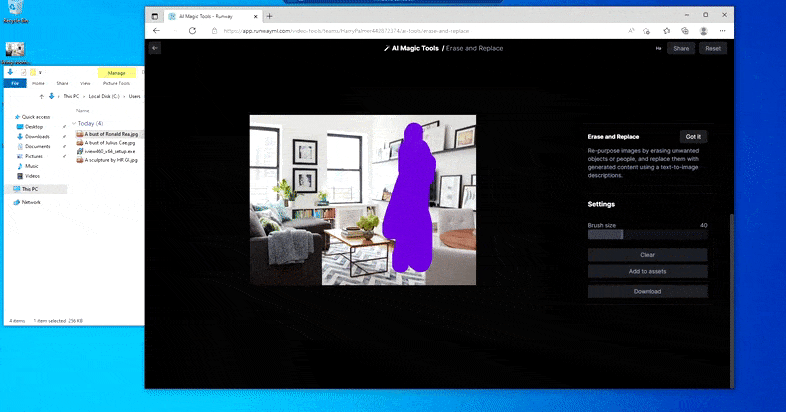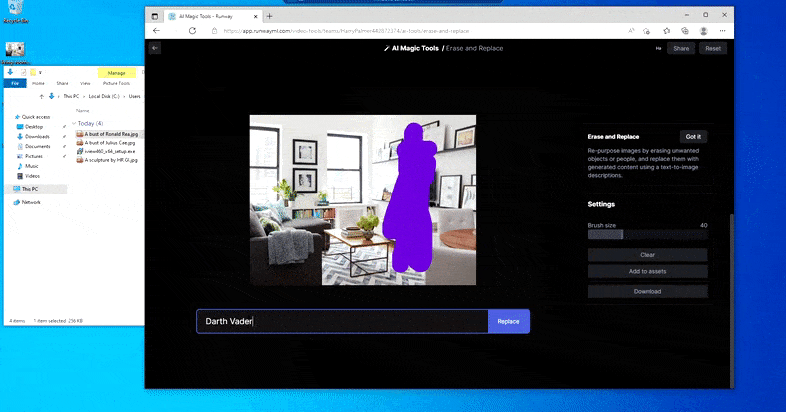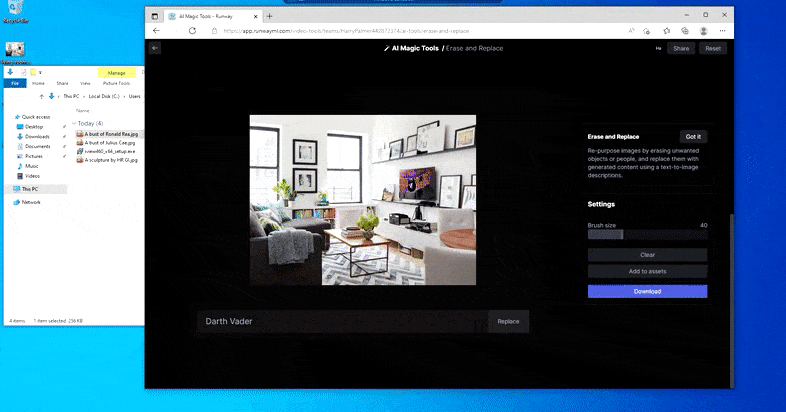
Zoals de naam aangeeft, kun je geen objecten in lege ruimte injecteren met Erase and Replace. Hier resulteert een poging om de beroemdste van de Sith‑heren op te roepen in een vreemd Vader‑gerelateerd muurschildering op de tv, ongeveer op de plek waar het ‘vervang’-gebied is getekend.
Het is moeilijk te bepalen of Erase and Replace ontwijkend is ten aanzien van het gebruik van auteursrechtelijk beschermde afbeeldingen (die nog steeds grotendeels geblokkeerd zijn, zij het met wisselend succes, in DALL‑E 2), of dat het model dat in de back‑end renderengine wordt gebruikt simpelweg niet geoptimaliseerd is voor dat soort zaken.

De enigszins NSFW ‘Muur van Nicole Kidman’ geeft aan dat het (vermoedelijk) op diffusie gebaseerde model hier DALL‑E 2’s vroegere systematische afwijzing van het renderen van realistische gezichten of pikante inhoud mist, terwijl de resultaten van pogingen om auteursrechtelijk beschermde werken te reproduceren variëren van dubbelzinnig (‘xenomorf’) tot absurd (‘de ijzeren troon’). In de rechteronderhoek staat de bronafbeelding.
Het zou interessant zijn te weten welke methoden Erase and Replace gebruikt om de objecten te isoleren die het kan vervangen. Vermoedelijk wordt de afbeelding door een afgeleide van CLIP gehaald, waarbij de afzonderlijke items geïdentificeerd worden door objectherkenning en daaropvolgende semantische segmentatie. Geen van deze bewerkingen werkt in een alledaagse installatie van Stable Diffusion in de buurt van even goed.
Maar niets is perfect – soms lijkt het systeem te wissen en niet te vervangen, zelfs wanneer (zoals we in de afbeelding hierboven hebben gezien) het onderliggende rendermechanisme duidelijk begrijpt wat een tekstprompt betekent. In dit geval is het onmogelijk om een salontafel in een xenomorf te veranderen – de tafel verdwijnt simpelweg.
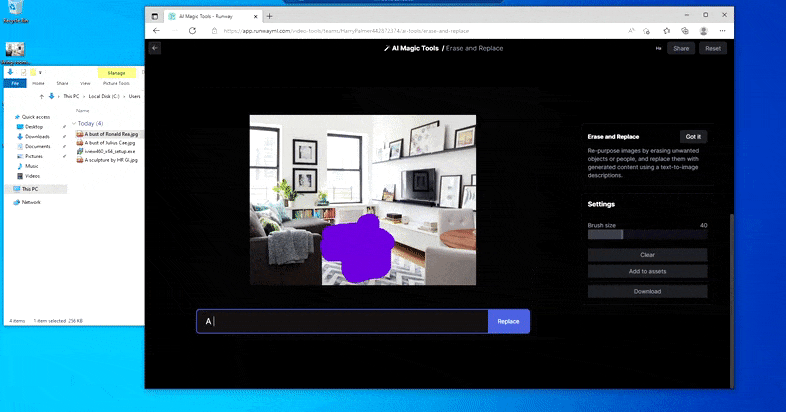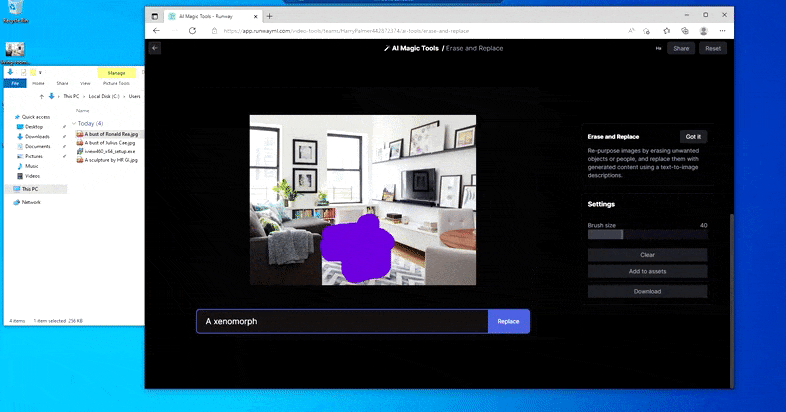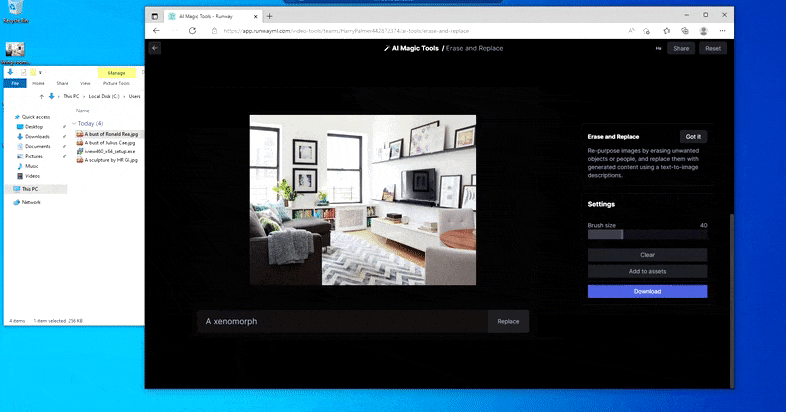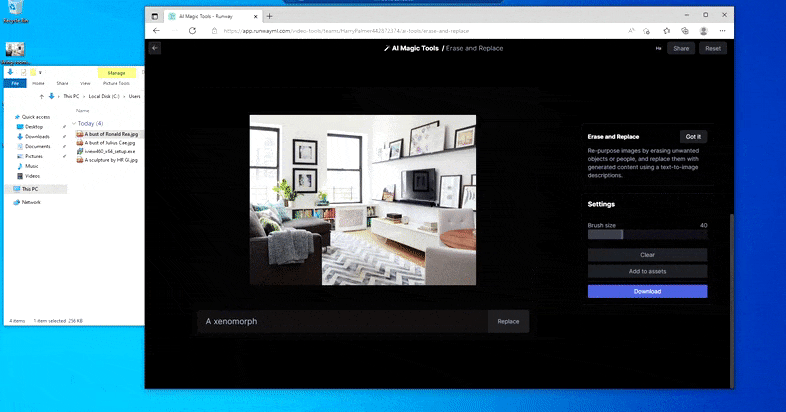
Een engere versie van ‘Waar is Waldo’, omdat Erase and Replace er niet in slaagt een alien te produceren.
Erase and Replace lijkt een effectief objectvervangingssysteem te zijn, met uitstekende inpainting. Het kan echter geen bestaande waargenomen objecten bewerken, maar alleen vervangen. Het daadwerkelijk wijzigen van bestaande beeldinhoud zonder het omringende materiaal aan te tasten is wellicht een veel moeilijkere taak, verweven met de lange strijd van de computer‑vision‑onderzoeksgemeenschap naar disentanglement in de verschillende latente ruimten van de populaire frameworks.
Imagic
Het is een taak die Imagic aanpakt. Het nieuwe artikel biedt talrijke voorbeelden van bewerkingen die individuele facetten van een foto succesvol aanpassen terwijl de rest van de afbeelding onaangetast blijft.

In Imagic ondervinden de aangepaste afbeeldingen niet de kenmerkende rekking, vervorming en ‘occlusie‑gissing’ die typerend is voor deepfake‑poppen, die gebruik maakt van beperkte priors afgeleid van één afbeelding.
Het systeem maakt gebruik van een drie‑stappenproces – optimalisatie van tekst‑embeddings; fijn afstellen van het model; en tenslotte het genereren van de aangepaste afbeelding.

Imagic codeert de doel‑tekstprompt om de initiële tekst‑embedding op te halen, en optimaliseert vervolgens het resultaat om de invoerafbeelding te verkrijgen. Daarna wordt het generatieve model fijn afgestemd op de bronafbeelding, met een reeks parameters, voordat het wordt onderworpen aan de gevraagde interpolatie.
Het is niet verrassend dat het framework is gebaseerd op Google’s Imagen tekst‑naar‑video‑architectuur, hoewel de onderzoekers stellen dat de principes van het systeem breed toepasbaar zijn op latente diffusiemodellen.
Imagen gebruikt een drie‑laag architectuur, in plaats van de zeven‑laag opstelling die wordt gebruikt voor de recentere tekst‑naar‑video‑iteratie van de software van het bedrijf. De drie afzonderlijke modules bestaan uit een generatief diffusiemodel dat werkt op een resolutie van 64 × 64 px; een super‑resolutiemodel dat deze output opschaalt naar 256 × 256 px; en een extra super‑resolutiemodel dat de output verder opschaalt tot 1024 × 1024 px.
Imagic grijpt in op het vroegste stadium van dit proces, waarbij de gevraagde tekst‑embedding geoptimaliseerd wordt op het 64‑px‑stadium met een Adam‑optimizer en een statische leersnelheid van 0,0001.

Een meesterklas in disentanglement: gebruikers die hebben geprobeerd iets eenvoudigs als de kleur van een gerenderd object in een diffusie‑, GAN‑ of NeRF‑model te wijzigen, zullen weten hoe belangrijk het is dat Imagic zulke transformaties kan uitvoeren zonder de consistentie van de rest van de afbeelding te ‘verbreken’.
Fijnafstemming vindt vervolgens plaats op het basis‑model van Imagen, gedurende 1500 stappen per invoerafbeelding, geconditioneerd op de aangepaste embedding. Tegelijkertijd wordt de secundaire 64 px→256 px‑laag parallel geoptimaliseerd op de geconditioneerde afbeelding. De onderzoekers merken op dat een vergelijkbare optimalisatie voor de uiteindelijke 256 px→1024 px‑laag ‘bijna geen effect’ heeft op het eindresultaat, en hebben deze daarom niet geïmplementeerd.
Het artikel stelt dat het optimalisatieproces ongeveer acht minuten per afbeelding duurt op twee TPUV4-chips. Het uiteindelijke renderen gebeurt in de kern van Imagen volgens het DDIM‑sampling‑schema.
Net als bij soortgelijke fijn‑afstemmingsprocessen voor Google’s DreamBooth, kunnen de resulterende embeddings bovendien worden gebruikt om stylisatie mogelijk te maken, evenals fotorealistische bewerkingen die informatie bevatten uit de bredere onderliggende database die Imagen aandrijft (aangezien, zoals de eerste kolom hieronder laat zien, de bronafbeeldingen niet over de benodigde inhoud beschikken om deze transformaties uit te voeren).

Flexibele fotorealistische bewegingen en bewerkingen kunnen worden verkregen via Imagic, terwijl de afgeleide en gedistingeerde codes die in het proces worden verkregen net zo gemakkelijk kunnen worden gebruikt voor gestileerde output.
De onderzoekers vergeleken Imagic met eerdere werken SDEdit, een op GAN gebaseerde benadering uit 2021, een samenwerking tussen Stanford University en Carnegie Mellon University; en Text2Live, een samenwerking uit april 2022 tussen het Weizmann Institute of Science en NVIDIA.

Een visuele vergelijking tussen Imagic, SDEdit en Text2Live.
Het is duidelijk dat de eerdere benaderingen worstelen, maar in de onderste rij, die een enorme pose‑verandering omvat, falen de concurrenten volledig in het herstructureren van het bronmateriaal, terwijl Imagic een opvallend succes laat zien.
De resource‑eisen en trainingstijd per afbeelding van Imagic, hoewel kort volgens de normen van dergelijke inspanningen, maken het onwaarschijnlijk dat het in een lokale beeldbewerkingsapplicatie op een persoonlijke computer wordt opgenomen – en het is onduidelijk in hoeverre het fijn‑afstemmingsproces kan worden teruggeschaald naar consumentenniveau.
Vooralsnog is Imagic een indrukwekkend aanbod dat beter geschikt is voor API’s – een omgeving waarin Google Research, terughoudend tegenover kritiek op het faciliteren van deepfakes, zich waarschijnlijk het meest op zijn gemak voelt.
Eerste publicatie 18 oktober 2022.


