
Andersons hoek
Uit het zicht, uit het hoofd: het aanpakken van het grootste probleem in AI-video

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Belangrijkste puntenEen nieuw hybride geheugensysteem lost het chronische geheugenverlies van AI-video op…
Meer weergeven
- Een nieuw hybride geheugensysteem lost het chronische geheugenverlies van AI-video op door personages buiten beeld consistent te houden.
- De methode gebruikt geheugentokenisatie en dynamisch ophalen om uiterlijk en beweging tijdens het uit beeld gaan te behouden.
- HyDRA overtreft eerdere benaderingen door dynamische onderwerpen te ontkoppelen van statische achtergronden in de latente ruimte.
Het grootste probleem met zelfs de beste AI-videogeneratoren is dat ze een chronische geheugenstoornis hebben – een uitdaging die nu wordt aangepakt door nieuw onderzoek uit China.
Het grootste probleem met zelfs de beste en meest geavanceerde AI-videogeneratiesystemen is dat ze allemaal chronische geheugenstoornis hebben: als de camera wegdraait van wat hij focust en dan terugdraait, zal hij nooit vinden wat er aanvankelijk was – personages zullen zijn verdwenen, van uiterlijk en/of beweging zijn veranderd en de achtergrond zal waarschijnlijk ook zijn veranderd.
Dit komt doordat het diffusie-gebaseerde generatiesysteem een beperkt rollend venster van aandacht heeft, en omdat het altijd bezig is met wat het op dat moment kan zien; in een ware verwezenlijking van solipsisme, is wat buiten het kader valt, niet-bestaand voor generatieve AI – het wordt letterlijk uit het geheugen gewist.
Dit is nooit een probleem geweest in traditionele CGI, die altijd naar een onderwerp kan verwijzen en het nauwkeurig kan reconstrueren, inclusief uiterlijk en beweging, op elk punt in een gerenderde video waar ze mogelijk opnieuw nodig zijn:

Traditionele CGI-meshes en bitmapped textures kunnen altijd worden getekend in een render, waardoor een consistente verschijning wordt geboden – een truc die veel moeilijker is om te bereiken in AI-benaderingen, omdat er geen equivalent ‘plat referentie’-bestand of verzameling van verwante bestanden is.
Dit komt doordat de componenten van CGI, zoals de mesh en textures (zie afbeelding hierboven), evenals bewegingsbestanden en andere dynamische gedragingen, als afzonderlijke bestanden op schijf kunnen worden opgeslagen en op elk moment in een compositie kunnen worden getekend.
Er is geen dergelijke ‘platte repository’ in generatieve video-AI; het dichtstbijzijnde dat het kan komen, is LoRAs – speciaal getrainde adjunct-bestanden die op consumentenapparatuur kunnen worden getraind, waardoor nieuwe personages en specifieke kleding in de video kunnen worden ‘gedwongen’:
Klik om af te spelen. Het solipsisme-probleem van AI-video kan tot op zekere hoogte worden gemitigeerd door het gebruik van LoRAs – maar de resultaten kunnen overweldigend zijn.
Dit is geen ideale oplossing, echter. Ten eerste zijn LoRAs gekoppeld aan een exacte specifieke versie van een basismodel (zoals Wan2+ of Hunyuan Video), en moeten opnieuw worden gemaakt elke keer dat het basismodel verandert. Ten tweede hebben LoRAs de neiging de gewichten te vervormen van het basismodel, zodat de getrainde identiteit van de LoRA wordt opgelegd aan alle personages in een scène. Bovendien zijn fijne afstelling methoden van deze soort zeer gevoelig voor slecht gecuratede datasets.
Nauwkeurige terugkeer
Nu biedt een nieuwe academische/industriële samenwerking uit China de eerste significante remedie die ik in meer dan drie jaar van rapporteren over dit onderwerp heb aangetroffen. De methode gebruikt wat de onderzoekers hybride geheugen noemen om het personage buiten het scherm en zijn directe omgeving actief en nauwkeurig te houden in de latente ruimte van het model, zodat wanneer ons gezichtspunt terugkeert naar hen, het effect consistent is:
Klik om af te spelen. Van de projectsite voor het nieuwe artikel, twee voorbeelden van AI-gegenereerde (WAN) personages die het kader verlaten en nauwkeurig terugkeren. Bron
Er moet worden benadrukt dat dit niet hetzelfde is als het bereiken van personageconsistentie over verschillende shots – iets dat een jaar geleden werd beweerd te zijn bereikt in Runway’s Gen 4-release, en dat nog steeds een gaande poging is in de onderzoeksliteratuur.
Integendeel, wat hier wordt opgelost, is iets dat geen enkel commercieel of experimenteel kader dat ik heb gezien, heeft kunnen bereiken – de visueel consistente terugkeer van het eerdere uiterlijk, de beweging en de omgeving van een personage dat buiten beeld is geweest:
Klik om af te spelen. De andere twee belangrijkste voorbeelden die op de projectsite van het nieuwe initiatief worden gegeven.
Het is duidelijk dat de principes die hier werken, ook kunnen worden toegepast op andere domeinen, zoals stedelijke exploratie, POV-rijden of andere soorten niet-personage rendering.
Er moet ook worden benadrukt dat deze nieuwe benadering het probleem dat Runway Gen4 en andere gesloten bronplatforms claimen te hebben aangepakt, niet oplost of aanpakt, door personages over verschillende shots te reconstrueren; in plaats daarvan doet het wat geen van hen heeft kunnen bereiken – het behoud van een personage en omgeving in het geheugen, zonder dat ze altijd zichtbaar hoeven te zijn voor de kijker.
Het nieuwe werk bestaat uit een speciaal gegenereerde dataset via Unreal Engine, evenals aangepaste metrics voor het solipsisme-probleem*, en een aangepast generatief framework gebouwd over WAN. In tests tegen de weinige vergelijkbare systemen die beschikbaar zijn, claimen de auteurs state-of-the-art resultaten, en ze merken op:
‘[Geheugen] mechanismen zijn geëmergeerd als een cruciaal onderzoeksgebied in de vooruitgang van wereldmodellen, aangezien de geheugencapaciteit de ruimtelijke en temporele consistentie van gegenereerde inhoud dicteert.
‘In het bijzonder is het het cognitieve anker dat het model in staat stelt om historische context te behouden tijdens gezichtspuntverschuivingen of langetermijnextrapolatie.
‘Zonder robuust geheugen, valt een gesimuleerde wereld snel uiteen in niet-verbonden, chaotische frames.’
Het nieuwe artikel heet Uit het zicht, maar niet uit het hoofd: Hybride geheugen voor dynamische video-wereldmodellen, en komt van zeven onderzoekers uit Huazhong University of Science and Technology, en het Kling Team bij Kuaishou Technology.
Methode
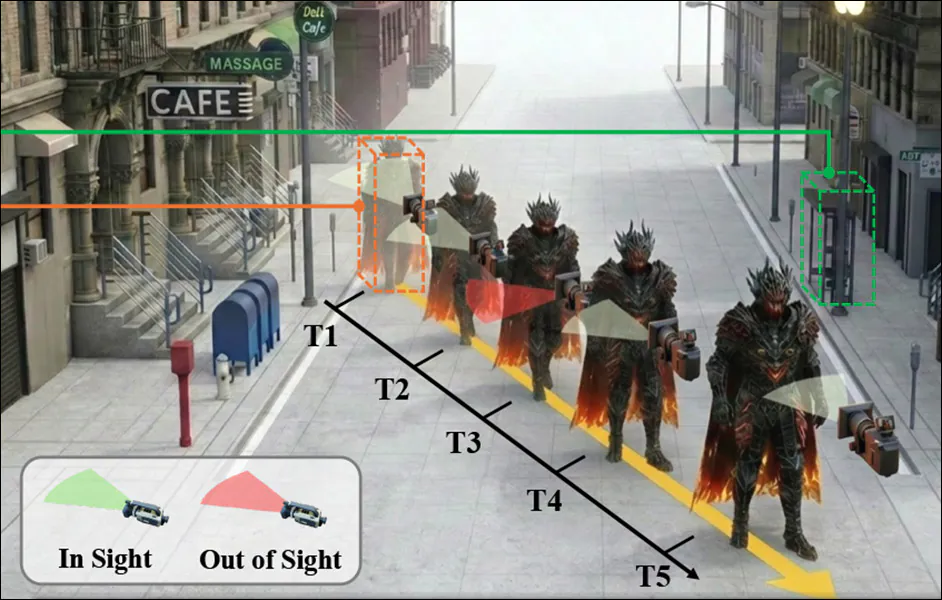
Het centrale onderdeel van het nieuwe werk is hybride geheugen, dat ‘uit het zicht extrapolatie’ mogelijk maakt – het behoud van personages en hun contexten terwijl de kijker ‘wegkijkt’ (of terwijl het personage zelf het zicht verlaat). In deze situatie moet het kader spatiotemporele ontkoppeling uitvoeren, waarbij het tegelijkertijd gefocust is op de zichtbare generatie en het bestaan van het personage buiten het zicht.

Voorbeelden van entry/exit camerabeweging. In deze gevallen is het de camerabeweging die het personage uit het kader doet verdwijnen, maar in diverse samples kunnen we ook observeren dat het personage zelf tijdelijk uit het zicht verdwijnt. Bron
De auteurs merken op dat in diffusie-latente embeddings, de kenmerken die moeten worden geëxtraheerd en gebruikt, zwaar verward zijn met andere kenmerken en eigenschappen; en dat het proberen om ze te extraheren vaak ervoor zorgt dat het onderwerp ‘bevriest’ in de achtergrond. Daarom hebben ze de HM-World dataset** ontwikkeld en samengesteld, specifiek gericht op het trainen van hybride geheugen:

Voorbeelden uit het artikel van de vier categorieën in de HM-World-dataset.
De verzameling is opgebouwd langs vier dimensies: trajecten van onderwerpen, cameratrajecten, scènes en onderwerpen.
De synthetische gegevens in HM-World omvatten 17 scènes en 49 onderwerpen, waaronder mensen met uiteenlopende uiterlijke kenmerken en dieren van meerdere soorten. Combinaties daarvan worden via Unreal Engine procedureel in een scène geplaatst, elk met een eigen bewegingsanimatie, en volgen vervolgens een willekeurig gekozen traject.
Volgens de auteurs toont de dataset uiteenlopende gebeurtenissen waarbij onderwerpen het beeld verlaten en terugkeren. Er zijn 28 verschillende cameratrajecten opgenomen, elk met meerdere beginpunten.
De uiteindelijke verzameling omvat 59.225 videoclips, die elk zijn geannoteerd door het multimodale grote taalmodel (MLLM) MiniCPM-V.
De onderzoekers wijzen op de statistische voordelen van hun verzameling ten opzichte van eerdere datasets: WorldScore; Context-As-Memory; Multi-Cam Video; en 360° Motion:

Vergelijking van bestaande datasets met HM-World. Dynamic Subject duidt op bewegende entiteiten, Subject Exit-Enter op clips waarin onderwerpen het beeld verlaten en terugkeren, en Subject Pose op de aanwezigheid van geannoteerde 3D-houdingen.
De minder bewandelde weg
Gegeven meerdere voorgaande frames en een bekend cameratraject, is de taak om toekomstige views te voorspellen terwijl het gezichtspunt van de kijker verschuift, en rekening houdend met personages die onafhankelijk bewegen en mogelijk het kader verlaten voordat ze terugkeren. Dit vereist meer dan het behoud van een stabiele achtergrond, aangezien het model ook een coherent intern record moet behouden van hoe elk bewegend personage eruitziet en zich gedraagt, zelfs tijdens perioden dat het niet zichtbaar is.
De Hybride Dynamische Oproep Aandacht (HyDRA) methode van de auteurs adresseert dit door een speciaal geheugenpad in te voeren dat dynamische personages scheidt van de statische scène-weergave, waardoor ze over tijd kunnen blijven bestaan en opnieuw kunnen verschijnen met consistente verschijning en beweging:

Conceptueel schema voor het HyDRA-model.
HyDRA is gebouwd over Wan2.1-T2V-1.3B, met de core diffusiepijpleiding grotendeels intact gelaten, terwijl een aangepast transformer-blok wordt geïntroduceerd dat dynamische oproep aandacht incorporeert. Dit stelt het model in staat om selectief beweging en verschijning hints uit voorgaande frames te herinneren, in plaats van te vertrouwen op vaste of lokale context.
Dit proces maakt gebruik van een aangepast Flow Matching-trainingsdoel in plaats van standaard diffusie verlies.
Om scènes te laten aansluiten bij camerabeweging, worden cameratrajecten ingevoerd als een expliciete conditioneringssignaal, met elke frame’s pose gedefinieerd door rotatie en translatie, en vervolgens omgezet in een compacte weergave die vastlegt hoe het gezichtspunt evolueert over tijd.
In lijn met de vorige (Kling) ReCamMaster initiatief, is het resultaat vervolgens geparsed door camera encoder, geïmplementeerd als een Multi-Layer Perceptron, vervolgens uitgezonden en toegevoegd aan de Diffusion Transformer kenmerken, waardoor het model consistent object-plaatsing kan behouden terwijl de camera beweegt.
Tokenisatie
Ruwe latente diffusierepresentaties mengen personagebeweging, verschijning en achtergrond in een enkele verwarde weergave; en het proberen om rechtstreeks uit deze ruimte op te halen, kan irrelevante context introduceren of bewegende onderwerpen laten opgaan in de achtergrond.
HyDRA adresseert dit met een 3D-convolutie-gebaseerde Geheugen Tokenizer die ruimte en tijd samen verwerkt – in plaats van volledige latent geschiedenissen door te sturen, comprimeert het ze in compacte, bewegingsbewuste geheugentokens die behouden hoe personages eruitzien en zich bewegen:

Overzicht van HyDRA. Links, de Geheugen Tokenizer converteert voorgaande frames in compacte, bewegingsbewuste geheugentokens; rechts, Dynamische Oproep Aandacht evalueert de huidige query tegen deze tokens, haalt de meest relevante op en gebruikt ze om consistente verschijning en beweging in de gegenereerde frame te herstellen.
Deze tokens vormen een gestructureerd hybride geheugen dat ruis filtert terwijl het lange-afstands dynamiek behoudt. Doorgegeven aan de Dynamische Oproep Aandacht module, stellen deze het model in staat om selectief personages buiten het zicht op te roepen, zodat ze opnieuw verschijnen met consistente verschijning, beweging en context.
Dynamische Oproep Aandacht
HyDRA’s dubbele geheugenmechanisme gebruikt ook dynamische oproep aandacht in een afzonderlijke maar complementaire rol binnen het kader.
Geheugen tokenisatie comprimeert voorgaande latente weergaven in gestructureerde, bewegingsbewuste tokens die dynamische personages scheiden van statische scène-inhoud, waardoor de verstrengeling waardoor personages vaak opgaan in de achtergrond, wordt verminderd. Deze tokens vormen een persistente geheugenbank in plaats van een volledige framegeschiedenis.
Dynamische Oproep Aandacht werkt vervolgens over deze bank tijdens generatie, waarbij het de huidige query evalueert tegen opgeslagen tokens en selectief de meest relevante oproept. Dit stelt het model in staat om personages buiten het zicht te laten voortbestaan (d.w.z. om te blijven lopen, rennen, wanneer je ze niet kunt zien), en om opnieuw te verschijnen met consistente verschijning en beweging wanneer ze terugkeren in zicht, in plaats van te resetten of te degraderen.
Gegevens en Tests
In tests codeerde en downsamplede het op Wan gebaseerde HyDRA-systeem 77 contextframes voordat deze werden verwerkt met een 3D Variational Autoencoder (VAE), terwijl de eerdergenoemde geheugen tokenizer 3D convolutie gebruikte bij een kernelgrootte van 2x4x4.
Het model werd getraind op HW-World voor 10.000 iteraties op 32 (niet gespecificeerde) GPUs, bij een batchgrootte van 32.
Een ongebruikelijk hoog aantal metrics werd gebruikt in de tests: naast de gebruikelijke Peak Signal-to-Noise Ratio (PSNR), Structural Similarity Index (SSIM), en Learned Perceptual Similarity Metrics (LPIPS), gebruikten de auteurs ook onderwerpconsistentie en achtergrondconsistentie van de VBench suite, om coherentie op frameniveau te evalueren.
Daarnaast ontwikkelden ze een aangepaste metric getiteld Dynamische Onderwerp Consistentie (DSC), die gebruik maakt van bounding boxes van YOLO V11, om gecropte regio’s te creëren met bewegende onderwerpen, waaruit semantische kenmerken werden geëxtraheerd en hun overeenkomsten werden berekend.
HyDRA werd getest tegen Diffusie Forcing Transformer (DFoT), en Context-As-Memory, tegen een baseline Wan2.1-T2V-1.3B model uitgerust met een camera encoder (om het subjectieve gezichtspunt te vertegenwoordigen dat algemeen is voor alle clips). Alle modellen werden getraind op HW-World, en WorldPlay werd ook gebruikt als een zero-shot, secundaire testcollectie:
In initiële kwantitatieve vergelijkingen, overtrof HyDRA alle baselines, waardoor PSNR steeg van 18.696 tot 20.357, en SSIM van 0.517 tot 0.606. Het bereikte ook de hoogste contextuele en grondwaarheidsdice scores, 0.827 en 0.849, waarbij de onderwerp- en achtergrondconsistentie respectievelijk 0.926 en 0.932 bereikten:

Resultaten van de initiële kwantitatieve vergelijking tegen eerdere benaderingen.
DFoT bereikte 17.693 PSNR en Context as Memory 18.921, met de winst toegeschreven aan geheugen tokenisatie in combinatie met dynamische oproep aandacht:

Kwantitatieve vergelijking waarin HyDRA wordt getest tegen de huidige stand van de techniek.


