
AI 기초
ETL이란? 추출, 변환, 적재에 대한 설명

 Unite.AI를 Google의 선호 소스에 추가
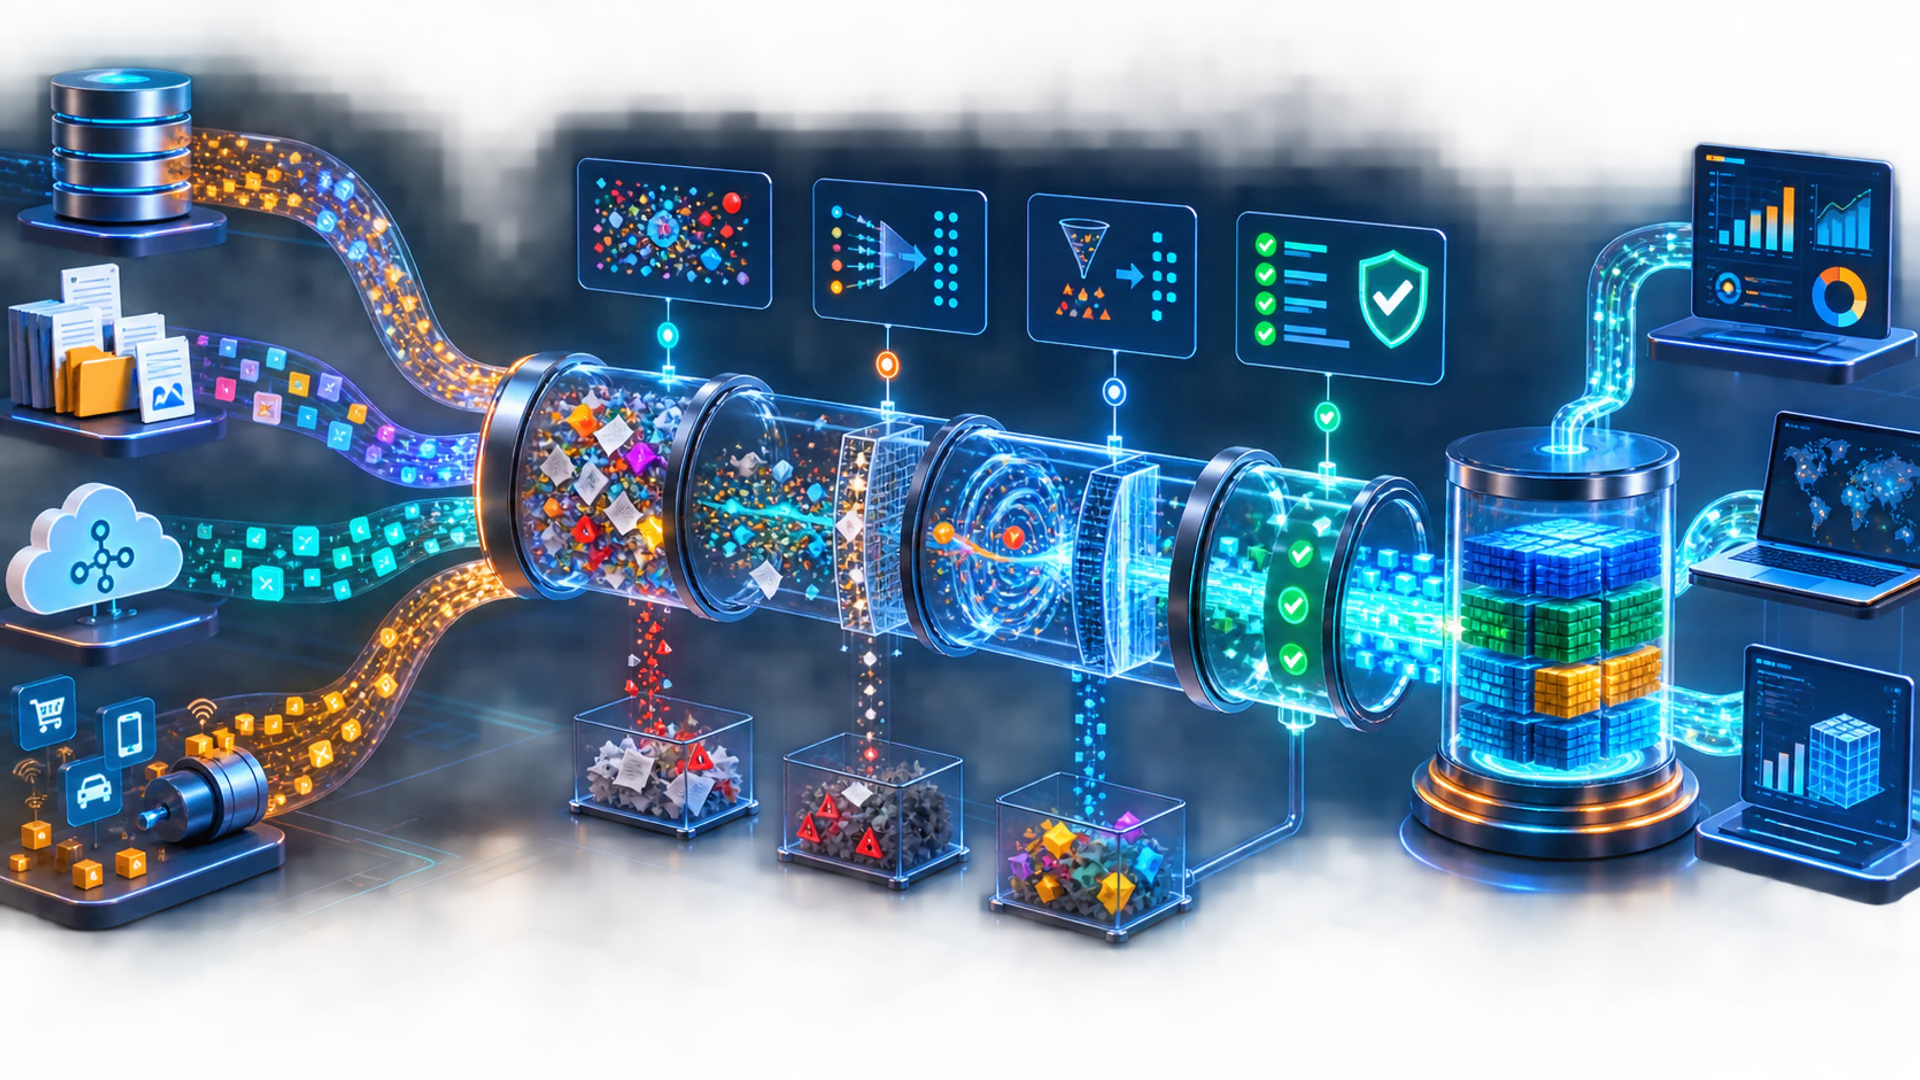
ETL—추출, 변환, 적재—는 데이터 통합 패턴으로, 소스 시스템에서 데이터를 읽고 검증·재구성한 뒤 분석, 보고, 머신러닝 또는 운영에 적합한 대상으로 기록합니다.
실제 운영 환경의 ETL 파이프라인은 세 개 이상의 구성 요소로 이루어집니다. 반복 가능한 실행, 스키마 및 품질 제어, 라인리지, 오케스트레이션, 가시성, 보안, 그리고 로직이 변경될 때 데이터를 백필하거나 재생할 안전한 방법이 필요합니다.
핵심 요점
- 추출은 소스에 미치는 영향을 최소화하고, 캡처된 구간이나 변경 세트를 기록해야 합니다.
- 변환은 비즈니스 의미를 인코딩하므로 버전 관리, 테스트 및 소유권이 필요합니다.
- 적재는 멱등성을 가져야 하며, 그렇지 않을 경우 중복 및 부분 실패로부터 보호해야 합니다.
- ETL과 ELT의 차이는 주로 변환이 실행되는 위치에 있으며, 최신 시스템은 두 방식을 모두 활용하는 경우가 많습니다.
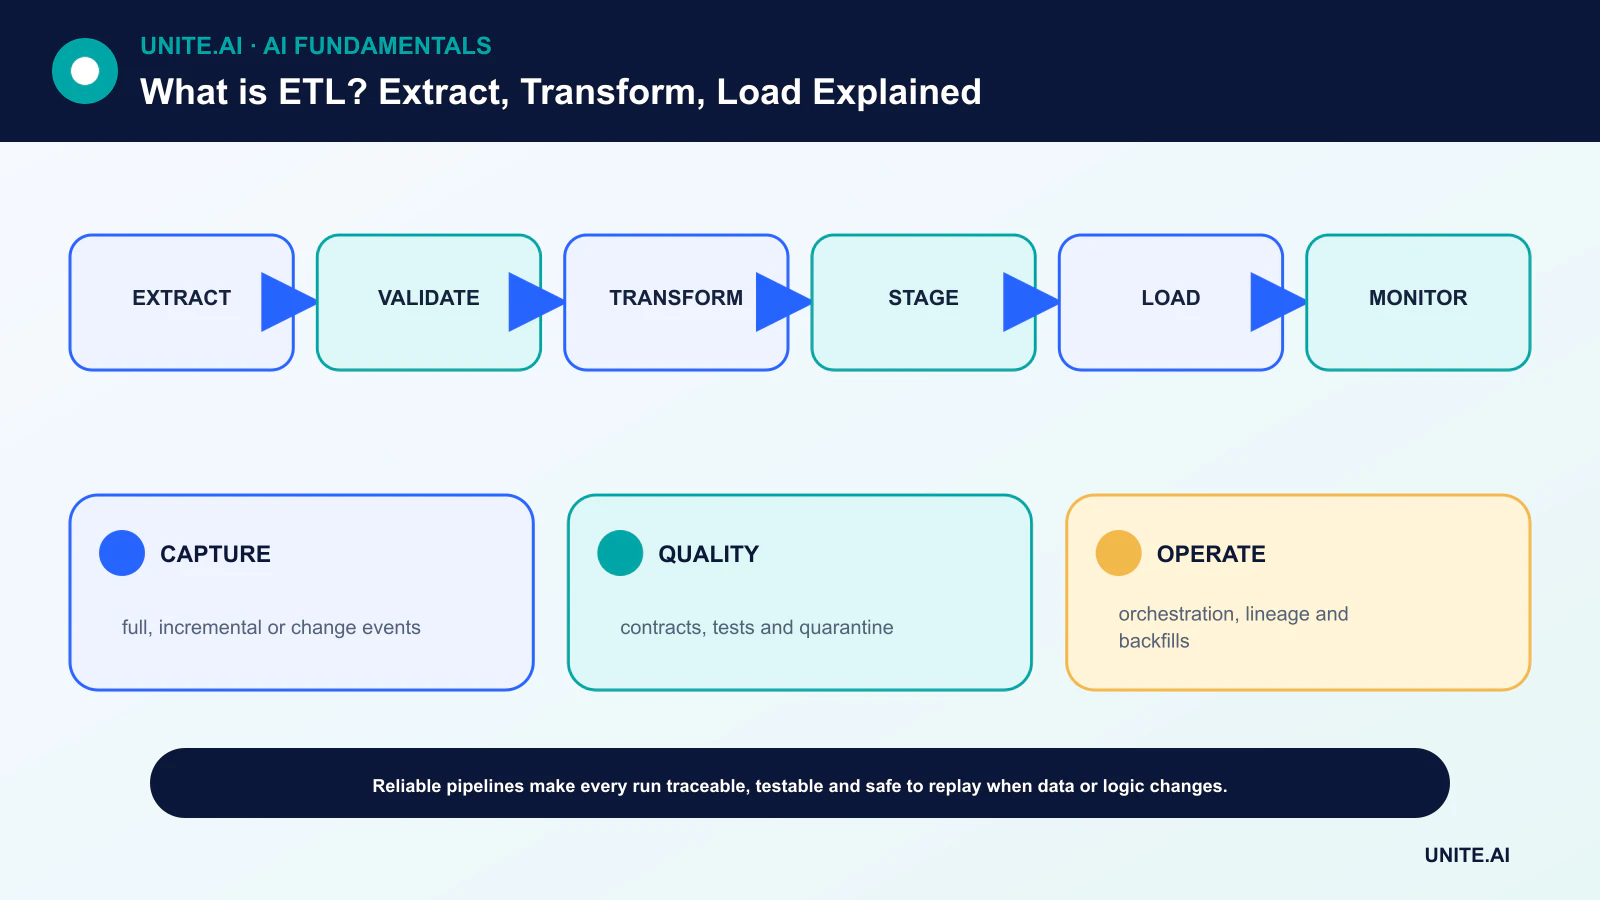
데이터를 안정적으로 추출하기
소스에는 데이터베이스, 파일, API, 이벤트 스트림, 애플리케이션 등이 포함될 수 있습니다. 전체 추출은 전체 데이터를 복사하고, 증분 추출은 체크포인트 이후 변경된 레코드를 읽습니다. 변경 데이터 캡처는 데이터베이스 로그나 이벤트를 활용해 반복 스캔을 줄입니다.
소스 식별자, 시간 경계 및 체크포인트를 기록합니다. 속도 제한과 트랜잭션 의미를 준수하세요. 소스가 스키마를 조용히 변경하면, 모호한 데이터를 그대로 적재하기보다 안전하게 실패하거나 레코드를 격리해야 합니다.
명시적 계약으로 변환하기
변환은 타입과 단위를 표준화하고, 레코드를 파싱하며, 소스를 조인하고, 중복을 제거하거나 표시하고, 비즈니스 규칙을 적용하고, 특징을 계산합니다. 유효하지 않은 데이터와 허용 가능한 누락 데이터를 구분하고, 출력이 입력으로 되돌아갈 수 있도록 충분한 증거를 유지합니다.
소프트웨어 제공과 동일한 엄격한 방식으로 변환을 버전 관리합니다. 테스트는 스키마, 범위, 참조 무결성, 기대 분포 및 알려진 예시를 포함해야 합니다. 데이터 계약은 생산자와 소비자 간 기대치를 정의합니다.
안전하고 반복 가능한 적재
적재는 이벤트를 추가하거나, 변경된 레코드를 병합하거나, 파티션을 교체하거나, 테이블을 재구성할 수 있습니다. 멱등성은 동일한 입력을 재실행해도 대상 상태가 동일하게 유지된다는 의미입니다. 트랜잭션, 스테이징 테이블 및 원자적 스와핑을 사용하면 부분 업데이트 위험을 줄일 수 있습니다.
파티셔닝과 인덱싱은 사용 패턴에 맞춰야 합니다. 민감한 필드는 보호하고, 데이터가 쿼리 가능해지기 전에 대상 권한을 적용합니다. 보존 및 삭제 요구사항은 데이터와 함께 이동해야 합니다.
ETL, ELT, 배치와 스트리밍
전통적인 ETL은 별도의 엔진에서 변환을 수행한 뒤 적재합니다. ELT는 원시 혹은 가볍게 처리된 데이터를 먼저 적재하고, 대상 컴퓨팅을 활용해 변환합니다. 클라우드 웨어하우스나 레이크하우스는 ELT를 편리하게 만들지만, 품질이나 거버넌스 작업을 없애지는 못합니다.
배치 파이프라인은 제한된 구간을 처리하고, 스트리밍 파이프라인은 정의된 시간 및 순서 의미를 가진 지속적인 이벤트를 처리합니다. 많은 아키텍처가 스트리밍 수집 후 주기적인 조정을 사용합니다. 이는 지연되거나 수정된 데이터가 일반적이기 때문입니다.
오케스트레이션, 라인리지 및 가시성
오케스트레이터는 작업을 스케줄링하고, 종속성을 존중하며, 정의된 실패를 재시도하고, 상태를 기록합니다. 재시도에는 한계와 멱등 작업이 필요합니다. 백필은 격리되고 용량을 고려해야 하며, 과거 복구가 현재 데이터 흐름을 방해하지 않도록 해야 합니다.
신선도, 볼륨, 스키마, 품질, 실행 시간 및 비용을 모니터링합니다. 데이터 패브릭의 라인리지와 메타데이터 레이어는 소비자가 어떤 버전이 데이터셋을 생성했는지, 상위 단계에서 무엇이 깨졌는지 이해하도록 돕습니다.
Extract: sources, contracts, and incremental capture
ETL은 소스 시스템에서 데이터를 이동하고, 관리된 구조로 변환한 뒤 목적지에 적재합니다. 추출은 파일, 데이터베이스 쿼리, API, 로그, 스트림 또는 변경 데이터 캡처를 사용할 수 있습니다. 소스 소유권, 스키마, 키, 타임스탬프, 시간대, 단위, 삭제 의미 및 허용 적재 방식을 정의하세요. 전체 추출은 간단하지만 비용이 많이 들고, 증분 캡처는 볼륨을 줄이지만 워터마크, 로그 위치 또는 버전 필드와 지연·수정 레코드에 대한 전략이 필요합니다.
API 성공이 전체 추출을 의미한다고 가정하지 마세요. 레코드 수, 체크섬, 시퀀스 간격, 페이지네이션, 속도 제한, 재시도 및 소스 스냅샷을 기록합니다. 정책이 허용하는 경우 불변 원시 데이터를 저장해 변환을 재생할 수 있게 합니다. 자격 증명과 민감한 필드를 보호하고, 재시도를 멱등하게 만드세요. 스키마 변경은 계약을 통해 호환 여부 또는 파괴 여부로 분류하고, 하위 대시보드가 조용히 변경될 때 발견되지 않도록 해야 합니다.
Transform and load with reproducible semantics
변환은 타입을 파싱하고, 단위를 표준화하며, 중복을 제거하고, 조인하고, 비즈니스 규칙을 적용하며, 히스토리를 관리하고, 사실과 차원을 도출합니다. 각 규칙은 테스트와 라인리지를 필요로 합니다. ETL이 머신러닝에 데이터를 공급할 때는 적절한 학습 데이터에만 통계 전처리를 적용하세요. 천천히 변하는 차원은 속성 변경이 히스토리를 덮어쓸지 보존할지를 결정합니다. 사실의 입자를 조인 전에 선언하고, 다대다 오류는 기본 행 검사만으로는 중복 측정을 초래할 수 있습니다.
적재는 추가, 병합, 파티션 교체 또는 레코드 업데이트가 될 수 있습니다. 가능한 경우 스테이징 테이블과 원자적 스와핑을 사용해 독자가 부분 상태를 보지 않게 합니다. 고유성, 관계, 허용 값, 완전성 및 비즈니스 불변성을 강제합니다. 지연 이벤트와 백필은 이벤트 시간과 버전된 코드를 사용해 처리합니다. 소스 총계와의 조정은 재무 및 운영 데이터에 필수적입니다. ELT는 변환 전에 원시 데이터를 적재하지만, 거버넌스와 정확성 요구사항은 그대로 유지됩니다.
Operations and recovery
오케스트레이션은 종속성, 스케줄, 재시도, 동시성 및 알림을 관리합니다. 신선도, 볼륨, 품질, 실행 시간, 비용 및 하위 영향도를 모니터링합니다. 실패한 작업은 중복 없이 재개하거나 재생할 수 있어야 합니다. 코드와 스키마를 버전 관리하고, 라인리지를 유지하며, 백필을 격리된 환경에서 테스트합니다. 재해 복구에는 원시 데이터, 카탈로그, 권한, 오케스트레이션 상태 및 의미 정의가 포함됩니다. 사용자가 메트릭을 소스까지 추적하고 변경 후에도 재현할 수 있을 때 ETL은 신뢰할 수 있습니다—단순히 파이프라인이 녹색 상태로 끝났다고 해서 그렇지는 않습니다.
Worked example: an incremental order pipeline
ETL 작업은 주문 및 품목에 대한 데이터베이스 변경 로그를 읽고, 불변 이벤트를 저장하며, 시퀀스와 스키마를 검증하고, 하나의 주문‑라인 입자로 웨어하우스 사실 테이블에 병합합니다. 이벤트 시간과 업데이트 버전은 지연 수정에 대응하고, 결정적 키는 재생을 멱등하게 합니다. 차원은 대리키를 통해 선택된 고객·제품 히스토리를 보존합니다. 행 수, 주문 총액, 세금, 반품 및 취소는 소스 기간과 조정됩니다.
파괴적인 소스 필드 변경은 신뢰 테이블로의 승격을 중단하고, 라인리지와 함께 소유자에게 알립니다. 백필은 버전된 코드를 격리된 환경에서 실행하고 원자적 스와핑 전에 비교합니다. 접근 정책은 고객 식별자를 제한하고, 삭제는 허가된 파생 복사본에 전파됩니다. 모니터링은 신선도, 볼륨, 품질, 비용 및 대시보드 영향을 포함합니다. 복구 테스트는 원시 이벤트에서 기간을 재구성하고 오케스트레이션 상태를 복원합니다. 녹색 스케줄러만으로는 비즈니스 수치가 재현 가능하고 조정되지 않는 한 충분하지 않습니다.
Implementation evidence and operational readiness
프로덕션 의사결정은 성공적인 시연만으로는 충분하지 않습니다. 대상 사용자, 운영 환경, 입력·출력, 종속성, 소유자 및 각 주요 실패의 결과를 정의하세요. 튜닝 전에 재현 가능한 기준선과 버전된 평가 세트를 설정합니다. 일반 사례, 경계 조건, 형식이 잘못되었거나 누락된 입력, 분포 변화, 종속성 장애, 오용 및 가장 취약한 그룹·환경을 테스트합니다. 작업 품질을 보정·불확실성, 지연, 처리량, 자원 비용, 접근성, 프라이버시 및 보안과 함께 측정합니다. 모든 변환과 임계값을 기록해 독립적인 검토자가 결과를 재현하고 매력적인 프로토타입과 증거를 구분할 수 있게 합니다.
출시 전에는 릴리즈, 예외, 변경, 롤백 및 퇴역에 대한 권한을 지정합니다. 단계적 롤아웃을 사용하고 안전한 폴백을 유지하며, 의도적으로 주입된 실패로 모니터링을 검증합니다. 운영 텔레메트리는 입력 품질, 출력 동작, 모델·규칙 버전, 종속성 상태, 인간 개입 및 확인된 결과를 보여주어야 하며, 불필요한 민감 데이터를 수집해서는 안 됩니다. 알림 임계값과 대응 책임자를 정의하고, 배포 후 실제 증거를 검토하세요—오프라인 성능이 지속될 것이라고 가정하지 마세요. 데이터 소스, 사용자, 모델, 공급업체, 정책, 하드웨어 또는 목표가 변경될 때마다 재평가합니다. 유지 관리되는 시스템은 문서화된 복구, 사고 학습, 삭제 및 보존 절차와 함께, 비활성화 또는 교체 시점을 명확히 정의해야 합니다.
Frequently asked questions
Is ETL obsolete in cloud data platforms?
No. Some platforms favor ELT, but extraction, transformation and loading responsibilities still exist. Teams often combine both patterns.
What makes an ETL pipeline idempotent?
It can safely process the same input again without creating duplicate or inconsistent destination state, usually through stable keys, checkpoints and transactional writes.
Primary references












