
Anderson의 관점
AI를 사용하여 실제 사진을 찍기 전에 개선하는 방법

 Unite.AI를 Google의 선호 소스에 추가
사진을 찍은 뒤 생성형 AI로 고치는 대신, 연구진은 무엇이 사진을 기억에 남게 만드는지에 관한 연구 지식을 이용해 촬영 전에 움직임·포즈·구도를 안내하는 시스템을 학습시켰다.
제조사와 기술 플랫폼이 촬영 직후 이미지를 바꿀 수 있는 카메라 내 편집 기능을 늘리면서 사후 보정은 계속 쉬워졌다. 대표적으로 Google의 대화형 편집과 Samsung의 생성형 편집이 있다.
하지만 AI로 ‘개선한’ 결과보다 진정성을 중시하는 흐름이 생기면서, 이런 기능의 대상 소비자가 변형된 사진을 ‘AI 쓰레기’로 받아들일 가능성도 커졌다.
이 점이 Google이 Gemini를 기반으로 촬영 과정에서 직접 지시하는 AI 학습형 ‘Camera Coach’를 만든 배경일 수 있다.
Google Camera Coach는 구도를 다시 잡는 방법 등 기본 조언을 제공한다.출처독점 시스템이라 공개 정보가 거의 없지만, Camera Coach는 Gemini로 구도를 개선하거나 피사체가 가까이 서고 카메라를 바로 보도록 하는 작은 자세 변화를 제안하는 것으로 보인다.
알려진 범위에서 이 제품은 Gemini 학습에 포함됐을 가능성이 큰 수백만 건의 업로드 자료를 바탕으로 구도를 평균값 쪽으로 밀어간다. 사용자는 마음에 들지 않는 사진을 버리고 선호하는 사진을 올리는 방식으로 AI의 보정 기준을 사실상 무료로 큐레이션한 셈이다.
그러나 평균적인 구도의 사진이 반드시 기억에 남는 사진과 같은 미적 가치나 관객 영향을 갖는 것은 아니다.
‘치즈!’와 삼분할 법칙을 넘어서
이탈리아 연구진은 여러 플랫폼에서 쓸 수 있고, 사진을 기억에 남게 만드는 선행 지식을 활용하는 코치형 시스템을 제안했다.
연구진의 새 시스템이 제공한 폭넓은 조언 사례.출처MemCoach라는 새 시스템의 조언은 구도 중심 Camera Coach가 하기 어려운 내용도 포함한다. 첫 사례에서 머리 장식을 없애라는 제안은 특히 논쟁적이고, 두 번째 사례처럼 눈을 감고 바닥에 누운 젊은 여성의 예술적 사진에서는 일반 구도 규칙만으로 맥락을 파악하기 어렵다.
세 부분으로 구성된 이 시스템의 사진 기억성 개념은 2015년의 What makes an object memorable?과 2013년의 What makes a photograph memorable? 등 선행 연구에서 가져왔다.
2013년 논문이 제시한 기억성이 높은 사진, 중간 사진, 낮은 사진의 대표 사례.출처이 연구들은 사람, 실내 장면, 감정 표현의 존재가 물체나 파노라마보다 중요한 내재 요인이며, 맥락과 관찰자 같은 외재 요인도 작용한다고 설명했다. 새 프로젝트는 기억성 피드백(MemFeed), 이를 제공하는 MemCoach 응용 프로그램, PPR10K 데이터셋에 기반한 MemBench 벤치마크를 중심으로 한다.
PPR10K 인물 보정 데이터셋의 다양한 표본. 윗줄은 원본, 아랫줄은 전문가 보정 결과와 인물 영역 마스크다. 원본은 시점·배경·조명·카메라 설정이 다양하지만, 보정본은 시각 품질과 그룹 내 일관성이 향상됐다.출처논문은 기억성이 주관적 의견의 단순 집합이 아니라 사진에서 정량화할 수 있는 특성이라고 본다. 이 특성은 사진뿐 아니라 영상에서도 여러 연구를 통해 확인됐다.
논문 제목은 How to Take a Memorable Picture? Empowering Users with Actionable Feedback이며 University of Trento, University of Pisa, Fondazione Bruno Kessler의 연구자 네 명이 작성했다. 프로젝트 페이지는 GitHub 코드와 Hugging Face 데이터를 2026년 3월 공개할 예정이라고 안내했다.
방법
연구진은 PPR10K 인물 데이터셋에서 MemBench를 만들기 위해 같은 장면의 사진을 묶고, CLIP 특징에 기반한 학습형 예측기로 각 이미지의 기억성 점수를 계산했다. 그런 다음 장면 안에서 덜 기억나는 사진부터 더 기억나는 사진까지 순위를 매겨 쌍을 만들었다.
MemBench 구축과 평가 개요. 위쪽은 장면별 이미지 그룹화, 기억성 예측, 순위화, 행동형 피드백 생성으로 이어지는 데이터 파이프라인이다. 아래쪽은 편집 뒤 기억성 증가와 perplexity로 피드백 품질을 평가한다.각 쌍에 대해 InternVL3.5가 덜 기억나는 사진과 더 기억나는 사진의 눈에 보이는 차이를 자연어로 설명했고, 이 설명이 기억성 피드백 시스템의 학습 신호가 됐다.
Google Camera Coach의 논리와 달리, 연구진은 촬영 후 “이미지를 더 밝게 하라”는 보정 대신 촬영자가 현장에서 실행할 수 있는 의미적 행동, 예를 들어 “서로 마주 보라” 같은 조언을 목표로 했다.
최종 MemBench는 약 1만 장을 1,570개 장면으로 묶었고 장면당 평균 6.5장을 포함한다. 연구진의 단어 구름은 데이터셋에 폭넓은 의미 범주가 있음을 보여준다.
MemBench에서 가장 자주 등장하는 단어의 구름.원본 사진의 기억성 평균은 0.63이었다. 같은 장면에서 가장 기억에 남는 사진의 점수는 0.51에서 1.0까지 분포했고, 두 그룹 사이에는 눈에 띄는 중첩이 있었다.
각 장면에서 기억성이 가장 낮은 이미지와 가장 높은 이미지의 점수 분포 비교.피드백은 7단어짜리 짧은 메모부터 훨씬 긴 지시까지 다양했다. 연구진은 GPT-5 Mini로 각 조언을 작은 행동 단위로 나눴다.
내용어 기준 피드백 길이 분포와 원자적 하위 행동 범주. 연결 폭은 범주가 함께 나타난 빈도를 뜻한다.제안 대부분은 피사체 포즈를 다뤘고, 다음으로 장면의 의미나 내용 변경이 많았다. 구도는 포즈와 자주 연결됐고 조명 조정은 의미적 변화와 함께 제안되는 경우가 많았다.
FLUX로 피드백 효과를 모의 평가
피드백이 실제로 기억성을 높이는지 평가하기 위해 FLUX.1 Kontext 생성 모델을 촬영자의 대리인으로 사용했다. 원본 이미지와 텍스트 조언을 주면 FLUX가 그 변경을 반영한 편집 이미지를 만들었다.
왼쪽은 데이터셋의 실제 사진, 오른쪽은 아래 노란색 프롬프트에 따라 FLUX가 만든 이미지다. 많은 사람을 동원하지 않고도 조언의 효과를 평가했으며, 장차 실제 촬영 사례를 이용해 시스템을 반복 개선할 수 있는 흐름을 보여준다.원본과 편집 이미지를 모두 기억성 예측기에 넣었다. 편집본 점수가 더 높아진 빈도를 Improvement Ratio로, 시작 이미지 대비 증가 폭을 Relative Memorability로 측정했다.
정답 설명 대비 perplexity로 기억성 중심 참조 조언과의 유사성도 계산했다. 장면 단위로 80 대 20 학습·시험 분할을 적용해 학습에 쓰지 않은 장면만 시험했다.
기존 멀티모달 모델의 한계
현재 멀티모달 대규모 언어 모델의 기억성 인식을 확인하기 위해 LaMem 이미지를 여러 주요 모델에 보여주고 기억에 남는지 물었다. 모델의 신뢰도를 원 연구의 인간 점수와 비교했다.
기준 멀티모달 모델이 기억성을 포착하지 못한 시험. 왼쪽은 모델 예측과 LaMem 정답의 Spearman 순위 상관관계이며 사람 평가자 간 일치도를 함께 표시했다. 오른쪽은 편집 기준선 대비 제로샷 피드백의 Improvement Ratio로, 향상 폭이 미미했다.인간 판단과 의미 있는 상관관계는 거의 없었다. 대규모 사전 학습에도 모델은 사람들이 일관되게 기억하는 요소를 추적하지 못했다.
LaMem 데이터셋의 이미지 사례. 왼쪽 위 사례에는 주목도 히트맵도 표시됐다.출처MemCoach
MemCoach는 셔터를 누르기 전에 실행할 수 있는 의미적 지시에 집중한다. 포즈를 조정하고, 피사체 간 상호작용을 바꾸고, 장면 요소를 수정하는 방식이다. 피드백 길이는 내용어 기준 7~102단어였다. 논문은 단순 구도 수정보다 피사체 배치와 서사적 단서가 기억성을 더 강하게 좌우한다고 본다.
MemCoach 파이프라인. 기억성 지식을 가진 교사 MLLM의 조언과 중립적인 학생 응답을 대비 데이터로 만든다. 계층별 활성화 차이를 평균해 기억성 조향 벡터를 얻고, 추론 때 이 벡터를 주입해 추가 학습 없이 학생 활성화를 더 나은 기억성 피드백 쪽으로 이동시킨다.시험
시험에는 Qwen2.5-VL, InternVL3.5-8B, Idefics3-8B, LLaVA-OneVision-1.5, 비공개 모델 GPT-5 Mini, 미학 특화 Q-Instruct와 AesExpert 등 7개 MLLM을 사용했다. 각 모델은 제로샷 기준 또는 교사 오라클 역할을 맡았다.
InternVL3.5는 교사와 학생 모두에 사용했고, MemBench 학습 분할로 대비 사례를 만들었다.
MemCoach와 최신 MLLM, 교사 오라클, 미학 특화 모델, 제로샷 기준의 성능 비교. MemCoach는 더 높은 Improvement Ratio, 경쟁력 있는 Relative Memorability, 가장 낮은 perplexity를 보여 더 일관되고 기억성 중심인 피드백을 생성했다.MemCoach는 모든 비교 모델보다 더 효과적인 기억성 조언을 제공했다. 조향된 InternVL3.5는 GPT-5 Mini보다 Improvement Ratio가 5% 높았고, 조향하지 않은 버전보다 Relative Memorability가 31.81% 증가했다.
추가 학습 없이도 미학 특화 시스템을 능가했다. 낮은 perplexity는 사람의 기억성 판단이 선호하는 언어 패턴과 피드백이 더 잘 맞는다는 근거로 제시됐다.
일반화 결과. MemCoach는 여러 멀티모달 백본에서 Improvement Ratio와 Relative Memorability를 일관되게 높였고, 대다수 모델의 perplexity도 낮췄다.추가 시험에서도 MemCoach는 모든 멀티모달 백본의 기억성 피드백을 개선했다. Improvement Ratio는 모두 상승했고, Qwen2.5-VL과 LLaVA-OV에서 증가 폭이 가장 컸다.
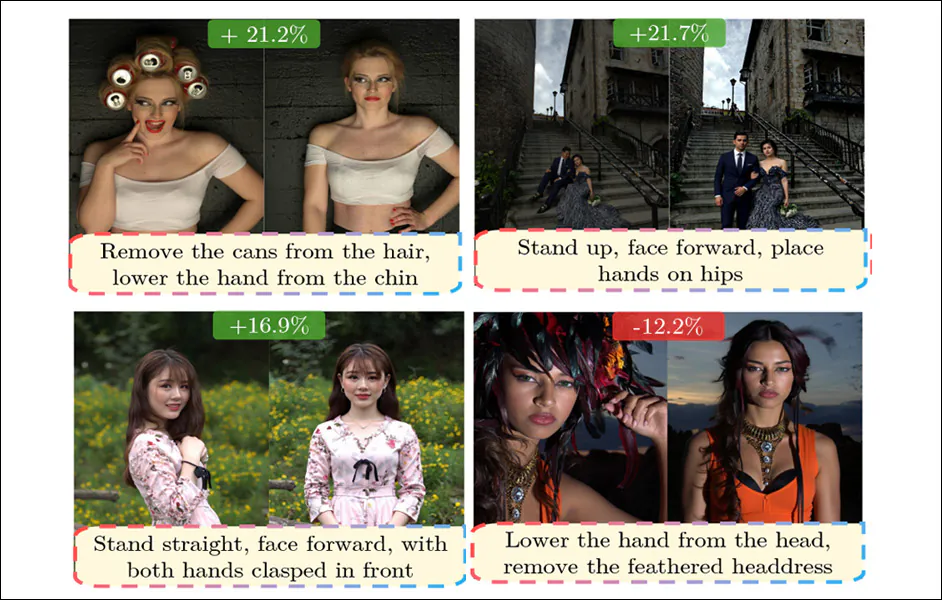
정성 평가에서는 원본 이미지, 자연어 조언, 가상 개선 결과를 나란히 비교했다.
MemCoach의 기억성 피드백 사례. 각 세트는 원본, 자연어 지시, 편집 결과를 보여주고 Relative Memorability로 변화를 나타낸다. 포즈·시선 조정부터 물체 제거 같은 의미적 개입까지 포함하며, 성공한 사례와 독특한 요소를 없애 오히려 기억성을 낮춘 사례를 함께 보여준다.저자들은 시선 방향, 포즈, 손 위치 같은 세밀한 구도 조정부터 물체 제거와 표정 변경까지 제안이 다양하다고 설명한다. 피드백은 주로 “가져오라”, “서라”, “제거하라” 같은 동사를 사용한 짧고 해석 가능한 지시로, 기억에 남는 사진을 찍는 방법을 바로 실행할 수 있게 말로 표현한다.
결론
Google의 비공개 Camera Coach 방법론과 MemBench를 비교한다면 흥미로울 것이다. 특히 Google이 시스템의 미적 기준을 정하기 위해 어떤 중심 규범, 참조 자료, 데이터베이스를 썼는지 알 수 있다.
공개 여부와 무관하게 이런 시스템은 대규모로 쓰일 때 획일적 기준을 강제해 밈과 진부한 관습을 만들 위험이 있다. 이는 일상적 글쓰기에서 ‘정답’처럼 권장되다가 오히려 기피 대상이 된 AI식 em dash 논쟁의 시각적 버전이 될 수 있다.
* 다른 곳에 링크가 없는 경우 필자가 저자의 인라인 인용을 하이퍼링크로 바꿨다.
† 논문은 여러 곳에서 보충 자료를 언급하지만, 논문·Arxiv 페이지·프로젝트 사이트 어디에서도 해당 자료를 찾을 수 없었다.
2026년 2월 26일 최초 게재.


