
Anderson의 관점
1999 년처럼 스트리밍 AI 아바타

 Unite.AI를 Google의 선호 소스에 추가
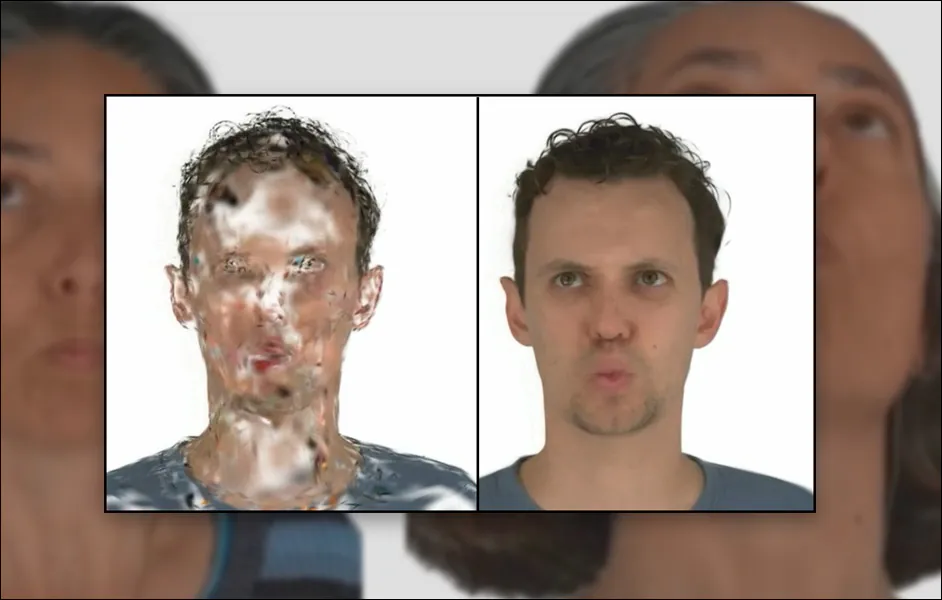
새 연구는 거대한 다운로드가 끝날 때까지 기다리지 않고, 거의 즉시 나타난 뒤 실시간으로 선명해지는 사실적인 3D 아바타를 스트리밍하는 방법을 제시한다.
생성형 AI와 AI 보조 렌더링 시스템의 막대한 자원 요구는 소비자 환경을 20년 이상 과거로 되돌리고 있다. 2023년만 해도 노트북이나 데스크톱의 RAM 64GB는 과하다고 여겨졌지만, RAM·CPU 오프로딩이 보편화된 지금은 로컬 AI 용도로 그리 넉넉하지 않다. 한때 평범하고 저렴했던 PC 부품 가격도 기업의 AI 서비스 수요 경쟁으로 치솟고 있다.
AI 시스템의 규모는 소비자 하드웨어를 쉽게 압도한다. GGUF처럼 로컬용으로 줄인 모델도 평균적 시스템에 부담을 준다. ChatGPT 같은 텍스트 서비스조차 클라이언트와 서버 모두에 큰 부하를 준다면, AI가 실시간 온라인 멀티미디어를 제공할 때는 지연과 품질을 크게 절충해야 한다. 이는 RealPlayer와 QuickTime의 버퍼링 아이콘으로 기억되는 초기 스트리밍 시절과 닮았다.
당시에는 Moore의 법칙에 따라 소비자 하드웨어 성능이 거의 매년 급상승했고 운영체제와 네트워크도 함께 발전했다. 지난 10년가량은 소비자 기술이 멀티미디어 요구를 앞섰지만, 로컬 장비가 더 낮은 사양에 더 비싸지고 AI 서비스가 서버와 로컬 양쪽 자원을 더 요구하면서 그 여유가 끝날 수 있다.
머리부터 먼저 전송하기
브로드밴드 이전에는 progressive JPEG가 적은 대역폭으로 이미지가 서서히 선명해지는 모습을 보여줬다. 더 많은 데이터가 내려올수록 영상이 천천히 형성되던 경험이 AI 보조 Gaussian Splat 아바타에서 다시 나타날 수 있다.
클릭해 재생. ProgressiveAvatars의 스트리밍 비교. 왼쪽의 기존 GaussianAvatars는 데이터가 쌓이는 동안 형상이 심하게 무너지지만, 오른쪽의 ProgressiveAvatars는 세부가 천천히 추가돼도 처음부터 사람처럼 보이는 기본 형상을 유지한다.
두 모델은 Gaussian Splat 기반 아바타다. 이는 1990년대 초로 거슬러 올라가는 비AI 렌더링 기법과 FLAME 파라메트릭 인간 모델, 현대 AI 학습을 결합한 인간 표현 방식이다.

Gaussian Splatting은 픽셀이나 복셀 대신 색과 3D 정보를 Gaussian으로 표현하고, 이를 FLAME이나 STAR 같은 ‘파라메트릭 인간’ CGI 메시 위에 사실적인 질감으로 매핑한다. 출처
기존 방식은 데이터가 로드되는 동안 아바타가 불쾌할 정도로 깨져 보이지만, 중국 연구진의 ProgressiveAvatars는 시작부터 자연스러운 사람 형상을 보여주며 세부를 우아하게 보강한다.
저자들은 이것이 Gaussian 아바타를 실제로 스트리밍하는 최초의 방식이자, 눈과 입술처럼 중요한 부위를 우선해 일부만 로드된 상태에서도 대화 가능한 아바타를 만드는 최초의 점진적 방식이라고 주장한다.
클릭해 재생. ProgressiveAvatars 프로젝트의 주의도 기반 로딩 시각화.
이전의 경량화 시도는 게임 최적화와 비슷한 레벨 오브 디테일(LOD)을 썼다. 사람이 화면에서 차지하는 크기나 주목도에 따라 점점 더 정교한 버전을 불러오는 방식이다. 하지만 여러 해상도의 ‘예비 아바타’를 중복 보관해야 한다. 새 방식은 하나의 계층 표현을 점진적으로 보내므로 더 합리적이며, 사용자 정의 변경도 여러 LOD 복제본에 반복 적용할 필요가 없다.
새로운 스트리밍 영역
이 문제가 틈새로 보일 수 있지만 초기 스트리밍 영상도 한때는 그랬다. AI 기반 스트리밍 표현은 인간 아바타를 넘어 도시 생성, 게임, 의류 가상 착용 등 거의 모든 온라인 3D 영역으로 확장될 수 있다.
클릭해 재생. 2024년 프로젝트가 보여준 온라인 가상 착용의 초기 모습. 다른 연구들은 움직임과 상호작용까지 추가하려 한다.
LOD 기술이 주로 게임에서 쓰였듯, 게임 개발의 다른 고려사항도 splat 기반 표현으로 넘어올 가능성이 크다. 초기 GSplat 사례는 한 사람이 표정을 짓거나 말하는 장면이 대부분이지만, 실제 서비스에는 여러 사람과 환경·분위기를 함께 처리해야 한다. 이때 고성능 우선순위 시스템이 시선이 머무는 곳으로 전송 데이터를 배분해야 몰입이 유지된다.
논문 제목은 ProgressiveAvatars: Progressive Animatable 3D Gaussian Avatars이며, Hefei의 University of Science and Technology of China 연구자 세 명이 작성했다.
방법
먼저 사람의 머리 영상을 사용한다. 각 프레임에 표준 FLAME 파라메트릭 얼굴 모델을 맞춰 시간에 따라 형태와 표정은 바뀌지만 기본 메시 구조는 고정한다. 토폴로지가 변하지 않으므로 매 순간 새로 만들지 않고 안정적인 FLAME 템플릿을 재사용하고 보정할 수 있다.

머리 영상을 추적된 FLAME 메시에 맞춘 뒤 각 면에 3D Gaussian을 붙이고, 화면 공간 기울기가 부족한 세부를 가리키는 영역을 계층적으로 세분한다. 학습 중에는 다중 시점 감독으로 다층 표현을 만들고, 추론 때는 면별 중요도에 따라 어떤 Gaussian을 먼저 보낼지 정해 아바타가 빠르게 나타난 뒤 고해상도 층이 추가될수록 정교해진다.
기본 구조 위에 세부가 층별로 더해진다. 표면은 암묵적인 계층으로 나뉘고, 각 세부 수준의 면에 작은 3차원 Gaussian이 붙는다. 거친 초기 층은 머리 전체 형태와 움직임을 잡고, 후속 미세 층은 주름, 미세 변형, 고주파 질감을 제공한다.
영상은 미분 가능한 Gaussian 래스터라이저로 렌더링되고 다중 시점 실제 영상과 비교해 학습된다. 학습 중 세부가 더 필요한 영역은 화면 공간 신호에 따라 자동으로 추가 분할돼, 관찰자가 오류를 가장 쉽게 알아차릴 위치에 계산 자원을 집중한다.
추론 때 같은 계층이 점진적 스트리밍을 가능하게 한다. 거친 아바타를 먼저 표시한 뒤 추가 층이 도착하면 이미 보인 부분을 바꾸지 않고 Gaussian을 더한다. 따라서 움직일 수 있는 머리 아바타가 즉시 나타나고, 데이터가 올수록 더 선명해진다.
시스템의 핵심은 수신 데이터의 우선순위다.

한 수준의 모든 Gaussian이 있으면 최고 충실도로 렌더링한다. 스트리밍 중에는 기여도가 큰 Gaussian부터 보내야 초기 부분 결과가 최종 영상에 가까워진다. 기여도가 낮은 요소를 먼저 보내면 색 균형이 왜곡되고 사소한 요소가 강조된다.
데이터와 시험
새 방법은 피험자별 다중 시점 영상과 모든 카메라의 보정값을 제공하는 NeRSemble 데이터셋에서 평가됐다.

ProgressiveAvatars 시험에 사용된 NeRSemble 데이터셋의 다양한 피험자 예시. 출처
기존 GaussianAvatars 방법에 맞춰 이미지를 802×550픽셀로 축소하고 전경 마스크를 만들었으며, 원 프로젝트의 학습·시험 분할을 그대로 사용했다. 매개변수 갱신에는 Adam 옵티마이저와 barycentric 좌표 학습률 1×10⁻²를 사용했다. 학습은 6만 회 진행했고 계층은 2천 회마다 자동 확장됐다.
첫 시험은 평면 영상을 FLAME의 표준 CGI 표현을 기준 메시로 삼는 3D 인식 좌표계로 바꾸는 재구성과 애니메이션이었다. 모든 기준 모델을 처음부터 학습했으며 GaussianAvatars와 PointAvatar를 비교 대상으로 사용했다. 평가지표는 PSNR, SSIM, LPIPS였다.

새 시점과 새 표정 합성의 정성 비교. GaussianAvatars 기준 모델은 눈 주변, 주름, 피부 질감의 미세 표현에 어려움을 보인다. 새 방법은 전송 데이터 약 5%만으로 핵심 얼굴 구조를 유지하고, Gaussian이 더 전송될수록 실제 참조 영상에 가까워져 완전한 모델과 거의 일치한다.
연구진은 새 방법이 특히 목, 어깨, 의상 부위에서 더 선명한 세부를 복원한다고 설명한다. FLAME 템플릿에서 이 영역은 눈 주위처럼 주목도가 높은 얼굴 영역보다 거칠게 분할돼 있으므로, 중요도 기반 세분화가 더 큰 효과를 낸다.

PSNR, SSIM, LPIPS를 사용한 새 시점·새 표정 합성의 정량 비교. 전체 전송 시 새 방법은 두 과제에서 가장 높은 PSNR을 기록하고 지각 지표에서도 GaussianAvatars와 경쟁했다. 5% 설정은 극단적인 대역폭 제한에서의 품질 절충을 보여준다.
다음으로 RTX 4090 24GB에서 550×802픽셀 실시간 점진 렌더링을 시험했다. 전송 예산 25%라면 레벨 1 Gaussian 전부와 레벨 2 일부를 사용한다. 낮은 번호 그룹이 기본 캔버스를 만들고 더 높은 그룹이 세부를 누적하는 구조다.

전송 예산별 새 시점·새 표정 합성 성능. RTX 4090에서 실시간 속도를 유지하면서 더 많은 Gaussian과 데이터가 도착할수록 품질이 GaussianAvatars에 접근하거나 이를 넘어선다.
2.60MB, 즉 예산 5%만 전송해도 아바타는 합리적인 품질에 도달했다. 상위 수준 Gaussian이 추가되면 셔츠 단추, 치아, 머리카락이 점차 선명해졌고 시간적 안정성도 유지됐다. 100% 전송에서는 최고 수준 방법과 비슷한 품질을 내면서 프레임 속도가 크게 떨어지지 않았다. 3DGS 작업이 아직 GPU를 포화시키지 않았기 때문으로 보인다.
다만 다중 사용자 VR에서는 3D Gaussian 수가 빠르게 늘어 GPU 래스터화가 병목이 될 수 있다. 이처럼 무거운 환경에서 제안 방식은 프리미티브 수와 시각 품질을 조절해 렌더링을 무너뜨리지 않고 부하를 줄일 수 있다.
논문 본문에 자세히 나오지는 않지만 프로젝트 사이트에는 MeGA 하이브리드 메시-Gaussian 아바타를 포함한 추가 비교 영상도 있다.
클릭해 재생. 프로젝트 사이트의 보충 영상 중 새 시점 합성을 비교한 사례.
결론
Gaussian Splatting이 오래 살아남을지, RealPlayer처럼 대화형 스트리밍의 초창기 기술로만 기억될지는 알 수 없다. AI 기반 또는 AI 보조 3D 인식 경험은 영상 통화, 가상 쇼핑, 경로 안내, 엔터테인먼트로 확장될 수 있다. 다른 기술이 승리할 수도 있고 GSplat이 가장 안정적인 AI 영상 표현이 될 수도 있다.
적어도 이 연구는 새 영역의 가능성을 보여주는 동시에, 대역폭이 부족했던 옛 인터넷을 향수 어린 방식으로 떠올리게 한다.
* 여기서 ‘3D’는 특수 안경이 필요한 경험이 아니라, 멀티미디어 콘텐츠가 X/Y/Z 좌표를 이해하는 형태를 뜻한다.
2026년 3월 18일 최초 게재.


