
Anderson의 관점
Stable Diffusion은 어떻게 대중적인 소비자 제품으로 발전할 수 있을까?

 Unite.AI를 Google의 선호 소스에 추가
핵심 포인트주류 스테이블 디퓨전 앱은 복잡한 명령줄 설치 및 의존성 문제를 해결해야 합니다.
더 보기
- 주류 스테이블 디퓨전 앱은 복잡한 명령줄 설치 및 의존성 문제를 해결해야 합니다.
- 상용 개발자들은 딥페이크 생성과 NSFW 콘텐츠 필터로 인한 법적 위험에 직면해 있습니다.
- 시간적 일관성 및 텍스트 인버전과 같은 고급 기능은 소비자 사용을 위해 클라우드 기반 처리가 필요합니다.
아이러니하게도 Stable Diffusion은 전 세계를 휩쓴 새로운 AI 이미지 합성 프레임워크이지만, 아직 안정적이지도, 널리 보급되지도 않았다.
시스템의 모든 기능은 소수 개발자가 끊임없이 바꾸는 여러 구현에 흩어져 있다. 이들은 Discord의 다양한 토론에서 최신 정보와 이론을 활발히 교환한다. 하지만 이들이 만들거나 수정한 패키지 대부분의 설치 절차는 간편하게 바로 사용하는 방식과 거리가 멀다.
대신 대개 명령줄이나 BAT 파일 기반 설치를 요구하며 GIT, Conda, Python, Miniconda 등 고급 개발 프레임워크를 사용한다. 일반 소비자에게는 드문 소프트웨어 패키지이므로, 설치하면 백신 및 악성코드 방지 업체가 시스템 침해의 징후로 자주 표시한다.

현재 표준 Stable Diffusion 설치에 필요한 단계 중 일부에 불과하다. 여러 배포판은 특정 Python 버전도 요구하며, 사용자의 컴퓨터에 이미 설치된 버전과 충돌할 수 있다. Docker 기반 설치와 어느 정도는 Conda 환경을 사용해 이를 피할 수 있다.
Stable Diffusion의 SFW 및 NSFW 커뮤니티 게시글에는 Python 스크립트와 표준 설치를 수정해 기능을 개선하거나 잦은 의존성 오류 등 문제를 해결하는 요령이 넘친다.
이 때문에 텍스트 프롬프트로 놀라운 이미지를 만들고 싶은 일반 소비자는 늘어나는 유료 웹 API의 처분에 거의 전적으로 의존한다. 대부분은 극소수의 무료 이미지 생성을 제공한 뒤 토큰 구매를 요구한다.
게다가 이러한 웹 기반 서비스 거의 모두는 NSFW 콘텐츠 생성을 거부한다. 여기에는 전쟁처럼 음란물과 무관한 일반 관심 주제도 많이 포함될 수 있다. 이런 콘텐츠를 만들 수 있다는 점이 Stable Diffusion과 OpenAI의 검열된 DALL-E 2 서비스를 구별한다.
Stable Diffusion을 위한 Photoshop
Twitter의 #stablediffusion 해시태그를 매일 채우는 환상적이고 선정적이거나 이세계적인 이미지에 매료된 대중이 기다리는 것은 Stable Diffusion을 위한 Photoshop이다. Stability.ai 아키텍처의 가장 뛰어나고 강력한 기능과 SD 개발 커뮤니티에서 등장하는 창의적인 혁신을 결합한, 여러 플랫폼에 설치할 수 있는 앱을 말한다. 팝업 명령줄 창, 알기 어렵고 계속 바뀌는 설치 및 업데이트 절차, 누락된 기능은 없어야 한다.
현재 기능이 풍부한 설치 대부분에서는 별도 명령줄 창 옆에 다양한 완성도의 웹페이지가 있고, 그 주소는 localhost 포트다.

명령줄 기반 합성 앱인 FaceSwap이나 BAT 중심의 DeepFaceLab처럼 Stable Diffusion의 prepack 설치도 명령줄에서 출발한 흔적을 드러낸다. localhost 포트로 접속하는 인터페이스는 위 이미지 상단에서 볼 수 있으며, 명령줄 기반 Stable Diffusion 기능과 통신한다.
더 편리한 앱이 등장하리라는 점은 분명하다. Patreon을 통해 다운로드할 수 있는 통합 앱도 이미 여럿 있다. GRisk와 NMKD가 그 예다. 아래 이미지를 참고하라. 그러나 더 발전했지만 접근하기 어려운 일부 Stable Diffusion 구현이 제공하는 모든 기능을 아직 통합한 앱은 없다.

Patreon을 통해 제공되는 초기 Stable Diffusion 패키지들은 아직 부분적으로만 완전한 앱 형태를 갖췄다. NMKD는 명령줄 출력을 GUI에 직접 통합한 첫 패키지다.
이 놀라운 오픈 소스 제품을 더 세련되고 통합된 방식으로 구현한다면 어떤 모습일지, 또 어떤 과제에 직면할지 살펴보자.
충분한 자금을 투입한 상용 Stable Diffusion 앱의 법적 고려 사항
NSFW 문제
Stable Diffusion 소스 코드는 매우 허용적인 라이선스로 공개되어, 소스 코드를 폭넓게 활용하는 상업적 재구현과 파생 작업을 금지하지 않는다.
앞서 언급한 Patreon 기반 패키지가 늘어나고 있고, Figma, Krita, Photoshop, GIMP, Blender 등 여러 앱용 플러그인도 개발되고 있다. 자금이 충분한 소프트웨어 회사가 훨씬 정교하고 강력한 Stable Diffusion 앱을 만들 수 없는 실질적인 이유는 없다. 시장 관점에서는 그런 프로젝트 여러 개가 이미 상당히 진행되었다고 볼 근거가 충분하다.
이런 프로젝트는 곧바로 딜레마에 부딪힌다. 대부분의 Stable Diffusion 웹 API처럼 앱에서도 시스템에 내장된 코드 조각인 NSFW 필터를 끌 수 있도록 허용할 것인가?
NSFW 스위치를 숨기기
Stability.ai의 Stable Diffusion 오픈 라이선스는 시스템을 사용해서는 안 되는 용도를 폭넓게 해석할 수 있는 목록으로 제시한다. 여기에는 음란 콘텐츠와 딥페이크가 포함될 수 있다. 그러나 공급자가 이런 사용을 효과적으로 금지하려면, NSFW 필터를 Python 파일의 매개변수 대신 내부를 보기 어려운 실행 파일로 컴파일하거나 NSFW 지시문이 있는 Python 또는 DLL 파일의 체크섬 비교를 강제해야 한다. 사용자가 설정을 바꾸면 렌더링이 불가능해지는 방식이다.
그러면 앱의 기능이 현재 DALL-E 2처럼 제한되어 상업적 매력이 줄어든다. 또한 원래 Python 런타임 요소든, 현재 Topaz의 AI 이미지 개선 도구가 사용하는 컴파일된 DLL이든, 이런 구성 요소를 역컴파일하고 변조한 버전이 결국 토렌트와 해킹 커뮤니티에 나타날 수밖에 없다. 방해 요소를 바꾸고 체크섬 요구를 무효화하면 제한을 풀 수 있기 때문이다.
결국 공급자는 현재 많은 Stable Diffusion 배포판이 처음 실행될 때 보여 주는 Stability.ai의 오용 금지 경고만 되풀이할 수도 있다.
하지만 이런 비공식 면책 문구를 쓰는 소규모 오픈 소스 개발자는 Stable Diffusion을 완전하고 접근하기 쉽게 만들기 위해 상당한 시간과 자금을 투자한 소프트웨어 회사보다 잃을 것이 훨씬 적다. 따라서 회사는 더 깊이 고려해야 한다.
딥페이크에 대한 책임
우리가 최근 지적했듯이, 개발 중인 Stable Diffusion 모델을 훈련한 42억 장의 이미지 일부인 LAION-aesthetics 데이터베이스에는 유명인 사진이 많다. 따라서 사용자는 유명인 딥페이크 음란물을 포함한 딥페이크를 만들 수 있다.

이전 기사에서 가져온 이미지. Jennifer Connelly의 40년 경력 중 네 시기의 모습을 Stable Diffusion이 생성했다.
이는 실제 인물을 묘사하지 않는, 대체로 합법적인 추상적 음란물을 생성하는 것과는 별개의 더 논란 많은 문제다. 물론 그런 이미지도 훈련 자료에 있는 여러 실제 사진에서 추론된다.
미국의 점점 더 많은 주와 여러 국가가 딥페이크 음란물 금지법을 마련하거나 시행하고 있으므로, Stable Diffusion의 유명인 음란물 생성 능력은 완전히 검열되지 않은 상용 앱, 즉 음란물을 만들 수 있는 앱에도 유명인 얼굴을 필터링하는 기능이 필요할 수 있음을 뜻한다.
한 가지 방법은 유명인 이름과 그와 관련된 가상 인물 등 사용자 프롬프트에서 허용하지 않을 용어의 내장 차단 목록을 제공하는 것이다. 원본 데이터에는 다른 언어도 포함되므로 영어 외 여러 언어에 설정을 적용해야 할 수 있다. Clarifai 같은 회사의 유명인 인식 시스템을 통합하는 방법도 있다.
소프트웨어 제작사는 이런 기능을 불법화할 수 있는 새 법률을 기다리는 동안, 완전한 독립형 Stable Diffusion 앱이 유명인 얼굴을 생성하지 못하도록 돕는 방법을 제공해야 할 수도 있다. 처음에는 꺼져 있을 수도 있다.
물론 이런 기능도 관심 있는 이들이 역컴파일하고 무력화할 수 있다. 그러나 역공학이 지나치게 쉬워지지만 않는다면, 제작사는 이를 허가받지 않은 파괴 행위라고 주장할 수 있다.
포함될 수 있는 기능
자금이 충분한 상용 앱이라면 모든 Stable Diffusion 배포판의 기본 기능을 제공해야 한다. 여기에는 텍스트 프롬프트로 적절한 이미지를 만드는 텍스트-이미지 생성, 스케치나 다른 이미지를 새 이미지의 가이드로 쓰는 이미지-이미지 생성, 시스템의 상상력을 조절하는 수단, 렌더링 시간과 품질 사이의 선택 등이 있다. 이미지와 프롬프트의 선택적 자동 보관, RealESRGAN을 통한 일반적인 선택적 확대, 적어도 GFPGAN 또는 CodeFormer를 통한 기본 얼굴 수정 같은 기능도 포함된다.
이는 상당히 기본적인 설치다. 현재 개발되거나 확장되고 있으며, 완전한 전통적 Stable Diffusion 앱에 포함할 만한 고급 기능을 살펴보자.
확률적 인코딩 고정
이전에 성공한 렌더링의 시드를 재사용하더라도, 다음 렌더링에서 프롬프트나 원본 이미지 또는 둘 다의 어느 한 부분이라도 바뀌면 Stable Diffusion이 변환을 정확히 반복하도록 하기란 매우 어렵다.
EbSynth를 이용해 Stable Diffusion 변환을 실제 영상에 시간적으로 일관되게 적용하려는 경우 문제가 된다. 다만 단순한 머리와 어깨 구도에는 매우 효과적일 수 있다.
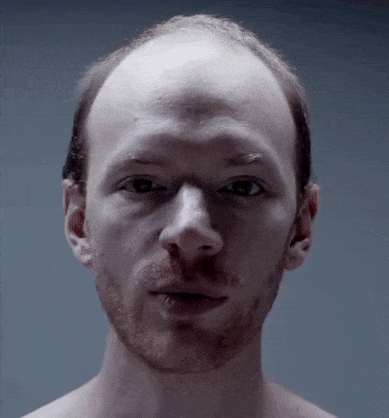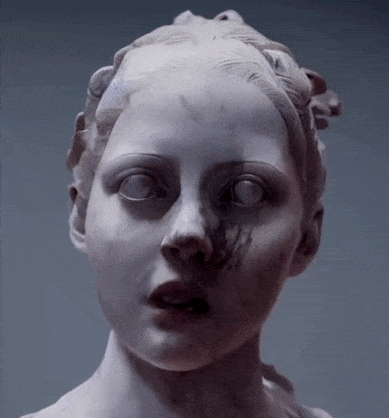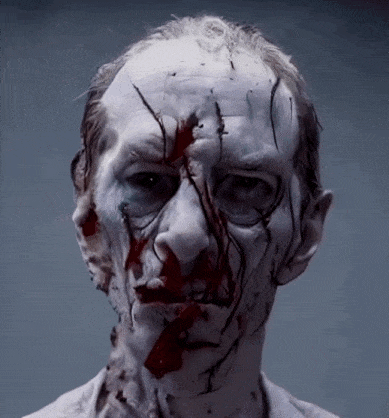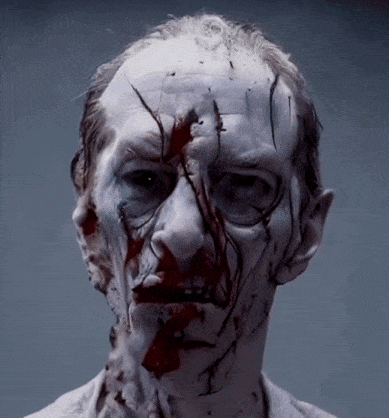
움직임이 제한적이면 EbSynth는 Stable Diffusion 변환을 사실적인 영상에 적용하는 효과적인 수단이 될 수 있다. 출처: https://streamable.com/u0pgzd
EbSynth는 변경한 소수의 키프레임을 이미지 파일 시퀀스로 변환된 영상 전체로 확장해 적용한다. 이미지들은 나중에 다시 영상으로 조립할 수 있다.

EbSynth 사이트의 이 사례에서는 영상의 소수 프레임을 예술적으로 채색했다. EbSynth는 이를 스타일 가이드로 삼아 전체 영상을 비슷하게 바꾸어 채색된 스타일에 맞춘다. 출처: https://www.youtube.com/embed/eghGQtQhY38
아래 사례에서 왼쪽의 실제 금발 요가 강사는 거의 움직이지 않는다. 그런데도 Stable Diffusion은 일관된 얼굴을 유지하기 어렵다. 키프레임으로 변환되는 세 이미지가 같은 숫자 시드를 사용하면서도 완전히 같지 않기 때문이다.

세 변환에서 같은 프롬프트와 시드를 쓰고 원본 프레임의 차이가 매우 작아도, 근육의 크기와 모양이 달라진다. 더 중요한 것은 얼굴이 일관되지 않아 EbSynth 영상으로 만들 때 시간적 일관성을 방해한다는 점이다.
아래 EbSynth/SD 영상은 사용자의 손가락을 각각 걸어 다니는 바지와 오리로 바꾸는 매우 창의적인 사례다. 하지만 바지의 불일치는 원본 프레임이 비슷하고 시드가 같아도 Stable Diffusion이 여러 키프레임 사이에서 일관성을 유지하기 어렵다는 문제를 보여 준다.
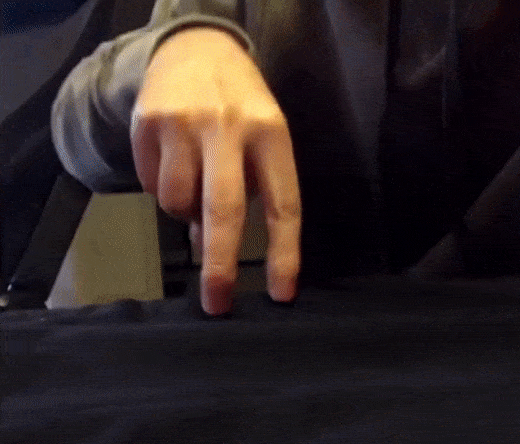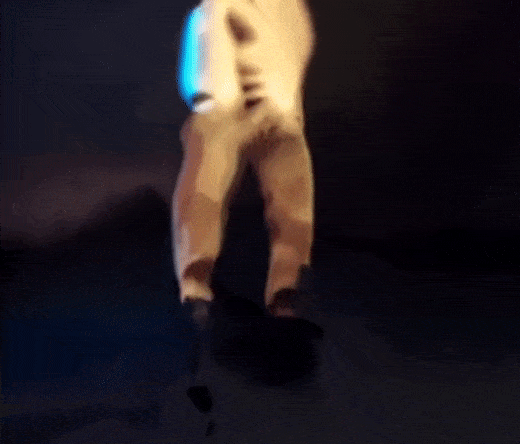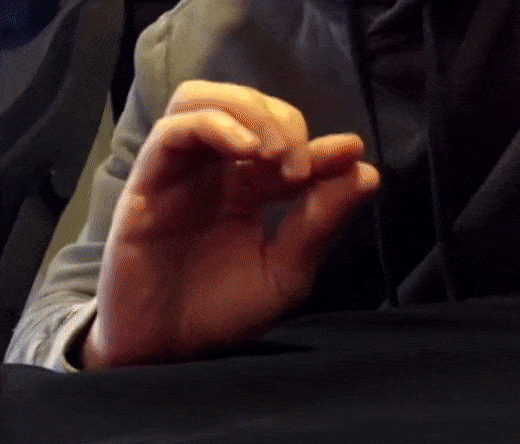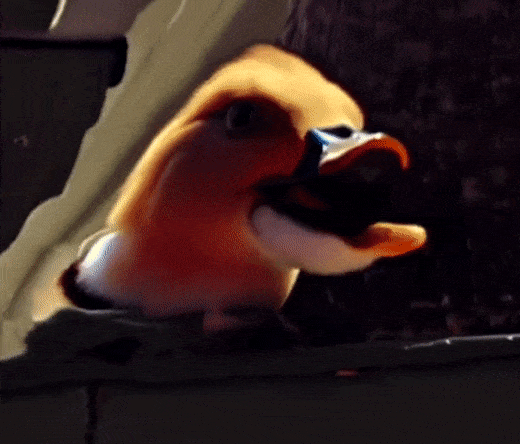
Stable Diffusion과 EbSynth를 통해 한 남자의 손가락이 걸어 다니는 사람과 오리로 변한다. 출처: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
영상을 만든 사용자는 이렇게 설명했다. 둘 중 오리 변환이 더 효과적이라고 할 수 있지만 덜 인상적이고 독창적인 대신, 변환된 키프레임이 하나만 필요했다. 반면 걸어 다니는 바지는 Stable Diffusion 이미지 50장을 렌더링해야 했으며 시간적 불일치가 더 두드러진다. 사용자는 키프레임 50장 각각에서 일관성을 얻으려면 다섯 번씩 시도해야 했다고 덧붙였다.
따라서 정말 종합적인 Stable Diffusion 앱이라면 키프레임 사이의 특성을 최대한 보존하는 기능이 큰 이점이 될 것이다.
한 가지 방법은 각 프레임의 변환에 쓰이는 확률적 인코딩을 사용자가 고정하게 하는 것이다. 현재는 소스 코드를 직접 수정해야만 가능하다. 아래 사례처럼 시간적 일관성에 도움이 되지만 문제를 완전히 해결하지는 못한다.
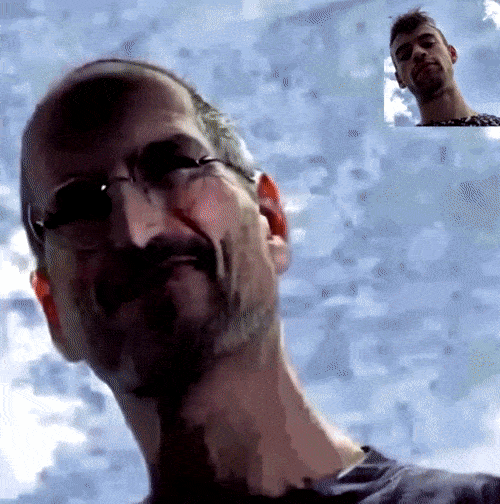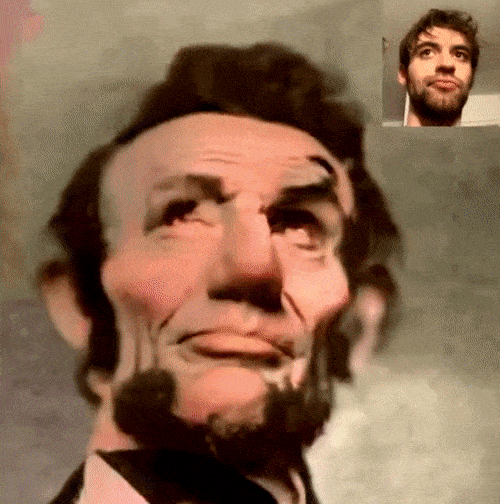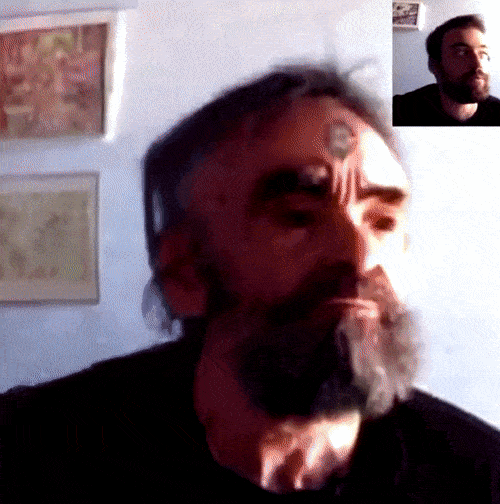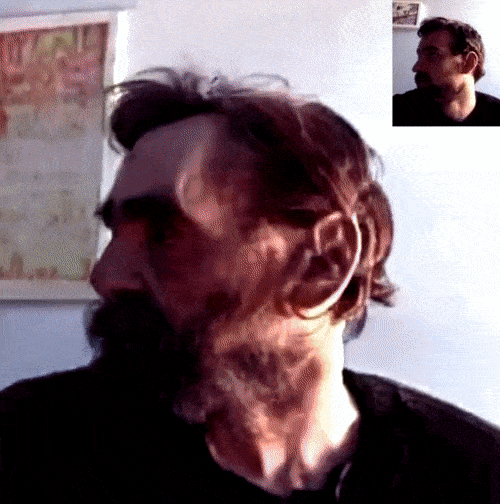
한 Reddit 사용자는 자신의 웹캠 영상을 여러 유명인의 모습으로 변환했다. 모든 Stable Diffusion 구현이 유지할 수 있는 시드를 고정했을 뿐 아니라, 각 변환의 stochastic_encode() 매개변수도 같도록 했다. 코드를 수정해 구현했지만 사용자용 스위치로 쉽게 제공할 수 있다. 그러나 모든 시간적 문제를 해결하지는 못한다. 출처: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
클라우드 기반 텍스트 반전
시간적으로 일관된 인물과 사물을 만드는 더 나은 방법은 이를 텍스트 반전 파일에 담는 것이다. 주석을 단 이미지 다섯 장만으로 몇 시간 안에 훈련할 수 있는 5KB 파일이며, 특별한 * 프롬프트로 불러올 수 있다. 예를 들어 이야기 속 새 등장인물이 계속 같은 모습으로 나타나도록 할 수 있다.

적절한 태그가 붙은 이미지를 텍스트 반전으로 개별 개체로 만들고, 특별한 토큰 단어를 통해 모호함 없이 올바른 맥락과 스타일로 불러올 수 있다. 출처: https://huggingface.co/docs/diffusers/training/text_inversion
텍스트 반전은 Stable Diffusion이 사용하는 매우 크고 완전히 훈련된 모델에 붙는 보조 파일이다. 생성 및 프롬프트 처리에 끼워 넣어 모델이 만든 장면에 참여하고, 사물과 스타일, 환경, 상호작용에 관한 모델의 방대한 지식을 이용할 수 있다.
훈련 시간은 길지 않지만 VRAM이 많이 필요하다. 현재 여러 튜토리얼에서는 12GB, 20GB, 심지어 40GB를 언급한다.
대부분의 일반 사용자가 이런 GPU 용량을 갖추기는 어려워 작업을 대신하는 클라우드 서비스가 등장하고 있다. Hugging Face 버전도 그중 하나다. Stable Diffusion용 텍스트 반전을 만드는 Google Colab 구현도 있지만, VRAM과 시간 요구량 때문에 Colab 무료 요금제 사용자에게는 어려울 수 있다.
충분한 투자를 받은 완전한 설치형 Stable Diffusion 앱이라면 무거운 작업을 회사 클라우드 서버로 넘기는 것이 분명한 수익화 전략이다. 저가 또는 무료 앱이 이런 유료 기능을 포함한다는 전제다. 향후 6~9개월 동안 이 기술에서 나올 많은 앱에서 그럴 가능성이 높아 보인다.
또한 제공된 이미지와 텍스트에 주석을 달고 형식을 맞추는 상당히 복잡한 작업도 통합 환경에서 자동화할 수 있다. Stable Diffusion의 광대한 세계를 탐험하고 상호작용하는 고유 요소를 만드는 일은 일반 애호가와 젊은 사용자 모두에게 매우 중독적일 수 있다.
유연한 프롬프트 가중치
긴 텍스트 프롬프트의 일부를 더 강조하도록 하는 구현이 현재 많이 있지만, 조작 방식은 크게 다르고 흔히 번거롭거나 직관적이지 않다.
예를 들어 인기 있는 AUTOMATIC1111의 Stable Diffusion 버전은 단어나 구절을 한 겹 또는 여러 겹의 소괄호에 넣어 강조를 낮추거나, 대괄호에 넣어 강조를 높일 수 있다.

이 Stable Diffusion 프롬프트 가중치 구현에서는 대괄호와 소괄호로 아침 식사를 바꿀 수 있다. 하지만 어느 쪽이든 콜레스테롤의 악몽이다.
다른 Stable Diffusion 구현은 느낌표로 강조하며, 가장 유연한 구현은 GUI에서 프롬프트의 각 단어에 가중치를 줄 수 있다.
시스템은 음의 프롬프트 가중치도 지원해야 한다. 이는 공포물 애호가만을 위한 것이 아니다. 제한된 언어 사용으로 불러낼 수 있는 것보다 덜 무섭고 더 유익한 신비가 Stable Diffusion의 잠재 공간에 있을 수 있기 때문이다.
아웃페인팅
Stable Diffusion이 큰 반향을 일으키며 오픈 소스로 공개된 직후, OpenAI는 발표한 아웃페인팅으로 DALL-E 2에 대한 관심을 일부 되찾으려 했지만 대부분 실패했다. 아웃페인팅은 의미적 논리와 시각적 일관성을 유지하면서 이미지를 경계 바깥으로 확장한다.
자연스럽게 이 기능은 그 뒤 Stable Diffusion에서 여러 형태로 구현되었고, Krita에도 적용되었다. Photoshop 같은 종합 Stable Diffusion 버전에도 반드시 포함되어야 한다.
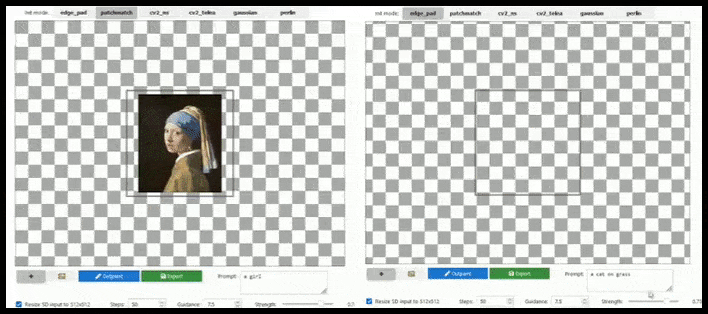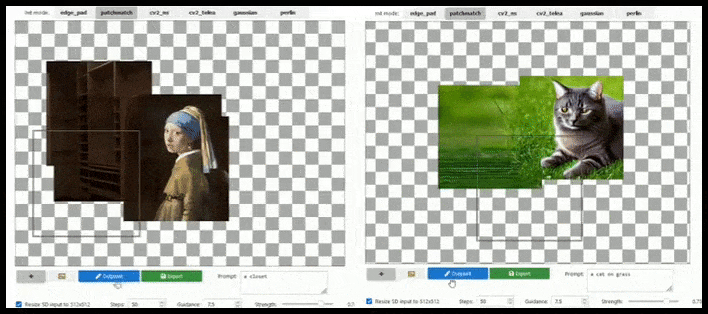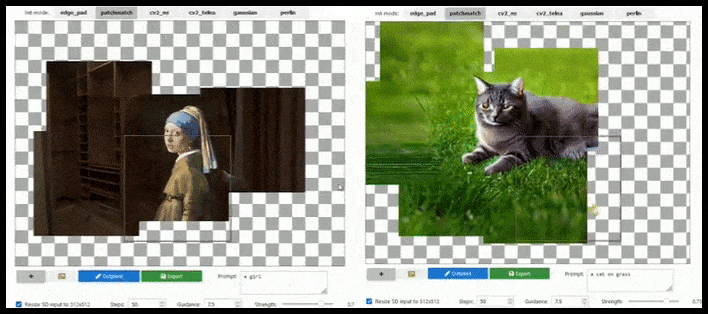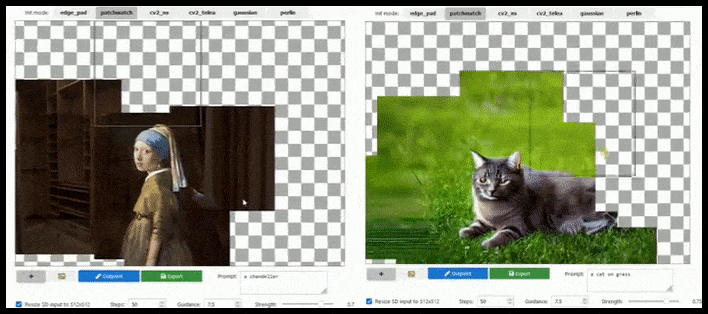
타일 기반 확장은 프롬프트, 기존 이미지, 의미적 논리가 허용한다면 표준 512×512 출력을 거의 무한히 확장할 수 있다. 출처: https://github.com/lkwq007/stablediffusion-infinity
Stable Diffusion은 512×512픽셀 이미지로 훈련되었고 다른 여러 이유도 있어, 프롬프트가 머리를 강조하라고 명시하더라도 인물의 머리나 중요한 신체 부위를 자주 잘라 낸다.

Stable Diffusion에서 머리가 잘리는 전형적인 사례들. 하지만 아웃페인팅은 George를 다시 화면에 넣을 수 있다.
위 움직이는 이미지와 같은 아웃페인팅 구현은 전적으로 Unix 라이브러리에 기반하지만 Windows에서도 재현할 수 있어야 한다. 또 이 문제를 클릭 한 번이나 프롬프트 하나로 해결하는 도구를 제공해야 한다.
현재 일부 사용자는 머리가 잘린 이미지의 캔버스를 위로 늘리고 머리 영역을 대략 채운 뒤 img2img로 실패한 출력을 완성한다.
맥락을 이해하는 효과적인 마스킹
마스킹은 Stable Diffusion의 분기나 버전에 따라 결과가 매우 불확실할 수 있다. 일관된 마스크를 그릴 수 있더라도, 지정한 영역이 이미지 전체의 맥락을 고려하지 않은 내용으로 채워지는 경우가 많다.
한번은 얼굴 이미지의 각막에 마스크를 씌우고 파란 눈이라는 프롬프트로 인페인팅했다. 그런데 마치 도려낸 두 사람 눈을 통해 멀리 있는 기괴한 늑대 그림을 보는 듯한 결과가 나왔다. Frank Sinatra가 아니었던 것이 다행이다.
이미지를 처음 만든 노이즈를 식별해 의미적 편집을 할 수도 있다. 이미지의 나머지 부분을 건드리지 않고 특정 구조 요소를 다룰 수 있다.

이미지를 처음 생성한 노이즈를 찾아 목표 영역에 기여한 부분을 조정하면, 기존 마스킹 없이 주변 내용을 바꾸지 않고도 한 요소를 변경할 수 있다. 출처: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
이 방법은 K-Diffusion 샘플러에 기반한다.
해부학적 오류를 거르는 의미적 필터
앞서 말했듯이 Stable Diffusion은 팔다리를 자주 더하거나 빼 버린다. 주로 데이터 문제와 훈련 이미지에 붙은 주석의 부족 때문이다.

학교 단체 사진에서 혀를 내민 장난꾸러기처럼, Stable Diffusion의 기이한 신체 오류가 항상 즉시 보이지는 않는다. 여분의 손이나 녹은 듯한 팔다리를 알아채기 전에 최신 AI 걸작을 Instagram에 올릴 수도 있다.
이런 오류는 고치기 매우 어렵다. 따라서 완전한 Stable Diffusion 앱에 의미적 분할을 이용하는 해부학 인식 시스템이 있으면 유용할 것이다. 들어오는 이미지에 위와 같은 심한 해부학적 결함이 있는지 계산하고, 사용자에게 보여 주기 전에 버린 뒤 새로 생성할 수 있다.

물론 여신 Kali나 닥터 옥토퍼스를 만들고 싶을 수도 있고, 팔다리가 잘못된 이미지에서 영향을 받지 않은 부분을 구하고 싶을 수도 있다. 그러므로 이 기능은 선택적으로 켜고 끌 수 있어야 한다.
사용자가 원격 측정 데이터 수집을 받아들인다면, 이런 실패 사례를 익명으로 전송해 연합학습의 공동 노력에 활용할 수도 있다. 미래 모델이 해부학적 논리를 더 잘 이해하도록 도울 수 있다.
LAION 기반 자동 얼굴 개선
Stable Diffusion이 앞으로 해결할 세 가지 문제를 이전에 살펴보면서 말했듯이, 처음 생성한 얼굴을 개선하는 작업을 어떤 GFPGAN 버전에만 맡겨서는 안 된다.
GFPGAN의 개선은 매우 획일적이며, 묘사한 사람의 정체성을 훼손하는 경우가 많다. 또 이미지의 다른 부분보다 더 많은 처리 시간이나 주의를 받지 못해 이미 제대로 생성되지 않은 얼굴만 대상으로 작업한다.
그러므로 전문적인 Stable Diffusion 프로그램은 YOLO 같은 표준적이고 비교적 가벼운 라이브러리로 얼굴을 인식하고, 사용할 수 있는 GPU 전력을 모두 투입해 다시 생성해야 한다. 개선한 얼굴을 전체 맥락이 있는 원본에 혼합하거나, 수동 재합성을 위해 별도로 저장할 수 있어야 한다. 현재 이 작업에는 상당한 수동 개입이 필요하다.
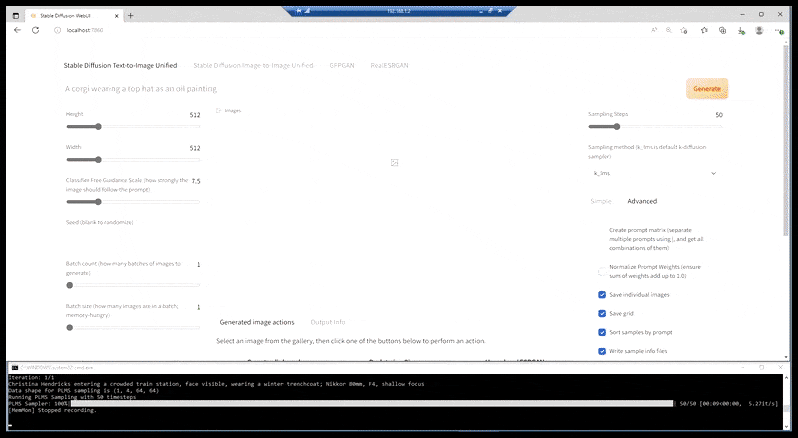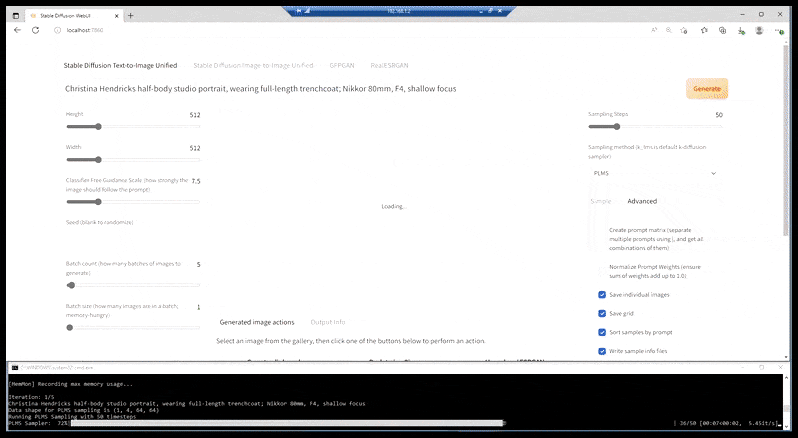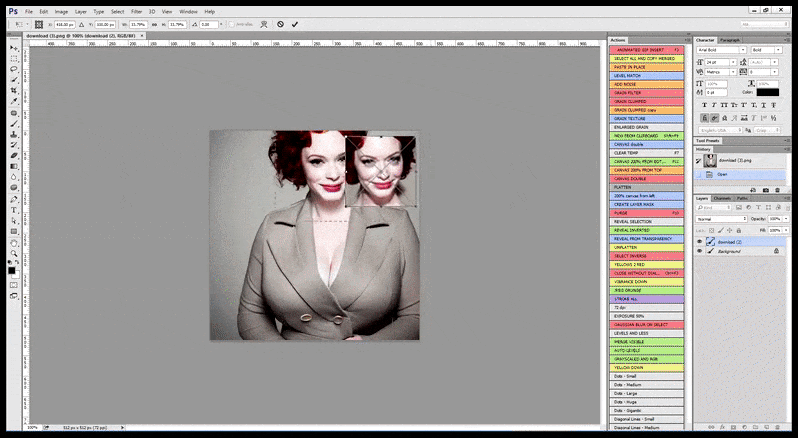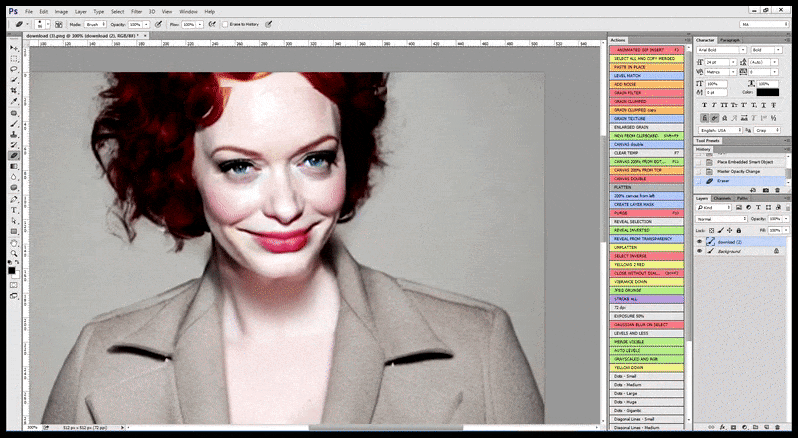
Stable Diffusion이 특정 유명인의 이미지를 충분히 학습했다면, 다음 렌더링에서 GPU 전체 용량을 이미지의 얼굴만 생성하는 데 집중할 수 있다. 보통 눈에 띄게 개선되며, GFPGAN과 달리 생성된 픽셀만 조정하는 대신 LAION 훈련 데이터의 정보를 이용한다.
앱 내부 LAION 검색
LAION 데이터베이스에서 개념과 인물, 주제를 검색하면 Stable Diffusion을 더 잘 사용할 수 있음을 사용자가 알게 된 후, haveibeentrained.com을 비롯한 여러 온라인 LAION 탐색 도구가 생겼다.

haveibeentrained.com의 검색으로 사용자는 Stable Diffusion을 뒷받침하는 이미지를 탐색하고, 생성하려는 사물과 인물, 아이디어가 학습되었을 가능성을 알아볼 수 있다. 유명인이 어떻게 묶여 있는지 또는 현재 생각에서 이어지는 다음 아이디어가 무엇인지처럼 인접한 개체를 발견하는 데도 유용하다. 출처: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
이 웹 데이터베이스는 이미지에 붙은 태그를 일부 보여 주지만, 모델 훈련 중 일어나는 일반화 때문에 특정 이미지의 태그를 프롬프트로 쓰는 것만으로 그 이미지를 불러올 가능성은 낮다.
또 자연어 처리에서 불용어를 제거하고 어간 추출과 표제어 추출을 수행하므로, 보이는 문구 중 다수는 Stable Diffusion 훈련 전에 분리되거나 생략되었다.
그렇더라도 이런 인터페이스에서 미적 그룹이 연결되는 방식은 사용자에게 Stable Diffusion의 논리, 어쩌면 성격에 대해 많은 것을 가르치고 더 나은 이미지 제작을 도울 수 있다.
결론
완전한 네이티브 데스크톱 Stable Diffusion 구현에서 보고 싶은 다른 기능도 많다. 예를 들어 CLIP 기반 이미지 분석은 표준 Stable Diffusion 과정을 반대로 수행해, 시스템이 원본 이미지나 생성물과 자연스럽게 연결할 문구와 단어를 사용자에게 알려 줄 수 있다.
또 진정한 타일 기반 확대도 반가운 기능이다. ESRGAN은 GFPGAN만큼이나 정교함이 부족하기 때문이다. 다행히 GOBIG의 txt2imghd 구현을 통합하려는 계획으로 이 기능이 여러 배포판에서 빠르게 실현되고 있다. 데스크톱 버전에도 당연히 어울리는 선택이다.
Discord 커뮤니티의 다른 인기 요청인 내장 프롬프트 사전, 적용할 수 있는 화가와 스타일 목록에는 관심이 덜하다. 다만 앱 내 메모장이나 사용자 정의 문구 사전은 합리적인 추가 기능 같다.
마찬가지로 CogVideo와 여러 프로젝트가 시작을 이끈 Stable Diffusion의 사람 중심 애니메이션도 아직 매우 초기 단계다. 실제 사람 움직임의 시간적 사전 지식에 관한 기초 연구에 좌우된다.
현재 Stable Diffusion 영상은 철저히 환각적이지만, EbSynth와 아직 초기 단계인 다른 텍스트-비디오 프로젝트를 통한 딥페이크 인형극에는 가까운 미래가 더 밝을 수 있다. Runway의 최근 홍보 영상에 합성하거나 변형한 사람이 없다는 점도 주목할 만하다.
또 유용한 기능은 Photoshop과의 원활한 이미지 교환이다. Cinema4D의 텍스처 편집기 등 유사한 도구에 오래전부터 구현된 기능이다. 이미지를 앱 사이로 쉽게 보내 각 앱이 가장 잘하는 변환에 사용할 수 있다.
마지막으로, 어쩌면 가장 중요하게도 완전한 데스크톱 Stable Diffusion 프로그램은 시스템의 기반 모델 버전인 체크포인트를 쉽게 바꿀 수 있어야 할 뿐 아니라, 예전 공식 모델에서 작동했던 사용자 정의 텍스트 반전을 업데이트할 수 있어야 한다. 공식 Discord 개발자들이 가능성을 언급했듯이, 새 모델 버전에서 이런 파일이 작동하지 않을 수 있기 때문이다.
아이러니하게도 이런 강력하고 통합된 Stable Diffusion 도구 모음을 만들 최적의 조직인 Adobe는 콘텐츠 진위 이니셔티브와 매우 강하게 연계되어 있어, 이런 제품은 회사의 홍보상 후퇴로 보일 수도 있다. 다만 OpenAI가 DALL-E 2에 했듯이 생성 능력을 철저히 제한하고, 자사의 방대한 스톡 사진 자산이 자연스럽게 발전한 것으로 포지셔닝한다면 예외일 것이다.
최초 발행: 2022년 9월 15일.


