Anderson의 관점

시각적 유사성을 AI에 적용하기

mm
Unite.AI를 Google의 선호 소스에 추가
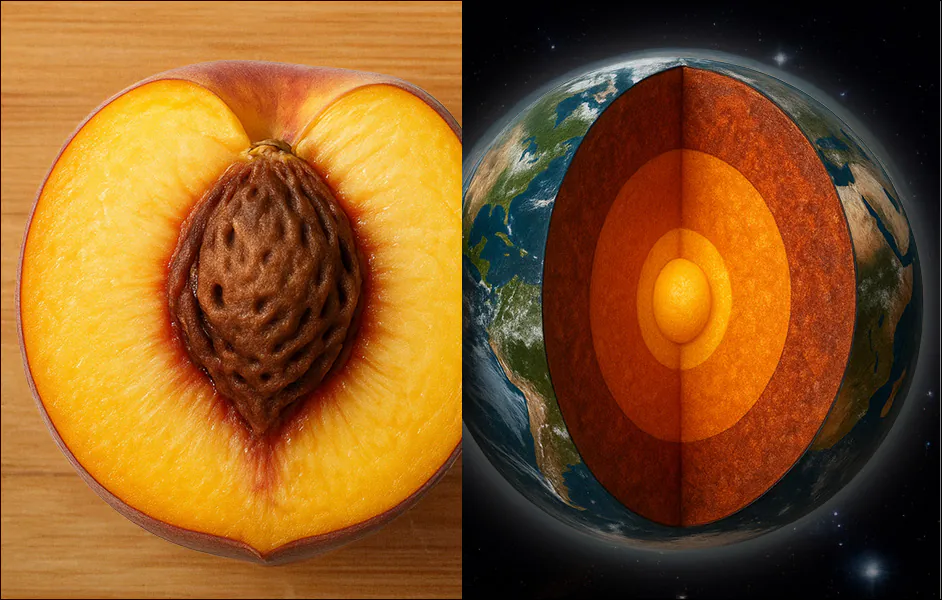
AI-generated image: comparative cross-sections of a peach and the planet Earth. GPT-image-1, Firefly 3.

모델은 많지만, 현재의 비교 시스템은 상상력이 부족하다. 1960년대 클래식 노래 현재 AI 모델은 ‘관계적’ 이미지 유사성을 인식하지


컴퓨터 비전 못한다. 예를 들어, 지구의 층과 복숭의 유사성은 인간이 이미지에 대해 인식하는 중요한 측면이다. 의 이러한 가사를 생각해보자: Windmills of Your Mind 비교는 인간에게

복숭과 지구의 단면은 유사한 논리 구조를 가지고 있기 때문에 유사한 것으로 인식된다. 이러한 방식으로 우리는 서로 관련이 없는 객체와

의미 있는 시적 은유의 영역을 대표한다. 이것은 예술적 표현을 넘어서 우리가 지각 시스템을 개발하는 방식과 관련이 있다. 객체를 만들면서 우리는 시각적 유사성을 개발한다. 예를 들어, 객체 유형 사이의연결을 유추할 수 있다. 또한 중력, 운동량, 표면 응집성과 같은 시스템을 추론할 수 있다. 이러한 시스템은 다양한 영역과 규모에서 적용할 수 있다. 회전하는 회전목마처럼, 달을 둘러싸는 원을 그리며 시계의 손이 시간을 가리키는 것처럼 세계는 조용히 공전하는 사과처럼

보는 것

最新의 이미지 비교 AI 시스템인 LPIPS와 DINO는 인간의 피드백을 받았지만, 여전히표면 비교만수행한다. 이 시스템은 얼굴을 찾는 알고리즘이 사용하는 저수준 얼굴 구조 특징으로 인해 얼굴이 없는 곳에서 얼굴을 찾을 수 있다. 이것은 인간이 개발하는 시각적 유사성 메커니즘을 대표하지 않는다. False positives for facial recognition in the ‘Faces

False positives for facial recognition in the 'Faces with Things' dataset. Source - https://arxiv.org/pdf/2409.16143 with Things’ dataset. Source 미국 연구진은 ‘관계적 시각적 유사성’에 대한

연구를 수행했다. 새로운 데이터셋을 구축하여 추상적인 관계를 형성하도록 설계했다. Most AI models only recognize similarity when images share (above) tosurface traits such as shape or color, which is why they would link only Group B

Most AI models only recognize similarity when images share surface traits like shape or color, which is why they link only Group B (above) to the reference. Humans, by contrast, also see Group A as similar – not because the images look alike, but because they follow the same underlying logic, such as showing a transformation over time. The new work attempts to reproduce this kind of structural or relational similarity, aiming to bring machine perception closer to human reasoning. Source: https://arxiv.org/pdf/2512.07833 참고 자료. 반면 인간은 그룹 A를 유사하게 인식합니다. 이미지가 비슷해 보여서가 아니라, 시간의 흐름에 따른 변화를 보여주는 등 동일한 기본 논리를 따르기 때문입니다. 이번 연구는 이러한 구조적 또는 관계적 유사성을 재현하여 기계의 인식을 인간의 인식에 더 가깝게 만드는 것을 목표로 합니다.reasoning . Source: https://arxiv.org/pdf/2512.07833 데이터셋에는 114,000개의 이미지와 그에 해당하는 캡션이 포함되어 있다. 캡션은 추상적인 논리 구조를 강조하도록 설계되었다. The predicted ‘anonymous’ captions that

The predicted 'anonymous' captions that contribute to the authors' 'relsim' metric. contribute to the authors’ ‘relsim’ metric. 캡션은

Qwen 모델을 사용하여 생성되었으며, 추상적인 논리 구조를 강조하도록 설계되었다. theA comparison between captioning style of typicaldatasets,which

A comparison between the captioning style of typical datasets, which focuses on attribute similarity, whereas the relsim approach (bottom row) emphasizes relational similarity. focuses on attribute similarity, whereas the relsim approach (bottom row) emphasizes relational similarity. 새로운 접근

방식은 인지 과학의 방법론을 사용한다. 특히 Dedre Gentner의 구조 매핑 이론과 Amos Tversky의 관계적 유사성과 속성 유사성의 정의를 사용한다. From the associated

From the associated project website, an example of relational similarity. Source - https://thaoshibe.github.io/relsim/ project website, an example of relationalsimilarity .

Source 연구진은

다음과 같이 말한다: ‘인간은 속성 유사성을 지각적으로 처리하지만, 관계적 유사성은 개념적 추상을 필요로 한다. 이것은 언어나 이전 지식에 의해 지원될 수 있다. 따라서 관계적 유사성을

인식하는 것은 먼저 사용하여, 그이미지를 이해하고, 지식을 아래에 있는 구조를 추상화하는 것을 필요로 한다.’

방법

연구진은 LAION-2B 데이터셋을 사용하여 관계적 이미지 비교를 수행했다.

Metadata for an entry in the LAION-2B collection. Source - https://huggingface.co/datasets/laion/laion2B-en-aesthetic/viewer/default/train Metadata for an entry

in the LAION-2B collection. Source 114,000개의 이미지와 그에 해당하는 캡션이 포함된 데이터셋을 구축했다. 캡션은 Qwen 모델을 사용하여생성되었다. The relsim system

The relsim system is trained in three stages: filtering images from LAION-2B for relational content; assigning each group a shared anonymous caption that captures their underlying logic; and learning to match images to those captions using a contrastive loss. is trained in three stages: filtering images from LAION-2B for relational content; assigning each group

a

다음과 같이 말한다: ‘주석자는 다음과 같이 지시받았다: “이 이미지에 관계적 패턴, 논리, 또는 구조를 볼 수 있나요? 이 이미지를

그들의 기본 논리를 포착한 익명의 공유 캡션; 그리고 대조 손실을 사용하여 이미지와 캡션을 일치시키는 방법을 학습합니다. 연구진은 다른 했다.이미지와 연결할 수 있나요?”‘ 관계적 레이블을 생성하기 위해 연구진은 Qwen 모델을 사용하여 이미지 세트의 공통된 논리 구조를 설명하도록

데이터와 테스트

연구진은 Qwen2.5-VL-7B 모델을 사용하여 관계적 이미지 비교를 수행했다. 114,000개의 이미지와 그에해당하는 캡션이 포함된 데이터셋을 구축했다. 데이터셋은 100,000개의 이미지로 훈련되고, 14,000개의 이미지로 평가되었다. 테스트를 위해 검색 설정을 사용했다. 질의 이미지를 주고, 28,000개의 이미지 풀에서 관계적 유사성을 가진 이미지를 찾도록 했다. GPT-4o 모델을 사용하여 관계적 유사성을 평가했다. 사용자 연구도 수행했다. 각 참가자는 익명화된 질의 이미지를 두 개의 후보 이미지와 함께 보았다.참가자는 두 이미지가 질의 이미지와 얼마나 관계적 유사성이 있는지 평가했다. 연구진은 다음과 같이 말한다: ‘이 방법은 관계적 유사성을 더 잘 캡처한다. 관계적 유사성은 인간이 이미지에 대해 인식하는 중요한 측면이다.’

기존 메트릭과 관계적 유사성

연구진은 기존

Comparison of retrieval performance as judged by GPT-4o, showing the average relational similarity score for each method. Conventional similarity metrics such as LPIPS, DINO, and CLIP-I scored lower. Caption-based baselines Qwen-T and CLIP-T also underperformed. The highest score was achieved by relsim (6.77, right-most blue column), indicating that fine-tuning on group-based relational patterns improved alignment with GPT-4o’s assessments. 메트릭이 관계적 유사성을 캡처할 수 있는지 테스트했다. Comparison of retrieval performance as judged by

GPT-4o, showing

the average relational similarity score for each method. Conventional similarity metrics

DINO, and CLIP-I scored lower. Caption-based

such as LPIPS,

관계형 검색은 표면 특징을 일치시키는 것이 아니라 쿼리와 더 깊은 개념 구조를 공유하는 이미지를 반환합니다. 예를 들어, 얼굴을 닮은 스타일의 식품 항목은 다른 의인화된 식사를 검색합니다. 슬라이스된 객체는 다른 슬라이스 형태를 생성합니다. 성체-자손 상호 작용 장면은 종과 구성이 다른 경우에도 유사한 관계 역할을 가진 이미지를 반환합니다. baselines Qwen-T and CLIP-T also underperformed. The highest score was achieved by relsim

(6.77,

that fine-tuning on group-based relational patterns improved

right-most blue column), indicating연구진은alignment with GPT-4o’s assessments.

입력 이미지와 관계형 프롬프트가 주어지면 모델은 동일한 기본 개념을 표현하는 새로운 이미지를 생성하도록 요청 받았습니다. 독점 모델은 형태의 큰 변화에 걸쳐 구조적 논리를 보존하면서 보다 충실한 유추를 생성했으며, 오픈 소스 모델은 문자 그대로 또는 문체 일치로 회귀하는 경향이 있어 더 깊은 아이디어를 전달하지 못했습니다. 출력은 의도된 변환을 예시하는 인간이 선별한 유추와 비교되었습니다. 다음과 같이 말한다: ‘LPIPS는純粋하게 지각적 유사성을 집중한다. DINO는 약간 더 잘 수행한다. CLIP-I는 가장 강한 결과를 보여준다. 그러나 relsim은最高의 점수를 얻었다. 이것은

관계적 패턴에 대한 미세 조정을 통해 GPT-4o의 평가와 더 잘 일치한다는 것을 나타낸다.’

사용 사례

연구진은 관계적 유사성이 이미지 검색과 이미지 생성에 어떻게 적용될 conceptual structure수 있는지 탐구했다. Relational retrieval returns images that share a deeper

Relational retrieval returns images that share a deeper conceptual structure with the query, rather than matching surface features. For example, a food item styled to resemble a face retrieves other anthropomorphic meals; a sliced object yields other sliced forms; and scenes of adult-offspring interaction return images with similar relational roles, even when species and composition differ. 표면적인 특징과 일치시키는 대신, 질의에 기반하여 이미지를 생성합니다. 예를 들어, 얼굴을 닮도록 스타일링된 음식 이미지는 다른 의인화된 음식 이미지를, 잘린 물체 이미지는 다른 잘린 형태의 이미지를, 그리고 어른과 자식의 상호작용 장면은 유사한 이미지를 반환합니다.

relational roles, same underlying종과 구성이 다르더라도 마찬가지입니다. 또한, 관계적 유사성을 지닌 이미지 생성에 있어 어떻게 대상을 표현할 수 있는지 파악했습니다. 입력 이미지와 관계적 프롬프트가 주어졌을 때, 모델은 해당 개념을 표현하는 새로운 이미지를 생성하도록 요청받았습니다.

Given an input image and a relational prompt, models were asked to generate a new image expressing the same underlying concept. Proprietary models produced more faithful analogies, preserving structural logic across large changes in form, and open-sourced models tended to regress to literal or stylistic matches, failing to transfer the deeper idea. Outputs were compared against human-curated analogies, which exemplified the intended transformation. 자체 개발 모델은 형태의 큰 변화에도 불구하고 구조적 논리를 유지하며 더 충실한 유사 이미지를 생성하는 반면, 오픈 소스 모델은 문자 그대로 또는 스타일적인 유사성으로 회귀하여 더 깊은 아이디어를 전달하지 못하는 경향을 보였습니다. 출력 결과는 의도된 변환을 보여주는 사람이 선별한 유사 이미지와 비교되었습니다.

결론

생성 AI 시스템은 추상적인 표현을 포함하는 능력이 있으면 더 향상될 수 있다. 현재는 개념 기반 이미지를 요청하면 가장 인기 있는 이미지나 데이터셋에 있는 이미지를 반환한다. 이것은 추상화가 아니라 기억이다. 이 원리는 생성적 글쓰기에 적용될 수 있다. 특히 분석적, 추측적, 또는 허구적인 출력에 유용할 수 있다. (/video) 재생하기 출처 * A100은 40Gb 또는 80GB의 VRAM을 가질

수


있다. 그러나 이 문서에서는 지정되지 않았다. ** 연구진의 인용문은 중복되므로

생략되었다. 最初에 2025년

12월 16일에 게시되었다.

머신러닝 분야 작가이자 인간 이미지 합성 도메인 전문가. Metaphysic.ai에서 연구 콘텐츠 책임자를 역임했으며, DNEG의 Brahma.ai로 통합될 때까지 근무했습니다.
웹사이트: martinanderson.ai
연락처: martin@martinanderson.ai