AI 모델 및 플랫폼
AudioSep: 설명한 모든 소리를 분리하는 모델

 Unite.AI를 Google의 선호 소스에 추가
핵심 포인트AudioSep는 오픈 도메인에서 자연어 질의를 사용하여 사운드를 분리하는 기초 모델입니다.
더 보기
- AudioSep는 오픈 도메인에서 자연어 질의를 사용하여 사운드를 분리하는 기초 모델입니다.
- 이 모델은 대규모 멀티모달 데이터셋을 활용하여 기존 LASS 프레임워크의 주석 데이터 한계를 극복합니다.
- 이 아키텍처는 고정된 CLIP 또는 CLAP 텍스트 인코더와 ResUNet 분리 백본을 결합하여 제로샷 성능을 구현합니다.
LASS(Language-queried Audio Source Separation)는 자연어 질의로 혼합 오디오에서 목표 소리를 분리하는 계산적 청각 장면 분석(CASA)의 새로운 패러다임이다. 디지털 오디오 작업에 자연스럽고 확장 가능한 인터페이스를 제공한다. 악기처럼 특정 음원을 분리하는 성능은 발전했지만, 기존 프레임워크는 개방형 영역의 임의 음원 분리에 한계가 있었다.
AudioSep는 자연어 질의로 목표 오디오를 분리하여 이러한 한계를 해결하려는 기반 모델이다. 개발진은 다양한 대규모 멀티모달 데이터셋으로 훈련하고 악기 분리, 오디오 이벤트 분리, 음성 향상 등의 작업에서 평가했다. 초기 결과는 강력한 분리 성능과 인상적인 제로샷 능력을 보여준다. 이 글에서는 구조, 훈련 및 평가 데이터, 핵심 개념을 살펴본다.
CASA, USS, QSS, LASS: AudioSep의 기반
CASA는 인간의 청각처럼 복잡한 소리 환경을 인식하는 기계 청취 시스템을 설계하는 접근법이다. 특히 목표 음원 분리는 여러 소리가 섞인 실제 녹음에서 개별 소리를 구별하는 ‘칵테일 파티 문제’를 다룬다. 음악 및 오디오 음원 분리, 음성 향상, 목표 소리 식별 등 다양한 응용이 있다.
기존 연구는 음악이나 음성 등 하나 이상의 특정 음원 분리에 주로 집중했다. USS(Universal Sound Separation)는 실제 녹음의 임의 소리를 모두 분리하려 하지만, 세상에 존재하는 음원이 매우 다양하여 모든 음원을 분리하는 것은 어렵고 실시간 응용에는 제약이 있다.
QSS(Query-based Sound Separation)는 특정 질의에 따라 필요한 개별 음원만 추출하는 대안이다. 사용자가 요구하는 소리를 고를 수 있으므로 멀티미디어 콘텐츠 편집이나 오디오 편집에 더 실용적이다.
QSS를 확장한 LASS는 목표 소리의 자연어 설명을 사용한다. 오디오나 시각 자료로 질의하는 방식보다 유연하며 질의 정보를 얻기도 쉽다. 미리 정해진 레이블을 질의로 쓰는 방식과 달리 입력 질의 수를 제한하지 않아 개방형 영역으로 일반화할 가능성이 있다.
초기 LASS는 레이블이 있는 오디오·텍스트 쌍을 사용하는 지도 학습에 의존했지만, 주석이 달린 오디오·텍스트 데이터는 제한적이다. 이를 줄이기 위해 멀티모달 지도 신호와 CLIP 같은 대조적 사전학습 모델을 질의 인코더로 사용한다. 텍스트 임베딩을 시각 등의 다른 모달리티와 정렬하면 풍부한 모달리티 데이터로 훈련하고 텍스트 질의를 제로샷 방식으로 사용할 수 있다. 그러나 기존 LASS의 훈련 데이터는 작았고 수많은 잠재적 영역의 응용은 충분히 탐색되지 않았다.
AudioSep의 목표는 기존 대규모 오디오 및 멀티모달 데이터를 활용하여 개방형 영역으로 일반화하는 사전학습 음원 분리 모델을 만드는 것이다. 즉 자연어 질의나 설명으로 임의의 소리를 분리하는 기반 모델이다.
AudioSep의 주요 구성 요소와 구조
두 핵심 구성 요소는 텍스트 인코더와 분리 모델이다.
텍스트 인코더
CLIP(Contrastive Language-Image Pre-training) 또는 CLAP(Contrastive Language-Audio Pre-training)의 텍스트 인코더를 사용한다. N개 토큰으로 이루어진 질의를 트랜스포머 블록에 통과시키고 출력 표현을 집계하여 고정 길이 D차원 벡터를 얻는다. D는 해당 CLIP 또는 CLAP 모델의 차원이며, 훈련 중 텍스트 인코더는 고정한다.
CLIP는 대규모 이미지·텍스트 쌍으로 대조 학습하여 텍스트 설명을 시각 표현과 같은 의미 공간에 매핑한다. 따라서 시각 임베딩을 대체 질의로 쓰면, 주석이 없는 시청각 데이터로도 LASS를 훈련할 수 있어 오디오·텍스트 레이블이 반드시 필요하지 않다. CLAP도 유사하게 오디오 인코더와 텍스트 인코더를 대조 학습하여 소리와 설명을 공통 잠재 공간에 연결한다.
분리 모델
주파수 영역의 ResUNet을 분리 백본으로 사용한다. 혼합 파형에 단시간 푸리에 변환(STFT)을 적용하여 복소 스펙트로그램 X, 크기 스펙트로그램, 위상을 얻고, 인코더·디코더 네트워크가 크기 스펙트로그램을 처리한다.
네트워크는 인코더 블록 6개, 디코더 블록 6개, 병목 블록 4개로 구성된다. 인코더는 잔차 합성곱 블록 4개로 특징을 다운샘플링하고, 디코더는 잔차 전치 합성곱 블록 4개로 업샘플링한다. 같은 해상도의 인코더와 디코더 사이에는 스킵 연결이 있다. 잔차 블록에는 Leaky-ReLU 2개, 배치 정규화 2개, CNN 층 2개와 입력·출력을 잇는 잔차 지름길이 포함된다.
모델은 복소 스펙트로그램 X를 입력받아 크기 마스크 M과 텍스트 임베딩을 조건으로 한 위상 잔차를 예측한다. 이는 스펙트로그램의 크기 조절과 각도 회전을 제어한다. 예측된 마스크와 위상 잔차를 혼합 오디오의 STFT에 적용하여 분리된 복소 스펙트로그램을 얻는다.

ResUNet의 합성곱 블록 뒤에 FiLM(Feature-wise Linear Modulation) 층을 배치하여 텍스트 인코더와 분리 모델을 연결한다.
훈련과 손실
라우드니스 증강을 사용하며, 정답 파형과 예측 파형 사이의 L1 손실로 전체 분리 프레임워크를 엔드투엔드 훈련한다.
데이터셋과 벤치마크
AudioSep는 주석이 달린 오디오·텍스트 쌍에 대한 의존을 줄이고 멀티모달 학습 능력을 얻기 위해 여러 데이터셋을 활용한다.
AudioSet
YouTube에서 추출한 10초 오디오 조각 200만 개 이상으로 구성된 대규모 약한 레이블 데이터셋이다. 정확한 발생 시점 없이 소리 클래스의 존재 여부가 표시되며 자연음, 사람 소리, 차량 소리 등 500개 이상의 클래스가 있다.
VGGSound
YouTube의 10초 영상 클립 20만 개 이상으로 구성된 시청각 데이터셋이다. 사람, 자연, 새 소리 등 300개 이상의 클래스가 있으며, 소리를 만드는 물체가 대응 영상에도 나타나도록 구성되어 있다.
AudioCaps
AudioSet에서 추출한 10초 클립 5만 개 이상의 공개 오디오 캡션 데이터셋이다. 훈련·검증·시험 세트로 나누며 Amazon Mechanical Turk를 통해 사람이 자연어 설명을 작성했다. 훈련 클립에는 캡션이 하나, 검증·시험 클립에는 정답 캡션이 각각 다섯 개다.
ClothoV2
FreeSound에서 가져온 클립으로 구성된 오디오 캡션 데이터셋이다. AudioCaps처럼 Amazon Mechanical Turk를 통해 사람이 자연어 설명을 붙였다.
WavCaps
캡션이 있는 오디오 클립 40만 개 이상, 훈련 분량 약 7,568시간의 대규모 약한 레이블 데이터셋이다. BBC Sound Effects, AudioSet, FreeSound, SoundBible 등 다양한 출처를 포함한다.

훈련 세부 사항
서로 다른 훈련 클립에서 약 5초 길이의 구간 두 개를 무작위로 뽑아 혼합한다. 파형에서 복소 스펙트로그램을 추출할 때 크기 1024의 Hann 윈도와 홉 크기 320을 사용한다.
CLIP/CLAP 텍스트 인코더로 임베딩을 추출하며 기본 설정은 텍스트 지도 신호다. 분리 모델은 30개 층, 인코더 블록 6개와 디코더 블록 6개를 갖는 ResUNet이다. 각 인코더 블록에는 3×3 커널의 합성곱 층 두 개가 있고, 출력 특징 맵 수는 차례로 32, 64, 128, 256, 512, 1024다. 디코더는 대칭 구조이며 Adam 옵티마이저와 배치 크기 96으로 훈련한다.
평가 결과
훈련에서 접한 데이터셋
다음 그림은 훈련 중 접한 데이터셋에서 음성 향상 모델, LASS, CLIP 등 기준 시스템과 비교한 결과다. CLIP 텍스트 인코더를 쓰는 변형은 AudioSep-CLIP, CLAP를 쓰는 변형은 AudioSep-CLAP로 표시한다.

오디오 캡션이나 텍스트 레이블을 입력 질의로 사용할 때 좋은 성능을 보이며, 기존 LASS와 오디오 질의 기반 분리 모델보다 우수한 결과가 나타났다.
훈련에서 접하지 않은 데이터셋
제로샷 성능을 확인하기 위해 보지 않은 데이터셋에서도 평가했다. 다음 결과는 강력한 분리 성능을 보여준다.

아래는 Voicebank-DEMAND 음성 향상 평가 결과다.

이러한 결과는 새로운 데이터 분포에서도 제로샷 음향 처리를 수행할 가능성을 보여준다.
분리 결과 시각화
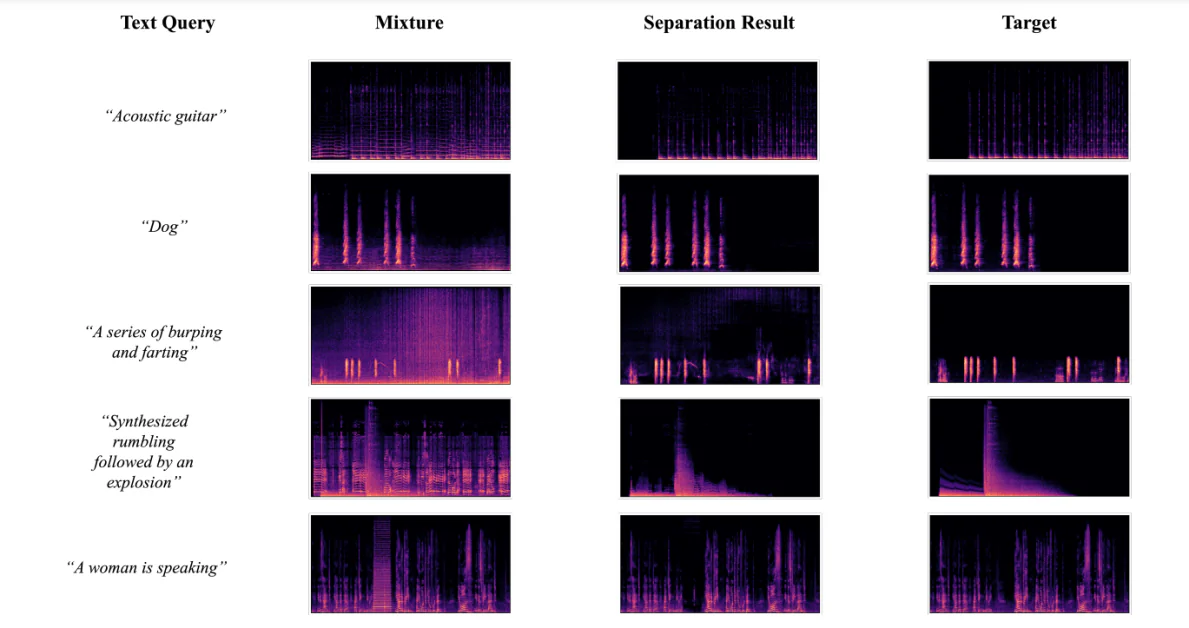
AudioSep-CLAP를 사용하여 여러 소리에 대한 텍스트 질의로 정답 목표 음원, 혼합 오디오, 분리된 음원의 스펙트로그램을 비교했다. 분리된 패턴이 정답에 가까워 실험의 정량적 결과를 뒷받침한다.
텍스트 질의 비교
AudioCaps Mini에서 AudioSep-CLAP와 AudioSep-CLIP를 평가하고, AudioSet 이벤트 레이블, AudioCaps 캡션, 새로 작성한 자연어 설명을 사용해 질의 유형의 영향을 살폈다. 다음 그림은 AudioCaps Mini의 예시다.

결론
AudioSep는 자연어 설명으로 소리를 분리하는 개방형 범용 음원 분리 기반 모델이다. 평가에서는 캡션이나 텍스트 레이블 질의를 활용하여 제로샷 및 비지도 설정에서 강력한 성능을 보였다. 기존 LASS 같은 분리 프레임워크보다 우수한 결과를 통해 기존 접근의 한계를 해결할 가능성을 제시한다.