
AGIと未来のAI
チューリングテストとは何か、そしてなぜ重要なのか

 Unite.AI を Google の優先ソースに追加
チューリングテストは、アラン・チューリングの1950年の論文「Computing Machinery and Intelligence」から生まれました。思考を定義しようとする代わりに、チューリングは模倣ゲームを提案しました。人間の審問者が見えない参加者と書面でメッセージをやり取りし、どちらが人間でどちらが機械かを判定します。
このテストは、抽象的な哲学的問いを観測可能な対話に変えるため、依然として影響力があります。しかし限界もあります。会話で人間らしく見えることは、真実であること、知識があること、安全であること、意識があること、あるいは一般的に知的であることと同義ではありません。
重要なポイント
- チューリングが提案した元の模倣ゲームは、テキストベースの行動テストであり、内部的な認知特性のチェックリストではありません。
- 結果は評価者、プロンプト、対話時間、参加者への指示、採点ルールに依存します。
- モデルは事実を捏造したり、単純なロバスト性テストに失敗したりしながらも、人間の会話を模倣できます。
- 現代の評価には、会話に加えてタスク指標、対抗的テスト、人間によるレビュー、リスク固有のエビデンスが必要です。
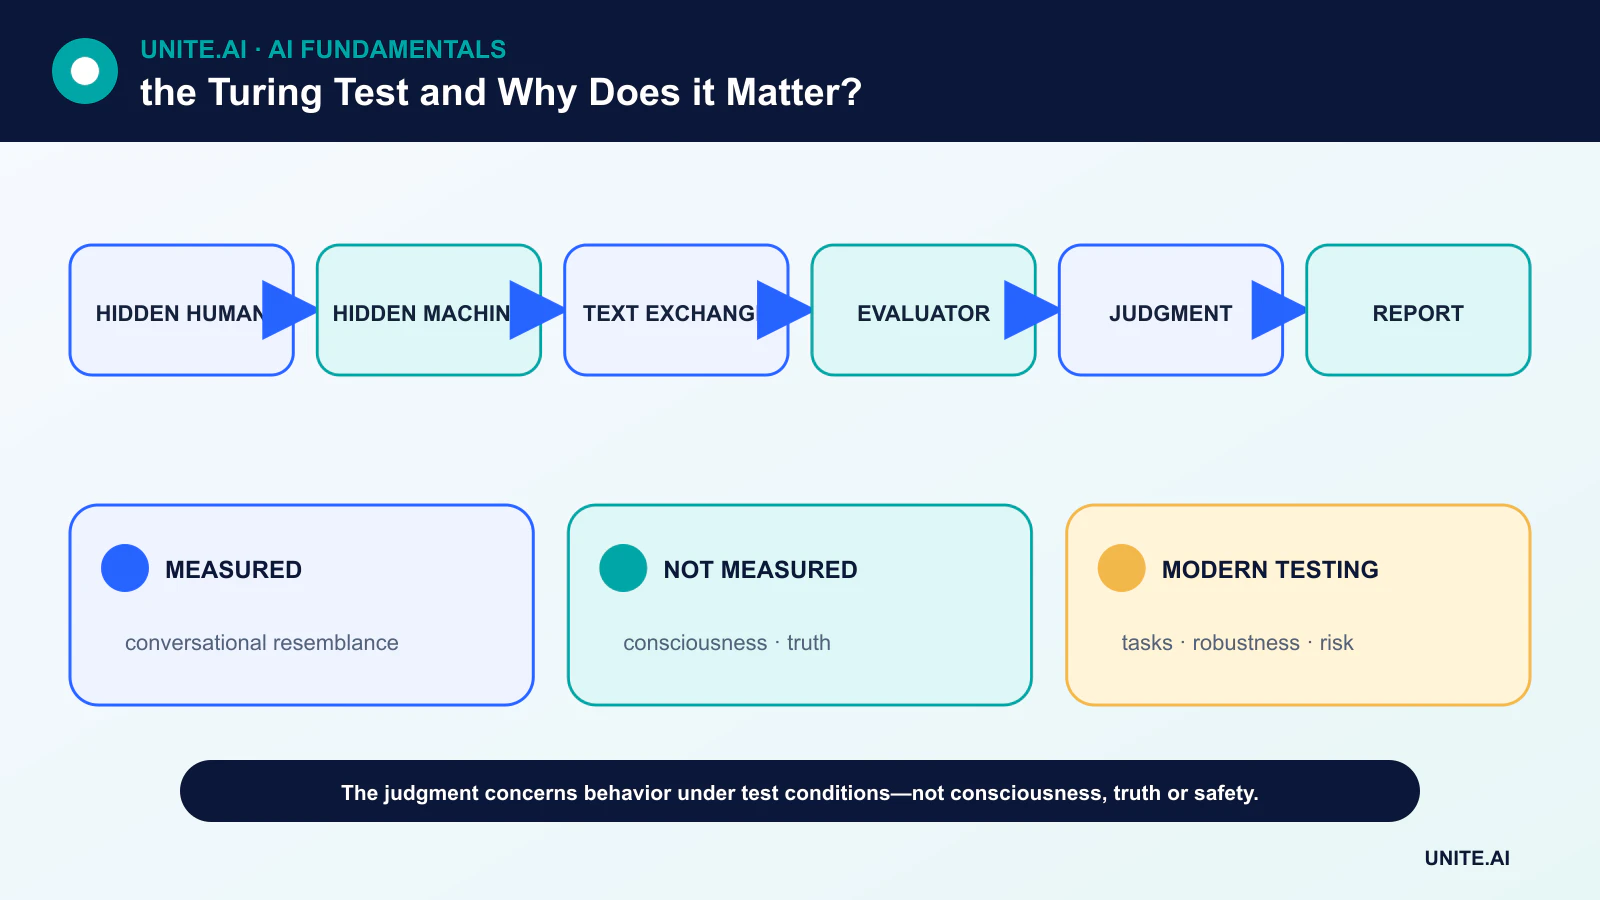
チューリングの模倣ゲーム
元の設定では、審問者は遠隔で通信し、声や外見が身元を明かさないようにしました。チューリングは、機械がゲームで十分に良いパフォーマンスを示し、評価者がそれを人間と確実に区別できないかどうかを問いました。
この運用的な枠組みは、思考の定義を決める必要性を回避しました。すべての説得力のあるやり取りが知性を証明するとは主張せず、また後のチャットボット実演に適用できる普遍的な合格基準も設定していません。
結果が実際に測定するもの
試験は、定義された条件下での行動的な区別不可能性を測定します。短い会話、経験の浅い審査員、またはシステム構築者が選んだプロンプトはタスクを容易にします。厳密なレポートでは、文字起こしの選択基準、審査員の人数と背景、比較対象となる人間、時間制限、統計手法を開示すべきです。
システムは期待を利用することもあります。回避的な態度、ユーモア、誤字、ロールプレイなどは、信頼できる推論を示さなくても人間らしく見えることがあります。逆に、異常に形式的な人間の応答が機械生成と誤分類されることもあります。
チューリングテストが確立しないこと
テストは意識、主観的経験、事実の正確性、因果理解、または道徳的主体性を直接測定しません。また、会話以外のトレーニングデータ、モデル構造、失敗モードも明らかにしません。さらに、物理的操作のような非言語的知能についてはほとんど言及しません。
現代の言語システムはトランスフォーマー・ニューラルネットワークとディープラーニングで構築されていますが、その流暢な出力は、検証された世界モデルではなく、学習された統計構造から生成されることがあります。
現代のAI評価が問いを拡張する方法
現代の評価では、ホールドアウトされたタスクセット、校正された不確実性、ロバスト性テスト、レッドチーミング、事実性チェック、人間の好み調査が用いられます。テキスト分類指標は定義された行動をテストでき、シナリオベースの評価はシステムがプレッシャー下でポリシーに従うかどうかを検証します。
単一のベンチマークではすべての導入シナリオを網羅できません。テストの汚染はスコアを過大評価し、静的ベンチマークは過学習を助長します。モデル、データ、プロンプト、ツール、ユーザー層が変化するたびに評価を繰り返すべきです。
テストが依然として重要である理由
チューリングテストは、AI評価の核心的教訓を予見していました。すなわち、内部的本質に関する主張に頼るのではなく、観測可能な能力を評価することです。また、どの人間の行動が証拠とみなされるか、実験設定が結論にどのように影響するかを問うことを強制します。
現代での最も有用な活用は、歴史的・概念的なベースラインとして用いることです。模倣ゲームに合格することは興味深いですが、導入判断には実際のタスク、影響を受けるユーザー、予測可能な危害に結びつく証拠が必要です。
チューリングテストが測定するもの
アラン・チューリングの模倣ゲームは、テキストでやり取りする審問者が機械と人間を確実に区別できるかどうかを問いました。そこでは、機械が思考するかどうかという抽象的な議論を観測可能な対話実験へと再構成しました。テストは参加者、対話時間、プロトコル、トピック、判定規則に依存し、単一の普遍的スコアは存在しません。合格とは、その設定下で人間らしい応答を生成することです。それは事実の正確性、推論、意識、自律性、知覚、具現化、信頼性、または有益な実世界での行動を直接測定するものではありません。
人間の模倣は回避、ペルソナ、ミス、ユーモア、操作を報いることがあります。審査員は人間を機械と誤認したり、期待、言語、文化的文脈に影響されたりすることがあります。短い会話は持続的な対話では失敗するトリックを可能にします。逆に、数学、翻訳、タンパク質モデリングに非常に有用なシステムでも、人間であるふりをしないために失格になることがあります。したがってテストは、評価者によって形作られる社会的・言語的能力を測定するものであり、知性全体の序列を測るものではありません。
現代の言語モデルと高度な評価
大規模言語モデルは、広範なトレーニングデータとその後のチューニングからシーケンスを予測することで流暢な対話を維持できますが、流暢さは真実や理解の証拠としては弱いです。記憶されたパターン、ツールへのアクセス、隠れたプロンプト、レイテンシ、サンプリング設定が結果に影響します。制御された評価では、モデルとプロトコルを開示し、情報漏洩を防ぎ、対抗的・領域別の質問を含め、不確実性と引用をスコアリングすべきです。成功した会話から選ばれたデモは、利用分布全体の信頼性を推定できません。
現代の評価は多次元的です:タスク精度、校正、ロバスト性、長期的一貫性、安全性、バイアス、プライバシー、セキュリティ、効率、そして人間への影響。行動テストはプロセスエビデンス、レッドチーミング、再現可能なベンチマーク、実世界モニタリングと補完すべきです。ベンチマークは飽和したりトレーニングデータに組み込まれたりする可能性があるため、プライベートで更新されたテストセットが必要です。実行するシステムについては、会話品質とは別にツール権限、復旧、結果を評価すべきです。
テストが依然として重要である理由
チューリングテストは、行動と知性定義の難しさに焦点を当てた歴史的に重要なものです。また、擬人化や欺瞞に関する継続的な疑問を提起します。特に重要な場面では、誤認を成功とみなすのではなく、合成エージェントであることをインターフェースで明示すべきです。テストは哲学的レンズとして、また一つの対話評価手段として利用し、汎用知性や人格の認証としては用いません。導入時に重要なのは、システムがどのような証拠と制限の下で何を確実に実行できるか、そして失敗した際に誰が責任を負うかという点です。
実例:制御された対話評価
評価者は、固定された対話時間、トピック、言語、匿名化された身元で、人間と複数のAIシステムをテキスト会話で比較します。審査員は各参加者が人間であると信じるかを記録し、事実性、一貫性、有用性、不確実性、操作性も採点します。複数の審査員と会話により変動を推定し、プロトコルはモデル開発者が好都合な文字起こしを選択できないようにします。人間の誤分類は結果解釈のための必要なベースラインを提供します。
審査員を欺きながら事実を捏造するシステムは一般的な知性を持つとは宣言されませんが、明示的に専門性を示すモデルは模倣に失敗しても高い有用性を持ち得ます。結果にはプロンプト、モデル、サンプラー、ツールアクセス、審査員の特性が含まれます。この実験は人間らしい対話の一つのテストとして位置付けられます。導入判断はタスク正確性、安全性、プライバシー、復旧に関する別個のエビデンスを用い、インターフェースはエージェントを特定し、欺瞞を製品目標に転換しないようにします。
実装エビデンスと運用準備性
本番導入の判断は、成功したデモだけでは不十分です。想定ユーザー、運用環境、入力・出力、依存関係、所有者、重要な失敗ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、 malformed または欠損入力、分布シフト、依存サービスの停止、誤用、そして最も支援が行き届かない可能性のあるグループや環境をテストします。タスク品質を校正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプとエビデンスを区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止に関する権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに入力品質、出力挙動、モデルまたはルールのバージョン、依存サービスの健全性、人間の介入、確認済み結果を明らかにすべきです。アラート閾値と対応責任者を定義し、オフライン性能が持続すると仮定せずに導入後の実世界エビデンスをレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持管理されたシステムは、文書化された復旧、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングも必要です。
よくある質問
AIがチューリングテストに決定的に合格した例はありますか?
単一の公式テスト機関や普遍的に受け入れられたプロトコルは存在しません。公開デモは異なるルールで行われるため、「合格」主張は直接比較できません。
テストに失敗したことは、システムが知性を欠くことを証明しますか?
いいえ。専門的なシステムは、人間の会話スタイルを模倣しなくても高度に有用であることがあります。
主要参考文献












