
AGI e IA del futuro
Cos’è il test di Turing e perché è importante?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Il Turing test nasce dal saggio del 1950 di Alan Turing “Computing Machinery and Intelligence”. Invece di cercare di definire il pensiero, Turing propose un gioco di imitazione: un interrogatore umano scambia messaggi scritti con partecipanti invisibili e giudica chi è umano e chi è una macchina.
Il test rimane influente perché trasforma una questione filosofica astratta in un’interazione osservabile. È anche limitato: apparire umano in una conversazione non è lo stesso che essere veritiero, competente, sicuro, cosciente o generalmente intelligente.
Punti chiave
- Il gioco di imitazione originale di Turing è un test comportamentale basato sul testo, non una lista di controllo di proprietà cognitive interne.
- I risultati dipendono dal valutatore, dal prompt, dalla durata, dalle istruzioni ai partecipanti e dalla regola di punteggio.
- Un modello può imitare la conversazione umana pur allucinando fatti o fallendo in semplici test di robustezza.
- La valutazione moderna richiede metriche di compito, test avversari, revisione umana e prove specifiche per il rischio, oltre alla conversazione.
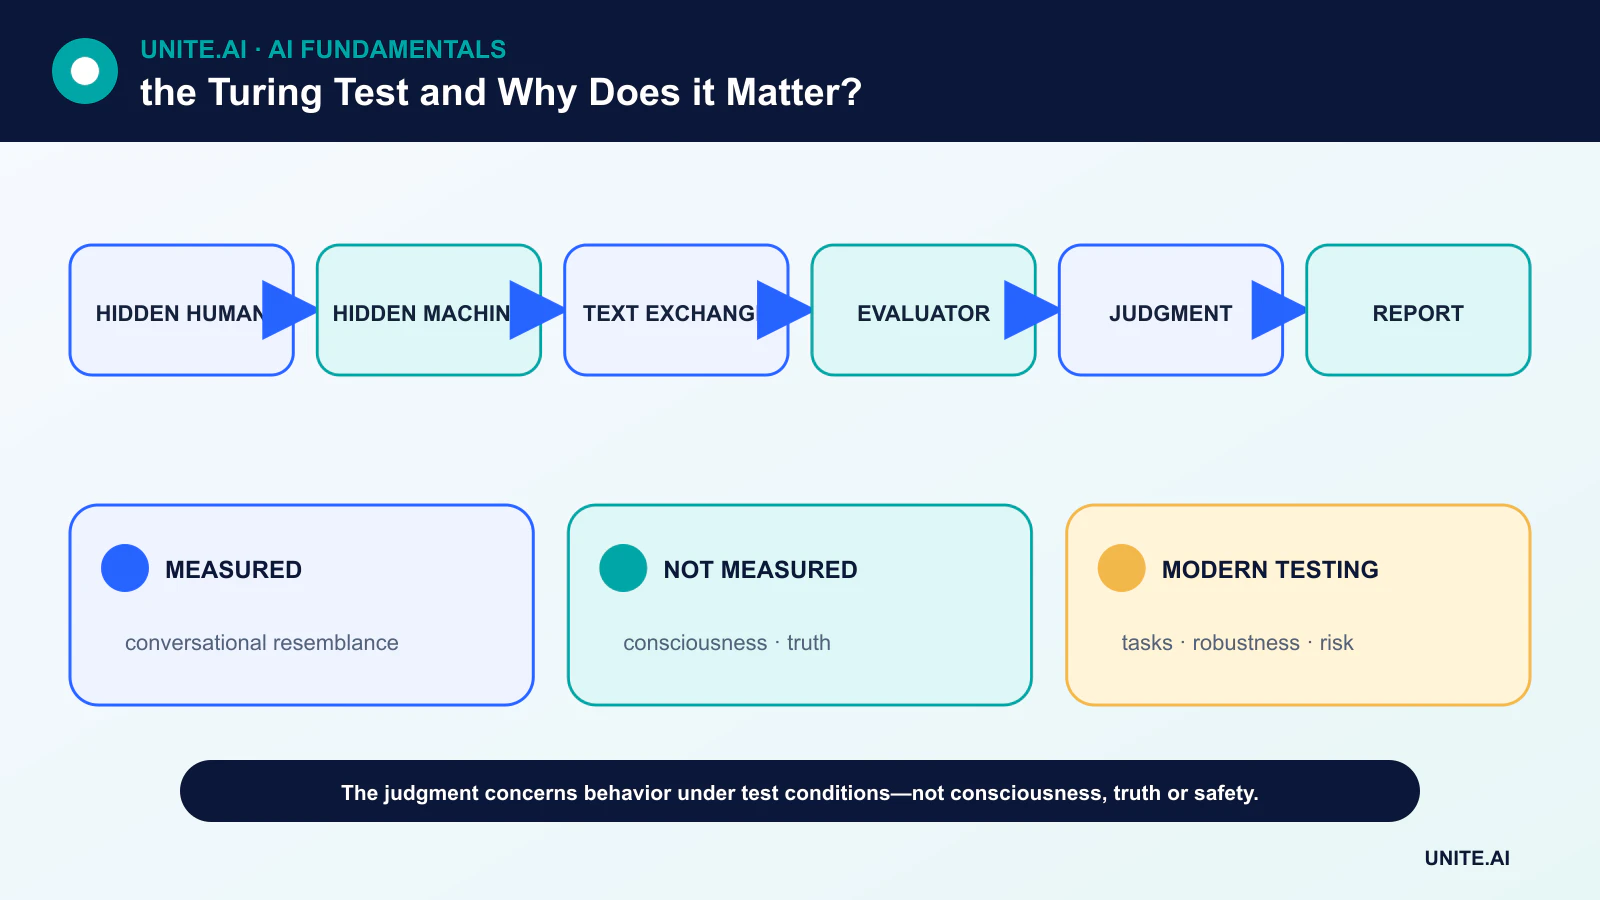
Il gioco di imitazione di Turing
Nella configurazione originale, un interrogatore comunicava a distanza affinché voce e aspetto non rivelassero l’identità. Turing si chiedeva se una macchina potesse esibirsi sufficientemente bene nel gioco da far sì che un valutatore non potesse distinguerla in modo affidabile da una persona.
Questa impostazione operativa evitava la necessità di stabilire una definizione unica di pensiero. Non affermava che ogni scambio convincente dimostri intelligenza, né specificava una soglia universale di superamento applicabile a future dimostrazioni di chatbot.
Cosa misura realmente un risultato
Una prova misura l’indistinguibilità comportamentale in condizioni definite. Conversazioni brevi, giudici inesperti o prompt scelti dal costruttore del sistema possono rendere il compito più semplice. Un rapporto rigoroso dovrebbe divulgare la selezione delle trascrizioni, il numero e il background dei giudici, gli umani di confronto, il limite di tempo e il metodo statistico.
Un sistema può anche sfruttare le aspettative: evasività, umorismo, errori tipografici e giochi di ruolo possono apparire umani senza dimostrare un ragionamento affidabile. Al contrario, una risposta umana insolitamente formale può essere classificata erroneamente come generata da una macchina.
Cosa il test di Turing non stabilisce
Il test non misura direttamente la coscienza, l’esperienza soggettiva, l’accuratezza fattuale, la comprensione causale o l’autonomia morale. Non rivela i dati di addestramento, l’architettura del modello o i modi di fallimento al di fuori della conversazione. Inoltre fornisce poche informazioni sull’intelligenza non linguistica, come la manipolazione fisica.
I moderni sistemi linguistici sono costruiti con reti neurali transformer e deep learning, ma le loro uscite fluide possono ancora essere generate da una struttura statistica appresa piuttosto che da un modello del mondo verificato.
Come la valutazione moderna dell’IA espande la questione
La valutazione contemporanea utilizza set di compiti tenuti da parte, incertezza calibrata, test di robustezza, red teaming, controlli di factualità e studi sulle preferenze umane. Una metrica di classificazione del testo può testare un comportamento definito, mentre una valutazione basata su scenari può verificare se un sistema rispetta la politica sotto pressione.
Nessun benchmark unico cattura ogni tipo di implementazione. La contaminazione dei test può gonfiare i punteggi, e i benchmark statici incoraggiano l’overfitting. La valutazione dovrebbe essere ripetuta man mano che modelli, dati, prompt, strumenti e popolazioni di utenti cambiano.
Perché il test è ancora importante
Il test di Turing anticipava una lezione fondamentale della valutazione dell’IA: valutare la capacità osservabile piuttosto che basarsi su affermazioni riguardo a un’essenza interna. Ci spinge anche a chiedere quali comportamenti umani contano come prova e in che modo una configurazione sperimentale influisce su una conclusione.
Il suo miglior utilizzo moderno è come riferimento storico e concettuale. Superare un gioco di imitazione può essere interessante, ma le decisioni di implementazione richiedono prove legate al compito reale, agli utenti interessati e ai danni prevedibili.
Cosa misura il test di Turing
Il gioco di imitazione di Alan Turing chiedeva se un interrogatore che comunica tramite testo potesse distinguere in modo affidabile una macchina da una persona. Ha riformulato un dibattito astratto sul fatto che le macchine pensino in un esperimento conversazionale osservabile. Il test dipende da partecipanti, durata, protocollo, argomenti e regola di giudizio; non esiste un unico punteggio universale. Superare il test significa produrre risposte simili a quelle umane in quella configurazione. Non misura direttamente l’accuratezza fattuale, il ragionamento, la coscienza, l’autonomia, la percezione, l’incarnazione, l’affidabilità o un comportamento reale benefico.
La imitazione umana può premiare evasività, persona, errori, umorismo o manipolazione. Un giudice può scambiare un umano per una macchina o essere influenzato dalle aspettative, dalla lingua e dal contesto culturale. Le conversazioni brevi consentono trucchi che falliscono con un’interazione prolungata. Al contrario, un sistema molto utile per la matematica, la traduzione o la modellazione proteica potrebbe fallire perché non finge di essere umano. Il test quindi misura una capacità sociale e linguistica modellata dal valutatore, non una classifica completa dell’intelligenza.
Modelli linguistici moderni e valutazione più rigorosa
I grandi modelli linguistici possono sostenere dialoghi fluidi prevedendo sequenze da ampi dati di addestramento e successiva messa a punto, ma la fluidità è una prova debole di verità o comprensione. Schemi memorizzati, accesso a strumenti, prompt nascosti, latenza e impostazioni di campionamento influenzano i risultati. Le valutazioni controllate dovrebbero divulgare modello e protocollo, prevenire perdite di informazioni, includere domande avversarie e di dominio, e valutare incertezza e citazioni. Una dimostrazione selezionata da conversazioni di successo non può stimare l’affidabilità sull’intera distribuzione di utilizzo.
La valutazione moderna è multidimensionale: accuratezza del compito, calibrazione, robustezza, coerenza a lungo termine, sicurezza, bias, privacy, sicurezza, efficienza e risultati umani. I test comportamentali dovrebbero essere integrati da prove di processo, red teaming, benchmark riproducibili e monitoraggio nel mondo reale. I benchmark possono saturare o entrare nei dati di addestramento, quindi sono necessari set di test privati e aggiornati. Per i sistemi che agiscono, valutare i permessi degli strumenti, il recupero e le conseguenze separatamente dalla qualità della conversazione.
Perché il test è ancora importante
Il test di Turing rimane storicamente importante perché si concentra sul comportamento e sulla difficoltà di definire l’intelligenza. Solleva inoltre domande continue sull’antropomorfismo e sulla frode. Le interfacce dovrebbero identificare gli agenti sintetici piuttosto che trattare l’identità errata come successo, soprattutto in contesti decisivi. Utilizzate il test come lente filosofica e come una valutazione conversazionale, non come certificazione di intelligenza generale o di personalità. La questione cruciale per l’implementazione è cosa il sistema può fare in modo affidabile, con quali prove e limiti, e chi è responsabile quando fallisce.
Esempio pratico: una valutazione conversazionale controllata
Gli valutatori confrontano umani e diversi sistemi di IA in conversazioni testuali con durata, argomenti, lingua e identità nascoste fisse. I giudici registrano se ritengono che ciascun partecipante sia umano e valutano anche factualità, coerenza, utilità, incertezza e manipolazione. Più giudici e conversazioni stimano la variazione, e il protocollo impedisce agli sviluppatori del modello di selezionare trascrizioni favorevoli. La misclassificazione umana fornisce una baseline necessaria per interpretare il risultato.
Un sistema che inganna i giudici ma inventa fatti non viene dichiarato generalmente intelligente, mentre un modello specializzato chiaramente divulgato può essere molto utile nonostante fallisca nell’imitazione. I risultati includono prompt, modello, sampler, accesso agli strumenti e caratteristiche del giudice. L’esperimento è inquadrato come un test di conversazione simile a quella umana. Le decisioni di implementazione utilizzano prove separate per la correttezza del compito, la sicurezza, la privacy e il recupero, e l’interfaccia identifica l’agente invece di trasformare la frode nell’obiettivo del prodotto.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più probabilmente trascurati. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout graduale, mantenere un fallback sicuro e verificare il monitoraggio con guasti inseriti deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile di risposta, quindi rivedere le prove del mondo reale dopo l’implementazione anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita inoltre di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Qualche IA ha superato definitivamente il test di Turing?
Non esiste un’unica autorità ufficiale per il test né un protocollo universalmente accettato. Le dimostrazioni pubbliche usano regole diverse, quindi le affermazioni di “superamento” non sono direttamente comparabili.
Il fallimento al test dimostra che un sistema è privo di intelligenza?
No. Un sistema specializzato può essere altamente capace senza imitare lo stile conversazionale umano.
Riferimenti principali












