
Angolo di Anderson
Verso esseri umani generati dall’IA in tempo reale con Neural Lumigraph Rendering

 Aggiungi Unite.AI alle tue fonti preferite su Google
Punti chiaveNeural Lumigraph Rendering migliora NeRF di circa due ordini di grandezza.
Vedi di più
- Neural Lumigraph Rendering migliora NeRF di circa due ordini di grandezza.
- NLR utilizza le reti SIREN per combinare i punti di forza di NeRF e IDR per la grafica in tempo reale.
- NLR manca di capacità di illuminazione dinamica e di riilluminazione, limitando l'output all'illuminazione al momento della cattura.
Nonostante l’attuale ondata di interesse per i Campi di Radianza Neurale (NeRF), una tecnologia in grado di creare ambienti e oggetti 3D generati da AI, questo nuovo approccio alla tecnologia di sintesi di immagini richiede ancora una grande quantità di tempo di addestramento e manca di un’implementazione che consenta interfacce in tempo reale altamente reattive.
Tuttavia, una collaborazione tra alcuni nomi importanti nell’industria e nell’accademia offre una nuova prospettiva su questa sfida (conosciuta genericamente come Sintesi di Nuova Vista, o NVS).
Lo studio, intitolato Neural Lumigraph Rendering, afferma un miglioramento dello stato dell’arte di circa due ordini di grandezza, rappresentando diversi passi verso la renderizzazione CG in tempo reale tramite pipeline di apprendimento automatico.

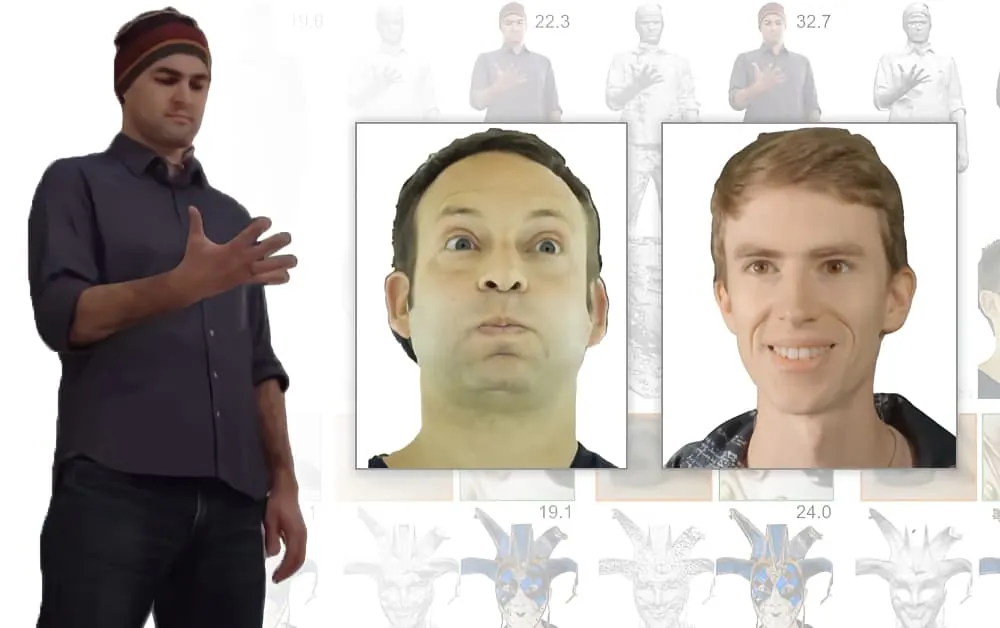
Neural Lumigraph Rendering (a destra) offre una migliore risoluzione degli artifact di blending e un miglioramento della gestione dell’occlusione rispetto ai metodi precedenti. Fonte.
Sebbene i crediti per il paper citino solo l’Università di Stanford e la società di tecnologia di display olografici Raxium (attualmente in modalità stealth), i contributori includono un architetto principale di sistemi di apprendimento automatico di Google, uno scienziato informatico di Adobe (ADBE ) e il CTO di StoryFile (che ha fatto notizia recentemente con una versione AI di William Shatner).
Per quanto riguarda la recente pubblicità di Shatner, StoryFile sembra utilizzare NLR nel suo nuovo processo per la creazione di entità generate da AI interattive basate sulle caratteristiche e le narrazioni di persone individuali.
StoryFile prevede l’utilizzo di questa tecnologia in mostre di musei, narrazioni interattive online, display olografici, realtà aumentata (AR) e documentazione del patrimonio – e sembra anche essere interessata a nuove applicazioni potenziali di NLR in colloqui di lavoro e applicazioni di dating virtuali:

Utilizzi proposti in un video online di StoryFile.
Cattura Volumetrica per Interfacce di Sintesi di Nuova Vista e Video
Il principio della cattura volumetrica, nell’ambito dei paper che si stanno accumulando sull’argomento, è l’idea di acquisire immagini o video di un soggetto e utilizzare l’apprendimento automatico per ‘riempire’ le prospettive che non sono state coperte dall’array originale di telecamere.
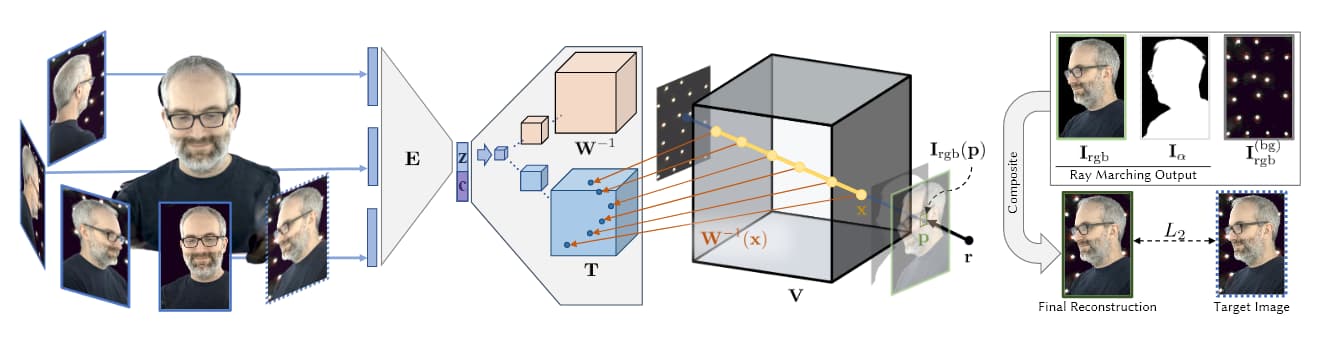
Fonte: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
Nell’immagine sopra, tratta dalla ricerca AI di Facebook del 2019 (vedi sotto), vediamo le quattro fasi della cattura volumetrica: più telecamere acquisiscono immagini/riprese; l’architettura encoder/decoder (o altre architetture) calcola e concatena la relazione tra le prospettive; gli algoritmi di ray-marching calcolano i voxel (o altre unità geometriche spaziali XYZ) di ogni punto nello spazio volumetrico; e (nella maggior parte dei paper recenti) si verifica l’addestramento per sintetizzare un’entità completa che può essere manipolata in tempo reale.
È questa fase di addestramento spesso estensiva e ricca di dati che, fino ad ora, ha tenuto la sintesi di nuova vista fuori dal regno del tempo reale o della cattura altamente reattiva.
Il fatto che la Sintesi di Nuova Vista crei una mappa 3D completa di uno spazio volumetrico significa che è relativamente banale cucire questi punti insieme in una mesh generata da computer tradizionale, catturando e articolando efficacemente un essere umano CGI (o qualsiasi altro oggetto relativamente limitato) al volo.
Gli approcci che utilizzano NeRF si basano su nuvole di punti e mappe di profondità per generare le interpolazioni tra i punti di vista sparsi dei dispositivi di cattura:
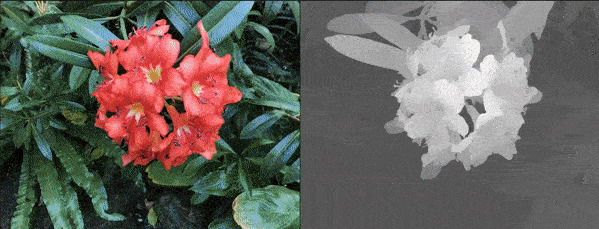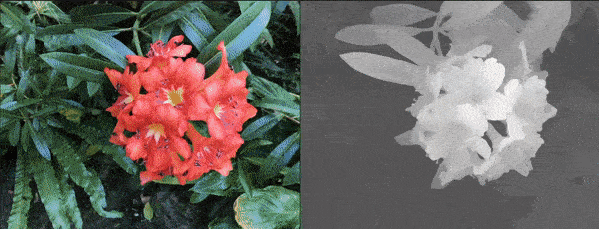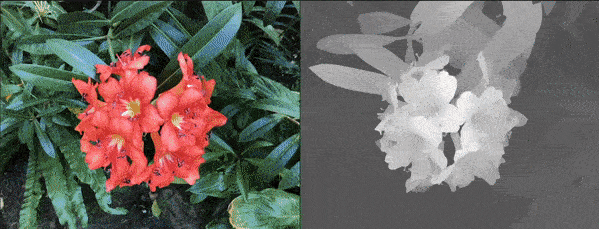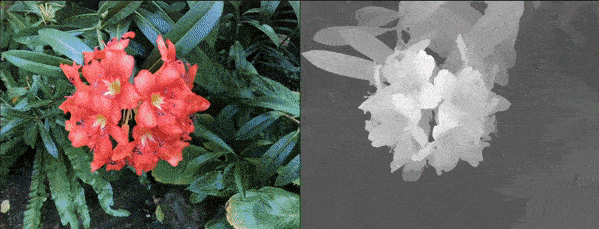
NeRF può generare profondità volumetrica tramite il calcolo di mappe di profondità, piuttosto che la generazione di mesh CG. Fonte: https://www.youtube.com/watch?v=JuH79E8rdKc
Sebbene NeRF sia capace di calcolare mesh, la maggior parte delle implementazioni non utilizza questo per generare scene volumetriche.
Al contrario, l’approccio Implicit Differentiable Renderer (IDR), pubblicato dall’Istituto Weizmann di Scienze nell’ottobre 2020, si basa sull’utilizzo delle informazioni di mesh 3D generate automaticamente dagli apparati di acquisizione:
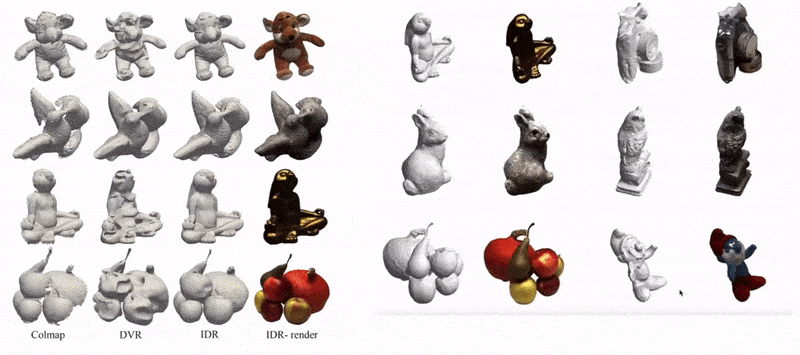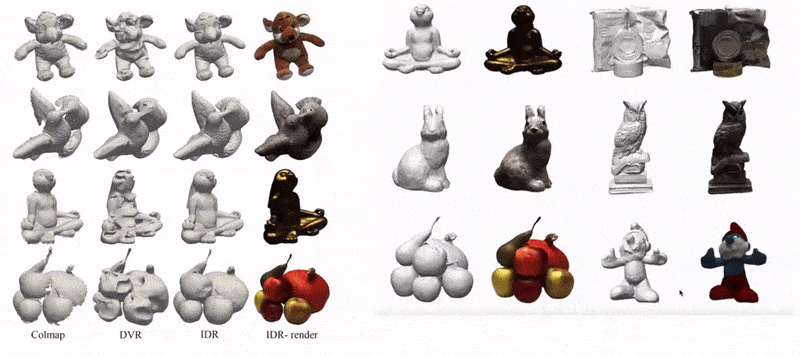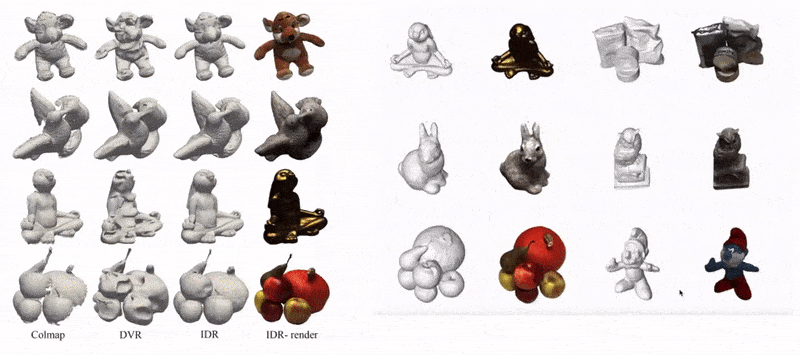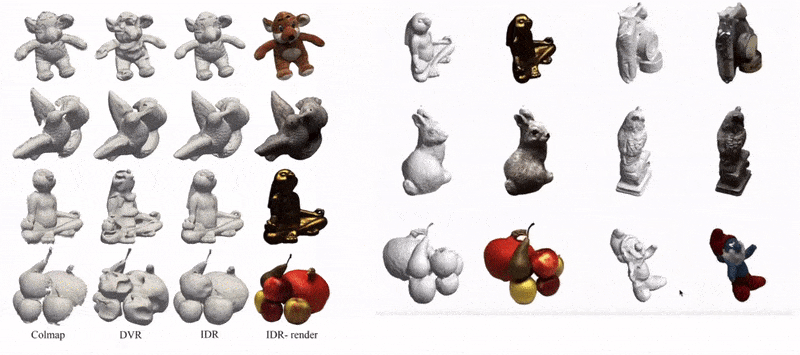
Esempi di acquisizioni IDR trasformate in mesh CGI interattive. Fonte: https://www.youtube.com/watch?v=C55y7RhJ1fE
Mentre NeRF non dispone della capacità di IDR di stimare la forma, IDR non raggiunge la qualità d’immagine di NeRF, ed entrambi richiedono risorse considerevoli per l’addestramento e l’aggregazione, anche se recenti innovazioni in NeRF stanno iniziando ad affrontare questo problema.

L’apparato di ripresa personalizzato di NLR comprende 16 GoPro HERO7 e 6 telecamere centrali Back-Bone H7PRO. Per il rendering in tempo reale operano ad almeno 60 fps. Fonte: https://arxiv.org/pdf/2103.11571.pdf
Neural Lumigraph Rendering utilizza invece SIREN (reti di rappresentazione sinusoidale) per incorporare i punti di forza di ogni approccio nel proprio framework, che è destinato a generare output direttamente utilizzabile nelle pipeline grafiche in tempo reale esistenti.
SIREN è stato utilizzato per implementazioni simili nel corso dell’ultimo anno e ora rappresenta una chiamata API popolare per notebook Colab amatoriali nelle comunità di sintesi di immagini; tuttavia, l’innovazione di NLR è applicare SIREN alla supervisione di immagini multiviste bidimensionali, che è problematica a causa della misura in cui SIREN produce output sovra-adattato piuttosto che generalizzato.
Dopo che la mesh CG è estratta dalle immagini dell’array, la mesh viene rasterizzata tramite OpenGL e le posizioni dei vertici della mesh vengono mappate ai pixel appropriati, dopo di che la fusione delle varie mappe contribuenti viene calcolata.
La mesh risultante è più generalizzata e rappresentativa di quella di NeRF (vedi immagine sotto), richiede meno calcoli e non applica eccessivi dettagli alle aree (come la pelle facciale liscia) che non possono trarne beneficio:

Fonte: https://arxiv.org/pdf/2103.11571.pdf
Dal lato negativo, NLR non ha ancora la capacità di illuminazione dinamica o ri-illuminazione, e l’output è limitato a mappe di ombre e altre considerazioni di illuminazione ottenute al momento della cattura. I ricercatori intendono affrontare questo in lavori futuri.
Inoltre, il paper ammette che le forme generate da NLR non sono così accurate come alcuni approcci alternativi, come Selezione di Vista Punto per Punto per Stereo Multi-View non Strutturato, o la ricerca dell’Istituto Weizmann menzionata in precedenza.
L’Ascesa della Sintesi di Immagini Volumetriche
L’idea di creare entità 3D da una serie limitata di foto con reti neurali precede NeRF, con paper visionari che risalgono al 2007 o precedenti. Nel 2019 il dipartimento di ricerca AI di Facebook ha prodotto un paper di ricerca seminale, Volumi Neurali: Apprendimento di Volumi Renderabili Dinamici da Immagini, che ha consentito per la prima volta interfacce responsive per esseri umani sintetici generati da cattura volumetrica basata su apprendimento automatico.
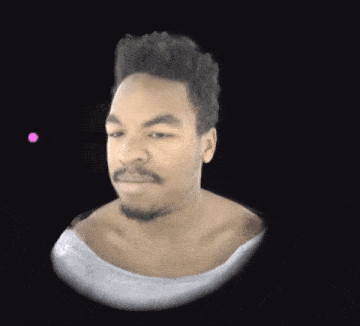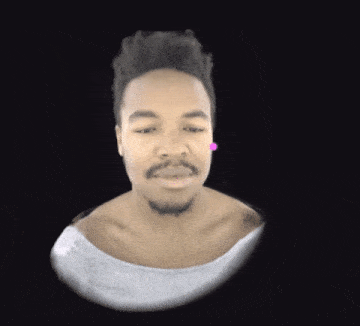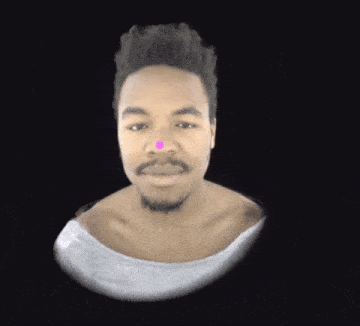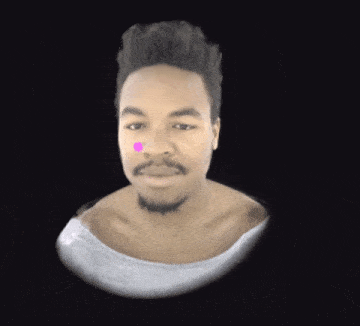
La ricerca del 2019 di Facebook ha consentito la creazione di un’interfaccia utente responsiva per un essere umano volumetrico. Fonte: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


