
Fondamenti di IA
SGD vs. Adam: Come gli ottimizzatori di apprendimento automatico apprendono realmente
Stochastic gradient descent e Adam sono algoritmi di ottimizzazione che aggiornano i parametri del modello a partire da gradienti stimati, ma impiegano regole diverse per il momentum e le dimensioni dei passi per parametro. Questa guida spiega il meccanismo, i compromessi, la valutazione e i controlli rilevanti nella pratica.

 Aggiungi Unite.AI alle tue fonti preferite su Google
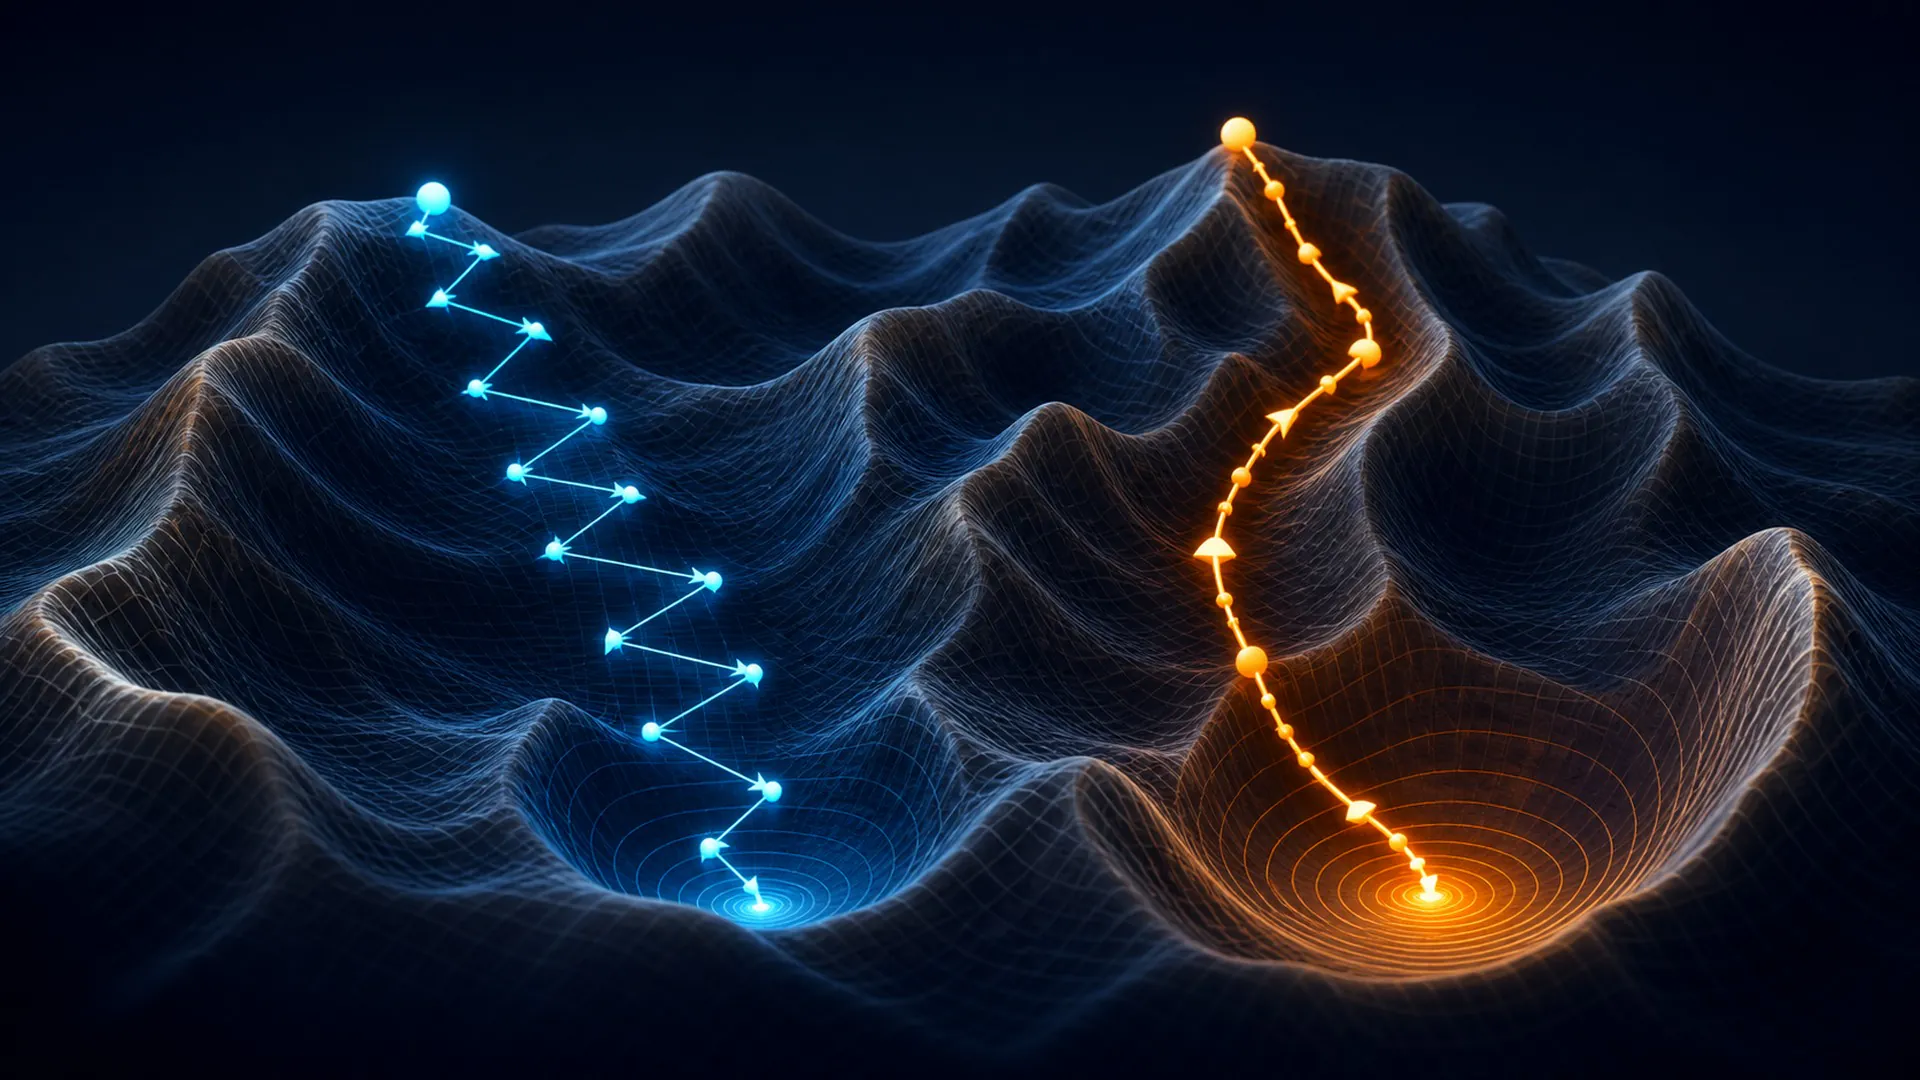
La discesa del gradiente stocastico e Adam sono algoritmi di ottimizzazione che aggiornano i parametri del modello a partire da gradienti stimati, ma utilizzano regole diverse per il momentum e per le dimensioni dei passi per parametro.
SGD e Adam meritano una spiegazione precisa perché il loro nome identifica un flusso informativo, una scelta di addestramento, un meccanismo di runtime o un confine di governance particolare. Trattarlo come sinonimo di “advanced AI” rende le affermazioni impossibili da verificare. Questa guida segue il concetto dal suo input e dalle sue assunzioni fino al risultato osservabile, per poi testare la scorciatoia più probabilmente confusa con esso.
SGD e Adam: Definizione, Confine e Scopo
La discesa del gradiente stocastico e Adam sono algoritmi di ottimizzazione che aggiornano i parametri del modello a partire da gradienti stimati, ma utilizzano regole diverse per il momentum e per le dimensioni dei passi per parametro. La definizione contiene tre impegni pratici: esiste un input identificabile, una trasformazione o decisione caratteristica di SGD e Adam, e un risultato che può essere valutato rispetto a un obiettivo dichiarato. Se uno di questi elementi manca, l’etichetta può descrivere un’aspirazione piuttosto che un meccanismo implementato.
L’apprendimento statistico trasforma campioni finiti in affermazioni sui dati futuri. Suddivisione, ottimizzazione, regolarizzazione, metriche e monitoraggio sono quindi parti di un unico problema di generalizzazione piuttosto che tecniche isolate da manuale. Per SGD e Adam, questa visione di sistema è importante perché le prestazioni possono dipendere dai dati circostanti, dalle interfacce, dall’hardware, dalle autorizzazioni e dalle persone anche quando il modello sottostante rimane invariato. Una spiegazione utile, quindi, separa il comportamento appreso dal modello dal prodotto che decide quando, dove e con quale autorità tale comportamento viene utilizzato.
La scorciatoia fuorviante più vicina è un metodo di ricerca che valuta modelli completi senza gradienti. Può condividere una caratteristica visibile con SGD e Adam, ma altera la narrazione causale: prove diverse stabilirebbero il successo, risorse diverse dominerebbero i costi e controlli diversi prevenirebbero danni. Il confine è quindi operativo piuttosto che terminologico.
Una mappa operativa a cinque fasi di SGD e Adam
Il diagramma è una mappa causale compatta per SGD e Adam, non un’affermazione secondo cui ogni implementazione utilizza cinque componenti software. Alcuni sistemi combinano le fasi e altri le ripetono in un ciclo. La mappa rimane utile perché impone che ogni cambiamento di informazione o autorità abbia un responsabile, un input, un output e un test.
1. Campionare un mini-batch e calcolare la perdita: Input e ipotesi in SGD e Adam
In questa fase di SGD e Adam, il sistema deve campionare un mini-batch e calcolare la perdita. La domanda utile non è solo se tale operazione avvenga, ma quali informazioni consuma, quale stato modifica e quali prove dimostrino che la modifica sia valida. Un revisore dovrebbe essere in grado di distinguere l’operazione da un metodo di ricerca che valuta modelli completi senza gradienti e di riprodurne il risultato nelle stesse condizioni dichiarate.
Il passaggio a questa fase di SGD e Adam inizia con l’obiettivo dichiarato e dovrebbe concludersi con un risultato che possa supportare la retropropagazione dei gradienti. Registrare l’incertezza, le alternative rifiutate, l’uso delle risorse e qualsiasi controllo umano o software applicato al confine. Questa traccia è il punto in cui i team possono rilevare se Adam può convergere rapidamente mentre SGD può generalizzare diversamente, e entrambi sono sensibili a pianificazioni e scala prima che la stessa debolezza raggiunga un output significativo.
2. Propagare all’indietro i gradienti: Rappresentazione o decisione in SGD e Adam
In questa fase di SGD e Adam, il sistema deve propagare all’indietro i gradienti. La domanda utile non è solo se tale operazione avvenga, ma quali informazioni consuma, quale stato modifica e quali prove dimostrino che la modifica sia valida. Un revisore dovrebbe essere in grado di distinguere l’operazione da un metodo di ricerca che valuta modelli completi senza gradienti e di riprodurne il risultato nelle stesse condizioni dichiarate.
Il passaggio a questa fase di SGD e Adam inizia con il campionamento di un mini-batch e il calcolo della perdita e dovrebbe terminare con un risultato in grado di supportare l’accumulo di momentum o di stime dei momenti. Registrare l’incertezza, le alternative rifiutate, l’uso delle risorse e qualsiasi controllo umano o software applicato al confine. Tale traccia è il punto in cui i team possono rilevare se Adam può convergere rapidamente mentre SGD può generalizzare diversamente, e entrambi sono sensibili a pianificazioni e scala prima che la stessa debolezza raggiunga un output significativo.
3. Accumulare Momentum o Stime dei Momenti: Trasformazione Distintiva in SGD e Adam
In questa fase di SGD e Adam, il sistema deve accumulare momentum o stime dei momenti. La domanda utile non è solo se tale operazione avvenga, ma quali informazioni consuma, quale stato modifica e quali prove dimostrino che la modifica sia valida. Un revisore dovrebbe essere in grado di distinguere l’operazione da un metodo di ricerca che valuta modelli completi senza gradienti e di riprodurne il risultato nelle stesse condizioni dichiarate.
Il passaggio a questa fase di SGD e Adam inizia con la retropropagazione dei gradienti e dovrebbe terminare con un risultato in grado di supportare l’applicazione dell’aggiornamento dei parametri dell’ottimizzatore. Registrare l’incertezza, le alternative rifiutate, l’uso delle risorse e qualsiasi controllo umano o software applicato al confine. Tale traccia è il punto in cui i team possono rilevare se Adam può convergere rapidamente mentre SGD può generalizzare diversamente, e entrambi sono sensibili a pianificazioni e scala prima che la stessa debolezza raggiunga un output significativo.
4. Applicare l’Aggiornamento dei Parametri dell’Ottimizzatore: Vincolo e Confine di Verifica in SGD e Adam
In questa fase di SGD e Adam, il sistema deve applicare l’aggiornamento dei parametri dell’ottimizzatore. La domanda utile non è solo se tale operazione avvenga, ma quali informazioni consuma, quale stato modifica e quali prove dimostrino che la modifica sia valida. Un revisore dovrebbe essere in grado di distinguere l’operazione da un metodo di ricerca che valuta modelli completi senza gradienti e di riprodurne il risultato nelle stesse condizioni dichiarate.
Il passaggio a questa fase di SGD e Adam inizia con l’accumulo di momentum o stime dei momenti e dovrebbe terminare con un risultato in grado di supportare la regolazione del programma di apprendimento e la ripetizione. Registrare l’incertezza, le alternative rifiutate, l’uso delle risorse e qualsiasi controllo umano o software applicato al confine. Tale traccia è il punto in cui i team possono rilevare se Adam può convergere rapidamente mentre SGD può generalizzare diversamente, e entrambi sono sensibili a pianificazioni e scala prima che la stessa debolezza raggiunga un output significativo.
5. Regolare il Programma di Learning Rate e Ripetere: Output, Feedback e Regola di Arresto in SGD e Adam
In questa fase di SGD e Adam, il sistema deve regolare il programma di learning rate e ripetere. La domanda utile non è solo se tale operazione avvenga, ma quali informazioni consuma, quale stato modifica e quali prove dimostrino che la modifica sia valida. Un revisore dovrebbe essere in grado di distinguere l’operazione da un metodo di ricerca che valuta modelli completi senza gradienti e di riprodurne il risultato nelle stesse condizioni dichiarate.
Il passaggio a questa fase di SGD e Adam inizia con l’applicazione dell’aggiornamento dei parametri dell’ottimizzatore e dovrebbe terminare con un risultato in grado di supportare il monitoraggio o una decisione finale. Registrare l’incertezza, le alternative rifiutate, l’uso delle risorse e qualsiasi controllo umano o software applicato al confine. Tale traccia è il punto in cui i team possono rilevare se Adam può convergere rapidamente mentre SGD può generalizzare diversamente, e entrambi sono sensibili a pianificazioni e scala prima che la stessa debolezza raggiunga un output significativo.
Leggi la mappa di SGD e Adam in avanti per comprendere la produzione e all’indietro per diagnosticare i fallimenti. L’analisi in avanti indaga come una fase alimenti la successiva. L’analisi all’indietro parte da un risultato errato, lento, costoso o non sicuro e traccia quale ipotesi precedente lo abbia permesso. Il percorso inverso è spesso il punto in cui un team scopre che l’errore decisivo si è verificato prima che il modello producesse qualcosa.
Un Esempio Pratico di SGD e Adam
Un modello di visione può utilizzare AdamW per un addestramento iniziale stabile o momentum SGD con un programma accuratamente ottimizzato.
Questo esempio è istruttivo perché SGD e Adam possono essere collegati a input osservabili, stati intermedi e a un risultato, anziché essere valutati tramite una dimostrazione rifinita. Un test rigoroso costruirebbe casi ordinari, difficili e deliberatamente fuorvianti attorno allo scenario, preserverebbe una baseline senza la tecnica e registrerebbe sia le prestazioni medie sia la gravità dei singoli fallimenti.
Modifica un’ipotesi nell’esempio di SGD e Adam e ripeti l’analisi. Rimuovi un input necessario, introduci un segnale conflittuale, limita la capacità di calcolo, altera la popolazione di utenti o costringe il sistema a astenersi. Un meccanismo che ha successo solo in una dimostrazione accuratamente organizzata non ha dimostrato di generalizzarsi all’ambiente operativo.
SGD e Adam vs. Il Loro Shortcut più Comune
Spesso SGD e Adam vengono ridotti a un metodo di ricerca che valuta modelli completi senza gradienti. Tale riduzione elimina il confine stesso che definisce il concetto. Può indurre gli acquirenti a confrontare prodotti diversi, i ricercatori a sovrastimare ciò che un esperimento dimostra e gli operatori a monitorare il segnale sbagliato dopo il deployment.
| Lente | Risposta pratica |
|---|---|
| Definizione | La discesa del gradiente stocastico (SGD) e Adam sono algoritmi di ottimizzazione che aggiornano i parametri del modello a partire da gradienti stimati, ma utilizzano regole diverse per il momentum e per le dimensioni dei passi per parametro. |
| Confusione | un metodo di ricerca che valuta modelli completi senza gradienti. |
| Rischio | Adam può convergere rapidamente mentre SGD può generalizzare diversamente, e entrambi sono sensibili a pianificazioni e scala. |
Il confronto dovrebbe anche identificare l’unità di analisi. Un articolo su SGD e Adam può isolare un modello o un algoritmo, mentre un servizio distribuito aggiunge recupero, instradamento, caching, policy, identità, interfacce utente e monitoraggio. Due prodotti possono utilizzare lo stesso termine di intestazione implementando parti diverse di quello stack. Chiedete quale componente esegue la trasformazione definitoria e quali altri componenti sono necessari per il risultato riportato.
Perché SGD e Adam sono importanti nei sistemi IA attuali
SGD e Adam sono ora rilevanti perché i sistemi IA stanno ricevendo contesti più ampi, più modalità, più capacità di calcolo in tempo reale, un accesso più ampio agli strumenti e connessioni più profonde alle decisioni organizzative. In tali condizioni, ciò che una volta sembrava un dettaglio di ricerca può determinare latenza, sicurezza, accessibilità, costo ambientale, qualità del prodotto o responsabilità legale.
La misura rilevante non è se SGD e Adam possono produrre un unico risultato impressionante. È se la tecnica migliora un risultato che conta su condizioni rappresentative e lo fa più efficacemente di una baseline più semplice. Segnalate le distribuzioni, le categorie di errore, la latenza di coda, l’uso delle risorse e i sottogruppi interessati, invece di comprimere ogni risultato in una media unica.
Scegliete le procedure in base alla struttura dei dati e al costo decisionale. Conservate gruppi e tempi, quantificate l’incertezza, ispezionate le sezioni, bloccate i test finali e verificate che i guadagni offline sopravvivano al deployment. Applicata specificamente a SGD e Adam, tale disciplina rende le evidenze portabili: un altro team può valutare se il guadagno dichiarato è probabile che sopravviva a un modello diverso, a un linguaggio, a una piattaforma hardware, a un dataset, a una popolazione di utenti o a una tolleranza al rischio diversa.
Benefici che SGD e Adam possono offrire
Il motivo più forte per utilizzare SGD e Adam è che possono affrontare direttamente il collo di bottiglia previsto. A seconda dell’implementazione, il beneficio può manifestarsi come un ancoraggio migliore, una rappresentazione più fedele, una generalizzazione migliorata, una latenza più bassa, una riduzione degli spostamenti di memoria, una responsabilità più chiara o un confine più sicuro tra una proposta di modello e un’azione reale.
I benefici dovrebbero essere espressi come decisioni e misurazioni. “Più intelligente” non è un criterio di accettazione per SGD e Adam. Un obiettivo utile potrebbe specificare il tasso di errore nei casi difficili, il recupero dopo evidenze contrastanti, il costo a un percentile del traffico, il tempo di revisione umana, la calibrazione o la percentuale di azioni mantenute entro un limite di autorità definito.
La modalità di fallimento che definisce SGD e Adam
La limitazione centrale è che Adam può convergere rapidamente mentre SGD può generalizzare diversamente, e entrambi sono sensibili a pianificazioni e scala. Questo fallimento non è un ripensamento da elencare una volta completato lo sviluppo. Dovrebbe influenzare la raccolta dei dati, l’architettura, le autorizzazioni, la valutazione, i gate di rilascio e il monitoraggio di SGD e Adam fin dall’inizio.
Un controllo per SGD e Adam è utile solo se interviene prima di una conseguenza costosa o irreversibile. Identificare il precursore osservabile più precoce del guasto, impostare una soglia o una regola, assegnare un responsabile e testare il recupero. A seconda del caso d’uso, il recupero può significare astenersi, ricorrere a un sistema più semplice, richiedere ulteriori evidenze, escalation a una persona, ripristinare un modello o interrompere completamente un’azione.
Un piano di valutazione per SGD e Adam
Iniziare la valutazione di SGD e Adam redigendo la decisione che le evidenze devono supportare. Definire la popolazione operativa, la conseguenza di un risultato errato, le informazioni effettivamente disponibili al momento della decisione e l’alternativa credibile più semplice. Ciò impedisce che un benchmark diventi l’obiettivo solo perché è facile da eseguire.
Utilizzare un set di test intatto per confronti controllati, quindi convalidare SGD e Adam in un ambiente operativo a fasi. La valutazione offline rende le varianti comparabili; la modalità shadow, i canarini, i limiti di velocità o i cancelli di approvazione rivelano come il traffico reale, i loop di feedback e le persone modificano il comportamento. La fase di distribuzione dovrebbe prevedere una condizione di arresto esplicita anziché presumere che ogni miglioramento meriti un rollout completo.
Versionare gli input necessari per riprodurre SGD e Adam: dati di origine, preprocessing, tokenizer o encoder, pesi del modello, configurazione, prompt o policy, indice di recupero, set di valutazione, ipotesi hardware e codice di servizio, se applicabile. Senza tracciabilità, un team non può capire se un risultato modificato provenga dalla tecnica, dall’ambiente o da una modifica non rilevata nella pipeline.
Infine, chiedersi quale scoperta falsificherebbe l’affermazione che SGD e Adam siano utili. Se nessun risultato potesse invertire la decisione di adozione, la valutazione è marketing. Soglie di accettazione predefinite e un set di conferma conservato trasformano l’esercizio in evidenza.
Domande da porsi prima di adottare SGD e Adam
- Obiettivo: Quale collo di bottiglia misurabile è destinato a risolvere SGD e Adam?
- Meccanismo: Quale delle cinque fasi contiene la trasformazione distintiva?
- Baseline: Come si confronta con un metodo di ricerca che valuta modelli completi senza gradienti o con un’alternativa più semplice?
- Evidenza: Quali casi ordinari, difficili, avversari e di sottogruppo sono stati testati?
- Operazioni: Quali costi di latenza, memoria, calcolo, energia, manutenzione e revisione emergono su larga scala?
- Rischio: Come rileverà il team che Adam può convergere rapidamente mentre SGD può generalizzare diversamente, e che entrambi sono sensibili a pianificazioni e scala?
- Recupero: Il sistema può astenersi, ricorrere a una soluzione di fallback, effettuare un rollback o effettuare un’escalation prima di un danno?
Fonti primarie per studiare SGD e Adam
Punti di partenza autorevoli per la parte dello stack AI che circonda SGD e Adam includono guida alla selezione del modello scikit-learn, Regole di ML di Google, NIST AI RMF. Leggili insieme alla documentazione per il modello esatto, il dataset, l’hardware e la giurisdizione coinvolti. Una fonte generale può definire il meccanismo, ma solo prove specifiche per il deployment possono stabilire che una particolare implementazione sia adeguata.
Cosa ricordare su SGD e Adam
SGD e Adam è un meccanismo definito all’interno di un più ampio sistema sociotecnico. Il suo valore deriva dal migliorare un risultato specifico sotto condizioni esplicite, non dall’etichetta stessa. La mappa a cinque fasi rende visibile il flusso di informazioni, il confronto identifica ciò che non è, e il percorso di controllo mostra dove un operatore responsabile può intervenire.
La regola pratica per SGD e Adam è definire l’obiettivo, confrontarsi con un baseline credibile, testare il guasto più rilevante e conservare le evidenze necessarie per monitorare il cambiamento. Con questi elementi in atto, il concetto diventa una scelta di ingegneria e governance valutabile. In loro assenza, rimane un nome promettente legato a un rischio operativo sconosciuto.


