
Angolo di Anderson
Rimozione di oggetti da video in modo più efficiente con l’apprendimento automatico

 Aggiungi Unite.AI alle tue fonti preferite su Google
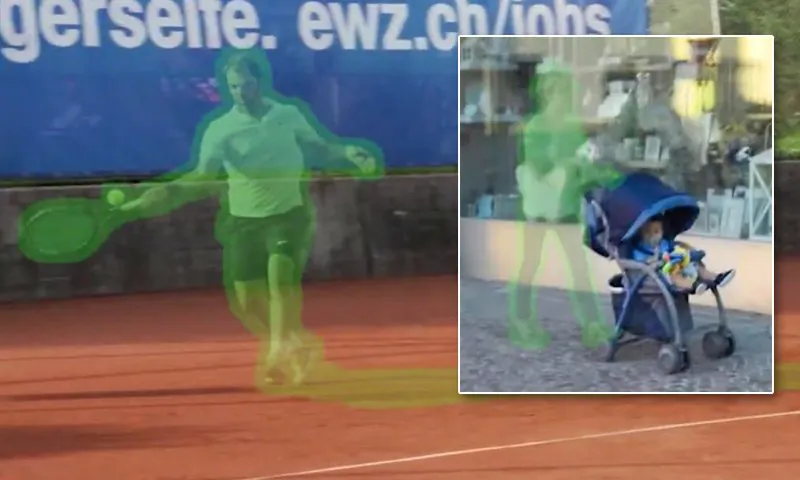
Una nuova ricerca proveniente dalla Cina riporta risultati all’avanguardia, nonché un’impressionante miglioramento in termini di efficienza, per un nuovo sistema di inpainting video in grado di rimuovere abilmente gli oggetti dalle riprese.
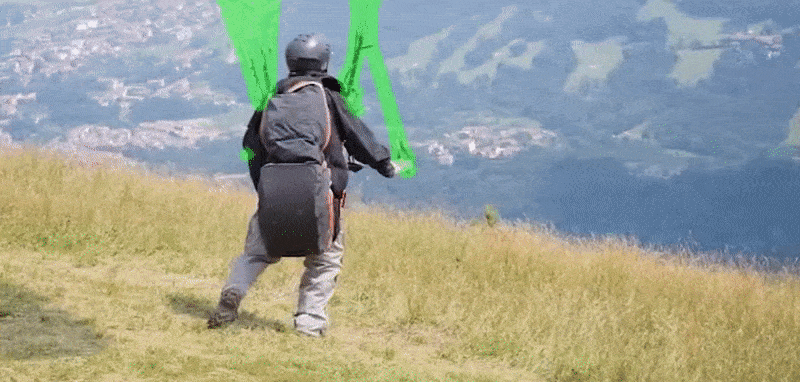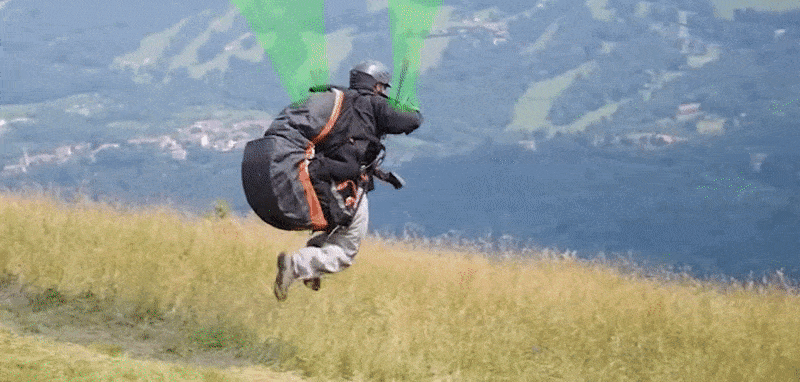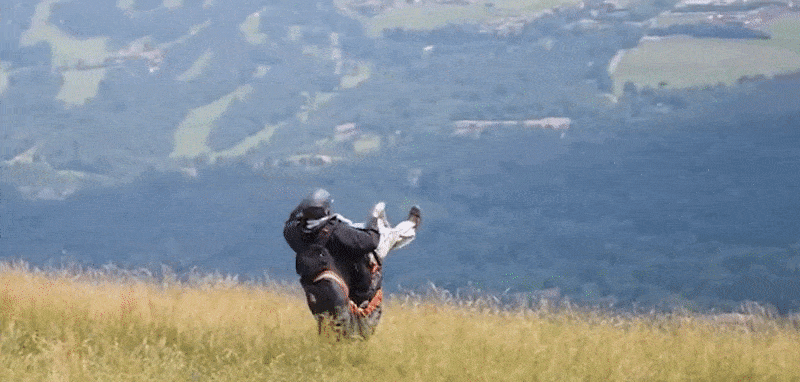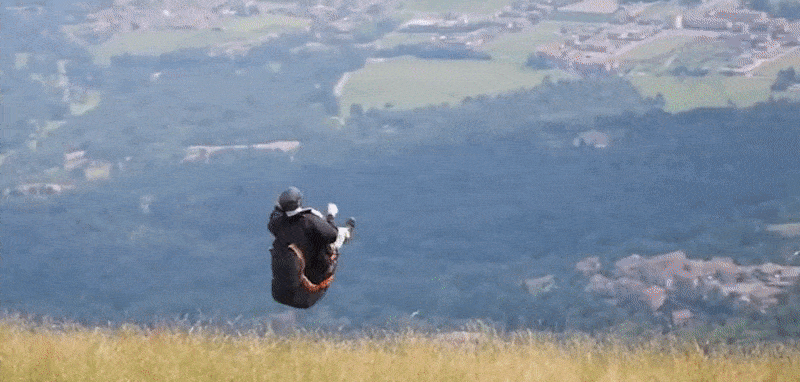
L’imbracatura di un aliante è stata dipinta con il nuovo procedimento. Vedi il video di origine per una risoluzione migliore e altri esempi. Fonte: https://www.youtube.com/watch?v=N–qC3T2wc4
La tecnica, chiamata End-to-End framework per Flow-Guided video Inpainting (E2FGVI), è anche in grado di rimuovere i watermark e altri tipi di occlusione dai contenuti video.
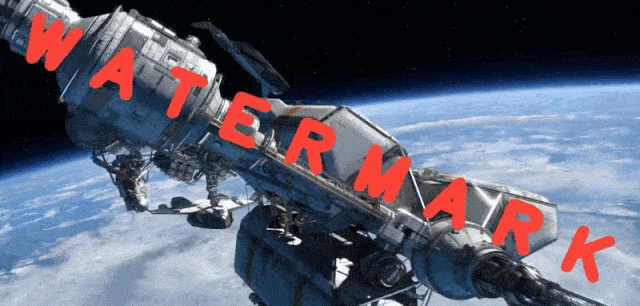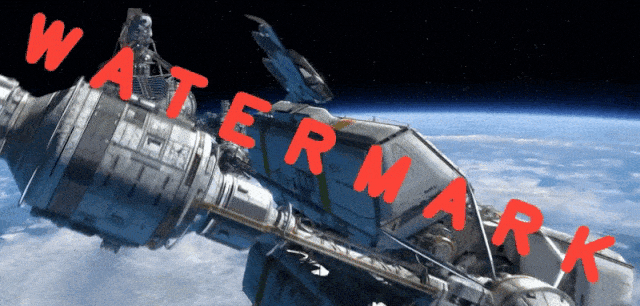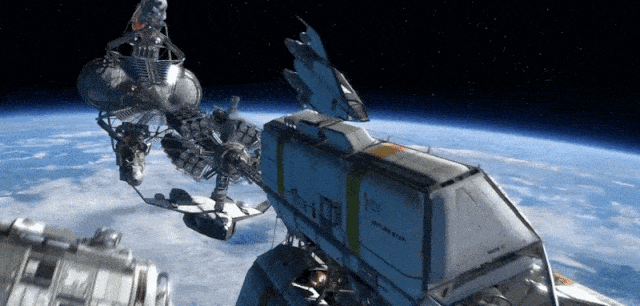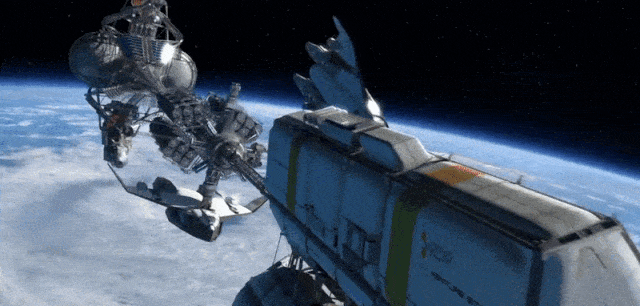
E2FGVI calcola le previsioni per il contenuto che si trova dietro le occlusione, consentendo la rimozione anche di watermark notevoli e intractabili. Fonte: https://github.com/MCG-NKU/E2FGVI
(Per vedere altri esempi in risoluzione migliore, controlla il video)
Sebbene il modello presentato nel paper pubblicato sia stato addestrato su video di 432px x 240px (dimensioni di input comunemente basse, limitate dallo spazio disponibile sulla GPU rispetto alle dimensioni di batch ottimali e ad altri fattori), gli autori hanno successivamente rilasciato E2FGVI-HQ, che può gestire video a risoluzione arbitraria.
Il codice per la versione attuale è disponibile su GitHub, mentre la versione HQ, rilasciata l’ultima domenica, può essere scaricata da Google Drive e Baidu Disk.

Il bambino rimane nell’immagine.
E2FGVI può elaborare video da 432×240 in 0,12 secondi per frame su una GPU Titan XP (12GB VRAM), e gli autori riportano che il sistema funziona quindici volte più velocemente dei metodi precedenti basati su flusso ottico.
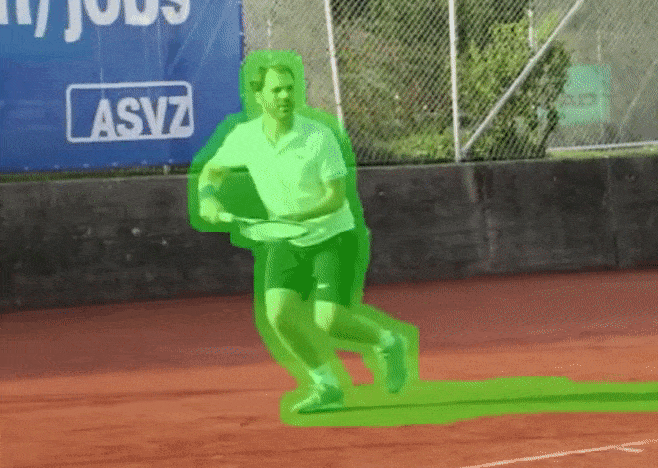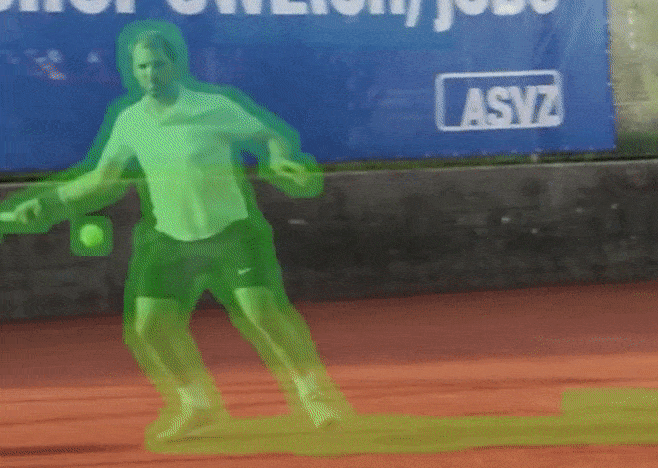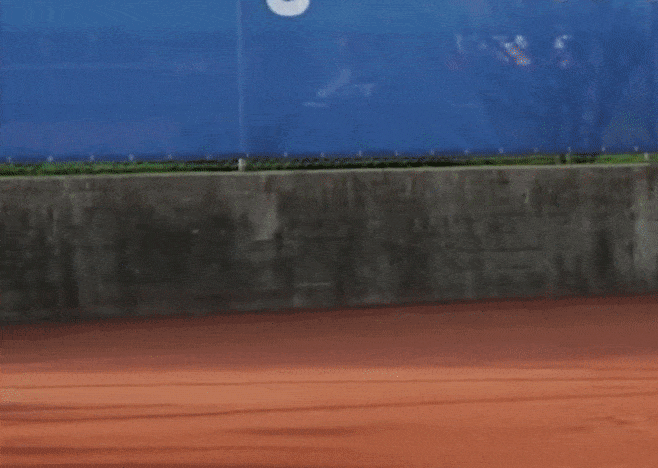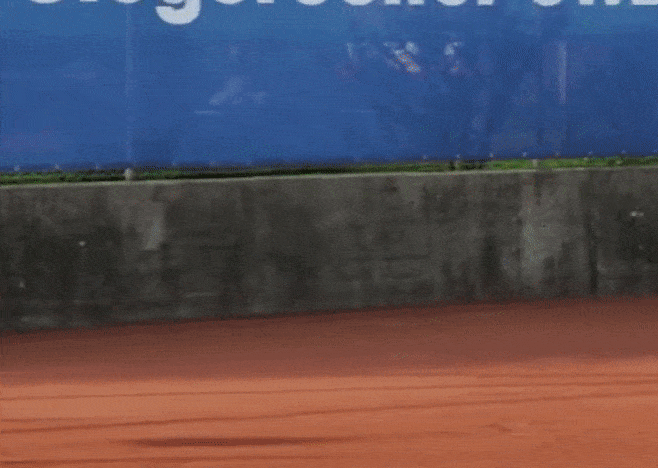
Un giocatore di tennis fa una uscita inaspettata.
Testato su set di dati standard per questo sottosettore di ricerca sulla sintesi di immagini, il nuovo metodo è stato in grado di superare i rivali sia nella valutazione qualitativa che in quella quantitativa.

Test contro approcci precedenti. Fonte: https://arxiv.org/pdf/2204.02663.pdf
Il paper è intitolato Verso un framework End-to-End per Flow-Guided Video Inpainting, ed è una collaborazione tra quattro ricercatori dell’Università di Nankai, insieme a un ricercatore di Hisilicon Technologies.
Cosa manca in questo quadro
Oltre alle sue ovvie applicazioni per gli effetti visivi, l’inpainting video di alta qualità è destinato a diventare una caratteristica fondamentale delle nuove tecnologie di sintesi di immagini e alterazione di immagini basate su intelligenza artificiale.
Questo è particolarmente vero per le applicazioni di moda che alterano il corpo, e altri framework che cercano di ‘dimagrire’ o alterare in altro modo le scene in immagini e video. In tali casi, è necessario ‘riempire’ in modo convincente lo sfondo aggiuntivo esposto dalla sintesi.

Da un recente paper, un algoritmo di ‘riaggiustamento’ del corpo è incaricato di inpainting lo sfondo appena rivelato quando un soggetto viene ridimensionato. Qui, quel deficit è rappresentato dal contorno rosso che la persona (nella vita reale, vedi immagine a sinistra) più formosa occupava in precedenza. Basato su materiale di origine da https://arxiv.org/pdf/2203.10496.pdf
Flusso ottico coerente
Il flusso ottico (OF) è diventato una tecnologia fondamentale nello sviluppo della rimozione di oggetti video. Come un atlante, OF fornisce una mappa unica di una sequenza temporale. Spesso utilizzato per misurare la velocità nelle iniziative di visione computerizzata, OF può anche consentire l’inpainting temporale coerente, dove la somma totale del compito può essere considerata in un’unica passata, invece del metodo ‘per frame’ di Disney, che inevitabilmente porta a discontinuità temporale.
I metodi di inpainting video fino ad oggi si sono concentrati su un processo in tre fasi: completamento del flusso, dove il video è essenzialmente mappato in un’entità discreta ed esplorabile; propagazione dei pixel, dove i buchi nei video ‘corrotti’ vengono riempiti propagando bidirezionalmente i pixel; e allucinazione del contenuto (invenzione di pixel che è familiare a molti di noi dalle deepfake e dai framework di testo-immagine come la serie DALL-E) dove il contenuto ‘mancante’ stimato viene inventato e inserito nel filmato.
La principale innovazione di E2FGVI è combinare queste tre fasi in un sistema end-to-end, eliminando la necessità di eseguire operazioni manuali sul contenuto o sul processo.

Il paper osserva che la necessità di intervento manuale richiede che i processi più vecchi non utilizzino una GPU, rendendoli piuttosto laboriosi. Dal paper*:
‘Prendendo DFVI come esempio, completare un video con dimensioni di 432 × 240 da DAVIS, che contiene circa 70 frame, richiede circa 4 minuti, il che è inaccettabile nella maggior parte delle applicazioni del mondo reale. Inoltre, oltre ai suddetti svantaggi, l’uso di una rete di inpainting di immagini pre-addestrata solo alla fase di allucinazione del contenuto ignora le relazioni di contenuto tra vicini temporali, portando a contenuto generato incoerente nei video.’
Unendo le tre fasi dell’inpainting video, E2FGVI è in grado di sostituire la seconda fase, la propagazione dei pixel, con la propagazione delle caratteristiche. Nei processi più segmentati dei lavori precedenti, le caratteristiche non sono così ampiamente disponibili, perché ogni fase è relativamente ermetica e il flusso di lavoro è solo semi-automatizzato.
Inoltre, i ricercatori hanno ideato un trasformatore focale temporale per la fase di allucinazione del contenuto, che considera non solo i vicini diretti dei pixel nel frame corrente (cioè cosa sta succedendo in quella parte del frame nell’immagine precedente o successiva), ma anche i vicini distanti che sono molti frame lontani e che influenzeranno comunque l’effetto coeso di qualsiasi operazione eseguita sul video nel suo complesso.

Architettura di E2FGVI.
La nuova sezione centrale del flusso di lavoro basata sulle caratteristiche è in grado di sfruttare processi a livello di caratteristiche e campionamenti offset apprendibili, mentre il trasformatore focale del progetto, secondo gli autori, estende la dimensione delle finestre focali ‘da 2D a 3D’.
Test e dati
Per testare E2FGVI, i ricercatori hanno valutato il sistema contro due popolari set di dati per la segmentazione di oggetti video: YouTube-VOS e DAVIS. YouTube-VOS presenta 3741 clip video di addestramento, 474 clip di convalida e 508 clip di test, mentre DAVIS presenta 60 clip video di addestramento e 90 clip di test.
E2FGVI è stato addestrato su YouTube-VOS e valutato su entrambi i set di dati. Durante l’addestramento, le maschere degli oggetti (le aree verdi nelle immagini sopra e il video YouTube di accompagnamento) sono state generate per simulare il completamento del video.
Per le metriche, i ricercatori hanno adottato il rapporto di segnale/rumore di picco (PSNR), la similarità strutturale (SSIM), la distanza di Fréchet di video (VFID) e l’errore di warp del flusso – quest’ultimo per misurare la stabilità temporale nel video interessato.
I precedenti architetture contro cui il sistema è stato testato sono state VINet, DFVI, LGTSM, CAP, FGVC, STTN e FuseFormer.

Dalla sezione dei risultati quantitativi del paper. Le frecce in alto e in basso indicano che numeri più alti o più bassi sono migliori, rispettivamente. E2FGVI raggiunge i punteggi migliori in assoluto. I metodi sono valutati in base a FuseFormer, sebbene DFVI, VINet e FGVC non siano sistemi end-to-end, rendendo impossibile stimare i loro FLOPs.
Oltre a raggiungere i punteggi migliori contro tutti i sistemi in competizione, i ricercatori hanno condotto uno studio qualitativo su utenti, in cui video trasformati con cinque metodi rappresentativi sono stati mostrati individualmente a venti volontari, che sono stati invitati a valutarli in termini di qualità visiva.

L’asse verticale rappresenta la percentuale di partecipanti che hanno preferito l’output E2FGVI in termini di qualità visiva.
Gli autori notano che, nonostante la preferenza unanime per il loro metodo, uno dei risultati, FGVC, non riflette i risultati quantitativi, e suggeriscono che ciò indica che E2FGVI potrebbe, ingannevolmente, generare ‘risultati visivamente più piacevoli’.
In termini di efficienza, gli autori notano che il loro sistema riduce notevolmente le operazioni in virgola mobile al secondo (FLOPs) e il tempo di inferenza su una singola GPU Titan su il set di dati DAVIS, e osservano che i risultati mostrano E2FGVI in esecuzione x15 volte più veloce dei metodi basati sul flusso.
Commentano:
‘[E2FGVI] detiene il minor numero di FLOPs in confronto a tutti gli altri metodi. Ciò indica che il metodo proposto è altamente efficiente per l’inpainting video.’
*La mia conversione delle citazioni in linea degli autori in collegamenti ipertestuali.
Pubblicato per la prima volta il 19 maggio 2022.
Modificato martedì 28 ottobre 2025, per rimuovere l’inserimento di video difettoso e modificare i riferimenti al video incorporato nel corpo dell’articolo.


