
Modelli e piattaforme di IA
Dentro di o3 e o4-mini di OpenAI: sbloccare nuove possibilità attraverso il ragionamento multimodale e l’integrazione degli strumenti

 Aggiungi Unite.AI alle tue fonti preferite su Google
Il 16 aprile 2025, OpenAI ha rilasciato versioni aggiornate dei suoi modelli di ragionamento avanzato. Questi nuovi modelli, chiamati o3 e o4-mini, offrono miglioramenti rispetto ai loro predecessori, o1 e o3-mini, rispettivamente. I modelli più recenti offrono prestazioni migliorate, nuove funzionalità e una maggiore accessibilità. Questo articolo esplora i principali vantaggi di o3 e o4-mini, descrive le loro principali capacità e discute come potrebbero influenzare il futuro delle applicazioni di intelligenza artificiale. Ma prima di addentrarci in ciò che rende o3 e o4-mini distinti, è importante capire come i modelli di OpenAI sono evoluti nel tempo. Iniziamo con una breve panoramica del percorso di OpenAI nello sviluppo di sistemi linguistici e di ragionamento sempre più potenti.
L’evoluzione dei modelli linguistici di grandi dimensioni di OpenAI
Lo sviluppo di modelli linguistici di grandi dimensioni da parte di OpenAI è iniziato con GPT-2 e GPT-3, che hanno portato ChatGPT all’uso mainstream a causa della loro capacità di produrre testi fluenti e contestualmente accurati. Questi modelli sono stati ampiamente adottati per compiti come la sintesi, la traduzione e la risposta alle domande. Tuttavia, mentre gli utenti li applicavano a scenari più complessi, sono emerse le loro carenze. Questi modelli spesso faticavano con compiti che richiedevano un ragionamento profondo, una coerenza logica e una risoluzione dei problemi multi-step. Per affrontare queste sfide, OpenAI ha introdotto GPT-4 e ha spostato la sua attenzione verso il miglioramento delle capacità di ragionamento dei suoi modelli. Questo spostamento ha portato allo sviluppo di o1 e o3-mini. Entrambi i modelli utilizzavano un metodo chiamato chain-of-thought prompting, che consentiva loro di generare risposte più logiche e accurate ragionando passo dopo passo. Mentre o1 è progettato per soddisfare esigenze di risoluzione di problemi avanzati, o3-mini è costruito per offrire capacità simili in modo più efficiente e conveniente. Sulla base di questa fondazione, OpenAI ha ora introdotto o3 e o4-mini, che migliorano ulteriormente le capacità di ragionamento dei loro LLM. Questi modelli sono progettati per produrre risposte più accurate e ben considerate, soprattutto in campi tecnici come la programmazione, la matematica e l’analisi scientifica—domini in cui la precisione logica è fondamentale. Nella sezione successiva, esamineremo come o3 e o4-mini migliorano i loro predecessori.
Miglioramenti chiave in o3 e o4-mini
Capacità di ragionamento migliorate
Uno dei principali miglioramenti in o3 e o4-mini è la loro capacità di ragionamento migliorata per compiti complessi. A differenza dei modelli precedenti che fornivano risposte rapide, i modelli o3 e o4-mini impiegano più tempo per elaborare ogni prompt. Questa elaborazione aggiuntiva consente loro di ragionare più a fondo e produrre risposte più accurate, portando a risultati migliori sui benchmark. Ad esempio, o3 supera o1 del 9% su LiveBench.ai, un benchmark che valuta le prestazioni in compiti complessi come logica, matematica e codice. Su SWE-bench, che testa il ragionamento in compiti di ingegneria del software, o3 ha raggiunto un punteggio del 69,1%, superando anche modelli competitivi come Gemini 2.5 Pro, che ha segnato 63,8%. Nel frattempo, o4-mini ha segnato il 68,1% sullo stesso benchmark, offrendo quasi la stessa profondità di ragionamento a un costo molto inferiore.
Integrazione multimodale: pensare con le immagini
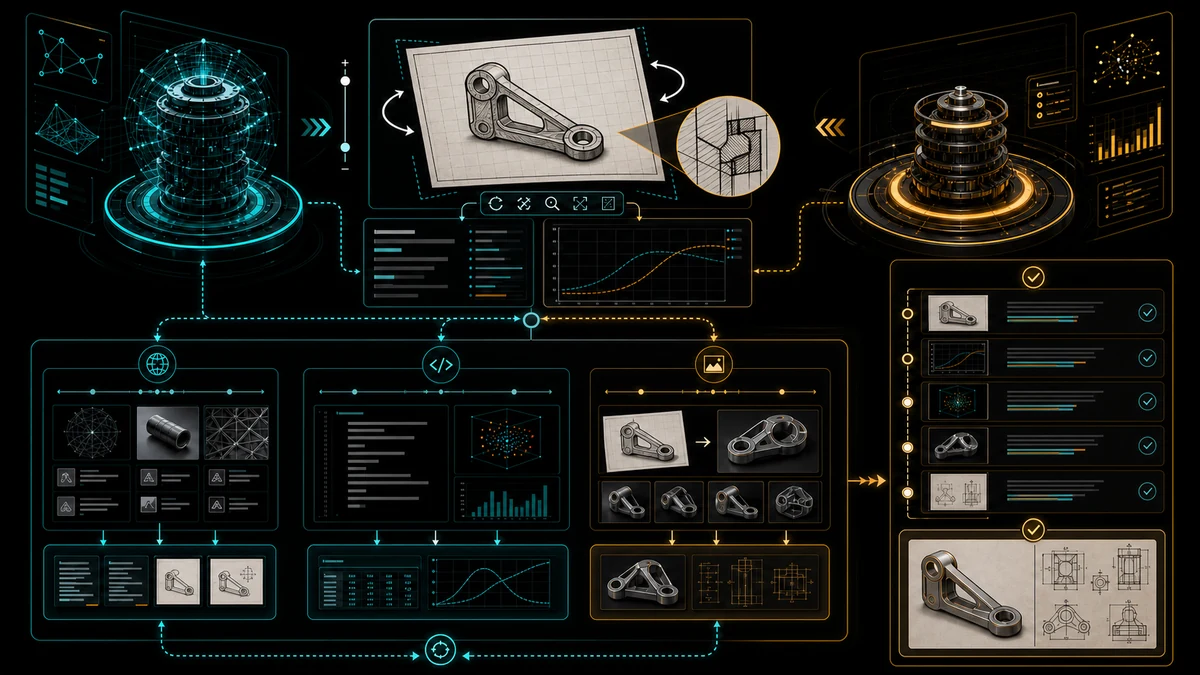
Una delle funzionalità più innovative di o3 e o4-mini è la loro capacità di “pensare con le immagini”. Ciò significa che possono non solo elaborare informazioni testuali, ma anche integrare direttamente i dati visivi nel loro processo di ragionamento. Possono comprendere e analizzare immagini, anche se sono di bassa qualità—come appunti scritti a mano, schizzi o diagrammi. Ad esempio, un utente potrebbe caricare un diagramma di un sistema complesso e il modello potrebbe analizzarlo, identificare potenziali problemi o addirittura suggerire miglioramenti. Questa capacità colma il divario tra dati testuali e visivi, consentendo interazioni più intuitive e complete con l’AI. Entrambi i modelli possono eseguire azioni come zoomare sui dettagli o ruotare le immagini per comprenderle meglio. Questo ragionamento multimodale rappresenta un notevole progresso rispetto ai predecessori come o1, che erano principalmente basati sul testo. Apre nuove possibilità per applicazioni in campi come l’istruzione, dove gli strumenti visivi sono cruciali, e la ricerca, dove diagrammi e grafici sono spesso centrali per la comprensione.
Uso avanzato degli strumenti
o3 e o4-mini sono i primi modelli di OpenAI a utilizzare tutti gli strumenti disponibili in ChatGPT contemporaneamente. Questi strumenti includono:
- Navigazione web: che consente ai modelli di recuperare le informazioni più recenti per le query sensibili al tempo.
- Esecuzione del codice Python: che consente loro di eseguire calcoli complessi o analisi dei dati.
- Elaborazione e generazione di immagini: che migliora la loro capacità di lavorare con dati visivi.
Utilizzando questi strumenti, o3 e o4-mini possono risolvere problemi complessi e multi-step più efficacemente. Ad esempio, se un utente chiede una domanda che richiede dati attuali, il modello può eseguire una ricerca web per recuperare le informazioni più recenti. Allo stesso modo, per compiti che coinvolgono l’analisi dei dati, può eseguire codice Python per elaborare i dati. Questa integrazione rappresenta un passo significativo verso agenti di intelligenza artificiale più autonomi che possono gestire una gamma più ampia di compiti senza intervento umano. L’introduzione di Codex CLI, un agente di codifica leggero e open-source che funziona con o3 e o4-mini, aumenta ulteriormente la loro utilità per gli sviluppatori.
Implicazioni e nuove possibilità
Il rilascio di o3 e o4-mini ha implicazioni diffuse in vari settori:
- Istruzione: questi modelli possono assistere studenti e insegnanti fornendo spiegazioni dettagliate e strumenti visivi, rendendo l’apprendimento più interattivo e efficace. Ad esempio, uno studente potrebbe caricare uno schizzo di un problema matematico e il modello potrebbe fornire una soluzione passo dopo passo.
- Ricerca: possono accelerare la scoperta analizzando set di dati complessi, generando ipotesi e interpretando dati visivi come grafici e diagrammi, il che è inestimabile per campi come la fisica o la biologia.
- Industria: possono ottimizzare i processi, migliorare la presa di decisioni e migliorare le interazioni con i clienti gestendo sia query testuali che visive, come l’analisi di progetti di prodotti o la risoluzione di problemi tecnici.
- Creatività e media: gli autori possono utilizzare questi modelli per trasformare un sommario di capitoli in una semplice storia. I musicisti possono abbinare le immagini a una melodia. I montatori video ricevono suggerimenti di tempistica. Gli architetti possono convertire piani di pavimento disegnati a mano in dettagliati progetti 3D che includono note strutturali e di sostenibilità.
- Accessibilità e inclusione: per gli utenti non vedenti, i modelli descrivono le immagini nel dettaglio. Per gli utenti non udenti, possono convertire diagrammi in sequenze visive o testo con didascalia. La loro traduzione di parole e immagini aiuta a colmare lacune linguistiche e culturali.
- Verso agenti autonomi: poiché i modelli possono navigare nel web, eseguire codice e elaborare immagini in un unico flusso di lavoro, formano la base per agenti autonomi. Gli sviluppatori descrivono una funzionalità; il modello scrive, testa e distribuisce il codice. I lavoratori della conoscenza possono delegare la raccolta dei dati, l’analisi, la visualizzazione e la stesura dei rapporti a un’unica assistente di intelligenza artificiale.
Limitazioni e prossimi passi
Nonostante questi progressi, o3 e o4-mini hanno ancora un limite di conoscenza di agosto 2023, che limita la loro capacità di rispondere agli eventi o tecnologie più recenti a meno che non vengano integrati con la navigazione web. Le iterazioni future affronteranno probabilmente questo divario migliorando l’ingestione dei dati in tempo reale.
Possiamo anche aspettarci ulteriori progressi negli agenti di intelligenza artificiale autonomi—sistemi che possono pianificare, ragionare, agire e imparare continuamente con una supervisione minima. L’integrazione di OpenAI degli strumenti, dei modelli di ragionamento e dell’accesso ai dati in tempo reale segnala che ci stiamo avvicinando a tali sistemi.
Il punto fondamentale
I nuovi modelli di OpenAI, o3 e o4-mini, offrono miglioramenti nel ragionamento, nella comprensione multimodale e nell’integrazione degli strumenti. Sono più precisi, versatili e utili in una vasta gamma di compiti—dall’analisi di dati complessi e dalla generazione di codice all’interpretazione delle immagini. Questi progressi hanno il potenziale per migliorare significativamente la produttività e accelerare l’innovazione in vari settori.





