
Interviste
Dott. Jaime Bland, Co-Fondatore e Amministratore Delegato di Aquila Health – Serie di Interviste

 Aggiungi Unite.AI alle tue fonti preferite su Google
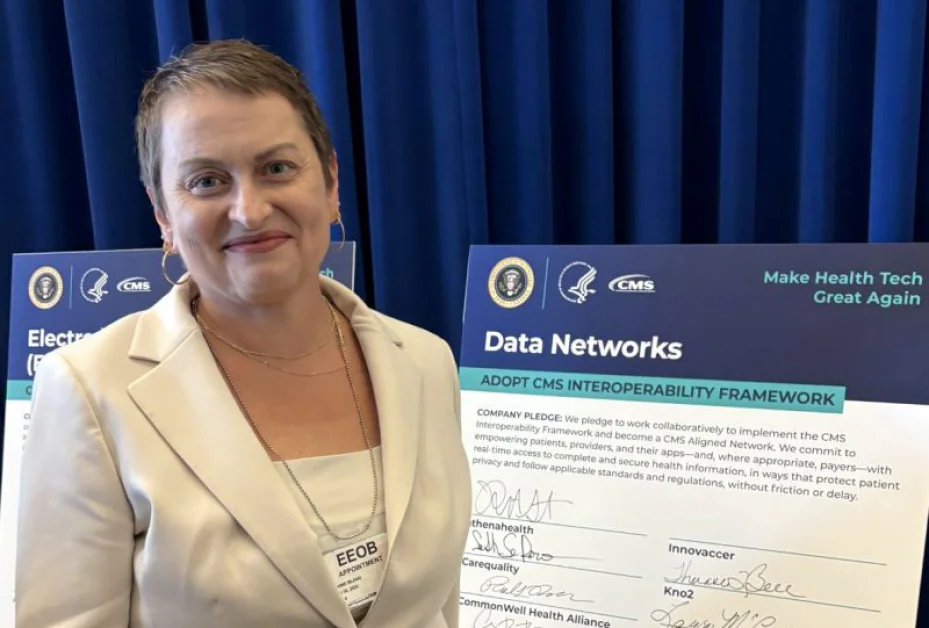
Dott. Jaime Bland, Co-Fondatore e Amministratore Delegato di Aquila Health, è un leader nel settore della tecnologia sanitaria che si concentra sul superamento di una delle sfide più persistenti dell’industria: i dati frammentati e inaccessibili. Ha co-fondato Aquila Health per creare un’infrastruttura di dati unificata che consenta alle organizzazioni sanitarie di andare oltre i sistemi isolati, sfruttando l’apprendimento automatico e l’analisi strutturata per generare informazioni azionabili mantenendo la supervisione clinica. Il suo lavoro si concentra sull’miglioramento dell’interoperabilità, sull’abilitazione dell’intelligenza sanitaria a livello di popolazione e sul sostegno alla rilevazione precoce di minacce sanitarie emergenti attraverso sistemi di dati clinici, di reclami e genetici integrati.
Aquila Health è una piattaforma di dati sanitari guidata dall’intelligenza artificiale progettata per unificare fonti di dati disparate in un sistema interoperabile che supporti sia l’efficienza operativa che l’analisi avanzata. La piattaforma inghiotte formati di dati sanitari ad alto volume come HL7 e FHIR, consentendo un’integrazione senza soluzione di continuità tra ospedali, sistemi di salute pubblica e altri soggetti interessati. Combinando approcci di apprendimento automatico strutturati con un modello di convalida umana, Aquila si concentra sul fornire informazioni affidabili per la gestione della salute di popolazione, la rilevazione di anomalie e la presa di decisioni in tempo reale, piuttosto che affidarsi esclusivamente a sistemi di intelligenza artificiale opachi. Ciò posiziona l’azienda all’intersezione dell’infrastruttura dei dati e dell’intelligenza artificiale applicata, dove il miglioramento della qualità e dell’accessibilità dei dati è fondamentale per sbloccare il pieno potenziale dell’intelligenza sanitaria.
Ha guidato CyncHealth attraverso una forte crescita, scalando l’interoperabilità su milioni di cartelle cliniche e più stati, prima di fondare Aquila Health. Quali sono stati i principali limiti o fallimenti sistemici che ha incontrato durante quel viaggio che l’hanno spinta a costruire Aquila fin dalle fondamenta?
In CyncHealth, abbiamo trascorso anni costruendo l’infrastruttura per collegare le organizzazioni sanitarie nel Nebraska e nell’Iowa. Abbiamo collegato oltre 1.100 siti di cura e milioni di cartelle cliniche, coprendo una popolazione di oltre cinque milioni di vite.
Tuttavia, continuavamo a incontrare il problema che collegare i sistemi e rendere i dati utilizzabili sono due problemi molto diversi. Ad esempio, abbiamo lavorato per creare un cruscotto per le overdose di oppioidi che coordinava i dati che ricevevamo da più fonti. Ci sono voluti mesi con centinaia di ore di lavoro e coordinamento tra molti soggetti interessati per rendere questo singolo punto di dati comprensibile in un contesto di salute pubblica e sanitario. E dopo tutto ciò, l’immagine era ancora incompleta.
Quell’esperienza è stata il seme per Aquila. Il modo tradizionale di collegare le interfacce senza capire la completezza e la qualità dell’esportazione dei dati non soddisferà il fabbisogno con i progressi che abbiamo visto negli ultimi anni nell’intelligenza artificiale. Quando l’intelligenza artificiale può realizzare in poche ore ciò che una squadra faceva in mesi, e lo fa con una qualità più alta a un costo inferiore, devi utilizzare quella conoscenza per ricostruire da una nuova base. È ciò che abbiamo fatto con Aquila, concentrandoci su strumenti moderni che riducono il costo di collegamento in modo che possiamo concentrarci sul completare l’intero quadro della salute, non solo i dati derivati dalle fonti tradizionali di EHI, ma l’intero quadro.
Aquila è recentemente emersa dalla fase di stealth con una piattaforma focalizzata sull’unificazione dei dati sanitari frammentati in un unico strato pronto per l’intelligenza artificiale. Quali sono stati i principali progressi tecnici che hanno reso possibile ciò adesso, rispetto a pochi anni fa?
Le capacità dell’intelligenza artificiale hanno guidato questo cambiamento quasi interamente.
Ho trascorso anni a guardare ingegneri esperti che riconciliavano manualmente gli standard dei dati, una fonte alla volta. Funzionava, ma quel modello non può mai scalare. Non puoi assumere personale sufficiente per tenere il passo con il volume e la varietà dei dati che il settore sanitario genera.
Ciò che è diverso adesso è che l’intelligenza artificiale può eseguire il lavoro di normalizzazione in modo continuo al livello dei dati mentre le informazioni si muovono attraverso il sistema. Non è un processo batch che si esegue durante la notte. Accade in tempo quasi reale. Ciò cambia ciò che è possibile per i clinici e le squadre di salute pubblica, perché i dati di cui hanno bisogno sono strutturati e convalidati (resi utilizzabili) prima di raggiungerli.
I clinici sono abituati a prendere decisioni senza l’immagine completa del paziente. La salute pubblica è abituata a guidare programmi senza dati recenti per sostenerli. Aquila sta cambiando il panorama e fornendo la velocità che rende possibile la presa di decisioni basate sui dati in modo efficace in tutta la sanità.
Abbiamo costruito TREUE™ come il framework che organizza i dati clinici derivati da EHR, laboratorio, salute pubblica, dati di reclami e farmacia in una struttura unificata. L’intelligenza artificiale non sostituisce una buona governance dei dati; la rende scalabile per la prima volta.
Ha sottolineato che la vera sfida nell’intelligenza artificiale sanitaria non sono i modelli, ma i dati stessi. Quali sono le lacune più critiche nell’attuale infrastruttura dei dati sanitari che impediscono all’intelligenza artificiale di fornire risultati significativi?
L’industria parla del modello di intelligenza artificiale, ma il modello non è la parte difficile.
La parte difficile è che un paziente può entrare in tre diverse strutture in un solo giorno e apparire come tre diverse persone in tre diversi sistemi. I laboratori non corrispondono alle note cliniche. Il record del pagatore ha un identificatore diverso rispetto al record dell’ospedale e la salute pubblica utilizza un identificatore completamente diverso. Una volta che si risolve tutto ciò manualmente, la finestra clinica si è chiusa.
Collegamenti tecnici forti non possono risolvere record che arrivano incompleti o fuori sequenza. L’intelligenza artificiale non può rilevare un modello che non è presente nei dati e non può fornire una raccomandazione affidabile da un record che manca della metà delle informazioni storiche o attuali che dovrebbe contenere.
La lacuna non è la potenza di elaborazione, ma la fiducia nei dati sottostanti. È ciò che deve essere risolto per primo e la risoluzione su larga scala è dove l’intelligenza artificiale può effettivamente guadagnare il suo posto.
Aquila si posiziona come il “livello di preparazione dei dati” prima dell’ingestione dell’intelligenza artificiale. Può spiegare cosa fa effettivamente questo livello nella pratica, specialmente quando si tratta di input eterogenei come record clinici, dati di reclami e flussi in tempo reale?
Utilizzando l’esempio precedente, consideri cosa arriva quando un incontro con il paziente genera dati. Ricevi un messaggio HL7 dall’ospedale, un record di reclamo dall’assicuratore, un risultato di laboratorio da un laboratorio di riferimento che utilizza un identificatore diverso e una relazione di salute pubblica presentata in una scala temporale completamente diversa. Nessuno di questi è stato progettato per essere riconciliato l’uno con l’altro.
Il nostro livello di preparazione, TREUE™, è ciò che si trova tra quegli input e qualsiasi applicazione di analisi o intelligenza artificiale a valle. Il suo compito è valutare ogni record non appena arriva, abbinare le identità tra le fonti, normalizzare i formati e segnalare cosa manca o è inconsistente prima che i dati si spostino ulteriormente.
Nella pratica, ciò significa che un clinico che guarda un paziente sta lavorando da un record che è stato convalidato e allineato tra le fonti, piuttosto che riconciliare manualmente quattro diverse viste di sistema durante un incontro di cura. Per le squadre di salute pubblica, significa che i segnali di focolaio non sono ritardati dai dati che arrivano in formati diversi da diverse giurisdizioni.
È un lavoro di infrastruttura. Non è glamour, ma nulla a valle funziona senza di esso.
Gli standard di interoperabilità come Fast Healthcare Interoperability Resources (FHIR) e United States Core Data for Interoperability (USCDI) esistono da anni, eppure la frammentazione persiste. Cosa manca ancora da un punto di vista degli standard e come Aquila affronta quelle lacune in modo diverso?
FHIR e USCDI hanno dato all’industria un linguaggio condiviso per scambiare dati. Quello è stato un progresso importante. Ma un linguaggio condiviso per inviare dati non è la stessa cosa dei dati che si comportano in modo coerente una volta arrivati.
Ecco la lacuna: i dati sanitari non provengono da un unico dominio. I sistemi clinici, i registri di salute pubblica, i laboratori e le fonti di dati sociali hanno tutti i propri requisiti di governance, tempi e definizioni di cosa significhi un campo. FHIR non ti dice come riconciliare un set di dati di determinanti sociali con un record clinico di una giurisdizione diversa.
Ciò che TREUE™ aggiunge è un framework unificato per come i dati da tutti quei domini possano essere organizzati e convalidati insieme, rispettando ancora le regole di governance che si applicano a ogni fonte. Il risultato è dati che puoi effettivamente analizzare tra i domini, non solo dati che sono stati trasmessi con successo.
Aquila opera in ambienti ad alta posta in gioco dove il fallimento non è un’opzione. Come progetta sistemi di intelligenza artificiale che bilanciano le prestazioni in tempo reale con requisiti rigorosi in materia di governance, tracciabilità e fiducia?
Devi costruire la governance nell’architettura prima di scrivere la prima riga di codice dell’applicazione. Non deve essere uno strato che aggiungi in seguito.
In ambienti di sanità e governo, le decisioni che vengono informate da questi dati influenzano la cura del paziente, la risposta agli outbreak e come vengono allocate le risorse pubbliche. Ogni azione intrapresa sui dati deve essere tracciabile e l’accesso deve essere strettamente controllato. Il sistema deve soddisfare i requisiti di conformità degli ambienti in cui opera.
Per Aquila, ciò significa operare all’interno di un’infrastruttura cloud di livello governativo, controlli di accesso zero-trust e pratiche di sicurezza allineate con gli standard HIPAA e federali. Abbiamo contratti attivi in corso con il governo statale, agenzie federali e organizzazioni sanitarie, e quegli ambienti hanno requisiti di conformità molto diversi che la piattaforma deve soddisfare contemporaneamente.
Il componente umano nel ciclo è altrettanto importante. L’intelligenza artificiale può segnalare segnali, ma gli esperti clinici convalidano le anomalie prima che informino le decisioni operative. La tecnologia rende più veloce la ricerca di quei segnali. Non sostituisce il giudizio delle persone che devono agire su di essi.
La sua piattaforma supporta la distribuzione dell’intelligenza artificiale sicura sul dispositivo e la sovranità dei dati. Quanto è importante la decentralizzazione nel settore dell’intelligenza artificiale sanitaria, specialmente alla luce delle crescenti preoccupazioni sulla privacy dei dati e sulla conformità normativa?
Sta diventando essenziale, e credo che l’industria stia solo iniziando a rendersi conto del perché.
Le organizzazioni sanitarie operano sotto obblighi di privacy rigorosi. I dati dei pazienti sensibili non possono semplicemente essere centralizzati ed elaborati in un ambiente condiviso. Diversi stati hanno regole diverse. Le agenzie federali hanno regole diverse. I dati sanitari internazionali hanno un altro set di vincoli. Qualsiasi architettura che richieda di spostare dati sensibili in una posizione centrale si scontrerà con quei muri ripetutamente.
La direzione che funziona effettivamente è generare informazioni più vicino a dove i dati già risiedono. Le organizzazioni possono contribuire all’analisi condivisa senza cedere il controllo sui dati sottostanti. È ciò che i modelli federati consentono.
La nostra piattaforma è costruita per operare in un ambiente regolamentato e decentralizzato – la governance che viaggia con i dati piuttosto che essere applicata in un singolo punto. È un’architettura più difficile da costruire, ma è quella che è effettivamente compatibile con il funzionamento della governance dei dati sanitari nella pratica.
Molte startup di intelligenza artificiale si affidano fortemente a modelli black-box, mentre Aquila incorpora la convalida umana nel ciclo. Dove vede la linea tra automazione e supervisione umana nei sistemi di intelligenza artificiale clinica?
Ho iniziato la mia carriera come infermiera. Quell’esperienza plasma il modo in cui penso al ruolo dell’intelligenza artificiale in un ambiente clinico e dove non appartiene.
L’intelligenza artificiale è molto brava a trovare modelli in grandi set di dati. Non è brava a sapere cosa significhi un modello per un paziente specifico con una storia specifica in un contesto comunitario specifico. Quella è ancora una decisione umana.
Il ruolo giusto per l’intelligenza artificiale nei sistemi clinici è quello di segnalare segnali che un essere umano potrebbe perdere a volume, non sostituire il ragionamento clinico che segue. In Aquila, le anomalie e le informazioni segnalate dal sistema vanno ai clinici e agli esperti di dominio per la revisione prima di guidare le decisioni operative. La tecnologia ti dice dove guardare e il professionista ti dice cosa significa.
Dove credo che la linea appartenga: automatizzare la rilevazione, mantenere l’interpretazione con le persone che sono responsabili del risultato.
Aquila sta lavorando nel settore della salute pubblica, dei sistemi di governo e degli ambienti regolamentati. Come cambiano i requisiti per l’infrastruttura di intelligenza artificiale tra questi ambienti rispetto ai tradizionali ambienti di intelligenza artificiale aziendale?
In un tipico ambiente di intelligenza artificiale aziendale, stai di solito lavorando all’interno di un ambiente di dati di un’organizzazione, un set di regole di governance, un quadro di conformità.
Gli ambienti di salute pubblica e di governo sono strutturalmente diversi. Stai coordinando tra più giurisdizioni, più agenzie, più ambienti clinici, ognuno operante su timeline di reporting diverse e sotto diversi quadri giuridici. Un ospedale in uno stato, un’agenzia di salute pubblica in un altro, un programma federale con i propri requisiti di dati. Tutti questi devono scambiare dati e generare informazioni senza che un’entità abbia accesso non controllato ai record dell’altra.
L’infrastruttura deve supportare l’elaborazione ad alto volume mantenendo allo stesso tempo una tracciabilità rigorosa attraverso tutti quei confini. Deve integrarsi con formati di messaggistica sanitaria legacy, perché quei sistemi non scompariranno. E deve operare in modo affidabile in ambienti in cui il downtime non è solo un problema aziendale, ma un problema di sicurezza del paziente.
Quella complessità è il motivo per cui abbiamo iniziato Aquila con quegli ambienti piuttosto che con il mercato aziendale tradizionale. Se puoi costruire un’infrastruttura che funziona qui, funziona ovunque.
L’intelligenza artificiale continua ad avanzare più velocemente dei quadri di governance. Quali sono le responsabilità dei fondatori e dei costruttori di piattaforme per assicurarsi che questi sistemi vengano distribuiti in modo etico e sicuro fin dal primo giorno?
Credo che la responsabilità siastraightforward, anche se soddisfarla non lo è. Se stai costruendo un’intelligenza artificiale che influenza le decisioni cliniche o i risultati della salute pubblica, non puoi trattare la governance come un elemento del piano di prodotto che affronterai eventualmente. Deve essere progettata fin dall’inizio.
Ciò significa praticamente che ogni azione sui dati deve essere tracciabile. I modelli devono essere interpretabili abbastanza da permettere a un clinico di capire perché un segnale è stato segnalato. Gli esperti clinici devono far parte del processo di revisione, non un ripensamento. E l’organizzazione deve essere onesta su ciò che il sistema può e non può fare in modo affidabile.
Ho trascorso la mia carriera in ambienti in cui i fallimenti dei dati hanno conseguenze reali per persone reali. Ciò plasma il modo in cui penso a questo. Le capacità stanno avanzando rapidamente e la responsabilità per la loro distribuzione non può essere consentita di rimanere indietro. I fondatori che costruiscono questi sistemi devono mantenere quel livello per se stessi, non aspettare che la regolamentazione lo imponga.
Grazie per la discussione approfondita. I lettori interessati a esplorare la piattaforma e il suo approccio all’infrastruttura dei dati sanitari possono saperne di più visitando Aquila Health.




