
Interviste
Dott.ssa Mathilde Pavis, Capo del Dipartimento Legale, OpenOrigins – Serie di Interviste

 Aggiungi Unite.AI alle tue fonti preferite su Google
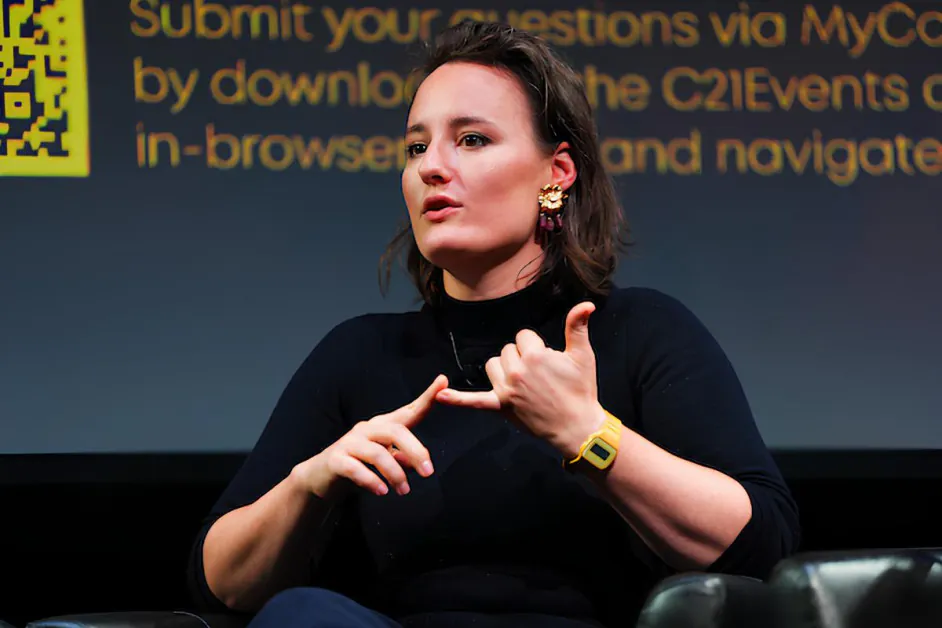
Dott.ssa Mathilde Pavis, Capo del Dipartimento Legale di OpenOrigins, è un’esperta leader nella regolamentazione dell’AI e nella governance dei media digitali, specializzata in deepfake, media sintetici e provenienza del contenuto. Fornisce consulenza a società, governi e sindacati su conformità, licenze e rischi nell’AI generativa, e ha lavorato con Microsoft (MSFT ) e ElevenLabs sulla politica e la strategia dell’AI. Ha anche consigliato l’UNESCO sull’AI e la proprietà intellettuale, e fornisce regolarmente prove di esperta ai responsabili delle politiche del Regno Unito.
OpenOrigins sviluppa tecnologie per combattere la disinformazione e i deepfake creando registri verificabili e inalterabili del contenuto digitale. La sua piattaforma si concentra sull’istituzione di una chiara provenienza, consentendo ai media, ai creatori e alle piattaforme di dimostrare quando e come il contenuto è stato creato, modificato e distribuito – una capacità sempre più critica poiché i media sintetici diventano più avanzati e più difficili da rilevare.
Ha consigliato governi, istituzioni globali come l’UNESCO e società come Microsoft e ElevenLabs sulla regolamentazione dell’AI. Cosa l’ha portata a concentrarsi specificamente sui deepfake, sulle repliche digitali e sui media sintetici, e come quel viaggio ha plasmato la sua decisione di fondare Replique?
Il mio lavoro sui deepfake non è iniziato con la tecnologia – è iniziato con un vecchio rompicapo legale. Quando ho iniziato a studiare la proprietà intellettuale per il mio dottorato di ricerca nel 2013, sono stata colpita da quanto meno protezione ricevono gli interpreti rispetto agli autori, ai compositori o ai registi. Nella pratica significa che le tue parole o la tua musica finiscono per essere meglio protette dalla legge rispetto alla tua voce, al tuo viso e al tuo corpo. Quella disparità mi è sembrata strana, e mi ha spinto a porre una domanda più profonda: come valutiamo culturalmente e legalmente il lavoro di qualcuno la cui contribuzione è il suo viso, la sua voce e il suo corpo sullo schermo?
Quella domanda mi ha portata a occuparmi dei diritti degli interpreti e dei dati. All’epoca, era considerata un’area di nicchia con poca rilevanza commerciale. Mi è stato attivamente consigliato di spostarmi in campi più “lucrativi” come i brevetti o il diritto d’autore tradizionale. L’ipotesi era che le questioni relative alla somiglianza o alla voce di una persona fossero in gran parte gestite in modo informale – attraverso norme di settore o “accordi tra gentiluomini a Hollywood”. Ma per me, quella mancanza di protezione formale ha segnalato una lacuna, non un vicolo cieco per la mia ricerca, quindi sono proseguita.
Cosa è cambiato è che oggi quasi tutti sono interpreti. Le nostre vite sono mediate attraverso le telecamere – sui telefoni, sui laptop, nelle videochiamate e sui social. Sia per lavoro che per uso personale, le persone registrano e condividono costantemente versioni di se stesse. Le questioni legali che un tempo si applicavano principalmente agli attori o ai musicisti ora si applicano a chiunque abbia uno smartphone.
I deepfake non hanno creato questi problemi – li hanno esposti e accelerati. La ricerca che stavo conducendo dal 2013 in poi è improvvisamente diventata urgente. Intorno al 2017 e al 2018, gli sviluppi nelle reti neurali – in particolare provenienti da luoghi come il MIT e la UC Berkeley – hanno iniziato a dimostrare quanto convincentemente il viso, la voce e il corpo di una persona potessero essere manipolati digitalmente. Entro un anno, quella capacità è diventata ampiamente nota come “deepfake”, e ha inizialmente guadagnato slancio in modi profondamente dannosi, in particolare attraverso contenuti sessuali non consensuali che prendevano di mira donne e bambini.
Solo in seguito sono emerse le implicazioni commerciali, poiché le industrie creative hanno iniziato ad adottare i media sintetici. È allora che le questioni contrattuali e economiche su cui stavo lavorando sono emerse in primo piano. Quasi da un giorno all’altro, ciò che era stato considerato un’area di legge in gran parte teorica o dottrinale è diventato un campo altamente pratico, commercialmente significativo e socialmente urgente.
Al suo nucleo, la sfida legale non è cambiata: le persone vogliono condividere aspetti di se stesse, ma vogliono anche mantenere un controllo significativo. I quadri esistenti lottano con quella sottigliezza. Tendono a trattare gli individui come se fossero interamente privati o completamente pubblici – o protetti o liberi. Ma la maggior parte delle persone esiste da qualche parte in mezzo. Quella tensione è ora centrale non solo per gli interpreti professionisti, ma per chiunque partecipi alla vita digitale.
Sono diventata nota come qualcuno che ha studiato e lavorato in questo settore, il che mi ha portato a lavorare con governi interessati a proteggere le persone dai deepfake, e con società che vogliono rendere i prodotti di clonazione digitale sicuri da usare, come ElevenLabs. A Replique, porto tutto ciò che ho imparato alle persone e alle società che vogliono utilizzare la clonazione digitale o la tecnologia di replica digitale in modo responsabile e sicuro. Ho fondamentalmente trasformato la mia “ricerca a cielo aperto” in un’attività di consulenza che fornisce consulenza legale specialistica alle industrie creative.
Come Capo del Dipartimento Legale di OpenOrigins, una società che si concentra sull’istituzione di un registro immutabile della provenienza del contenuto per combattere i deepfake, come vede la competizione o il rimpiazzo dei sistemi basati sulla provenienza rispetto ai tradizionali approcci di rilevamento dei deepfake?
Confrontare gli strumenti di rilevamento dei deepfake può rapidamente diventare un esercizio di mele e arance, perché la loro efficacia dipende dal contesto e dallo scopo. Da una prospettiva di politica, ciò di cui abbiamo bisogno è una gamma di strumenti complementari – non esiste una singola “soluzione migliore”, e Open Origins è solo una parte di quell’ecosistema più ampio. Dove la tecnologia di OpenOrigins si distingue come soluzione di rilevamento dei deepfake è in situazioni in cui un creatore di contenuto o un’organizzazione di informazione deve dimostrare l’autenticità del contenuto che condivide con i partner, il pubblico o il pubblico.
Fornendo una provenienza verificabile e “ricevute” al momento della creazione, offre una forma forte di prevenzione dimostrando che il contenuto non è un deepfake. Tuttavia, questo approccio è meno utile per gli utenti di Internet che desiderano valutare rapidamente il contenuto che incontrano online. In quei casi, il rilevamento si basa più su metodi di analisi del contenuto e probabilistici piuttosto che sulla verifica basata sulla provenienza. Abbiamo bisogno di strumenti diversi per esigenze diverse, e dobbiamo accettare che non esiste una soluzione universale contro i deepfake.
Da un punto di vista legale, qual è attualmente la lacuna più grande nel modo in cui le giurisdizioni gestiscono il consenso e la proprietà nel contenuto generato o replicato dall’AI?
Oof, quanto tempo hai? Le risposte dipendono da cosa intendiamo per contenuto generato o replicato dall’AI. Le questioni variano se stiamo guardando un’immagine di una casa o di un gatto generata dall’AI. O la riproduzione digitale del viso di una persona o della sua voce. Limitiamoci all’argomento dei deepfake e della replica digitale, e rispondiamo alla tua domanda nel contesto della “clonazione digitale”.
Per quanto riguarda il consenso, la questione principale è che la maggior parte dei contratti – sia gli accordi di lavoro che i termini della piattaforma – contengono clausole ampie e vaghe che concedono ampi diritti sul contenuto degli utenti. Queste possono essere interpretate come una sorta di “consenso indiretto” in cui l’accettazione dei termini può essere considerata come il consenso all’uso di clonazione, anche se la maggior parte delle persone contesterebbe fortemente quell’interpretazione. Ciò crea un divario significativo tra l’interpretazione legale e le aspettative degli utenti, uno che attualmente beneficia le società mentre la regolamentazione è in ritardo.
Per quanto riguarda la proprietà, non esiste una risposta legale chiara su chi possiede una replica digitale, poiché i quadri esistenti come la protezione dei dati, il diritto d’autore e i diritti della personalità non sono stati progettati per questa tecnologia. Oggi, la maggior parte delle persone viene scansionata e clonata al lavoro, su richiesta e con il finanziamento di un datore di lavoro o di un cliente. E quelle entità si aspettano generalmente un alto grado di controllo su quell’asset, il che è comprensibile ma spesso problematico perché quell’asset è una riproduzione digitale del tuo viso o della tua voce, e può farti dire cose che non hai mai detto, o fare cose che non hai mai fatto.
La questione di “chi possiede il tuo clone?” è molto importante, ma non ha ancora una risposta nella legge di oggi.
Ha lavorato a stretto contatto con le tecnologie di clonazione vocale. Quali sono i rischi legali più fraintesi quando si tratta di voci sintetiche, sia per le società che per gli individui?
La questione più fraintesa nella conformità legale è l’equilibrio tra l’interesse commerciale di una società nel finanziare e sfruttare una replica digitale, e il diritto dell’individuo alla privacy e alla dignità digitale. Quella tensione si estende attraverso più regimi legali (in gran parte proprietà intellettuale, protezione dei dati e privacy) che non sono stati progettati per operare insieme e interpretano la clonazione in modi fondamentalmente diversi. Di conseguenza, tradurre questo in pratiche aziendali funzionali è complesso e spesso poco chiaro. Le società quindi o trascurano i rischi chiave o incorrono in costi significativi per navigare correttamente. Ciò crea un esito perverso in cui la conformità responsabile diventa il percorso più difficile e più costoso, piuttosto che il percorso predefinito.
Come dovrebbero pensare le imprese all’architettura del consenso nei sistemi di intelligenza artificiale, in particolare quando si tratta di somiglianza, identità e dati di formazione?
Le società dovrebbero progettare i loro sistemi intorno a tre capacità fondamentali. In primo luogo, devono ottenere il consenso informato e contestuale al momento dell’iscrizione. In secondo luogo, devono rendere facile per gli utenti revocare quel consenso e cancellare alcuni o tutti i loro dati, cosa che è tecnicamente impegnativa e spesso trascurata, ma essenziale per la conformità con leggi come il GDPR del Regno Unito e dell’UE e regimi simili negli Stati Uniti. Mantenere il consenso nel tempo significa costruire sistemi in cui la revoca sia operativamente fluida e allineata con il modello di business.
Il consenso deve essere granulare. E in terzo luogo, gli utenti dovrebbero essere in grado di gestire le autorizzazioni a livello di singoli file, aggiornare i loro dati di somiglianza e capire come vengono utilizzati. Ciò richiede trasparenza e controllo – strumenti che consentono agli utenti di monitorare, esaminare e moderare come vengono utilizzati i loro cloni digitali. Quel livello di flessibilità è ancora raro, ma è dove si trova il vantaggio competitivo crescente.
Nella sua esperienza di consulente per startup e governi, dove si trova la maggiore disconnessione tra come l’AI viene costruita e come viene regolamentata?
La disconnessione tra come l’AI viene costruita e come viene regolamentata si riduce a missioni fondamentalmente diverse. I governi regolamentano nell’interesse pubblico, mentre le società di AI (spesso finanziata da venture) sono principalmente guidate dalla crescita, dai ricavi e dal profitto. Quegli obiettivi non confliggono sempre, ma spesso tirano in direzioni diverse, con la regolamentazione vista come un vincolo piuttosto che un supporto.
Ciò crea una tensione strutturale: i regolatori e gli innovatori operano con incentivi, valori e persino lingue diverse. Ciò rende l’allineamento difficile nella pratica, anche se non è impossibile. Stiamo iniziando a vedere una nuova ondata di società tecnologiche allineate più strettamente con gli obiettivi di interesse pubblico, ma rimangono l’eccezione piuttosto che la regola – specialmente tra coloro che hanno successo nella scalabilità.
OpenOrigins si concentra sulla verifica del contenuto al momento della creazione utilizzando la provenienza crittografica. Quanto è critico questo approccio di origine rispetto alle salvaguardie post-distribuzione?
Questo si collega alla mia risposta precedente. L’autenticazione del contenuto alla creazione, “a monte” è molto più efficace che cercare di verificarlo al momento della distribuzione o anche del consumo, cioè “a valle”. L’autenticazione del contenuto alla creazione è come tracciare il cibo dal momento in cui viene coltivato nella fattoria, piuttosto che cercare di capire tutto solo guardando il piatto finito. Se sai dove è stato allevato il pollo, come è stato gestito e come è passato attraverso la catena di approvvigionamento, puoi fidarti di ciò che stai mangiando. Se invece cerchi di dedurre tutto solo guardando il piatto finito, ti affidi alle congetture. È lo stesso con il distinguere tra contenuto creato dall’uomo e contenuto generato dall’AI online: la provenienza alla fonte ti dà una garanzia verificabile, mentre il rilevamento a valle è intrinsecamente più incerto e reattivo.
Qual è il ruolo che vede per gli standard come C2PA nel futuro dei media, e sono sufficienti da soli per ripristinare la fiducia online?
C2PA è un’iniziativa benvenuta, e in molti modi supporta lo stesso movimento per l’autenticità del contenuto come OpenOrigins. Sono una parte importante dell’ecosistema di sicurezza del contenuto e autenticità del contenuto. Come per ogni strumento di sicurezza, non esiste una soluzione universale.
Per i creatori e i talenti in settori come il cinema, la musica e i videogiochi, quali passi pratici dovrebbero intraprendere oggi per proteggersi dalla replica digitale non autorizzata?
Gli artisti oggi affrontano due rischi distinti: la replica del loro lavoro (come musica, immagini o scrittura) e la replica della loro somiglianza, compreso il loro viso, la loro voce e il loro corpo. Con un input minimo, i sistemi di intelligenza artificiale possono ora riprodurre entrambi con un alto grado di fedeltà. In termini pratici, la protezione inizia con l’essere intenzionali su ciò che si condivide online, riconoscendo che qualsiasi contenuto pubblicato può essere raschiato e utilizzato in set di dati di formazione, spesso senza un consenso chiaro o visibilità.
Quel rischio è ora una realtà di base dell’operare online. Ma il rischio più immediato e controllabile spesso si trova nei contratti. Gli accordi che gli artisti stipulano con i loro collaboratori, distributori o piattaforme possono includere clausole che consentono l’uso, il riutilizzo o la rivendita del contenuto per scopi di formazione – spesso senza una partecipazione significativa ai ricavi downstream.
Per gli artisti, ciò rende la scrutinio del contratto critico. Capire come il proprio lavoro e la propria somiglianza possano essere utilizzati, licenziati o riproposti è ora altrettanto importante del processo creativo stesso. Gran parte del dibattito attuale (tra sindacati, organismi di settore e piattaforme) si concentra sul correggere quell’equilibrio e assicurare che i creatori mantengano sia il controllo che la compensazione equa.
Quindi due consigli chiave: siate cauti su ciò che condividete online e leggete i vostri contratti e cercate le clausole sull’AI prima di firmare.
Guardando avanti tre o cinque anni, crede che raggiungeremo un punto in cui ogni pezzo di contenuto digitale dovrà avere una provenienza verificabile, o la fiducia rimarrà frammentata attraverso piattaforme e giurisdizioni?
Mi piacerebbe dire sì, ma realisticamente, no – non entro cinque anni. Nella tecnologia, cinque anni sembrano lunghi; in termini di cambiamento del comportamento e delle abitudini degli utenti, è molto breve. La maggior parte dei consumatori è improbabile che basi le proprie decisioni sulla presenza di una provenienza autenticata. Le piattaforme tendono a seguire la domanda degli utenti, ottimizzando per l’engagement piuttosto che per la provenienza.
Ciò potrebbe cambiare se la regolamentazione interviene. Stiamo già vedendo i primi movimenti in luoghi come la California, dove stanno emergendo requisiti di etichettatura e moderazione, ma scalare questo a livello globale richiederà tempo – probabilmente più vicino a un decennio che a cinque anni.
Un’altra area di cambiamento è settore-specifica: settori come il giornalismo, la finanza, l’assicurazione e la sanità potrebbero iniziare a richiedere la provenienza e l’autenticazione perché la fiducia è fondamentale per le loro operazioni.
Last but not least, i consumatori potrebbero non curarsi della provenienza del contenuto nel breve termine, ma si preoccuperanno della qualità del contenuto e della qualità delle informazioni. Se il contenuto generato dall’AI diventa troppo omogeneo o “insipido”, il pubblico potrebbe iniziare a valorizzare di più il contenuto creato dall’uomo. Ciò potrebbe tcould drive a segmentation of the market, with some platforms prioritising scale and AI-generated content, and others curating for authenticity, provenance and high-trust, human-led material – but that shift remains an unknown. Thank you for your great answers, readers who wish to learn more should visit OpenOrigins.


