
Angolo di Anderson
Disney combina CGI e rendering neurale per affrontare la ‘valle dell’inquietudine’

 Aggiungi Unite.AI alle tue fonti preferite su Google
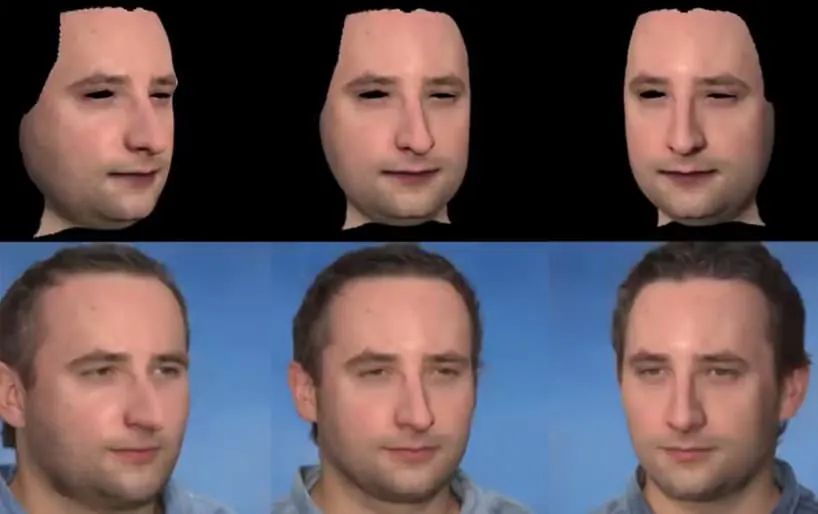
La divisione di ricerca AI di Disney ha sviluppato un metodo ibrido per la simulazione facciale di qualità cinematografica, combinando i punti di forza del rendering neurale facciale con la coerenza di un approccio basato su CGI.
Il documento in attesa di pubblicazione è intitolato Rendering with Style: Combining Traditional and Neural Approaches for High Quality Face Rendering, ed è presentato in un nuovo video di 10 minuti sul canale YouTube Disney Research (incorporato alla fine di questo articolo*).
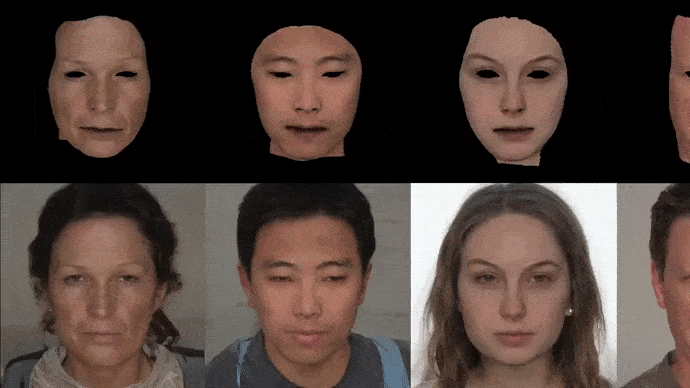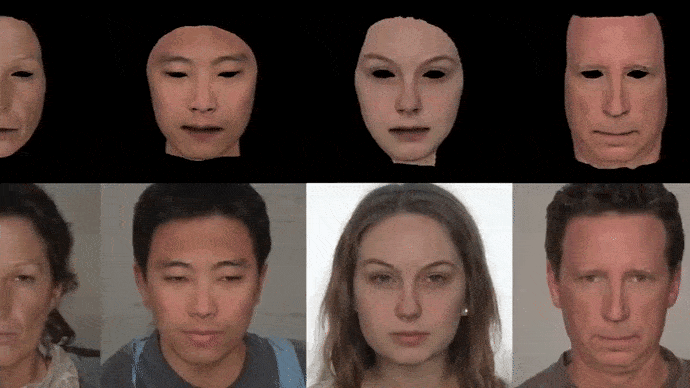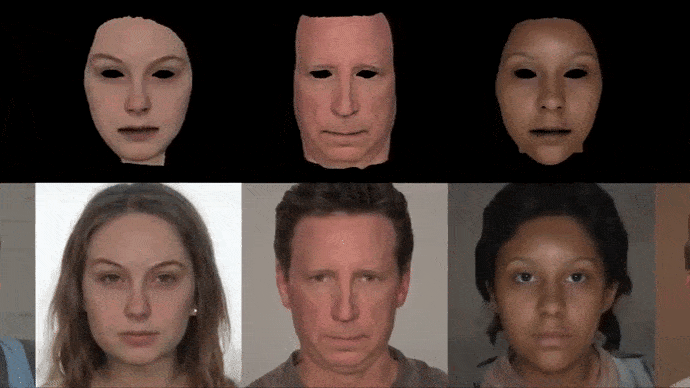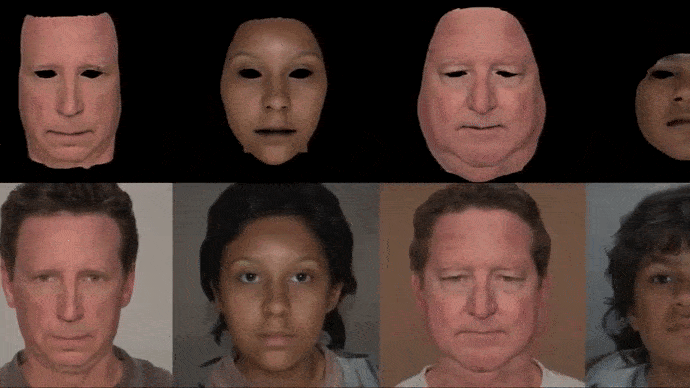
Meshes combined with neural facial renders. See video embed at end of article for better detail and quality. Source: https://www.youtube.com/watch?v=TwpLqTmvqVk
Come osserva il video, il rendering neurale dei volti (inclusi i deepfake) può produrre occhi e interni della bocca molto più realistici rispetto a quanto il CGI è in grado di fare, mentre le texture facciali generate dal CGI sono più coerenti e adatte a produzioni VFX di livello cinematografico.
Perciò Disney sta sperimentando l’uso del generatore neurale StyleGan2 di NVIDIA per gestire le caratteristiche circostanti di un volto e gli elementi ‘cruciali per la vita’ come gli occhi, sovrapponendo al risultato una pelle facciale CGI coerente e gli elementi correlati.

From the video (see end of article), the architectural concept behind Disney’s hybrid approach, where an old-school CGI mesh, of the type used to recreate ‘young’ Carrie Fisher and the late Peter Cushing for Rogue One (2016), is integrated into neurally-rendered face environments.
Il video fa un riferimento tacito alle frequenti critiche sull’inautenticità e l’effetto ‘valle dell’inquietudine’ della ricreazione CGI del defunto attore britannico di Star Wars Peter Cushing in Rogue One (2016), ammettendo:
‘[C’è] ancora un’enorme differenza tra ciò che le persone possono catturare e renderizzare facilmente e i doppi digitali fotorealistici finali, completi di capelli, occhi e interno della bocca. Per colmare questo divario, di solito è necessario molto lavoro manuale da parte di artisti esperti.’
In realtà, anche i sistemi di cattura facciale più moderni non tentano nemmeno di ricreare occhi, interni della bocca o capelli, che presentano rispettivamente problemi di autenticità in tali tecniche (occhi) o di coerenza temporale (capelli).

The video illustrates what VFX artists will get after a typical modern facial capture session. Eyes, hair, facial hair, and mouth interiors will all have to be handled by separate teams in the production pipeline, in addition to texturing and lighting.
Controllo dell’illuminazione
L’approccio ibrido è anche vantaggioso per il riluminamento – una sfida notevole per il rendering neurale dei volti, poiché le sovrapposizioni di pelle CGI possono essere riluminate più facilmente.
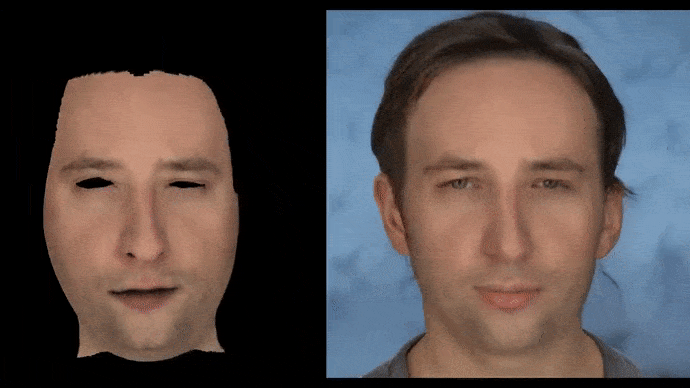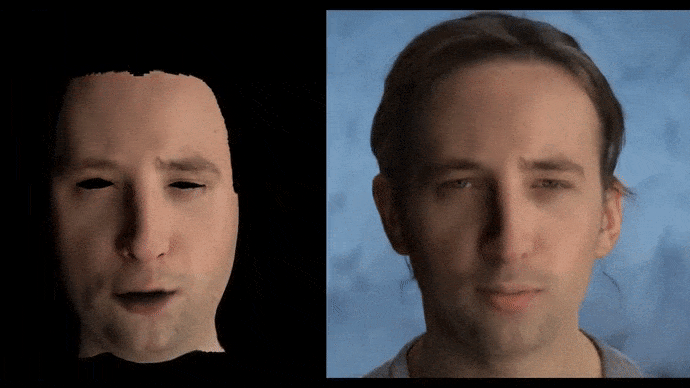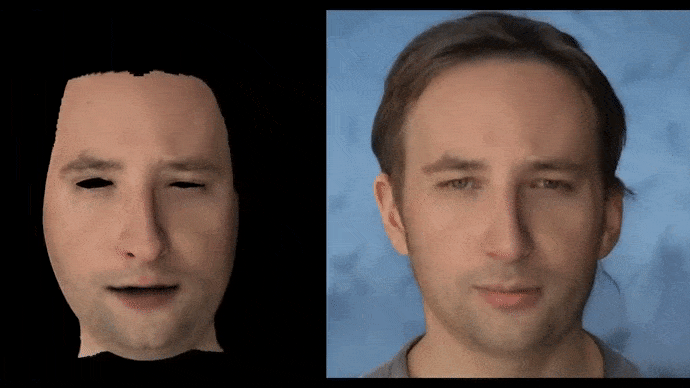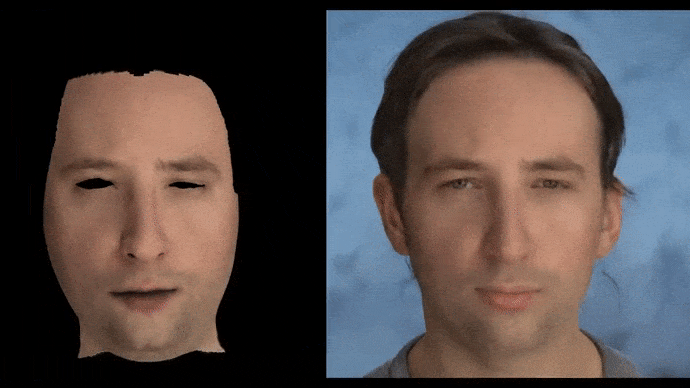
An animated version of the CGI/Neural approach.
In ambienti più impegnativi, come le riprese esterne, i ricercatori hanno sviluppato un metodo di inpainting attorno a una sorta di zona demilitarizzata che circonda la persona ‘creata’.

A black margin is generated to allow a ‘canvas’ for inpainting the outer parts of the identity and integrating the CGI skin into the combined CGI/neural output.
Il video osserva:
‘[Il] rendering neurale non corrisponde perfettamente al vincolo di sfondo. – è inteso solo come guida, poiché l’ottimizzazione per componenti umane realistiche come capelli, occhi e denti è l’obiettivo principale. È più difficile cercare di mantenere un’identità coerente, modificando al contempo l’illuminazione dell’ambiente.’
Creazione di mesh CGI da rendering neurali
Il team di ricerca ha inoltre sviluppato un autoencoder variazionale addestrato su un (non specificato) ampio database di immagini 3D di volti, e afferma che può generare mesh facciali 3D ‘casuali ma plausibili’ a partire da dati di verità di base.
Ci sono limitazioni che questa ricerca deve superare, inclusa la difficoltà nel mantenere i capelli temporalmente coerenti nei rendering neurali, e il video (vedi sotto) mostra diversi esempi di capelli che mutano rapidamente in un’inquadratura altrimenti coerente attorno a un volto CGI/neurale.
La coerenza temporale nel rendering video neurale è un problema molto più ampio rispetto a quello di Disney, e sembra probabile che le successive iterazioni di questo sistema ricorrano all’aggiunta di capelli ‘in post-produzione’, o a varie altre possibili soluzioni per la generazione dei capelli, piuttosto che sperare che un nuovo approccio neurale lo risolva definitivamente.
Usi per la generazione di dataset
Il metodo è proposto anche come potenziale modalità di generazione di dati sintetici, arricchendo il panorama dei set di immagini facciali, che negli ultimi anni è diventato pericolosamente monotono.

Disney envisages the new technique populating facial image datasets.
‘[Ogni] risultato fotorealistico che generiamo ha una geometria corrispondente sottostante e mappe di aspetto, renderizzate da punti di vista della fotocamera sconosciuti con illuminazione nota. Queste informazioni di ‘verità di base’ possono essere fondamentali per addestrare applicazioni successive, come la ricostruzione monocale 3D del volto, il riconoscimento facciale o la comprensione della scena. Pertanto ogni render prodotto può essere considerato un campione di dati, e possiamo generare molte variazioni di numerosi individui.’
‘Inoltre, anche per una singola persona renderizzata con una singola espressione, da un unico punto di vista e con una singola illuminazione, possiamo generare variazioni casuali del render fotorealistico variando il seme di randomizzazione durante l’ottimizzazione.’
I ricercatori osservano che questa diversità di output configurabile potrebbe essere utile per addestrare applicazioni di riconoscimento facciale, concludendo:
‘[Il nostro] metodo è in grado di sfruttare la tecnologia attuale per la cattura, la modellazione e il rendering della pelle facciale, creando automaticamente render facciali fotorealistici completi che corrispondono all’identità, all’espressione e alla configurazione della scena desiderate. Questo approccio ha applicazioni nel rendering facciale per film e intrattenimento, risparmiando lavoro manuale agli artisti e anche per la generazione di dati in diversi ambiti del deep learning.’
Per un’analisi più approfondita del nuovo approccio, guarda il video di 10 minuti pubblicato oggi:
* Il link del video originale è stato sostituito con un altro apparentemente identico 8 ore dopo la pubblicazione di questo articolo. Ho modificato tutti i link pertinenti, poiché non c’è traccia del video originale.
8:24 GMT+2 – Video sostituito, poiché è stato rimosso dal canale YouTube Disney Research per qualche motivo.


