
Interviste
Ben Koska, Fondatore e Amministratore Delegato di SF Tensor – Serie di Interviste

 Aggiungi Unite.AI alle tue fonti preferite su Google
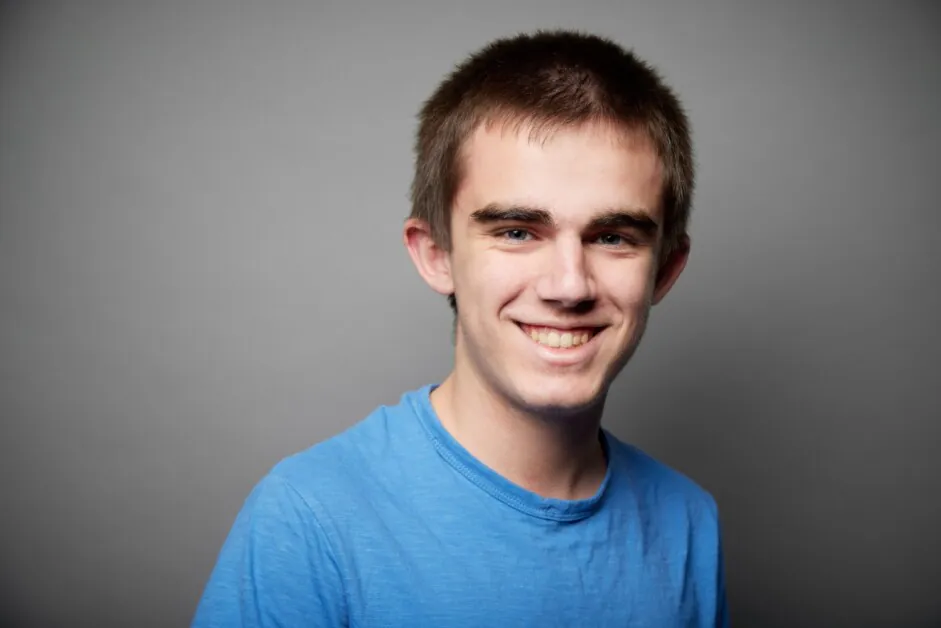
Ben Koska, Fondatore e Amministratore Delegato di SF Tensor, è un ricercatore di intelligenza artificiale e ingegnere di sistemi noto per il suo lavoro su calcolo ad alte prestazioni, ottimizzazione del kernel e formazione di modelli efficienti. Il suo background spazia dallo sviluppo di infrastrutture di intelligenza artificiale di basso livello, al miglioramento della produttività di formazione e alla progettazione di strumenti che rendono lo sviluppo di modelli avanzati accessibile senza un sovraccarico di ingegneria pesante. Si concentra sulla costruzione di sistemi che spingono i limiti di velocità, portabilità e affidabilità su hardware eterogeneo.
SF Tensor è l’azienda che guida per trasformare quella filosofia in una piattaforma pratica. Introduce un modello di programmazione unificato, un ottimizzatore del kernel e uno strato di orchestrazione cross-cloud progettato per rimuovere la complessità dei carichi di lavoro di intelligenza artificiale distribuiti. La piattaforma mira a fornire agli ingegneri un ambiente pulito, agnostico per l’hardware, in cui possono scrivere una volta, distribuire ovunque e raggiungere automaticamente prestazioni elevate. La missione di SF Tensor è quella di rendere il calcolo di intelligenza artificiale drasticamente più veloce, più facile da gestire e libero da vincoli di fornitore.
Hai fondato SF Tensor a soli 19 anni, dopo aver già guidato l’ingegneria in diverse startup. Cosa ti ha ispirato ad affrontare la sfida di reinventare l’infrastruttura di intelligenza artificiale così presto nella tua carriera?
Il problema che stiamo risolvendo è uno che mi sta molto a cuore, perché è uno che ho incontrato io stesso. Quando abbiamo sviluppato ciò che è ora il nucleo di SF Tensor, non stavamo lavorando su un progetto commerciale, era in realtà un’iniziativa accademica. Avevamo ricevuto una sovvenzione per condurre alcune ricerche molto interessanti, ma abbiamo trascorso la maggior parte del nostro tempo a gestire l’infrastruttura e le ottimizzazioni, invece di fare ricerca. Abbiamo scoperto che le persone erano universalmente più interessate alla nostra tecnologia di infrastruttura, non al nostro progetto di ricerca.
SF Tensor sta affrontando uno dei problemi più difficili dell’intelligenza artificiale — rompere il dominio di NVIDIA CUDA. Come hai approcciato la progettazione di un sistema che potesse raggiungere una vera portabilità hardware senza compromettere le prestazioni
alla fine, tutta l’intelligenza artificiale si riduce a semplice matematica. Ogni modello è essenzialmente un insieme di operazioni matematiche che dobbiamo calcolare per ottenere i risultati. Trattandolo principalmente come un problema matematico piuttosto che un problema di scienza informatica, possiamo identificare l’insieme più piccolo di vincoli sui calcoli, quindi generare milioni o miliardi di modi diversi per trasformare quei calcoli in codice macchina, trovando il più veloce. È più facile a dirsi che a farsi, poiché non possiamo effettivamente eseguire miliardi di programmi diversi per trovare il più veloce, quindi per ridurre il nostro spazio di ricerca, abbiamo dovuto creare un modello matematico accurato per stimare la velocità di un dato programma per un dato hardware, che è una delle innovazioni chiave che rendono possibile ciò che facciamo oggi.
Il blog dell’azienda evidenzia innovazioni intorno all’ottimizzazione del compilatore e all’orchestrazione cross-cloud. Puoi spiegare come l’approccio di SF Tensor differisce da framework esistenti come PyTorch o JAX?
Non abbiamo ancora scritto un blog tecnico al riguardo, ma in realtà supportiamo framework come PyTorch e JAX, consentendo ai codici scritti in essi di essere ottimizzati dal nostro stack. Ci sono diverse decisioni architettoniche che JAX e PyTorch hanno preso che li differenziano dal nostro stack, ma la più significativa è che trattiamo l’intero modello come un singolo calcolo da risolvere, invece di moduli individuali che devono essere ottimizzati individualmente e poi congiuntamente. A questo proposito, invece di applicare tecniche di ottimizzazione del compilatore tradizionali e cercare di applicare ogni singola ottimizzazione, creiamo uno spazio di ricerca di milioni o talvolta miliardi di potenziali kernel e affermiamo che nessun essere umano può possibilmente creare un set di regole per trasformare qualsiasi codice nel più veloce, quindi dobbiamo semplicemente creare ogni combinazione e poi identificare il più veloce.
Molte startup si concentrano sull’efficienza di formazione, ma tu hai sottolineato la “tassa di infrastruttura” — il tempo che i ricercatori perdono nella gestione del calcolo invece di innovare. Come SF Tensor affronta questo squilibrio?
Crediamo che entrambi i problemi debbano essere affrontati e gran parte del nostro lavoro è rivolto a risolvere l’efficienza di formazione, ma il problema più acuto che possiamo risolvere attualmente senza essere condizionati da future innovazioni è la tassa di infrastruttura, poiché è un problema che abbiamo già risolto per noi stessi.
Hai menzionato di aver raggiunto riduzioni del costo di formazione fino all’80%. Quali ottimizzazioni o innovazioni architettoniche rendono possibile ciò?
Il nostro intero stack software si basa sull’idea che un compilatore basato sulla ricerca batterà sempre le regole create dall’uomo. Finora, il più grande vincolo su questi compilatori è stato il fatto che non è possibile testare e classificare miliardi o anche solo milioni di kernel. È stato quindi necessario creare un modello matematico del calcolo che possa stimare con precisione il tempo che un dato calcolo, o un insieme di calcoli, richiederà su un dato hardware. Facendo ciò, possiamo espandere il nostro spazio di ricerca e poi ridurlo, il che è una necessità se si vuole trovare i kernel più veloci in modo coerente.
Come la tua esperienza nella costruzione del linguaggio di programmazione Emma influenza l’architettura e la filosofia di SF Tensor verso le prestazioni e l’astrazione?
Non dirlo ai miei investitori, ma nel profondo sono ancora un ingegnere di compilatori. Sono sempre stato interessato a trovare modi diversi per rendere le cose anche solo marginalmente più veloci. Sviluppando Emma, abbiamo gettato via l’intero compilatore 4 o 5 volte; abbiamo iniziato da capo, ogni volta perché abbiamo incontrato un’ottimizzazione che non potevamo implementare dato il vincolo attuale, costringendoci a riorganizzare il sistema per renderlo ancora più generale, pur consentendoci di scendere al livello più basso di ottimizzazione quando necessario, spesso andando contro i principi comuni di progettazione del compilatore e del linguaggio. Queste conoscenze e l’architettura risultante, combinate con quasi due anni di ciò che sembrava a molti come ottimizzazioni minori e scommesse sbagliate, si sono trasformate in un sistema che ci consente ora di iterare più velocemente e ottimizzare meglio di qualsiasi sistema che abbia seguito i principi comuni, poiché quei principi sono fondamentalmente progettati per CPU, non GPU e modelli di intelligenza artificiale.
Hai lavorato su esecuzioni di formazione su larga scala con oltre 4.000 GPU — quali sono state alcune delle più grandi lezioni apprese nella gestione del calcolo a quella scala?
Una grande lezione è che il guasto hardware è molto più comune e problematico di quanto si possa supporre. Avendo trascorso molto tempo a lavorare con programmi tradizionali e compilatori, generalmente parlando, un computer fa esattamente ciò che gli viene detto, e se qualcosa va storto, è quasi sempre colpa della persona che ha scritto il codice. Con le GPU, d’altra parte, il guasto hardware è un’evenienza comune, specialmente in esecuzioni di formazione distribuite su cluster estremamente grandi. Andando di pari passo con ciò è il fatto che, a differenza delle CPU che generalmente agiscono in modo deterministico e prevedibile, le GPU a volte riducono misteriosamente la velocità dell’orologio per nessun motivo apparente, rallentando l’intero processo di formazione perché un singolo chip sta funzionando più lentamente.
Y Combinator ha sostenuto alcune delle aziende di infrastrutture più trasformative nel settore tecnologico. Come quell’esperienza ha plasmato il tuo approccio alla scalabilità del prodotto e della visione di SF Tensor?
Andando in Y Combinator, pensavo che la scommessa che volevamo fare allora fosse ambiziosa. Dopo solo alcune settimane, la nostra definizione di ambizioso era drasticamente cambiata, e abbiamo raddoppiato la scommessa su una scommessa ancora più grande. Inoltre, il senso di comunità e apprendimento che posso prendere il telefono o inviare un’e-mail a quasi qualsiasi azienda o persona là fuori e ricevere una risposta e un consiglio nel giro di ore o giorni, ha cambiato il modo in cui pensiamo ad affrontare i problemi e ad abbracciare un approccio significativamente più collaborativo.
Guardando avanti, hai espresso interesse per modelli non LLM, robotica e dati sintetici. Come queste aree si inseriscono nella tua visione a lungo termine per l’azienda?
I modelli LLM sono assolutamente una tecnologia interessante e avranno un ruolo integrante nel modo in cui il mondo apparirà nel futuro, ma il motivo per cui sono così più avanzati rispetto ad altre aree di intelligenza artificiale deriva principalmente dal fatto che c’è molto denaro investito nel loro sviluppo, e ci sono abbastanza persone che collaborano sul problema che hanno ottimizzato abbastanza. Se possiamo abbassare la barriera di ingresso, consentendo ai ricercatori di tutto il paese e del pianeta, anche a quelli con risorse limitate e poca conoscenza di ottimizzazioni, di eseguire la loro ricerca nel modo più economico e efficiente possibile, credo che vedremo una nuova generazione di modelli che affronteranno problemi per cui i modelli LLM non sono adatti, sia perché interagiscono con il mondo fisico o perché sono problemi che non possono essere adeguatamente espressi in linguaggio.
Cosa pensi che l’infrastruttura di intelligenza artificiale sarà tra cinque anni — e dove vedi il ruolo di SF Tensor all’interno di essa?
Tra cinque anni, spero che molte più aziende avranno sviluppato e rilasciato i propri chip specializzati e che i ricercatori saranno in grado di sfruttarli e utilizzare senza dover scrivere codice specifico per loro, idealmente senza nemmeno dover sapere che esistono. È il futuro verso cui stiamo lavorando e che credo avremo un ruolo significativo nel plasmare.
Grazie per la grande intervista, i lettori che desiderano saperne di più possono visitare SF Tensor.


