Angolo di Anderson
Matting di Immagini AI che Comprende le Scene

 Aggiungi Unite.AI alle tue fonti preferite su Google
Nel documentario extra che accompagna l’uscita DVD del 2003 di Alien3 (1992), la leggenda degli effetti visivi Richard Edlund ricordò con orrore il “sumo wrestling” dell’estrazione fotochimica di matte che dominava il lavoro sugli effetti visivi tra la fine degli anni 1930 e la fine degli anni 1980. Edlund descrisse la natura incostante del processo come “sumo wrestling”, in confronto alle tecniche digitali di schermo blu/verde che presero il sopravvento all’inizio degli anni 1990 (e da allora è tornato alla metafora).
Estrarre un elemento in primo piano (come una persona o un modello di astronave) da uno sfondo, in modo che l’immagine ritagliata possa essere composita su una piastra di sfondo, veniva originariamente realizzato filmando l’oggetto in primo piano su uno sfondo uniformemente blu o verde.
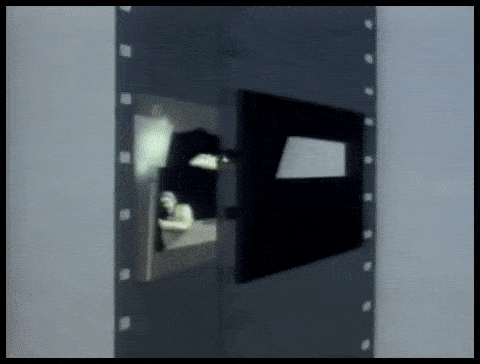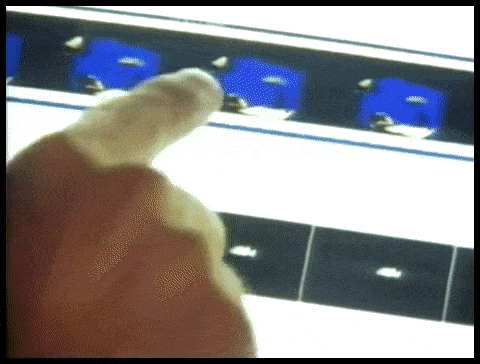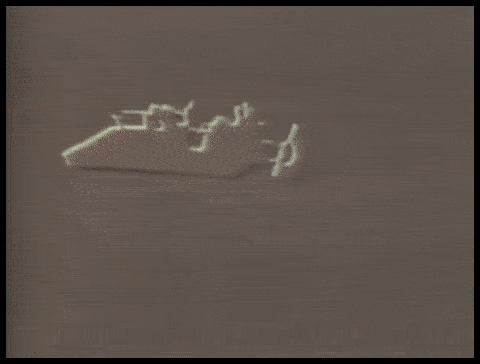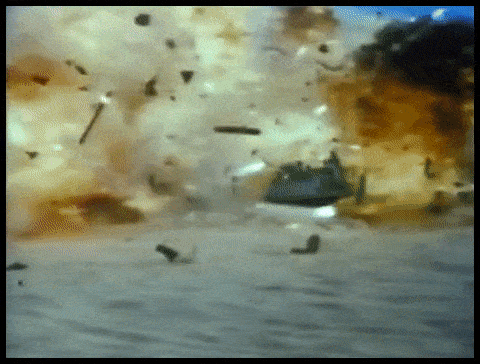
Processi fotochimici laboriosi di estrazione per una ripresa VFX di ILM per “Return of the Jedi” (1983).
Nel filmato risultante, il colore di sfondo veniva successivamente isolato chimicamente e usato come modello per ristampare l’oggetto (o la persona) in una stampante ottica come un oggetto “fluttuante” in una cella di pellicola altrimenti trasparente.
Il processo era conosciuto come color separation overlay (CSO) – sebbene questo termine fosse poi più associato agli effetti video grezzi di ‘Chromakey’ nelle produzioni televisive a basso budget degli anni 1970 e 1980, ottenuti con mezzi analogici piuttosto che chimici o digitali.

Una dimostrazione di Color Separation Overlay nel 1970 per il programma per bambini britannico “Blue Peter”. Fonte: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
In ogni caso, sia per elementi cinematografici che video, il filmato estratto poteva essere inserito in qualsiasi altro filmato.
Sebbene il processo di vapore di sodio di Disney, notevolmente più costoso e proprietario processo a vapore di sodio (che si basava sul giallo, in particolare, e fu anche usato per il film horror del 1963 di Alfred Hitchcock The Birds) offrisse una definizione migliore e matte più nitide, l’estrazione fotochimica rimaneva laboriosa e inaffidabile.

Il processo proprietario di estrazione a vapore di sodio di Disney richiedeva sfondi vicino all’estremità gialla dello spettro. Qui, Angela Lansbury è sospesa su fili durante la produzione di una sequenza ricca di VFX per “Bedknobs and Broomsticks” (1971). Fonte
Oltre il Matting Digitale
Negli anni ’90, la rivoluzione digitale ha eliminato le sostanze chimiche, ma non la necessità di schermi verdi. Divenne possibile rimuovere lo sfondo verde (o di qualsiasi colore) semplicemente cercando i pixel entro un intervallo di tolleranza di quel colore, in software di editing pixel come Photoshop, e in una nuova generazione di suite di compositing video che potevano automaticamente rimuovere gli sfondi colorati. Quasi da un giorno all’altro, sessanta anni dell’industria della stampa ottica furono relegati alla storia.
Gli ultimi dieci anni di ricerca sulla visione artificiale accelerata da GPU stanno introducendo l’estrazione di matte in una terza era, affidando ai ricercatori lo sviluppo di sistemi capaci di estrarre matte di alta qualità senza la necessità di schermi verdi. Solo su Arxiv, i lavori relativi alle innovazioni nell’estrazione di primo piano basata sul machine learning sono una presenza settimanale.
Metterci nella Scena
Questo punto focale di interesse accademico e industriale nell’estrazione AI ha già influenzato il mercato consumer: implementazioni grezze ma funzionanti ci sono tutte familiari sotto forma di filtri Zoom e Skype che possono sostituire gli sfondi dei nostri salotti con isole tropicalhe, ecc., nelle videochiamate.
Tuttavia, i migliori matte richiedono ancora uno schermo verde, come ha osservato Zoom mercoledì scorso.

Sinistra, un uomo davanti a uno schermo verde, con i capelli ben estratti grazie alla funzione Sfondo Virtuale di Zoom. Destra, una donna davanti a una scena domestica normale, con i capelli estratti algoritmicamente, meno accuratamente, e con requisiti di calcolo più elevati. Fonte: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Un ulteriore post dalla piattaforma di supporto Zoom avverte che l’estrazione senza schermo verde richiede anche una maggiore potenza di calcolo nel dispositivo di acquisizione.
La Necessità di Ritagliare
Miglioramenti in qualità, portabilità ed economia delle risorse per i sistemi di estrazione matte “in the wild” (cioè isolare le persone senza la necessità di schermi verdi) sono rilevanti per molti più settori e attività rispetto ai soli filtri per videoconferenze.
Per lo sviluppo di dataset, il miglioramento del riconoscimento facciale, della testa intera e del corpo intero offre la possibilità di garantire che elementi di sfondo estranei non vengano incorporati nei modelli di visione artificiale di soggetti umani; un’isolamento più accurato migliorerebbe notevolmente le tecniche di segmentazione semantica progettate per distinguere e assimilare domini (cioè ‘cat’, ‘person’, ‘boat’), e migliorerebbe i sistemi di sintesi d’immagine basati su VAE e transformer come il nuovo DALL-E 2 di OpenAI; e algoritmi di estrazione migliori ridurrebbero la necessità di costosi rotoscoping nei costosi pipeline VFX.
In effetti, l’ascesa delle metodologie multimodali (di solito testo/immagine), dove un dominio come “cat” è codificato sia come immagine sia con riferimenti testuali associati, sta già facendo breccia nell’elaborazione delle immagini. Un esempio recente è l’architettura Text2Live, che utilizza l’addestramento multimodale (testo/immagine) per creare video di, tra le innumerevoli altre possibilità, cigni di cristallo e giraffe di vetro.
Matting AI Consapevole della Scena
Una buona parte della ricerca sul matting automatico basato su AI si è concentrata sul riconoscimento dei contorni e sulla valutazione di raggruppamenti di pixel all’interno di un’immagine o di un fotogramma video. Tuttavia, una nuova ricerca proveniente dalla Cina propone una pipeline di estrazione che migliora la delineazione e la qualità del matte sfruttando descrizioni basate su testo di una scena (un approccio multimodale che ha guadagnato trazione nel settore della ricerca sulla visione artificiale negli ultimi 3‑4 anni), affermando di aver migliorato i metodi precedenti in diversi modi.

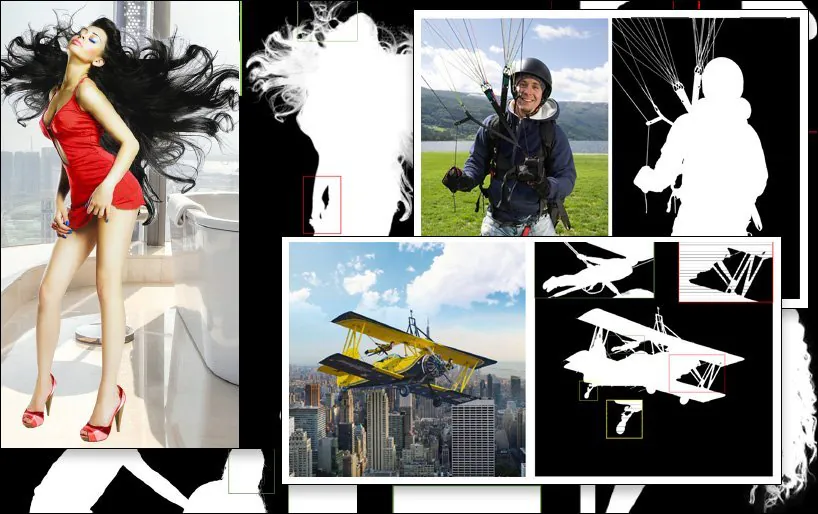
Un esempio di estrazione SPG-IM (ultima immagine, in basso a destra), confrontato con i metodi precedenti concorrenti. Fonte: https://arxiv.org/pdf/2204.09276.pdf
La sfida posta per il sotto-settore della ricerca sull’estrazione è produrre flussi di lavoro che richiedano un minimo indispensabile di annotazione manuale e intervento umano – idealmente nessuno. Oltre alle implicazioni di costo, i ricercatori del nuovo articolo osservano che le annotazioni e le segmentazioni manuali eseguite da crowdworker esternalizzati in diverse culture possono far sì che le immagini vengano etichettate o addirittura segmentate in modi differenti, portando a algoritmi incoerenti e insoddisfacenti.
Un esempio di ciò è l’interpretazione soggettiva di ciò che definisce un “oggetto in primo piano”:

Dal nuovo articolo: i metodi precedenti LFM e MODNet (‘GT’ indica Ground Truth, un risultato “ideale” spesso ottenuto manualmente o con metodi non algoritmici), hanno interpretazioni diverse e variamente efficaci della definizione del contenuto in primo piano, mentre il nuovo metodo SPG-IM delinea più efficacemente il “contenuto vicino” attraverso il contesto della scena.
Per affrontare ciò, i ricercatori hanno sviluppato una pipeline a due stadi intitolata Situational Perception Guided Image Matting (SPG-IM). L’architettura encoder/decoder a due stadi comprende Situational Perception Distillation (SPD) e Situational Perception Guided Matting (SPGM).

L’architettura SPG-IM.
In primo luogo, SPD pre‑addestra le trasformazioni delle caratteristiche da visuale a testuale, generando didascalie appropriate alle immagini associate. Dopo ciò, la previsione della maschera di primo piano è abilitata collegando la pipeline a una nuova tecnica di predizione della salienza.
Quindi SPGM produce una matte alfa stimata basata sull’immagine RGB grezza in ingresso e sulla maschera generata ottenuta nel primo modulo.
L’obiettivo è la guida tramite percezione situazionale, in cui il sistema ha una comprensione contestuale di cosa contiene l’immagine, consentendogli di inquadrare – ad esempio – la sfida di estrarre capelli complessi da uno sfondo, basandosi su caratteristiche note di tale compito specifico.

Nell’esempio sotto, SPG-IM comprende che le corde sono intrinseche a un “paracadute”, dove MODNet non riesce a mantenere e definire questi dettagli. Allo stesso modo, sopra, la struttura completa dell’attrezzatura del parco giochi viene persa arbitrariamente in MODNet.
Il nuovo articolo è intitolato Situational Perception Guided Image Matting e proviene da ricercatori dell’OPPO Research Institute, PicUp.ai e Xmotors.
Mattes Automatizzati Intelligenti
SPG-IM propone anche una Adaptive Focal Transformation (AFT) Refinement Network che può elaborare i dettagli locali e il contesto globale separatamente, facilitando “mattes intelligenti”.

Comprendere il contesto della scena, in questo caso “ragazza con cavallo”, può potenzialmente rendere l’estrazione del primo piano più facile rispetto ai metodi precedenti.
The paper states:
‘We believe that visual representations from the visual-to-textual task, e.g. image captioning, focus on more semantically comprehensive signals between a)object to object and b)object to the ambient environment to generate descriptions that can cover both the global info and local details. In addition, compared with the expensive pixel annotation of image matting, textual labels can be massively collected at a very low cost.’
Crediamo che le rappresentazioni visive derivanti dal compito visual-to-textual, ad esempio la didascalia delle immagini, si concentrino su segnali semanticamente più completi tra a) oggetto e oggetto e b) oggetto e l’ambiente circostante, per generare descrizioni che possano coprire sia le informazioni globali sia i dettagli locali. Inoltre, rispetto alla costosa annotazione pixel per il matting delle immagini, le etichette testuali possono essere raccolte massivamente a un costo molto basso.
Il ramo SPD dell’architettura è pre‑addestrato congiuntamente al decoder testuale basato su transformer VirTex dell’Università del Michigan, che apprende rappresentazioni visive da didascalie semanticamente dense.

VirTex addestra congiuntamente una ConvNet e Transformers tramite coppie immagine‑didascalia, e trasferisce le intuizioni ottenute a compiti di visione a valle come il riconoscimento di oggetti. Fonte: https://arxiv.org/pdf/2006.06666.pdf
Tra altri test e studi di ablazione, i ricercatori hanno confrontato SPG‑IM con metodi all’avanguardia basati su trimap come Deep Image Matting (DIM), IndexNet, Context‑Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA e Semantic Image Mapping (SIM).
Altri framework precedenti testati includevano approcci senza trimap LFM, HAttMatting e MODNet. Per un confronto equo, i metodi di test sono stati adattati in base alle diverse metodologie; dove il codice non era disponibile, le tecniche dell’articolo sono state riprodotte dall’architettura descritta.
The new paper states:
‘Our SPG-IM outperforms all competing trimap-free methods ([LFM], [HAttMatting], and [MODNet]) by a large margin. Meanwhile, our model also shows remarkable superiority over the state-of-the-art (SOTA) trimap-based and mask-guided methods in terms of all four metrics across the public datasets (i.e. Composition-1K, Distinction-646, and Human-2K), and our Multi-Object-1K benchmark.’
Il nostro SPG‑IM supera di gran lunga tutti i metodi trimap‑free concorrenti ([LFM], [HAttMatting] e [MODNet]). Nel frattempo, il nostro modello mostra anche una notevole superiorità rispetto ai metodi basati su trimap e guidati da maschera allo stato dell’arte (SOTA) in tutti e quattro i metriche sui dataset pubblici (cioè Composition‑1K, Distinction‑646 e Human‑2K), e sul nostro benchmark Multi‑Object‑1K.
And continues:
‘It can be obviously observed that our method preserves fine details (e.g. hair tip sites, transparent textures, and boundaries) without the guidance of trimap. Moreover, compared to other competing trimap-free models, our SPG-IM can retain better global semantic completeness.’
È evidente che il nostro metodo preserva i dettagli fini (ad esempio le punte dei capelli, le texture trasparenti e i contorni) senza la guida di una trimap. Inoltre, rispetto ad altri modelli trimap‑free concorrenti, il nostro SPG‑IM può mantenere una migliore completezza semantica globale.


Pubblicato per la prima volta il 24 aprile 2022.