
Angolo di Anderson
Modifica coerente di contenuti video con IA mediante input testuali

 Aggiungi Unite.AI alle tue fonti preferite su Google
Punti chiaveText2Live 能够根据文本提示实现一致的视频编辑,无需逐帧处理。
Vedi di più
- Text2Live 能够根据文本提示实现一致的视频编辑,无需逐帧处理。
- 该系统利用神经分层图集,在整个视频时间线上一次性应用编辑。
- Text2Live 自动完成遮罩和合成,省去了旋转描摹或绿幕的需求。
Mentre la comunità professionale di effetti visivi è intrigata – e occasionalmente si sente un po’ minacciata – dalle nuove innovazioni nella sintesi di immagini e video, la mancanza di continuità temporale nella maggior parte dei progetti di editing video basati su intelligenza artificiale li relega alla sfera “psichedelica”, con texture e strutture che scintillano e si alterano rapidamente, effetti incoerenti e il tipo di tecnologia grezza che ricorda l’ era fotochimica degli effetti visivi.
Se si desidera cambiare qualcosa di molto specifico in un video che non rientra nel campo dei deepfake (ad esempio, imporre una nuova identità su filmati esistenti di una persona), la maggior parte delle soluzioni attuali operano con limitazioni abbastanza severe, in termini di precisione richiesta per effetti visivi di produzione di alta qualità.
Un’eccezione è il lavoro in corso di un’associazione di accademici dell’Istituto di Scienza Weizmann. Nel 2021, tre dei suoi ricercatori, in associazione con Adobe (ADBE ), hanno annunciato un nuovo metodo per decomporre video e sovrapporre una mappatura interna coerente – un atlante neurale stratificato – in un output composito, completo di canali alpha e output temporale coeso.
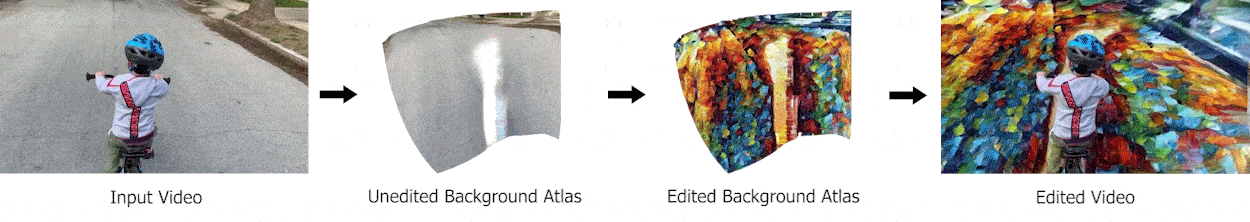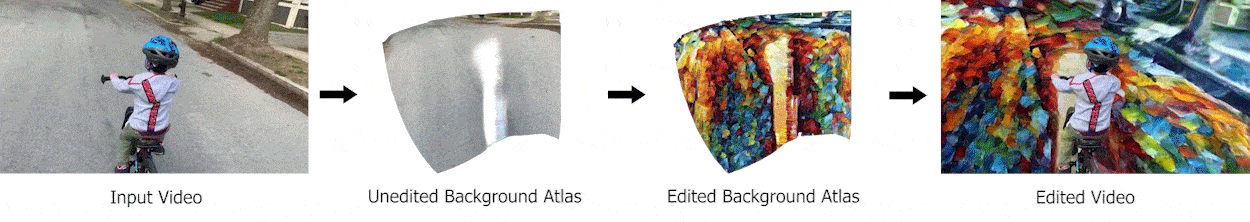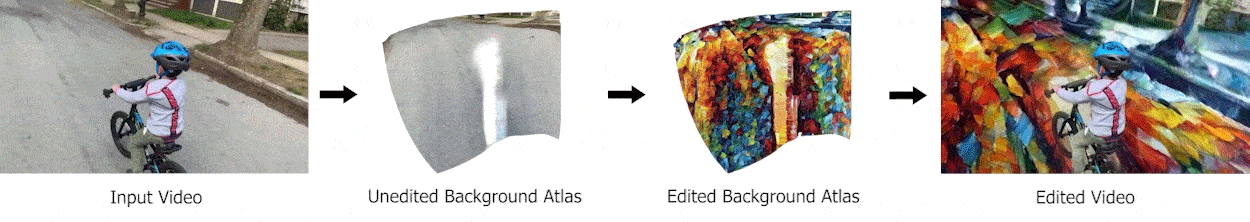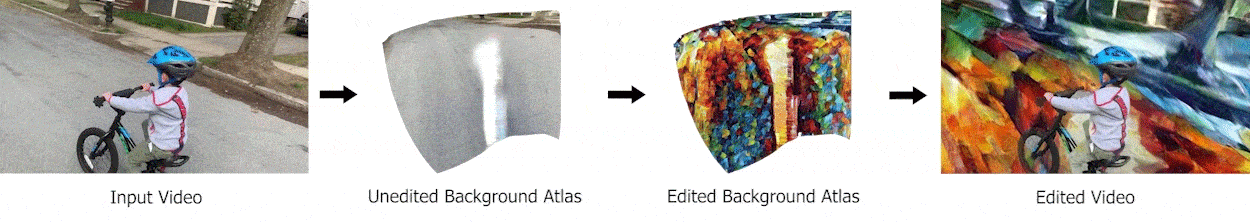
Dall’articolo del 2021: una stima della completa traversata della strada nel clip di origine è editata tramite una rete neurale in un modo che tradizionalmente avrebbe richiesto un’estensiva rotoscopia e match-moving. Poiché gli elementi di sfondo e primo piano sono gestiti da reti diverse, le maschere sono veramente ‘automatiche’. Fonte: https://layered-neural-atlases.github.io/
Sebbene cada in qualche modo nella sfera coperta dal flusso ottico nelle pipeline di effetti visivi, l’atlante stratificato non ha un equivalente diretto nei flussi di lavoro CGI tradizionali, poiché costituisce essenzialmente una ‘mappa di texture temporale’ che può essere prodotta ed editata attraverso metodi software tradizionali. Nella seconda immagine nell’illustrazione sopra, lo sfondo della superficie stradale è rappresentato (figurativamente) in tutta la durata del video. Alterare quell’immagine di base (terza immagine da sinistra nell’illustrazione sopra) produce un cambiamento coerente nello sfondo.
Le immagini dell’atlante ‘srotolato’ sopra rappresentano solo frame interpretati individualmente; i cambiamenti coerenti in qualsiasi frame di destinazione sono mappati indietro al frame originale, mantenendo eventuali occlusioni e altri effetti di scena necessari, come ombre o riflessi.
L’architettura principale utilizza un Multilayer Perceptron (MLP) per rappresentare gli atlanti srotolati, i canali alpha e le mappe, tutti ottimizzati in concerto e interamente in uno spazio 2D, eliminando la necessità di conoscenze preliminari di punti geometrici 3D come quelle richieste da NeRF, mappe di profondità e simili accessori CGI.
L’atlante di riferimento di oggetti individuali può anche essere modificato in modo affidabile:
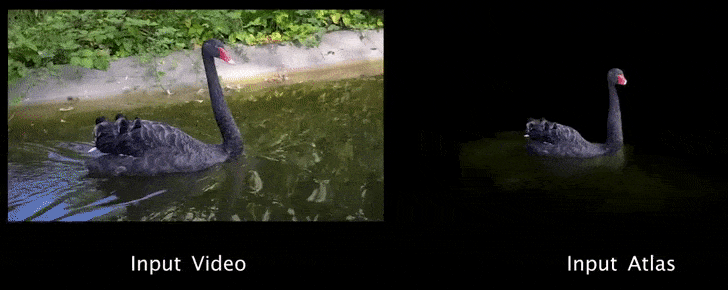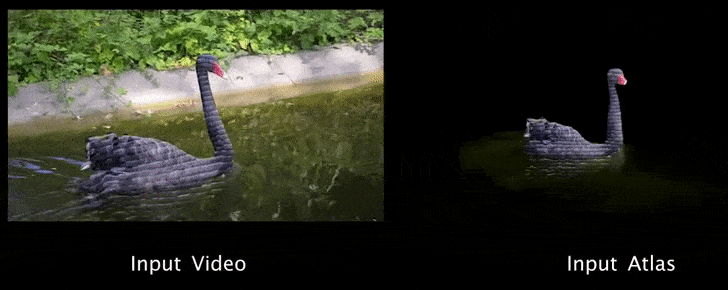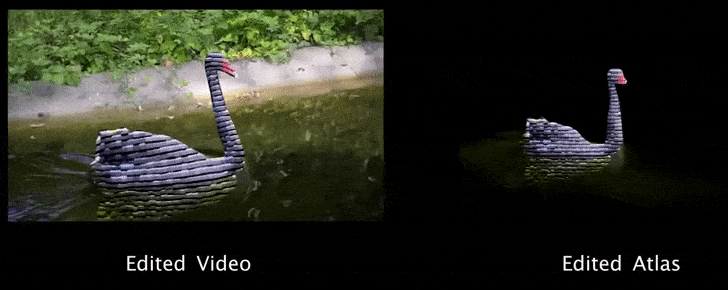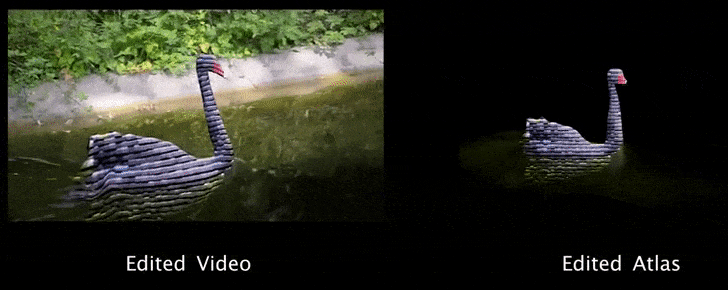
Cambiamento coerente di un oggetto in movimento secondo il framework del 2021. Fonte: https://www.youtube.com/watch?v=aQhakPFC4oQ
In sostanza, il sistema del 2021 combina allineamento della geometria, match-moving, mappatura, riapplicazione delle texture e rotoscopia in un processo neurale discreto.
Text2Live
I tre ricercatori originali dell’articolo del 2021, insieme a NVIDIA Research (NVDA ), sono tra i contributori di una nuova innovazione sulla tecnica che combina il potere degli atlanti stratificati con il tipo di tecnologia CLIP guidata da testo che è tornata alla ribalta questa settimana con il rilascio del framework DALL-E 2 di OpenAI.
La nuova architettura, intitolata Text2Live, consente all’utente finale di creare modifiche localizzate al contenuto video reale in base a prompt di testo:
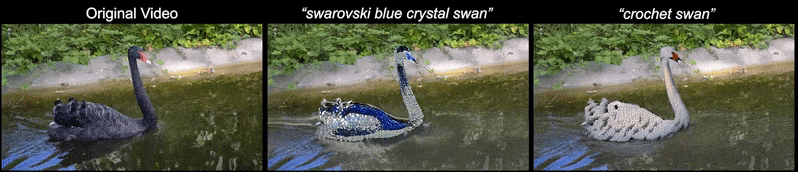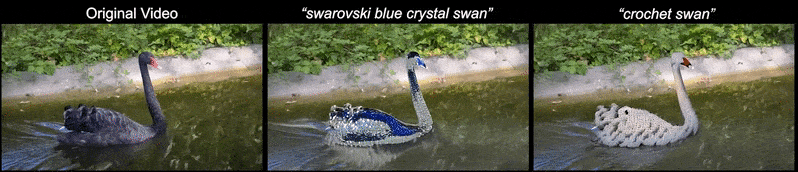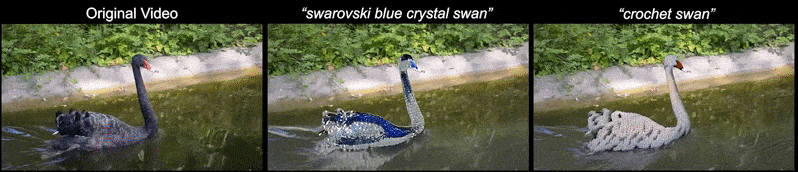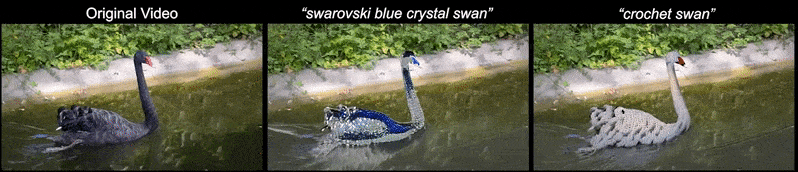
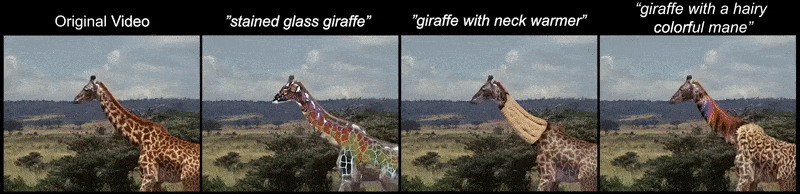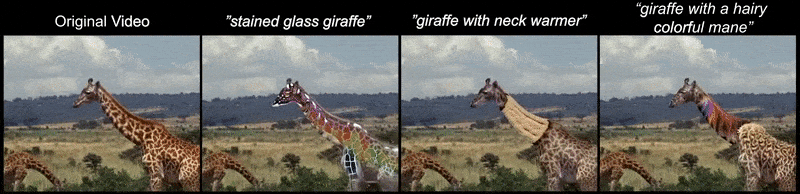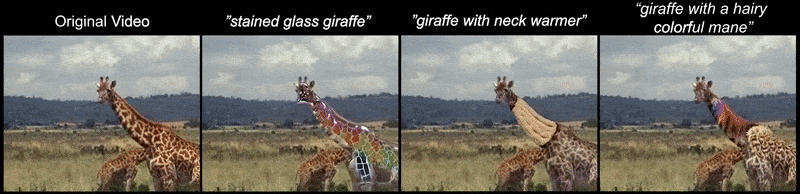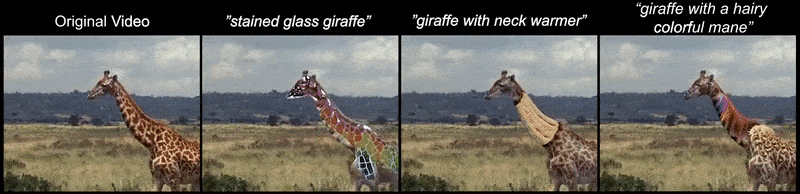
Due esempi di editing del primo piano. Per una risoluzione e una definizione migliori, consultare i video originali su https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live offre editing semantico e altamente localizzato senza l’uso di un generatore pre-addestrato, sfruttando un database interno specifico per il clip video interessato.

Trasformazioni di sfondo e primo piano (oggetto) con Text2Live. Fonte: https://text2live.github.io/sm/pages/video_results_atlases.html
La tecnica non richiede maschere fornite dall’utente, come un flusso di lavoro di rotoscopia o chroma key tipico, ma stima invece mappe di rilevanza attraverso una tecnica di avvio basata sulla ricerca del 2021 della School of Computer Science dell’Università di Tel Aviv e Facebook AI Research (FAIR).

Mappe di output generate tramite un modello di attenzione generico basato su transformer.
Il nuovo documento è intitolato Text2LIVE: Editing stratificato di immagini e video guidato dal testo. Il team originale del 2021 è affiancato da Omer Bar-Tal del Weizmann e Yoni Kasten della ricerca NVIDIA.
Architettura
Text2Live comprende un generatore addestrato su un’immagine di input unica e prompt di testo di destinazione. Un modello di preaddestramento contrastivo linguaggio–immagine (CLIP), preaddestrato su 400 milioni di coppie testo/immagine fornisce materiale visivo associato da cui le trasformazioni dell’utente possono essere interpretate.

Il generatore accetta un’immagine di input (frame) e produce un layer RGBA di destinazione che contiene informazioni di colore e opacità. Questo livello viene poi integrato nel filmato originale mediante compositing, con ulteriori modifiche.

Il canale alpha nel layer RGBA generato fornisce una funzione di composizione interna senza ricorrere a pipeline tradizionali che coinvolgono software basato su pixel come After Effects.
Addestrando su immagini interne rilevanti per il video o l’immagine di destinazione, Text2Live evita la necessità di invertire l’immagine di input nello spazio latente di una rete generativa avversaria (GAN), una pratica che attualmente è lontana dall’essere abbastanza precisa per le esigenze di editing video di produzione, o utilizzare un modello di diffusione più preciso e configurabile, ma non può mantenere la fedeltà al video di destinazione.

Varie modifiche di trasformazione basate su prompt da Text2Live.
Approcci precedenti hanno utilizzato metodi basati sulla propagazione o approcci basati sul flusso ottico. Poiché queste tecniche sono in qualche misura basate su frame, nessuna di esse è in grado di creare un aspetto temporale coerente dei cambiamenti nel video di output. Un atlante neurale stratificato, invece, fornisce uno spazio unico in cui affrontare i cambiamenti, che possono poi rimanere fedeli alla modifica stabilita mentre il video procede.
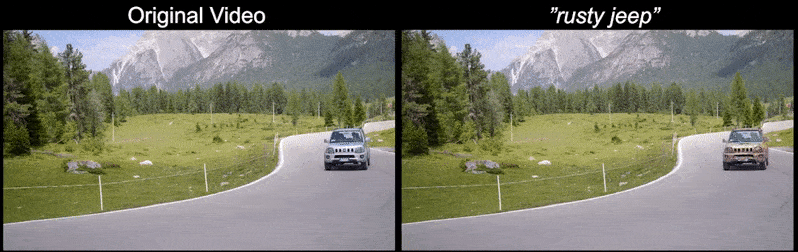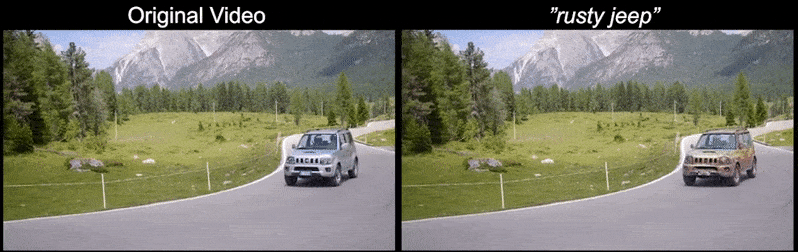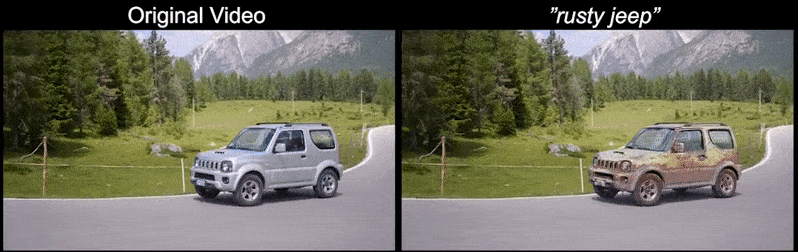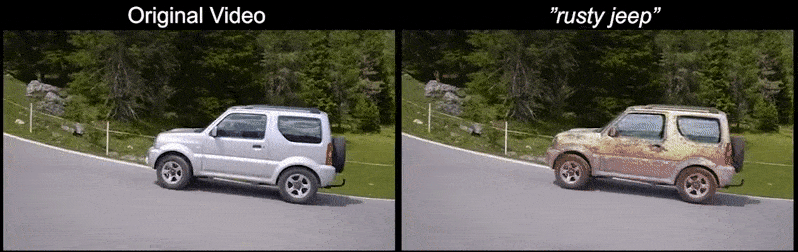
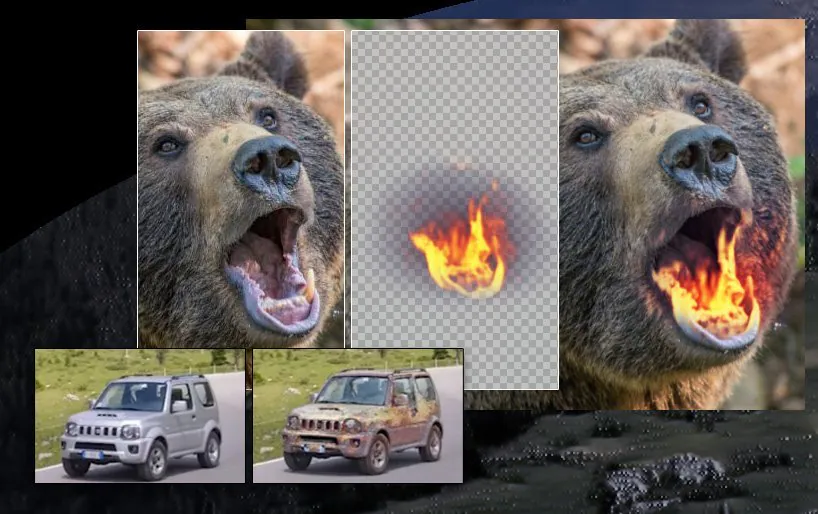
Nessuno sfarfallio né allucinazioni casuali: Text2Live ottiene un’interpretazione del prompt di testo ‘jeep arrugginito’ e lo applica una volta all’atlante neurale stratificato dell’auto nel video, invece di riavviare la trasformazione per ogni frame interpretato.

Flusso di lavoro della trasformazione coerente di una Jeep in un relitto arrugginito con Text2Live.
Text2Live è più vicino a una svolta nell’ambito del compositing basato su intelligenza artificiale, piuttosto che nello spazio fertile delle immagini generate da testo, che ha attirato molta attenzione questa settimana con il rilascio della seconda generazione del framework DALL-E di OpenAI (che può incorporare immagini di destinazione come parte del processo di trasformazione, ma rimane limitata nella sua capacità di intervenire direttamente in una foto, oltre alle censure dei dati di addestramento di origine e l’imposizione di filtri, progettati per prevenire l’abuso degli utenti).
Text2Live, invece, consente all’utente finale di estrarre un atlante e quindi modificarlo in un’unica passata in ambienti basati sui pixel che offrono un elevato controllo come Photoshop (e, si potrebbe sostenere, persino in framework di sintesi di immagini più astratti come NeRF), prima di reinserirlo in un ambiente correttamente orientato che non si basa sulla stima 3D o su approcci CGI che ritornano a metodi del passato.
Inoltre, Text2Live, secondo gli autori, è il primo framework comparabile a realizzare mascheratura e compositing in modo completamente automatico.
Pubblicato per la prima volta il 7 aprile 2022.





