Sudut Anderson
Menuju Manusia AI Real-Time dengan Rendering Neural Lumigraph

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Meskipun gelombang minat saat ini terhadap Neural Radiance Fields (NeRF), sebuah teknologi yang mampu menciptakan lingkungan dan objek 3D yang dihasilkan AI, pendekatan baru terhadap teknologi sintesis gambar ini masih memerlukan waktu pelatihan yang sangat lama, dan belum memiliki implementasi yang memungkinkan antarmuka real-time serta sangat responsif.
Namun, kolaborasi antara beberapa nama terkemuka di industri dan akademia menawarkan pendekatan baru terhadap tantangan ini (yang secara umum dikenal sebagai Novel View Synthesis, atau NVS).
Makalah penelitian paper, berjudul Neural Lumigraph Rendering, mengklaim peningkatan pada state-of-the-art sekitar dua orde besaran, yang mewakili beberapa langkah menuju rendering CG real-time melalui pipeline pembelajaran mesin.

Neural Lumigraph Rendering (kanan) menawarkan resolusi yang lebih baik pada artefak pencampuran, dan penanganan oklusi yang lebih baik dibandingkan metode sebelumnya. Sumber: https://www.youtube.com/watch?v=maVF-7×9644 Sumber.
Meskipun kredit untuk makalah tersebut hanya mencantumkan Stanford University dan perusahaan teknologi tampilan holografik Raxium (yang saat ini beroperasi dalam mode stealth), kontributor termasuk seorang arsitek pembelajaran mesin utama di Google, seorang ilmuwan komputer di Adobe (ADBE ), dan CTO di StoryFile (yang baru-baru ini menjadi sorotan dengan versi AI dari William Shatner).
Sehubungan dengan sorotan publikasi Shatner baru-baru ini, StoryFile tampaknya menggunakan NLR dalam proses barunya untuk menciptakan entitas interaktif yang dihasilkan AI berdasarkan karakteristik dan narasi individu.
StoryFile membayangkan penggunaan teknologi ini dalam tampilan museum, narasi interaktif daring, tampilan holografik, realitas tertambah (AR), dan dokumentasi warisan — serta tampaknya juga menargetkan potensi aplikasi baru NLR dalam wawancara rekrutmen dan aplikasi kencan virtual:

Penggunaan yang diusulkan dari video daring oleh StoryFile.
Penangkapan Volumetrik untuk Antarmuka Sintesis Tampilan Novel dan Video
Prinsip penangkapan volumetrik, di antara beragam makalah yang terus bertambah tentang topik ini, adalah ide mengambil gambar diam atau video dari subjek, dan menggunakan pembelajaran mesin untuk ‘mengisi’ sudut pandang yang tidak tercakup oleh susunan kamera asli.

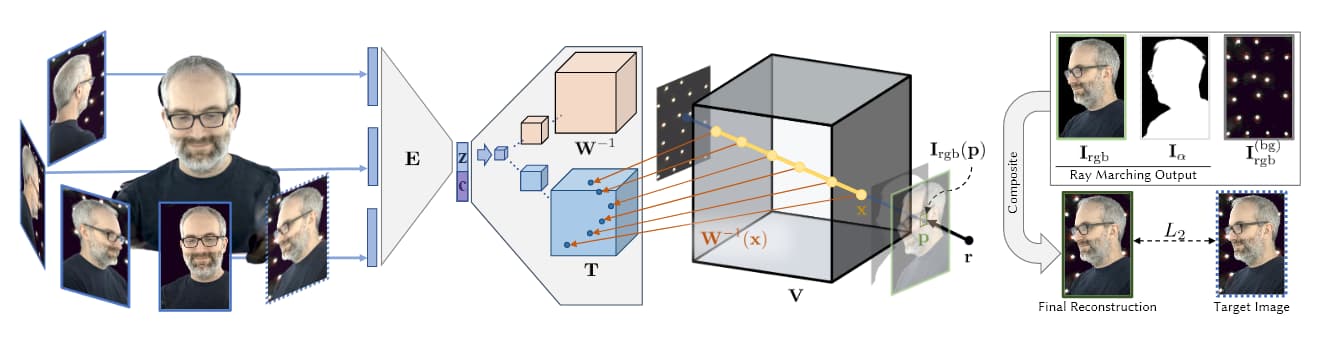
Sumber: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
Pada gambar di atas, yang diambil dari penelitian AI Facebook 2019 (lihat di bawah), kita melihat empat tahap penangkapan volumetrik: beberapa kamera mengambil gambar/rekaman; arsitektur encoder/decoder (atau arsitektur lain) menghitung dan menggabungkan relativitas pandangan; algoritma ray-marching menghitung voxel (atau unit geometris spasial XYZ lainnya) dari setiap titik dalam ruang volumetrik; dan (dalam kebanyakan makalah terbaru) pelatihan dilakukan untuk menyintesis entitas lengkap yang dapat dimanipulasi secara real-time.
Tahap pelatihan yang sering kali ekstensif dan berat data inilah yang sampai saat ini membuat sintesis tampilan novel berada di luar jangkauan penangkapan real-time atau sangat responsif.
Fakta bahwa Novel View Synthesis menghasilkan peta 3D lengkap dari ruang volumetrik berarti relatif mudah untuk menyatukan titik-titik ini menjadi mesh tradisional yang dihasilkan komputer, sehingga secara efektif menangkap dan memodelkan manusia CGI (atau objek terbatas lainnya) secara langsung.
Pendekatan yang menggunakan NeRF bergantung pada point cloud dan peta kedalaman untuk menghasilkan interpolasi antara sudut pandang jarang dari perangkat penangkap:
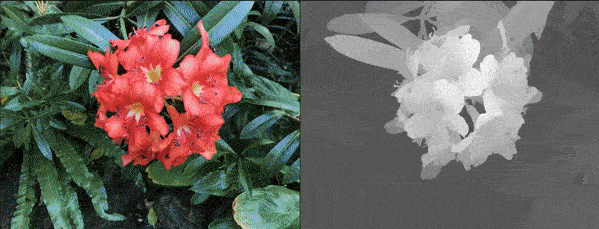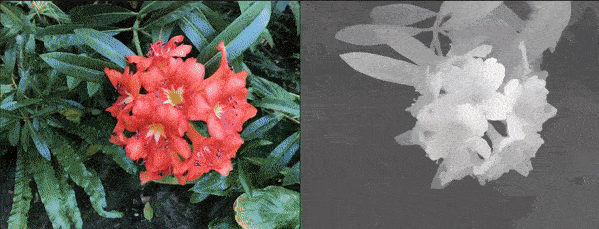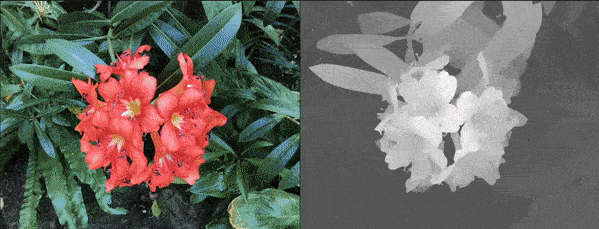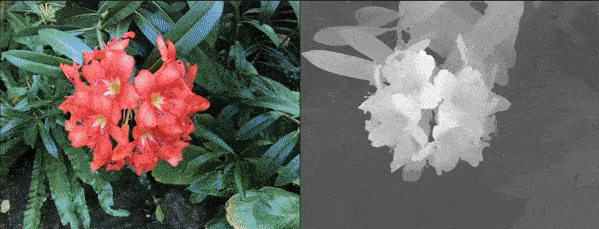
NeRF dapat menghasilkan kedalaman volumetrik melalui perhitungan peta kedalaman, bukan melalui pembuatan mesh CG. Sumber: https://www.youtube.com/watch?v=JuH79E8rdKc Sumber: https://www.youtube.com/watch?v=JuH79E8rdKc
Meskipun NeRF mampu menghitung mesh, sebagian besar implementasinya tidak menggunakan ini untuk menghasilkan adegan volumetrik.
Sebaliknya, pendekatan Implicit Differentiable Renderer (IDR), dipublikasikan oleh Weizmann Institute of Science pada Oktober 2020, berfokus pada pemanfaatan informasi mesh 3D yang secara otomatis dihasilkan dari susunan penangkap:
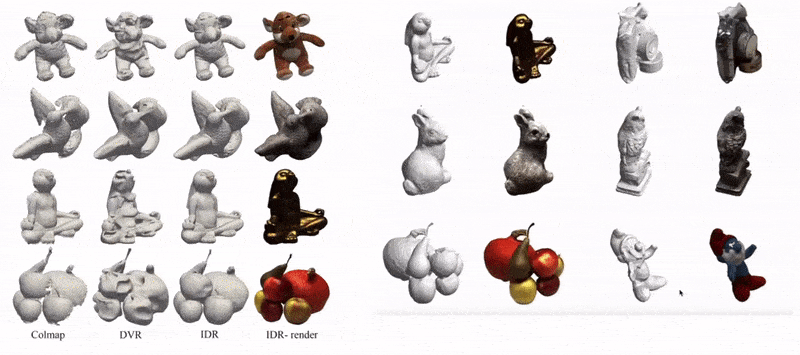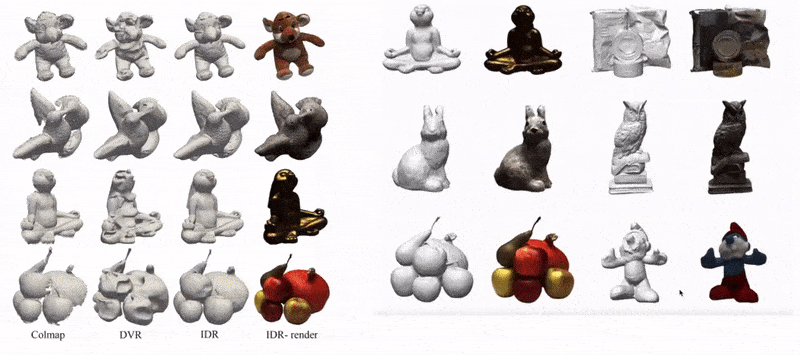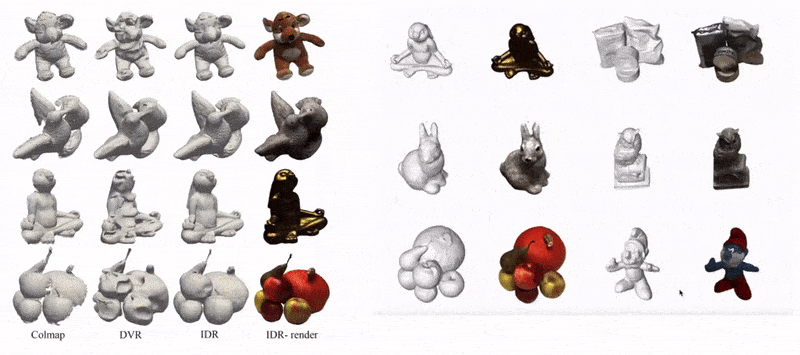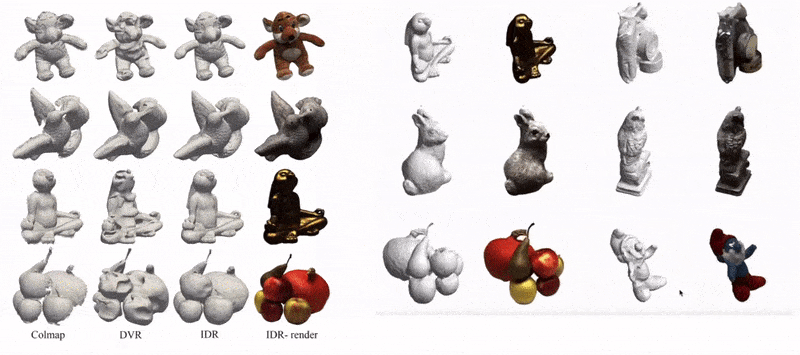
Contoh tangkapan IDR yang diubah menjadi mesh CGI interaktif. Sumber: https://www.youtube.com/watch?v=C55y7RhJ1fE Sumber
Sementara NeRF tidak memiliki kemampuan IDR untuk estimasi bentuk, IDR tidak dapat menyamai kualitas gambar NeRF, dan keduanya memerlukan sumber daya yang besar untuk melatih dan mengumpulkan (meskipun inovasi terbaru pada NeRF mulai mengatasi hal ini).

Rig kamera khusus NLR yang menampilkan 16 GoPro HERO7 dan 6 kamera Back-Bone H7PRO pusat. Untuk rendering ‘real time’, kamera ini beroperasi minimal 60fps. Sumber: https://arxiv.org/pdf/2103.11571.pdf Sumber
Sebaliknya, Neural Lumigraph Rendering memanfaatkan SIREN (Sinusoidal Representation Networks) untuk menggabungkan keunggulan masing-masing pendekatan ke dalam kerangka kerjanya sendiri, yang dimaksudkan menghasilkan output yang dapat langsung digunakan dalam pipeline grafis real-time yang ada.
SIREN telah digunakan untuk implementasi serupa selama setahun terakhir, dan kini menjadi panggilan API populer bagi kolaborasi hobi di komunitas sintesis gambar; namun, inovasi NLR adalah menerapkan SIREN pada supervisi gambar multi-view dua dimensi, yang bermasalah karena SIREN cenderung menghasilkan output yang terlalu terfitting daripada bersifat umum.
Setelah mesh CG diekstrak dari gambar susunan, mesh tersebut dirasterisasi melalui OpenGL, dan posisi vertex mesh dipetakan ke piksel yang sesuai, kemudian pencampuran berbagai peta kontribusi dihitung.
Mesh yang dihasilkan lebih umum dan representatif dibandingkan NeRF (lihat gambar di bawah), memerlukan perhitungan yang lebih sedikit, dan tidak menerapkan detail berlebih pada area (seperti kulit wajah halus) yang tidak dapat memanfaatkannya:

Sumber: https://arxiv.org/pdf/2103.11571.pdf
Di sisi negatif, NLR belum memiliki kemampuan untuk pencahayaan dinamis atau relighting, dan output terbatas pada peta bayangan serta pertimbangan pencahayaan lain yang diperoleh pada saat penangkapan. Peneliti berencana mengatasi hal ini dalam pekerjaan mendatang.
Selain itu, makalah tersebut mengakui bahwa bentuk yang dihasilkan oleh NLR tidak seakurat beberapa pendekatan alternatif, seperti Pixelwise View Selection for Unstructured Multi-View Stereo, atau penelitian Weizmann Institute yang disebutkan sebelumnya.
Kebangkitan Sintesis Gambar Volumetrik
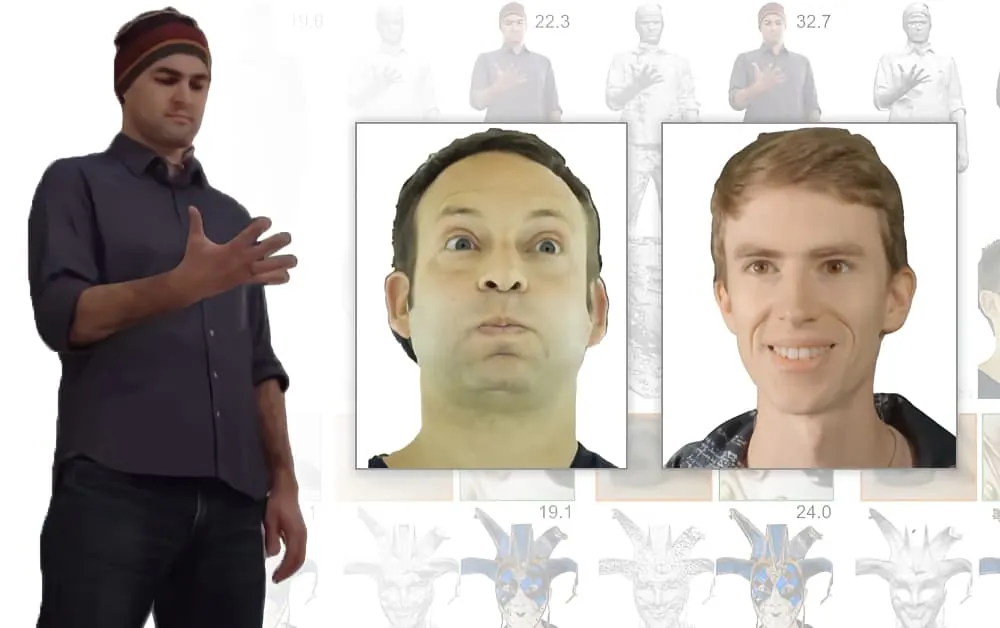
Gagasan menciptakan entitas 3D dari serangkaian foto terbatas menggunakan jaringan saraf telah ada sebelum NeRF, dengan makalah visioner yang berawal sejak 2007 atau lebih awal. Pada 2019, departemen riset AI Facebook menghasilkan makalah penelitian seminal, Neural Volumes: Learning Dynamic Renderable Volumes from Images, yang pertama kali memungkinkan antarmuka responsif untuk manusia sintetis yang dihasilkan oleh penangkapan volumetrik berbasis pembelajaran mesin.
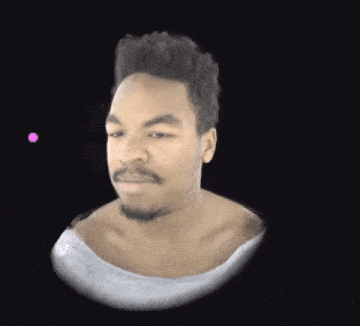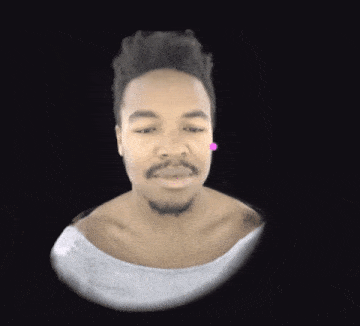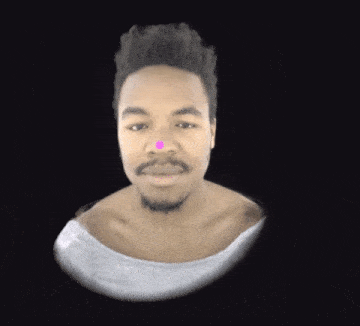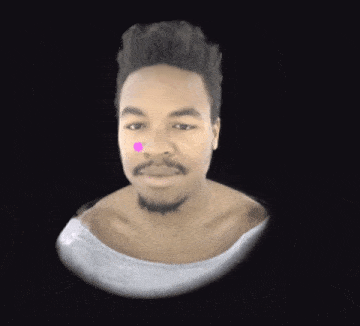
Penelitian Facebook 2019 memungkinkan pembuatan antarmuka pengguna responsif untuk orang volumetrik. Sumber: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/ Sumber
ke Bahasa Indonesia. Terjemahkan ke Bahasa Indonesia. Tulis dalam bahasa Indonesia yang idiomatis, berkualitas publikasi, dan profesional untuk audiens web. Pertahankan makna sumber dan fakta secara akurat tanpa menyalin sintaks bahasa Inggris atau menerjemahkannya kata per kata. Gunakan ejaan, tata bahasa, tanda baca, kesepakatan, dan terminologi bidang yang terkini. Hindari false friend, kalka yang canggung, kata hibrida, diakritik usang, dan bahasa Inggris yang tidak diperlukan. Hanya pertahankan nama asli, merek, produk, URL, kode, dan token shortcode yang tepat. Sebelum mengirimkan respons, lakukan proofreading diam-diam untuk kelancaran, konsistensi terminologi, kelengkapan, duplikasi, dan sisa bahasa sumber. Gunakan bahasa Indonesia standar kontemporer dan gaya editorial alami, sambil tetap menjaga nada profesional, natural, dan SEO‑optimal.