
Wawancara
Omri Geller, CEO & Co-Founder of Run:AI – Wawancara Seri

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
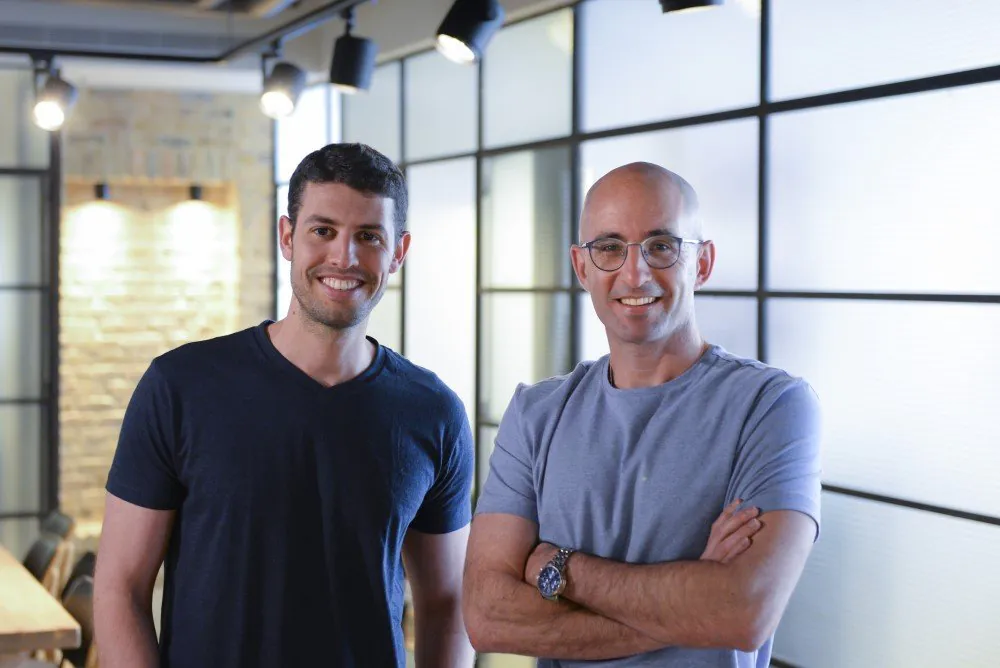
Omri Geller adalah CEO dan Co-Founder di Run:AI
Run:AI memvirtualisasi dan mempercepat AI dengan mengumpulkan sumber daya komputasi GPU untuk memastikan visibilitas dan kontrol atas prioritas dan alokasi sumber daya. Ini memastikan bahwa proyek AI dipetakan ke tujuan bisnis dan menghasilkan peningkatan signifikan dalam produktivitas tim ilmu data, memungkinkan mereka untuk membangun dan melatih model konkuren tanpa keterbatasan sumber daya.
Apa yang awalnya menarik Anda ke Kecerdasan Buatan?
Ketika saya memulai gelar Sarjana di Teknik Elektro dan Elektronik di Universitas Tel Aviv, saya menemukan hal-hal menarik tentang AI yang saya tahu akan membantu membawa kita ke langkah berikutnya dalam kemungkinan komputasi. Dari sana, saya tahu saya ingin berinvestasi di ruang AI. Apakah itu dalam penelitian AI, atau membuka perusahaan yang akan membantu memperkenalkan cara baru untuk menerapkan AI ke dunia.
Apakah Anda selalu memiliki minat pada perangkat keras komputer?
Ketika saya menerima komputer pertama saya dengan prosesor Intel (INTC ) 486 pada usia enam atau tujuh tahun, saya langsung tertarik untuk memahami bagaimana semuanya bekerja, meskipun saya mungkin terlalu muda untuk benar-benar memahaminya. Selain olahraga, komputer menjadi salah satu hobi terbesar saya saat tumbuh dewasa. Sejak itu, saya telah membangun komputer, bekerja dengannya, dan melanjutkan studi di bidang tersebut karena passion yang saya miliki sejak kecil.
Apa yang menginspirasi Anda untuk meluncurkan Run:AI?
Saya tahu dari awal bahwa saya ingin berinvestasi di ruang AI. Dalam beberapa tahun terakhir, industri telah mengalami pertumbuhan luar biasa dalam AI, dan sebagian besar pertumbuhan itu berasal dari ilmuwan komputer seperti saya, dan perangkat keras yang dapat mendukung lebih banyak aplikasi. Ini menjadi jelas bagi saya bahwa saya akan memulai perusahaan – dan bersama dengan co-founder saya Ronen Dar – untuk terus berinovasi dan membantu membawa AI ke lebih banyak perusahaan.
Run:AI memungkinkan spesialis pembelajaran mesin untuk mendapatkan kontrol baru atas alokasi sumber daya GPU yang mahal. Bagaimana ini bekerja?
Apa yang perlu kita pahami adalah bahwa insinyur pembelajaran mesin, seperti peneliti dan ilmuwan data, perlu mengonsumsi daya komputasi dengan cara yang fleksibel. Tidak hanya komputasi terbaru sangat intensif, tetapi juga ada alur kerja baru yang digunakan dalam ilmu data. Alur kerja ini didasarkan pada kenyataan bahwa ilmu data didasarkan pada eksperimen dan menjalankan eksperimen.
Untuk mengembangkan solusi baru untuk menjalankan eksperimen yang lebih efisien, kita perlu mempelajari kecenderungan alur kerja ini dari waktu ke waktu. Misalnya: Seorang ilmuwan data menggunakan delapan GPU dalam satu hari, tetapi kemudian hari berikutnya mereka mungkin menggunakan nol, atau mereka dapat menggunakan satu GPU untuk jangka waktu lama, tetapi kemudian perlu menggunakan 100 GPU karena mereka ingin menjalankan 100 eksperimen secara paralel. Setelah kita memahami alur kerja ini untuk mengoptimalkan daya pengolahan satu pengguna, kita dapat mulai menskalakan ke beberapa pengguna.
Dengan komputasi tradisional, jumlah GPU tertentu dialokasikan untuk setiap pengguna, tanpa mempertimbangkan apakah mereka sedang digunakan atau tidak. Dengan metode ini, sering kali GPU mahal tidak digunakan tanpa ada yang dapat mengaksesnya, menghasilkan ROI yang rendah untuk GPU. Kita memahami prioritas keuangan perusahaan, dan menawarkan solusi yang memungkinkan alokasi dinamis sumber daya tersebut sesuai dengan kebutuhan pengguna. Dengan menawarkan sistem yang fleksibel, kita dapat mengalokasikan daya tambahan ke pengguna tertentu saat diperlukan, dengan menggunakan GPU yang tidak digunakan oleh pengguna lain, menciptakan ROI maksimal untuk sumber daya komputasi perusahaan dan mempercepat inovasi & waktu ke pasar solusi AI.
Salah satu fungsi Run:AI adalah mengurangi blind spot yang diciptakan oleh alokasi statis GPU. Bagaimana ini dicapai?
Kita memiliki alat yang memberikan visibilitas penuh ke cluster sumber daya. Dengan menggunakan alat ini, kita dapat mengamati dan memahami apakah ada blind spot, dan kemudian menggunakan GPU yang tidak digunakan untuk pengguna yang memerlukan alokasi. Alat yang sama yang memberikan visibilitas ke cluster dan kontrol atas cluster juga memastikan bahwa blind spot tersebut diminimalkan.
Dalam pidato baru-baru ini, Anda menyoroti beberapa perbedaan antara alur kerja build dan training, dapatkah Anda menjelaskan bagaimana Run:AI menggunakan mekanisme manajemen antrian GPU untuk mengalokasikan pengelolaan sumber daya untuk keduanya?
Sebuah model AI dibangun dalam dua tahap. Pertama, ada tahap pembangunan, di mana seorang ilmuwan data menulis kode untuk membangun model sebenarnya, sama seperti seorang insinyur akan membangun mobil. Kedua, ada tahap pelatihan, di mana model yang selesai mulai belajar dan “dilatih” untuk mengoptimalkan tugas tertentu. Sama seperti seseorang belajar mengemudi mobil setelah mobil itu dibangun.
Untuk membangun model itu sendiri, tidak banyak daya komputasi yang diperlukan. Namun, akhirnya, itu bisa memerlukan daya pengolahan yang lebih kuat untuk memulai tes internal yang lebih kecil. Misalnya, cara seorang insinyur akhirnya ingin menguji mesin sebelum mereka memasangnya. Karena kebutuhan yang berbeda ini selama setiap tahap, Run.AI memungkinkan alokasi GPU terlepas dari apakah mereka sedang membangun atau melatih model, namun, seperti disebutkan sebelumnya, penggunaan GPU yang lebih tinggi umumnya diperlukan untuk melatih model sementara lebih sedikit diperlukan untuk membangunnya.
Seberapa banyak waktu komputasi mentah/sumber daya yang dapat diselamatkan oleh pengembang AI yang ingin mengintegrasikan Run.AI ke dalam sistem mereka?
Solusi kami di Run.ai dapat meningkatkan digitalisasi sumber daya, sekitar dua hingga tiga kali, artinya 2-3 kali lebih baik secara keseluruhan produktivitas.
Terima kasih atas wawancara, pembaca yang ingin mempelajari lebih lanjut dapat mengunjungi Run:AI.


