
Wawancara
Nikunj Bajaj, Salah Satu Pendiri dan CEO TrueFoundry – Seri Wawancara

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
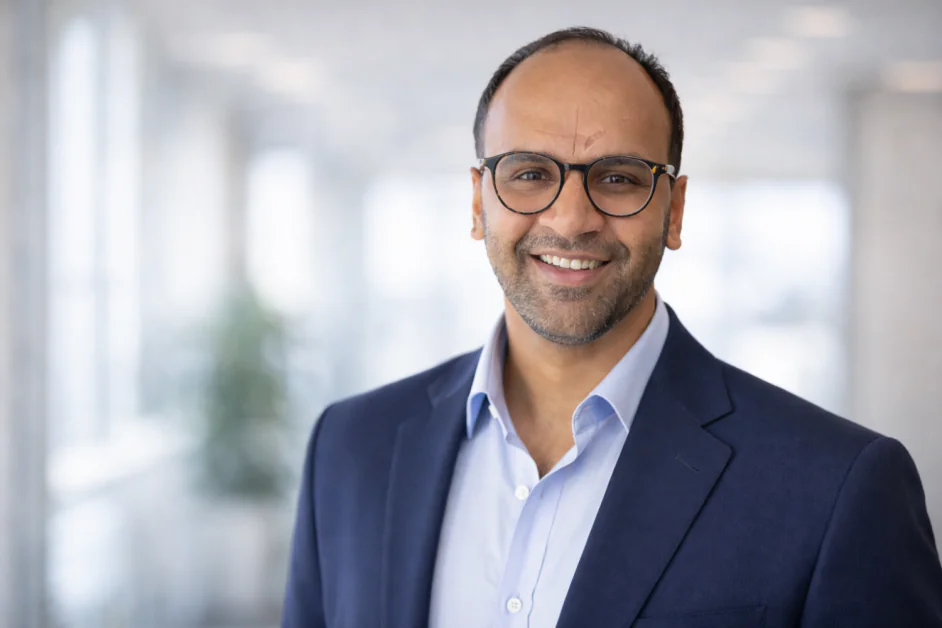
Sebelum mendirikan TrueFoundry, Anda bekerja dalam riset pembelajaran mesin, AI dalam lingkungan produksi di Facebook (META ), dan sistem rekomendasi berskala besar. Pengalaman apa yang paling langsung mendorong Anda membangun perusahaan infrastruktur AI untuk perusahaan, dan masalah apa yang menurut Anda belum teratasi saat itu?
Di Meta, kami memandang pembelajaran mesin sebagai kasus khusus perangkat lunak, dan GenAI sebagai kasus khusus pembelajaran mesin. Hasilnya adalah tumpukan teknologi vertikal dengan perangkat lunak di bagian bawah, pembelajaran mesin di tengah, dan GenAI di bagian atas. Dalam susunan ini, jika saya adalah pengembang pembelajaran mesin, model yang saya bangun mengikuti pola penerapan yang sama dengan perangkat lunak lainnya, sehingga penskalaan sistem menjadi sangat mudah.
Namun, kebanyakan perusahaan menerapkan tumpukan teknologi paralel, yakni tumpukan terpisah untuk perangkat lunak, pembelajaran mesin, dan GenAI. Begitu tumpukan-tumpukan ini berjalan paralel, penskalaan menjadi lebih kompleks karena diperlukan serah terima pekerjaan antara bidang pembelajaran mesin dan perangkat lunak.
Tim kami selalu bekerja di persinggungan antara pengembangan model pembelajaran mesin dan infrastrukturnya. Karena itu, kami memiliki sudut pandang yang khas: kami dapat menghadirkan tumpukan vertikal serupa bagi perusahaan dan menyesuaikannya dengan kebutuhan spesifik mereka. Menjelang akhir 2021, kami juga memiliki hipotesis bahwa pembelajaran mesin mendekati titik balik. Saat titik itu tercapai, lebih banyak perusahaan akan memerlukan tumpukan yang terintegrasi secara vertikal untuk menerapkan dan meningkatkan skala sistem ini secara efektif. Inilah yang akhirnya mendorong kami mendirikan TrueFoundry, dan hipotesis kami terbukti benar. Adopsi AI meningkat pesat setelah peluncuran ChatGPT pada akhir 2022.
Ketika sistem AI beralih dari eksperimen ke operasional sehari-hari, apa yang telah berubah dalam cara organisasi perlu memikirkan keandalan dan kegagalan?
Taruhan dalam GenAI jauh lebih besar dibandingkan sistem pembelajaran mesin tradisional. Ketika sistem ini masuk ke lingkungan produksi, organisasi menghadapi tingkat ambiguitas dan nondeterminisme yang jauh lebih tinggi karena LLM secara alami bersifat stokastik. Sistem berbasis agen yang dibangun di atasnya menambah ambiguitas tersebut.
Selain itu, kegagalan tidak lagi bersifat biner. Sistem tidak sekadar gagal atau tidak gagal; banyak masalah muncul sebagai kegagalan sebagian atau penurunan kinerja yang tidak disadari. Seiring waktu, sistem dapat merespons dengan latensi lebih tinggi, kualitas yang menurun, atau perilaku yang keliru. Dalam banyak kasus, penurunan ini lebih sulit dideteksi dan terkadang bahkan lebih merugikan daripada berhenti beroperasi sepenuhnya.
Organisasi perlu memikirkan keandalan bukan hanya dari sisi waktu aktif, melainkan juga penurunan kinerja seiring waktu.
TrueFailover diluncurkan di tengah gelombang gangguan layanan cloud dan AI yang mendapat sorotan luas. Peristiwa terbaru apa yang memperjelas bahwa keandalan AI telah beralih dari pelengkap yang diinginkan menjadi persyaratan arsitektur inti?
Salah satu pelanggan kami di bidang kesehatan memproses permintaan pasien terkait resep obat secara real time, dengan waktu penanganan yang sangat penting. Pelanggan ini mengalami gangguan operasional akibat kegagalan model. Alur kerja mereka menghasilkan ribuan dolar pendapatan per detik, dan gangguan tersebut menghambat sebagian alur kerja kritis itu. Mereka merupakan salah satu pelanggan awal TrueFailover, sehingga kami dapat membantu memulihkan operasi dengan cepat dan membatasi dampaknya.
Insiden seperti ini menimbulkan pertanyaan penting. Ketika taruhan sistem GenAI terus meningkat, mengapa proses pemulihan masih sebagian besar dilakukan secara manual? Ini memperkuat pandangan bahwa sistem harus dibangun dengan asumsi kegagalan akan terjadi, dan dirancang agar dapat memperbaiki diri secara otomatis. Keandalan juga harus ditanamkan dalam tumpukan AI itu sendiri melalui AI Gateway, yang dapat menyediakan perutean terpusat, observabilitas, mekanisme pengaman, serta perpindahan model secara cerdas di antara penyedia.
Banyak gangguan AI masih digambarkan sebagai kendala teknis kecil. Menurut Anda, di mana biaya nyata terhadap perekonomian dan manusia mulai terlihat ketika sistem AI berhenti beroperasi?
AI di perusahaan telah berkembang hingga kendala-kendala ini tidak lagi hanya memengaruhi alur kerja internal. Saat ini, gangguan dan penurunan kinerja berdampak langsung dan seketika pada persepsi publik serta laba, karena aplikasi dalam lingkungan produksi kini melayani pelanggan secara langsung. Peralihan dari pengujian internal ke aplikasi yang diakses publik dengan taruhan besar inilah yang meningkatkan kebutuhan akan perhatian dan pengawasan dari pimpinan eksekutif.
Ketika sistem AI semakin terintegrasi ke dalam alur kerja operasional, gangguan tidak lagi sekadar masalah teknis. Gangguan tersebut semakin menimbulkan konsekuensi langsung bagi bisnis, pelanggan, dan reputasi.
Dalam lingkungan yang sangat penting bagi kelangsungan layanan, seperti apotek, operasional layanan kesehatan, atau dukungan pelanggan, seberapa cepat waktu henti AI dapat berkembang menjadi risiko operasional atau reputasi?
Dalam lingkungan seperti itu, risiko meningkat hampir seketika karena sistem ini mendukung alur kerja real time yang menuntut ketepatan waktu. Bahkan gangguan singkat dapat menghentikan proses kritis, menunda penyediaan layanan, atau mengganggu sistem hilir yang bergantung pada keluaran tersebut, sehingga menimbulkan efek operasional berantai di seluruh organisasi.
Di sektor seperti kesehatan, dampaknya melampaui gangguan operasional dan mencakup pengalaman pelanggan serta hasil layanan. Jika pasien tidak dapat menebus resep tepat waktu, konsekuensinya bisa nyata. Ini bukan hanya masalah bagi pasien, tetapi juga dapat merusak reputasi apotek atau penyedia layanan kesehatan. Dalam lingkungan yang sangat penting bagi kelangsungan layanan dan mengandalkan kepercayaan, memastikan sistem tetap beroperasi adalah hal yang mutlak. Karena itulah organisasi semakin menyadari bahwa sistem AI harus dirancang dengan asumsi kegagalan akan terjadi, dan mekanisme pemulihan perlu aktif secara otomatis untuk meminimalkan risiko.
Anda pernah mengatakan banyak tim merancang arsitektur dengan mengutamakan kapabilitas daripada kesinambungan operasi. Mengapa menurut Anda ketahanan terhadap gangguan secara historis mendapat prioritas lebih rendah dalam desain sistem AI?
Penyebab utamanya adalah insentif dalam organisasi. Kapabilitas baru terlihat jelas dan menarik. Kapabilitas tersebut memungkinkan demonstrasi, fitur, serta kemungkinan baru produk yang bisa langsung dilihat oleh pimpinan.
Kesinambungan operasi, sesuai definisinya, tidak terlihat ketika semuanya berjalan baik. Karena itu, sistem penghargaan cenderung lebih mengutamakan peluncuran fitur baru daripada memastikan tidak ada yang rusak. Akibatnya, organisasi sering mengalokasikan investasi secara tidak proporsional pada pengembangan kapabilitas dibandingkan rekayasa ketahanan terhadap gangguan.
Ketika perusahaan semakin bergantung pada model dan API eksternal, kerentanan baru apa yang muncul dalam tumpukan AI yang mungkin belum sepenuhnya disadari para pemimpin?
LLM pada dasarnya merupakan sumber daya bersama, dan perusahaan tidak memilikinya sebagaimana mereka memiliki infrastruktur tradisional. Selain itu, sistem perusahaan yang sangat penting bagi bisnis berjalan di atas sistem eksternal yang belum sepenuhnya teruji oleh waktu. LLM sendiri berkembang pesat, sehingga penyedia model tidak dapat dimintai pertanggungjawaban atas hal-hal seperti latensi atau sedikit penurunan kinerja model, karena mereka melakukan iterasi riset dengan sangat cepat.
Karena LLM merupakan sumber daya bersama, latensi dapat melonjak ketika pengguna LLM lain melakukan tindakan tertentu. Ada banyak titik kegagalan semacam ini yang muncul akibat sifat dasar LLM, dan perusahaan dalam dunia baru ini tidak memiliki kendali penuh. Tanpa kendali penuh, langkah terbaik yang dapat dilakukan perusahaan adalah menyediakan redundansi sistem yang memadai untuk membangun sistem yang tangguh.
Tanpa berfokus pada produk tertentu, bagaimana organisasi perlu memikirkan ulang arsitektur AI agar mengasumsikan kegagalan akan terjadi, alih-alih menganggap gangguan sebagai kasus langka di luar kondisi normal?
Organisasi perlu kembali ke prinsip dasar desain sistem terdistribusi. Sistem perangkat lunak dibangun dengan asumsi komponen jaringan dan mesin akan gagal, bahkan satu wilayah secara keseluruhan dapat berhenti beroperasi.
Sistem AI seharusnya tidak berbeda. Kita perlu mengasumsikan penyedia model akan mengalami masalah latensi, penurunan kinerja, atau gangguan, serta menyertakan redundansi agar aplikasi tetap tangguh dalam berbagai skenario kegagalan.
Apakah Anda memperkirakan ketahanan AI terhadap gangguan akan menjadi faktor penentu dalam pemilihan platform dan vendor, serupa dengan cara waktu aktif dan redundansi membentuk keputusan mengenai infrastruktur cloud?
Seiring semakin banyaknya sistem AI yang masuk ke lingkungan produksi, ketahanan terhadap gangguan akan menjadi persyaratan minimum. Jika vendor tidak dapat menunjukkan grafik dan metrik waktu aktif serta ketahanan sistem secara keseluruhan, mereka bahkan tidak akan dipertimbangkan. Setelah ketahanan menjadi harapan dasar terhadap semua vendor, faktor penentu akan beralih ke pengalaman pengguna, optimalisasi kinerja, observabilitas, dan kapabilitas produk pada tingkat yang lebih tinggi. Seiring waktu, komponen seperti AI Gateway dan kemampuan pengalihan otomatis saat terjadi kegagalan akan menjadi fondasi utama infrastruktur AI perusahaan.
Ke depan, apa sebenarnya arti AI yang “siap untuk lingkungan produksi” di dunia yang mengharapkan AI selalu tersedia, bukan hanya sesekali berguna?
Sistem AI yang siap untuk lingkungan produksi harus dapat diamati, dikendalikan, dan dipulihkan. Ketiga persyaratan ini wajib terpenuhi.
Agar AI dalam lingkungan produksi dapat diamati, tim memerlukan visibilitas mendalam terhadap perilaku model, latensi, tingkat kesalahan, penggunaan token, pergeseran atau drift, serta pola kegagalan. Tanpa observabilitas yang kuat, sangat sulit mendeteksi penurunan kinerja sebelum pengguna mulai menyadarinya.
Kemampuan mengendalikan sistem mencakup pengaturan lalu lintas, pembatasan laju permintaan, mekanisme pengaman, penegakan kebijakan, serta perutean cerdas di antara model dan penyedia. Di sinilah AI Gateway menjadi fondasi, dengan bertindak sebagai lapisan kendali terpusat yang menegakkan mekanisme pengaman, menyediakan tata kelola yang konsisten, dan memungkinkan perpindahan model secara dinamis ketika kinerja atau keandalan menurun.
Terakhir, agar dapat dipulihkan, sistem harus dibangun dengan asumsi komponennya dapat rusak sebagian atau sepenuhnya, baik akibat gangguan penyedia, penurunan kualitas model, batas laju permintaan, maupun masukan tak terduga dari pihak yang berniat jahat. Mekanisme pengalihan otomatis saat terjadi kegagalan dan pemulihan mandiri harus menjadi bagian bawaan arsitektur, bukan prosedur manual yang baru dijalankan setelah terjadi masalah.
Inilah arah yang kami tempuh di TrueFoundry. Vendor yang mendefinisikan kesiapan produksi dengan cara ini—menggabungkan observabilitas, kendali terpusat, dan pemulihan otomatis—akan memperoleh kepercayaan pelanggan dalam jangka panjang serta dapat terus menyelesaikan masalah baru ketika muncul.
Terima kasih atas wawancara yang luar biasa. Pembaca yang ingin mengetahui lebih lanjut dapat mengunjungi TrueFoundry.


