
Wawancara
Elizabeth Nammour, CEO & Founder of Teleskope – Seri Wawancara

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
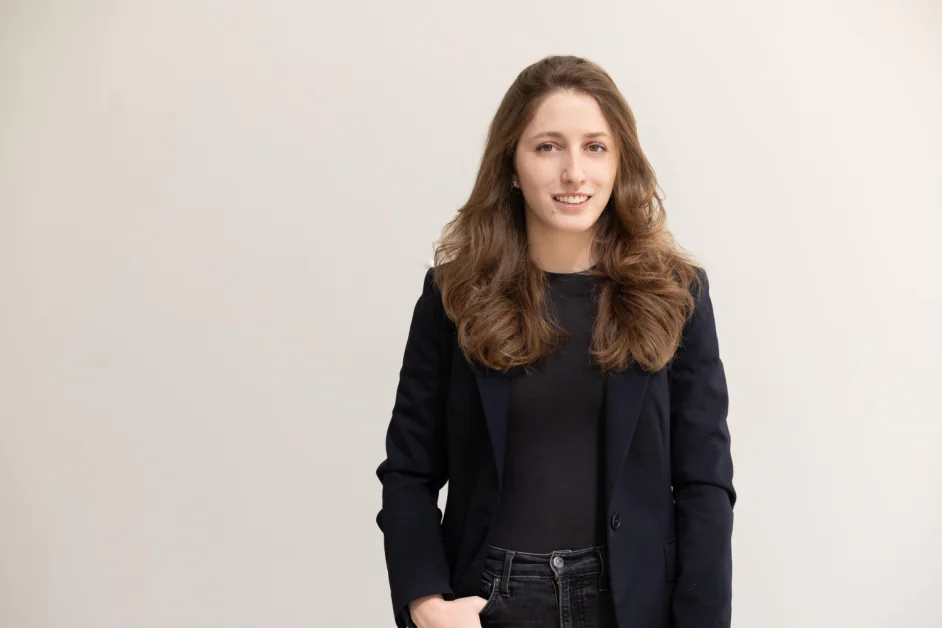
Elizabeth Nammour, CEO dan pendiri Teleskope, adalah insinyur keamanan yang berubah menjadi pendiri yang karirnya meliputi keamanan data, rekayasa perangkat lunak, dan peran inovasi di beberapa organisasi teknologi terbesar di dunia. Sementara bekerja sebagai insinyur perangkat lunak senior yang fokus pada keamanan data di Airbnb (ABNB ), dia menghadapi tantangan operasional untuk memahami dan mengontrol estate data yang besar dan tumbuh dengan cepat yang tersebar di selusin sistem. Pengalaman itu, dikombinasikan dengan peran teknis dan strategis sebelumnya di Amazon (AMZN ) dan Booz Allen Hamilton (BAH ), membentuk perspektifnya tentang bagaimana organisasi modern berjuang untuk mengatur data sensitif dalam skala dan akhirnya memimpinnya untuk membangun perusahaan yang menangani kesenjangan itu.
Teleskope adalah platform keamanan data modern yang dirancang untuk membantu organisasi terus-menerus memahami di mana data mereka hidup, bagaimana data tersebut digunakan, dan apa risiko yang dihasilkannya ketika lingkungan menjadi lebih kompleks. Dibangun dengan mempertimbangkan pengembang dan tim keamanan, platform ini menekankan visibilitas data yang akurat, remediasi otomatis, dan kontrol berbasis kebijakan di seluruh lingkungan cloud, SaaS, dan hybrid. Dengan melampaui audit statis dan proses manual, Teleskope bertujuan untuk memberikan organisasi dasar yang praktis untuk mengelola penyebaran data sambil memungkinkan adopsi AI yang bertanggung jawab.
Anda mendirikan Teleskope setelah membangun alat keamanan data internal di Airbnb untuk mengatalog dan mengklasifikasikan data dalam skala besar. Apa momen yang membuat Anda yakin bahwa ini perlu menjadi perusahaan dan tidak hanya proyek internal, dan bagaimana pelajaran awal itu membentuk tesis produk Anda?
Ketika saya selesai membangun produk ini di AirBnB, saya memiliki kesempatan untuk menulis posting di blog AirBnB yang berjudul “Mengotomatisasi Perlindungan Data pada Skala”. Saya tidak pernah benar-benar mengantisipasi apa pun yang akan datang dari itu, tetapi komunitas keamanan merespons sangat positif dan saya mulai dihubungi oleh praktisi dari seluruh dunia. Saya pasti memiliki momen itu ketika saya menyadari bahwa banyak orang berbagi tantangan yang sama yang saya hadapi, dan bahwa produk ini adalah sesuatu yang pasar benar-benar minta. Saya banyak bergantung pada umpan balik dari rekan-rekan di hari-hari awal, dan bahkan Teleskope v1.0 jauh lebih baik dari apa yang saya bangun di AirBnB. Hari ini produk kami lebih besar dan lebih berdampak daripada yang saya bisa bayangkan sebelumnya.
Anda menggunakan pipa klasifikasi multi-model yang menggabungkan ML tradisional, model spesifik format, dan validasi GenAI. Bisakah Anda menjelaskan logika keputusan dan bagaimana Anda mengurangi false positif/negatif pada skala besar?
Saya sangat merekomendasikan membaca blog kami, yang saya tulis bersama dengan kepala Ilmu Data kami, Ivan, tentang klasifikasi data. Saya akan mengatakan bahwa ini adalah seni, sama seperti itu adalah ilmu. Ada banyak nuansa – setiap kali Anda menemukan entitas data sensitif, konteksnya akan unik. Sementara itu, skala data telah membuat masalah ini menjadi lebih menantang, karena memindai petabyte data produksi membutuhkan banyak komputasi dan waktu. Secara dasar, ada alasan mengapa ini terus dilihat sebagai masalah yang belum terpecahkan.
Di mana seni itu datang adalah dengan menemukan cara untuk mengimbangkan semua trade-off – kecepatan, latensi, akurasi, biaya, dan cakupan (dalam toko data, format file, bahasa, dll.). Kami selalu percaya bahwa jawabannya harus kreatif, dan harus multi-modal. Ini adalah mengapa kami telah mengambil pendekatan yang kami lakukan, menggabungkan banyak metode klasifikasi yang tersedia untuk memiliki pendekatan yang dinamis dan nuansa yang, untuk menyimpulkan, dibangun untuk menggunakan metode ringan mungkin, tanpa mengorbankan akurasi secara signifikan. Pendekatan dinamis ini memungkinkan kami untuk memindai data 10-20 kali lebih cepat daripada alat yang bergantung pada LLM satu-ukuran-untuk-semua, sambil juga memberikan hasil yang jauh lebih akurat daripada pendekatan berbasis REGEX atau konteks konvensional.
Anda baru-baru ini memperkenalkan Prism, yang fokus pada pemahaman data tingkat bisnis dan remediasi yang ditenagai GenAI. Apa kasus penggunaan baru yang dibuka kuncinya dibandingkan dengan deteksi PII tingkat elemen, dan bagaimana Anda melindungi terhadap halusinasi dalam tindakan remediasi?
Ketika saya pertama kali berusaha untuk menangani tantangan klasifikasi dan perlindungan data, fokus saya adalah mengurangi hasil positif palsu yang sebenarnya. Misalnya, bagaimana kita memastikan bahwa setidaknya 95% dari waktu ketika kita menandai sesuatu sebagai Nomor Keamanan Sosial, itu akan terbukti menjadi SSN yang sebenarnya. Beberapa tahun yang lalu, bahkan akurasi 80% di seluruh jenis elemen data akan menjadi perbaikan.
Namun, dengan bekerja erat dengan pelanggan kami selama setahun terakhir, menjadi jelas bahwa “kebisingan” yang timbul bukan hanya disebabkan oleh klasifikasi entitas data yang tidak akurat (hasil positif palsu tradisional). Kebisingan itu sering kali tentang ditenggelamkan dalam alert yang tidak relevan sama seperti mendapatkan alert palsu. Apa yang dilakukan Prism adalah membuka kemampuan kami untuk mempertimbangkan konteks yang jauh lebih luas – tidak hanya “apa ini potongan data” atau “siapa yang mengakses file ini”, tetapi juga “apa, secara praktis, file ini”. Dengan menggabungkan ini dengan informasi yang dapat kami terima tentang apa yang sebenarnya dilakukan oleh bisnis dan apa yang mereka pedulikan, kami dapat menyampaikan produk yang disesuaikan dengan definisi “data sensitif” yang berbeda-beda untuk setiap perusahaan.
Mengabadikan konteks yang halus ini adalah perubahan permainan yang sebenarnya. Menyimpan ratusan SSN dalam Dokumen Google (GOOGL ) di drive pribadi, misalnya, mungkin merupakan risiko besar dan pelanggaran Kebijakan Manajemen Data. Tetapi memiliki folder di drive HR yang aman penuh dengan W2 karyawan? Itu perilaku yang diharapkan. Tim keamanan ingin diingatkan tentang yang pertama, tetapi mendapatkan alert untuk setiap W2 karyawan, yang disimpan dengan benar, hanya kebisingan. Memahami di mana dan dalam konteks apa data sensitif berada membutuhkan lebih dari sekadar model klasifikasi entitas.
Kami bekerja dengan perusahaan kimia multinasional, Chevron (CVX ) Philips Chemicals. Bisnis ini tidak akan pernah membeli alat privasi atau DSPM standar, karena mereka tidak benar-benar melihat risiko data konsumen sebagai prioritas. Namun, apa yang mereka pedulikan adalah properti intelektual dalam bentuk persamaan kimia. Dengan menguraikan esensi dokumen menjadi daftar label yang dikelompokkan, kami tidak hanya dapat mendeteksi elemen data sensitif unik, tetapi juga menemukan contoh aset data ini berada di “tempat yang salah”. Dengan menggabungkan konteks ini dengan remediasi otomatis kami, kami kemudian dapat mengambil tindakan untuk mengarsip, menghapus, menyensor, atau memindahkan file-file tersebut ke lokasi yang tepat. Tidak ada yang melakukan pekerjaan seperti ini di pasar keamanan data.
Teleskope menyoroti penemuan berkelanjutan di seluruh multi-cloud, on-prem, dan sistem pihak ketiga – termasuk data bayangan. Apa yang tampak seperti “peta lengkap”, dan seberapa cepat Anda dapat menemukan toko data yang tidak diketahui dalam penerapan greenfield?
“Lengkap” adalah kata yang sulit di sini – dalam kenyataan itu adalah batang yang terus bergerak, bahkan setiap hari. Itulah betapa sulitnya mengelola penyebaran data. Tujuan kami selalu untuk Teleskope ada di mana pun data pelanggan kami ada. Kami pada dasarnya adalah produk berbasis integrasi dalam banyak cara – kami telah membangun lusinan konektor data proprietary untuk dapat merayapi, memindai, dan mengklasifikasikan data di seluruh rangkaian alat SaaS, toko data cloud, dan sistem on-premise. Sebagian besar pelanggan memulai dengan beberapa konektor yang mereka lihat sebagai risiko tertinggi, atau di mana mereka memiliki visibilitas paling sedikit, sehingga dalam kenyataan kami jarang ada di mana pun data perusahaan berada. Namun, di dalam setiap sumber data, kami terus merayapi lingkungan mereka untuk menemukan akun baru, tabel, blob, file, pesan, dll. Jadi, di mana pun kami berada, kami menemukan data, baru dan lama, hampir secara real-time.
Untuk keamanan dan tata kelola AI, bagaimana Anda melacak garis keturunan antara set data pelatihan, model, prompt, dan output untuk keamanan audit?
Kami memiliki tiga cara utama untuk mendukung keamanan dan tata kelola AI. Pertama, teknologi klasifikasi dan remediasi kami dapat diterapkan pada data yang sedang bergerak melalui API. Ketika perusahaan membuat set data pelatihan, Teleskope terhubung langsung ke pipeline dan membersihkan PII atau informasi sensitif saat data dipindahkan atau disalin, sehingga model tidak berisiko mengeluarkannya.
Kedua, produk inti kami memungkinkan adopsi AI yang aman. Alat seperti M365 Copilot mempermudah menemukan file, tetapi juga mempermudah menemukan data sensitif. Teleskope memindai lingkungan dan menegakkan kebijakan pengelolaan serta keamanan secara otomatis, sehingga perusahaan dapat menggunakan AI dengan percaya diri.
Ketiga, kami membangun integrasi yang menyunting atau mengarantina prompt berisi data sensitif sebelum bocor ke layanan publik seperti ChatGPT. Banyak perusahaan melarang alat ini sepenuhnya, padahal adopsi aman dapat dilakukan bila definisi data sensitif milik setiap perusahaan diterapkan sebelum data keluar.
Redaction dan “remediation at the source” adalah inti pendekatan Anda. Bagaimana menyeimbangkan remediasi otomatis dengan human-in-the-loop?
Penemuan dan klasifikasi hanya memberi separuh cerita. Menemukan risiko adalah langkah pertama; menyelesaikannya adalah tujuan akhir. Pelanggan biasanya memulai dengan meninjau temuan di katalog data, kemudian melakukan remediasi dengan persetujuan manusia, dan akhirnya mengotomatisasi tindakan yang telah dipercaya.
Beberapa tindakan tidak akan pernah nyaman diotomatisasi sepenuhnya. Menghapus data dari basis data produksi, misalnya, bisa sangat berbahaya. Namun, pelanggan sudah memakai otomatisasi penuh untuk mencabut izin, memindahkan data, dan menegakkan kebijakan arsip atau retensi.
Banyak alat DSPM/DLP kesulitan memberi perlindungan real time. Apa yang harus berubah secara arsitektural?
Masalah real time harus dipecah menjadi komponen inti karena situasi berbeda memerlukan latensi berbeda. Arsitektur yang fleksibel memungkinkan sistem latensi rendah dijalankan paralel sesuai kebutuhan throughput. Ketika Teleskope berjalan di lingkungan perusahaan, data diklasifikasikan dan dilindungi langsung dalam infrastruktur mereka, mengurangi latensi dan aliran data keluar. Dalam skenario berisiko tinggi, remediasi dapat dilakukan dalam waktu kurang dari satu detik.
Bagaimana pemetaan privasi dan kepatuhan tetap mutakhir ketika regulasi berubah?
Fokus kami bergeser dari sekadar mencentang kotak menuju pemahaman mendalam tentang risiko yang dipedulikan pelanggan. Kami terus memantau peraturan baru dan memasukkannya ke produk, tetapi banyak perusahaan masih jauh dari kepatuhan penuh. Kami harus membawa mereka dari titik A ke B lalu C sebelum menuntut titik Z.
Kami terlebih dahulu mendefinisikan arti kepatuhan bagi perusahaan tersebut. Perusahaan manufaktur, misalnya, mungkin tidak menganggap GDPR sebagai risiko utama. Kontrol dapat dibentuk sesuai profil risiko, wilayah, dan kebutuhan unit bisnis masing-masing.
Bagaimana pelanggan menciptakan “input aman” dan “output aman” untuk GenAI tanpa memperlambat pengembang?
Pelanggan memasang Redact API Teleskope ke pipeline pelatihan dan inferensi agar data sensitif tidak pernah mengalir ke model generatif. Proses penyuntingan diabstraksikan dari pengembang: informasi disunting sebelum inferensi lalu direhidrasi setelahnya, sehingga kecepatan pengembangan tetap terjaga.
Apa tanda bahwa industri siap untuk platform keamanan data agentic dengan remediasi otonom?
Industri sudah siap. Bidang keamanan siber lain seperti SOC telah beralih menuju agentic AI untuk meningkatkan kapasitas tim keamanan. Kami memiliki antrean pelanggan yang ingin menjadi design partner karena mereka masih harus memilah, menyelidiki, memutuskan, lalu mengeksekusi tindakan secara manual untuk menyelesaikan satu tiket.
Kami yakin pasar bergerak menuju perlindungan otonom menyeluruh dan berniat memimpin peralihan tersebut.
Terima kasih atas wawancara ini. Pembaca dapat mempelajari lebih lanjut di Teleskope.









