
Wawancara
Dr Mathilde Pavis, Kepala Hukum, OpenOrigins – Seri Wawancara

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
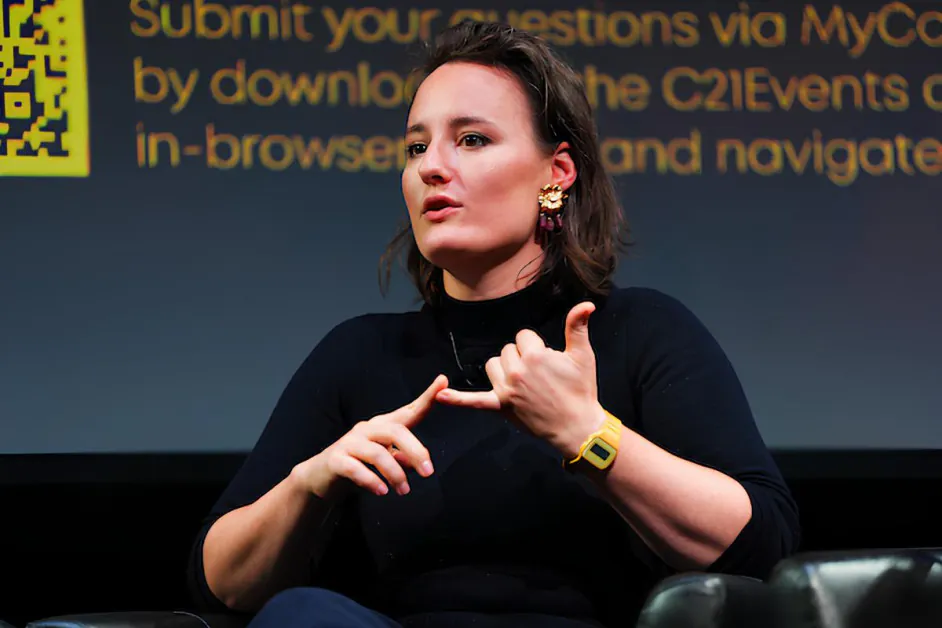
Dr Mathilde Pavis, Kepala Hukum di OpenOrigins, adalah seorang ahli terkemuka dalam regulasi AI dan tata kelola media digital, yang mengkhususkan diri dalam deepfakes, media sintetis, dan provenance konten. Ia memberikan saran kepada perusahaan, pemerintah, dan serikat pekerja tentang kepatuhan, lisensi, dan risiko dalam AI generatif, dan telah bekerja dengan Microsoft (MSFT ) dan ElevenLabs pada kebijakan dan strategi AI. Ia juga telah memberikan saran kepada UNESCO tentang AI dan hak cipta, dan secara teratur memberikan bukti ahli kepada pembuat kebijakan Inggris.
OpenOrigins mengembangkan teknologi untuk melawan informasi yang salah dan deepfakes dengan menciptakan catatan digital yang dapat diverifikasi dan tahan manipulasi. Platformnya berfokus pada membangun provenance yang jelas, yang memungkinkan media, kreator, dan platform untuk membuktikan kapan dan bagaimana konten dibuat, diedit, dan didistribusikan – kemampuan yang semakin penting karena media sintetis menjadi lebih maju dan lebih sulit dideteksi.
Anda telah memberikan saran kepada pemerintah, lembaga global seperti UNESCO, dan perusahaan seperti Microsoft dan ElevenLabs tentang regulasi AI. Apa yang membuat Anda fokus pada deepfakes, replika digital, dan media sintetis, dan bagaimana perjalanan itu membentuk keputusan Anda untuk mendirikan Replique?
Penelitian saya tentang deepfakes tidak dimulai dengan teknologi – itu dimulai dengan teka-teki hukum yang lebih tua. Ketika saya mulai melakukan penelitian tentang hak cipta untuk disertasi saya pada tahun 2013, saya terkejut dengan betapa sedikit perlindungan yang diterima oleh para pemain dibandingkan dengan penulis, komponis, atau pembuat film. Dalam praktiknya, ini berarti bahwa kata-kata atau musik Anda akan lebih baik dilindungi oleh hukum daripada suara, wajah, dan tubuh Anda. Ketidakseimbangan itu terasa aneh, dan itu mendorong saya untuk mengajukan pertanyaan yang lebih dalam: bagaimana kita secara budaya dan hukum menilai kontribusi seseorang yang menggunakan wajah, suara, dan tubuhnya di layar?
Pertanyaan itu membawa saya ke hak-hak pemain dan data. Pada saat itu, itu dianggap sebagai area yang tidak komersial dan memiliki sedikit relevansi. Saya secara aktif dianjurkan untuk pindah ke bidang yang lebih “menguntungkan” seperti paten atau hak cipta tradisional. Asumsinya adalah bahwa masalah seputar kesamaan atau suara seseorang sebagian besar dikelola secara tidak formal – melalui norma-norma industri atau “perjanjian gentlemen” di Hollywood. Tapi bagi saya, kurangnya perlindungan formal itu menandakan celah, bukan akhir dari penelitian saya, sehingga saya terus melanjutkannya.
Apa yang berubah adalah bahwa hari ini, hampir semua orang adalah seorang pemain. Kehidupan kita dimediasi oleh kamera – di ponsel, laptop, panggilan video, dan platform sosial. Baik untuk pekerjaan atau penggunaan pribadi, orang-orang terus-menerus merekam dan berbagi versi diri mereka sendiri. Pertanyaan hukum yang dulunya hanya berlaku untuk aktor atau musisi sekarang berlaku untuk siapa saja yang memiliki smartphone.
Deepfakes tidak menciptakan masalah-masalah ini – mereka mempercepat dan memperluasnya. Penelitian yang saya lakukan sejak 2013 tiba-tiba menjadi mendesak. Sekitar tahun 2017 dan 2018, perkembangan dalam jaringan saraf – terutama dari tempat-tempat seperti MIT dan UC Berkeley – mulai menunjukkan bagaimana wajah, suara, dan tubuh seseorang dapat dimanipulasi secara digital. Dalam waktu setahun, kemampuan itu menjadi dikenal secara luas sebagai “deepfakes”, dan pertama kali mendapatkan traksi dalam cara-cara yang sangat merugikan, terutama melalui konten seksual non-konsensual yang menargetkan perempuan dan anak-anak.
Baru kemudian implikasi komersial muncul, ketika industri kreatif mulai mengadopsi media sintetis. Itulah saat ketika pertanyaan-pertanyaan kontraktual dan ekonomi yang saya kerjakan mulai mendapat perhatian. Hampir semalam, apa yang dulunya dianggap sebagai area hukum yang sebagian besar teoretis atau doktrinal menjadi bidang yang sangat praktis, komersial, dan sosial yang mendesak.
Intinya, tantangan hukum tidak berubah: orang ingin berbagi aspek-aspek diri mereka sendiri, tetapi tetap ingin mempertahankan kontrol yang bermakna. Kerangka kerja yang ada berjuang dengan nuansa itu. Mereka cenderung mengobati individu sebagaieither sepenuhnya pribadi atau sepenuhnya publik – baik dilindungi atau menjadi permainan. Tapi kebanyakan orang ada di antaranya. Ketegangan itu sekarang menjadi pusat tidak hanya bagi pemain profesional, tetapi bagi siapa saja yang berpartisipasi dalam kehidupan digital.
Saya menjadi dikenal sebagai orang yang meneliti dan bekerja dalam ruang ini, yang membawa saya untuk bekerja dengan pemerintah yang tertarik untuk melindungi orang-orang dari deepfakes, dan perusahaan yang ingin membuat produk pengkloning digital aman untuk digunakan, seperti ElevenLabs. Di Replique, saya membawa semua yang telah saya pelajari kepada orang-orang dan perusahaan yang ingin menggunakan teknologi pengkloning digital atau replika digital secara bertanggung jawab dan aman. Saya pada dasarnya telah mengubah penelitian “langit biru” saya menjadi bisnis konsultasi yang membawa saran hukum khusus ke industri kreatif.
Sebagai Kepala Hukum di OpenOrigins, perusahaan yang berfokus pada membangun catatan yang tidak dapat diubah dari provenance konten untuk melawan deepfakes, bagaimana Anda melihat sistem berbasis provenance bersaing dengan atau menggantikan pendekatan deteksi deepfake tradisional?
Membandingkan alat deteksi deepfake dapat dengan cepat menjadi latihan yang tidak seimbang, karena efektivitasnya tergantung pada konteks dan tujuan. Dari perspektif kebijakan, apa yang kita butuhkan adalah serangkaian alat yang komplementer – tidak ada satu “solusi terbaik”, dan Open Origins adalah salah satu bagian dari ekosistem yang lebih luas. Di mana teknologi OpenOrigins menonjol sebagai solusi deteksi deepfake adalah dalam situasi di mana pembuat konten atau organisasi informasi perlu membuktikan autentisitas konten yang mereka bagikan dengan mitra, audiens, atau masyarakat.
Dengan memberikan provenance yang dapat diverifikasi dan “resi” pada saat pembuatan, ini menawarkan bentuk pencegahan yang kuat dengan membuktikan bahwa konten bukanlah deepfake. Namun, pendekatan ini kurang berguna untuk pengguna internet sehari-hari yang ingin segera menilai konten yang mereka temui secara online. Dalam kasus-kasus tersebut, deteksi lebih bergantung pada metode analisis konten dan probabilistik daripada verifikasi berbasis provenance. Kita membutuhkan alat yang berbeda untuk kebutuhan yang berbeda, dan kita harus menerima bahwa tidak ada peluru perak melawan deepfakes.
Dari perspektif hukum, apa yang saat ini merupakan celah terbesar dalam cara yurisdiksi menangani persetujuan dan kepemilikan dalam konten yang dihasilkan AI atau direplikasi AI?
Oof, berapa lama Anda punya? Jawabannya tergantung pada apa yang kita maksud dengan konten yang dihasilkan AI atau direplikasi AI. Masalah-masalahnya bervariasi apakah Anda melihat gambar AI yang dihasilkan dari sebuah rumah atau kucing. Atau replikasi digital wajah seseorang atau suaranya. Mari kita tetap pada topik deepfakes dan replika digital, dan jawab pertanyaan Anda dalam konteks ‘pengkloning digital’.
Mengenai persetujuan, masalah intinya adalah bahwa sebagian besar kontrak – baik perjanjian kerja atau ketentuan platform – mengandung klausa yang luas dan samar yang memberikan hak yang luas atas konten pengguna. Ini dapat diartikan sebagai bentuk “persetujuan belakang” di mana menyetujui ketentuan mungkin dianggap sebagai persetujuan untuk penggunaan seperti pengkloning, meskipun kebanyakan orang akan sangat membantah interpretasi tersebut. Ini menciptakan celah yang signifikan antara interpretasi hukum dan harapan pengguna, yang saat ini menguntungkan perusahaan sementara regulasi tertinggal.
Mengenai kepemilikan, tidak ada jawaban hukum yang jelas tentang siapa yang memiliki replika digital, karena kerangka kerja yang ada seperti perlindungan data, hak cipta, dan hak kepribadian tidak dirancang untuk teknologi ini. Hari ini, kebanyakan orang dipindai dan dikloning di tempat kerja, atas permintaan dan dengan pembiayaan dari majikan atau klien. Dan entitas-entitas tersebut biasanya mengharapkan kontrol yang tinggi atas aset tersebut, yang dapat dimengerti tetapi sering bermasalah karena aset tersebut adalah tiruan digital dari wajah atau suara Anda, dan dapat membuat Anda mengatakan hal-hal yang tidak pernah Anda katakan, atau melakukan hal-hal yang tidak pernah Anda lakukan.
Pertanyaan tentang “siapa yang memiliki klona Anda?” sangat penting, tetapi belum terjawab dalam hukum saat ini.
Anda telah bekerja erat pada teknologi pengkloning suara. Apa yang paling tidak dipahami tentang risiko hukum ketika datang ke suara sintetis, baik untuk perusahaan maupun individu?
Masalah yang paling tidak dipahami dalam kepatuhan hukum adalah keseimbangan antara kepentingan komersial perusahaan dalam mendanai dan mengeksploitasi replika digital, dan hak individu atas privasi dan martabat digital. Ketegangan ini berada di seluruh rezim hukum (terutama hak cipta, perlindungan data, dan privasi) yang tidak pernah dirancang untuk beroperasi bersama dan menafsirkan pengkloning dengan cara yang sangat berbeda. Sebagai hasilnya, menerjemahkan ini menjadi praktik yang dapat diterapkan dan ramah bisnis sangat kompleks dan sering tidak jelas. Perusahaan oleh karena itu baik mengabaikan risiko kunci atau mengeluarkan biaya yang signifikan untuk menavigasi mereka dengan benar. Ini menciptakan hasil yang tidak masuk akal di mana kepatuhan yang bertanggung jawab menjadi jalur yang lebih sulit dan lebih mahal, daripada jalur default.
Bagaimana perusahaan harus memikirkan arsitektur persetujuan dalam sistem AI, terutama ketika menangani kesamaan, identitas, dan data pelatihan?
Perusahaan harus merancang sistem mereka di sekitar tiga kemampuan inti. Pertama, mereka perlu memastikan persetujuan yang terinformasi dan kontekstual pada saat pendaftaran. Kedua, mereka harus membuatnya mudah bagi pengguna untuk menarik persetujuan tersebut dan menghapus beberapa atau semua data mereka, sesuatu yang secara teknis menantang dan sering diabaikan, tetapi penting untuk kepatuhan dengan hukum seperti GDPR Inggris dan UE dan rezim serupa di AS. Memelihara persetujuan dari waktu ke waktu berarti membangun sistem di mana penarikan adalah operasional yang mulus dan sejalan dengan model bisnis.
Persetujuan harus bersifat granular. Dan ketiga, pengguna harus dapat mengelola izin pada tingkat file individual, memperbarui data kesamaan mereka, dan memahami bagaimana data tersebut digunakan. Ini memerlukan transparansi dan kontrol – alat yang memungkinkan pengguna untuk memantau, meninjau, dan memoderasi bagaimana replika digital mereka diterapkan. Tingkat fleksibilitas ini masih jarang, tetapi ini adalah tempat di mana keunggulan kompetitif semakin terletak.
Dalam pengalaman Anda sebagai penasihat baik untuk perusahaan rintisan maupun pemerintah, di mana letak disconnect terbesar antara bagaimana AI dibangun dan bagaimana AI diatur?
Disconnect antara bagaimana AI dibangun dan bagaimana AI diatur terletak pada misi yang berbeda secara fundamental. Pemerintah mengatur dalam kepentingan publik, sementara perusahaan AI (sering didukung oleh ventura) didorong oleh pertumbuhan, pendapatan, dan keuntungan. Prioritas-prioritas tersebut tidak selalu bertentangan, tetapi sering menarik ke arah yang berbeda, dengan regulasi dianggap sebagai kendala daripada dukungan.
Ini menciptakan ketegangan struktural: regulator dan inovator beroperasi dengan insentif, nilai, dan bahasa yang berbeda. Ini membuat keselarasan sulit dalam praktiknya, bahkan jika itu tidak mustahil. Kami mulai melihat gelombang baru perusahaan teknologi yang lebih sejalan dengan tujuan kepentingan publik, tetapi mereka tetap pengecualian daripada aturan – terutama di antara mereka yang berhasil menskala.
OpenOrigins berfokus pada memverifikasi konten pada saat pembuatan menggunakan provenance kriptografis. Seberapa kritis pendekatan origin-first ini dibandingkan dengan pengamanan pasca-distribusi?
Ini kembali ke jawaban saya sebelumnya. Mengotentikasi konten pada saat pembuatan, ‘hulu’ jauh lebih efektif daripada mencoba memverifikasi konten pada saat distribusi atau konsumsi, yaitu ‘hilir’. Mengotentikasi konten pada saat pembuatan seperti melacak makanan dari saat itu ditanam di pertanian, bukan mencoba menebaknya dari apa yang ada di piring Anda. Jika Anda tahu dari mana ayam itu dipelihara, bagaimana itu ditangani, dan bagaimana itu bergerak melalui rantai pasokan, Anda dapat mempercayai apa yang Anda makan. Jika Anda sebaliknya mencoba menyimpulkan semua itu hanya dengan melihat hidangan yang sudah jadi, Anda bergantung pada tebakan. Ini sama dengan membedakan antara konten yang dibuat manusia dan konten yang dihasilkan AI secara online: provenance pada sumber memberikan Anda jaminan yang dapat diverifikasi, sementara deteksi hilir secara inheren lebih tidak pasti dan reaktif.
Apa peran yang Anda lihat standar seperti C2PA memainkan dalam masa depan media, dan apakah mereka cukup sendiri untuk memulihkan kepercayaan online?
C2PA adalah inisiatif yang disambut, dan dalam banyak cara mendukung gerakan yang sama untuk autentisitas konten seperti OpenOrigins. Mereka adalah bagian penting dari ekosistem keamanan konten dan autentisitas konten. Seperti dengan setiap alat keamanan siber, tidak ada peluru perak.
Bagi kreator dan bakat di industri seperti film, musik, dan permainan, apa langkah-langkah praktis yang harus mereka ambil hari ini untuk melindungi diri dari replikasi digital tidak sah?
Seni hari ini menghadapi dua risiko yang berbeda: replikasi karya mereka (seperti musik, gambar, atau tulisan) dan replikasi kesamaan mereka, termasuk wajah, suara, dan tubuh mereka. Dengan sedikit input, sistem AI sekarang dapat mereproduksi keduanya dengan tingkat kesamaan yang tinggi. Secara praktis, perlindungan dimulai dengan menjadi sengaja tentang apa yang Anda bagikan secara online, mengakui bahwa konten apa pun yang diposting dapat diambil dan digunakan dalam kumpulan data pelatihan, sering tanpa persetujuan yang jelas atau visibilitas.
Risiko itu sekarang merupakan kenyataan dasar dari beroperasi secara online. Tapi risiko yang lebih langsung dan terkendali sering terletak pada kontrak. Perjanjian yang dibuat oleh seniman dengan kolaborator, distributor, atau platform mereka mungkin berisi klausa yang memungkinkan penggunaan AI, penggunaan kembali, atau penjualan kembali konten untuk keperluan pelatihan – sering tanpa partisipasi yang signifikan dalam pendapatan hilir.
Bagi seniman, ini membuat pemeriksaan kontrak sangat kritis. Memahami bagaimana karya dan kesamaan mereka dapat digunakan, dilisensikan, atau digunakan kembali sangat penting sekarang. Banyak debat saat ini (di seluruh serikat, badan industri, dan platform) berfokus pada memperbaiki ketidakseimbangan ini dan memastikan kreator mempertahankan kontrol dan kompensasi yang adil.
Jadi dua potong saran: berhati-hati dengan apa yang Anda bagikan secara online, dan baca kontrak Anda dan cari klausa AI sebelum Anda menandatangani.
Menghadap ke depan tiga hingga lima tahun, apakah Anda percaya kita akan mencapai titik di mana setiap potongan konten digital harus membawa provenance yang dapat diverifikasi, atau apakah kepercayaan akan tetap terfragmentasi di seluruh platform dan yurisdiksi?
Saya ingin mengatakan ya, tetapi secara realistis, tidak – tidak dalam lima tahun. Dalam teknologi, lima tahun terasa lama; dalam hal mengubah perilaku dan kebiasaan pengguna, itu sangat singkat. Kebanyakan konsumen tidak mungkin membuat keputusan mereka berdasarkan apakah konten datang dengan provenance yang diverifikasi. Platform cenderung mengikuti permintaan pengguna, mengoptimalkan untuk keterlibatan daripada provenance.
Ini bisa berubah jika regulasi campur tangan. Kami sudah melihat langkah-langkah awal di tempat-tempat seperti California, di mana persyaratan pelabelan dan moderasi muncul, tetapi menskalakan ini secara global akan memakan waktu – mungkin lebih dekat ke satu dekade daripada lima tahun.
Area perubahan lainnya adalah spesifik sektor: industri seperti jurnalisme, keuangan, asuransi, dan perawatan kesehatan mungkin mulai memerlukan provenance dan autentikasi karena kepercayaan sangat penting bagi operasi mereka.
Terakhir, konsumen mungkin tidak peduli dengan informasi provenance dalam jangka pendek, tetapi mereka kemungkinan akan menghargai kualitas konten, dan kualitas informasi. Jika konten yang dihasilkan AI menjadi terlalu homogen atau “tumpul”, audiens mungkin mulai menghargai konten yang dibuat manusia secara eksplisit. Ini bisa mengarah ke segmentasi pasar, dengan beberapa platform memprioritaskan skala dan konten yang dihasilkan AI, dan yang lain mengkurasi untuk autentisitas, provenance, dan bahan yang dipimpin manusia dengan kepercayaan tinggi – tapi pergeseran itu tetap tidak diketahui.
Terima kasih atas jawaban Anda yang luar biasa, pembaca yang ingin mempelajari lebih lanjut harus mengunjungi OpenOrigins.


