
Sudut Anderson
Disney Menggabungkan CGI dengan Rendering Neural untuk Menangani ‘Uncanny Valley’

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
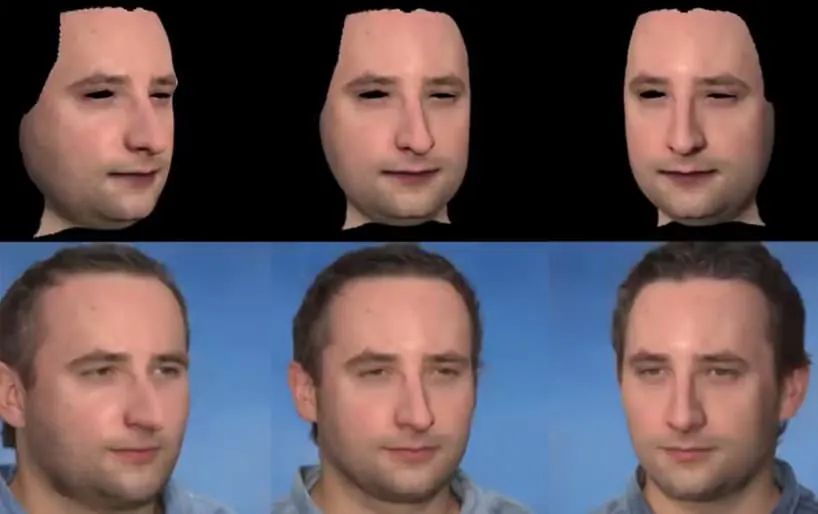
Divisi riset AI Disney telah mengembangkan metode hibrida untuk simulasi wajah berkualitas film, menggabungkan keunggulan neural rendering wajah dengan konsistensi pendekatan berbasis CGI.
Makalah yang sedang dipersiapkan berjudul Rendering with Style: Combining Traditional and Neural Approaches for High Quality Face Rendering, dan dipratinjau dalam video baru berdurasi 10 menit di saluran YouTube Disney Research (tersemat di akhir artikel ini*).
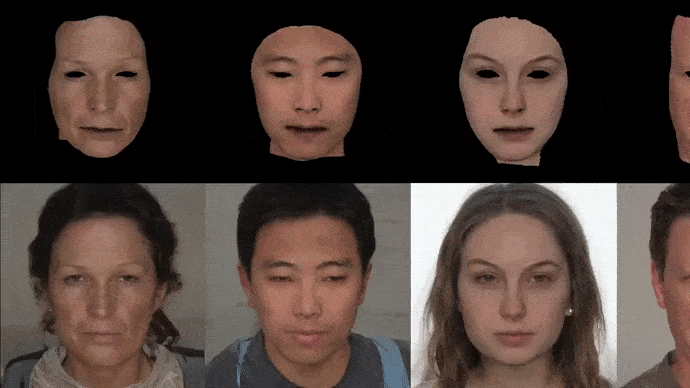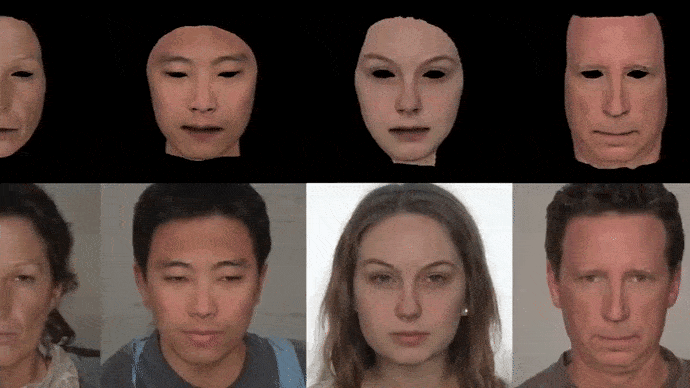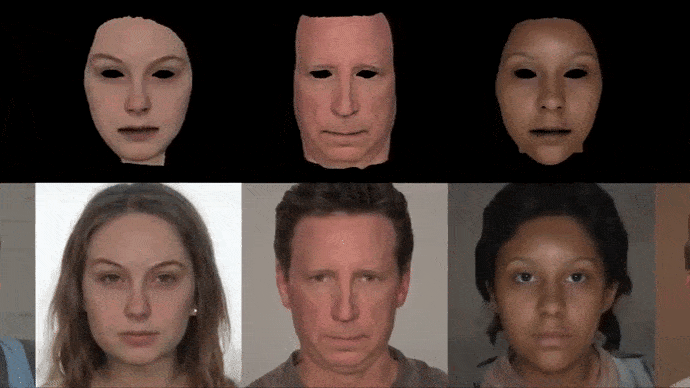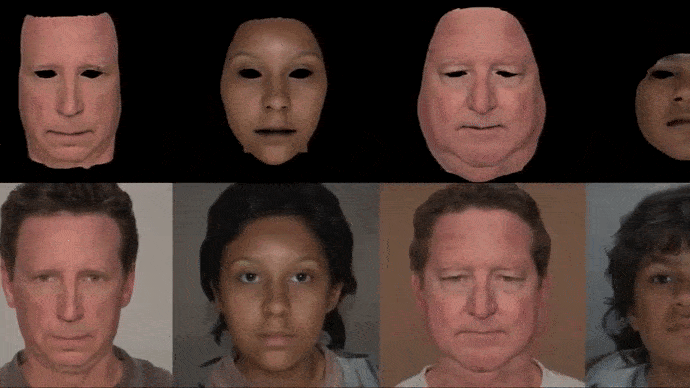
Mesh yang digabungkan dengan render wajah neural. Lihat video tersemat di akhir artikel untuk detail dan kualitas yang lebih baik. Sumber: https://www.youtube.com/watch?v=TwpLqTmvqVk
Seperti yang dicatat dalam video, rendering neural wajah (termasuk deepfake) dapat menghasilkan mata dan interior mulut yang jauh lebih realistis dibandingkan yang dapat dicapai CGI, sementara tekstur wajah berbasis CGI lebih konsisten dan cocok untuk output VFX tingkat bioskop.
Oleh karena itu Disney sedang bereksperimen dengan membiarkan generator neural NVIDIA StyleGan2 menangani fitur-fitur sekitar wajah dan elemen ‘penting untuk kehidupan’ seperti mata, sambil menumpangkan kulit wajah CGI yang konsisten dan elemen terkait ke dalam output.

Dari video (lihat akhir artikel), konsep arsitektural di balik pendekatan hibrida Disney, di mana mesh CGI klasik, jenis yang digunakan untuk merekonstruksi ‘muda’ Carrie Fisher dan almarhum Peter Cushing untuk Rogue One (2016), diintegrasikan ke dalam lingkungan wajah yang dirender secara neural.
Video tersebut secara implisit merujuk pada kritik sering terhadap ketidakotentikan dan efek ‘lembah aneh’ dari rekreasi CGI almarhum aktor Inggris Star Wars Peter Cushing dalam Rogue One (2016), dengan mengakui:
‘[Masih] ada jurang besar antara apa yang orang dapat dengan mudah tangkap dan render dibandingkan dengan duplikat digital fotorealistik akhir, lengkap dengan rambut, mata, dan bagian dalam mulut. Untuk menutup jurang ini, biasanya diperlukan banyak kerja manual dari seniman terampil.’
Pada kenyataannya, bahkan sistem penangkapan wajah paling modern sekalipun tidak berusaha merekonstruksi mata, interior mulut, atau rambut, yang masing-masing memiliki masalah keotentikan dalam teknik tersebut (mata) atau konsistensi temporal (rambut).

Video tersebut menggambarkan apa yang akan didapatkan artis VFX setelah sesi penangkapan wajah modern yang tipikal. Mata, rambut, janggut, dan interior mulut semuanya harus ditangani oleh tim terpisah dalam alur produksi, selain tekstur dan pencahayaan.
Kontrol Pencahayaan
Pendekatan hibrida juga memberikan keuntungan dalam relighting – tantangan signifikan bagi neural rendering wajah, karena penumpukan kulit CGI dapat lebih mudah direlighting.
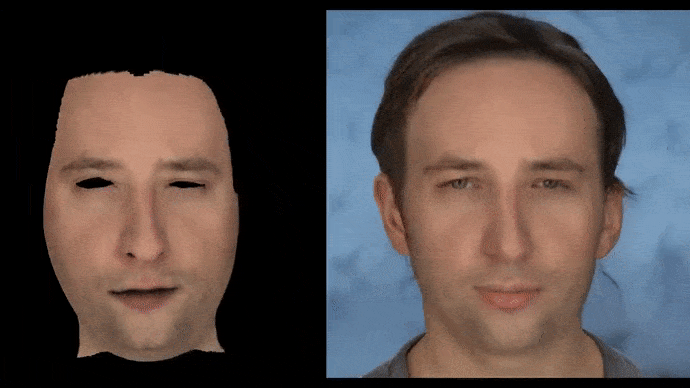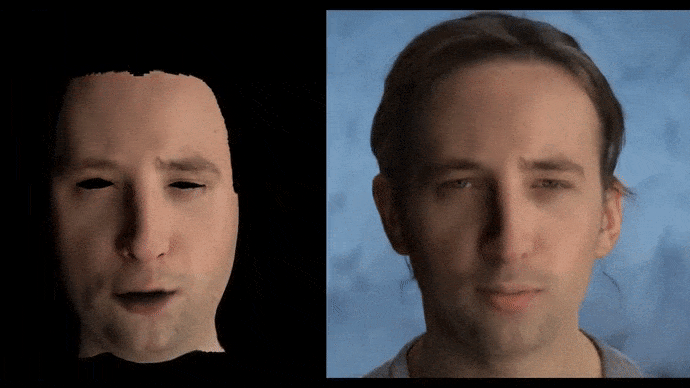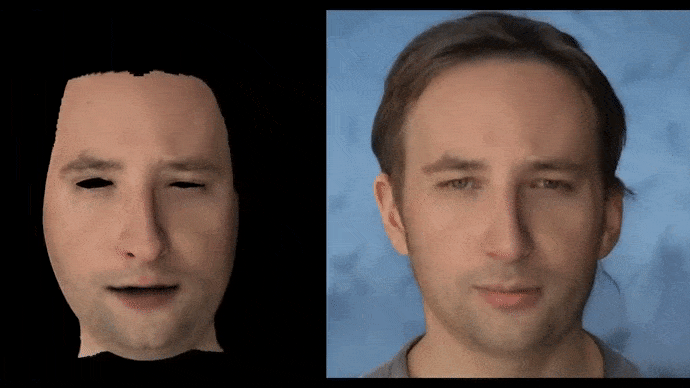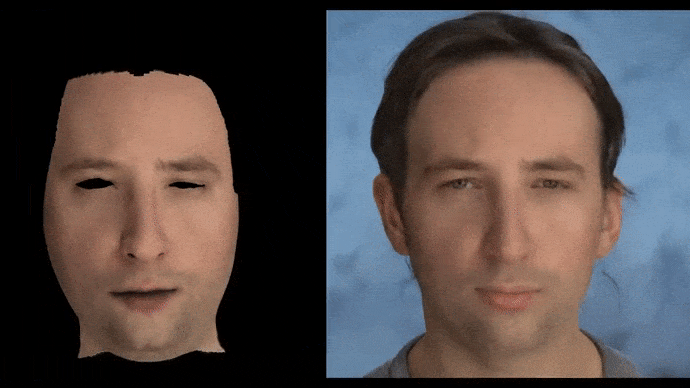
Versi animasi dari pendekatan CGI/Neural.
Dalam lingkungan yang lebih menantang, seperti pemotretan di luar ruangan, para peneliti telah mengembangkan metode inpainting di sekitar semacam zona demiliterisasi yang mengelilingi orang yang ‘dibuat’.

Margin hitam dihasilkan untuk menyediakan ‘kanvas’ bagi inpainting bagian luar identitas dan mengintegrasikan kulit CGI ke dalam output gabungan CGI/neural.
Catatan video:
‘[Neural render] tidak sepenuhnya cocok dengan batas latar belakang. – ini hanya dimaksudkan sebagai panduan, karena mengoptimalkan komponen manusia realistis seperti rambut, mata, dan gigi adalah tujuan utama. Lebih menantang adalah mencoba mempertahankan identitas yang konsisten, sambil mengubah pencahayaan lingkungan.’
Membuat Mesh CGI Dari Render Neural
Tim peneliti juga telah mengembangkan variational autoencoder yang dilatih pada basis data besar (tidak disebutkan) gambar wajah 3D, dan mengklaim dapat menghasilkan mesh wajah 3D yang ‘acak namun masuk akal’ dari data ground truth.
Ada keterbatasan yang harus diatasi dalam riset ini, termasuk kesulitan menjaga rambut tetap konsisten secara temporal dalam render neural, dan video (lihat di bawah) menunjukkan beberapa contoh rambut yang berubah cepat dalam gerakan pan yang konsisten di sekitar wajah CGI/neural.
Konsistensi temporal dalam rendering video neural merupakan masalah yang jauh lebih luas daripada hanya Disney, dan tampaknya iterasi selanjutnya dari sistem ini mungkin akan menambahkan rambut ‘pasca produksi’, atau berbagai pendekatan lain untuk menghasilkan rambut daripada mengandalkan pendekatan neural baru yang pada akhirnya dapat menyelesaikannya.
Penggunaan untuk Generasi Dataset
Metode ini juga diusulkan sebagai cara potensial untuk menghasilkan data sintetis, serta memperkaya lanskap kumpulan gambar wajah, yang dalam beberapa tahun terakhir menjadi monoton berbahaya.

Disney membayangkan teknik baru ini mengisi dataset gambar wajah.
‘[Setiap] hasil fotorealistik yang kami hasilkan memiliki geometri yang bersesuaian dan peta penampilan, dirender dari sudut pandang kamera yang tidak diketahui dengan iluminasi yang diketahui. Informasi ‘ground truth’ ini dapat menjadi penting untuk melatih aplikasi downstream, seperti rekonstruksi wajah 3D monokular, pengenalan wajah, atau pemahaman adegan. Oleh karena itu setiap render hasil dapat dianggap sebagai sampel data, dan kami dapat menghasilkan banyak variasi dari banyak individu yang berbeda.
‘Selain itu, bahkan untuk satu orang yang dirender dalam satu ekspresi dengan satu sudut pandang dan iluminasi, kami dapat menghasilkan variasi acak dari render foto-realistis dengan mengubah seed randomisasi selama optimisasi.’
Para peneliti mencatat bahwa keberagaman output yang dapat dikonfigurasi ini dapat berguna dalam melatih aplikasi pengenalan wajah, dengan kesimpulan:
‘[Metode] kami dapat memanfaatkan teknologi terkini untuk penangkapan, pemodelan, dan rendering kulit wajah, serta secara otomatis menciptakan render wajah fotorealistik lengkap yang sesuai dengan identitas, ekspresi, dan konfigurasi adegan yang diinginkan. Pendekatan ini memiliki aplikasi dalam rendering wajah untuk film dan hiburan, menghemat tenaga kerja artis manual serta untuk generasi data di berbagai bidang pembelajaran mendalam.’
Untuk melihat lebih dalam tentang pendekatan baru ini, lihat video berdurasi 10 menit yang dirilis hari ini:
* Tautan video asli telah diganti dengan yang tampaknya identik 8 jam setelah artikel ini dipublikasikan. Saya mengubah semua tautan terkait, karena tidak ada jejak video asli.
8:24 GMT+2 – Video diganti, karena saluran YouTube Disney Research menggantinya karena suatu alasan.


