
Wawancara
Ben Koska, Pendiri dan CEO SF Tensor – Seri Wawancara

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
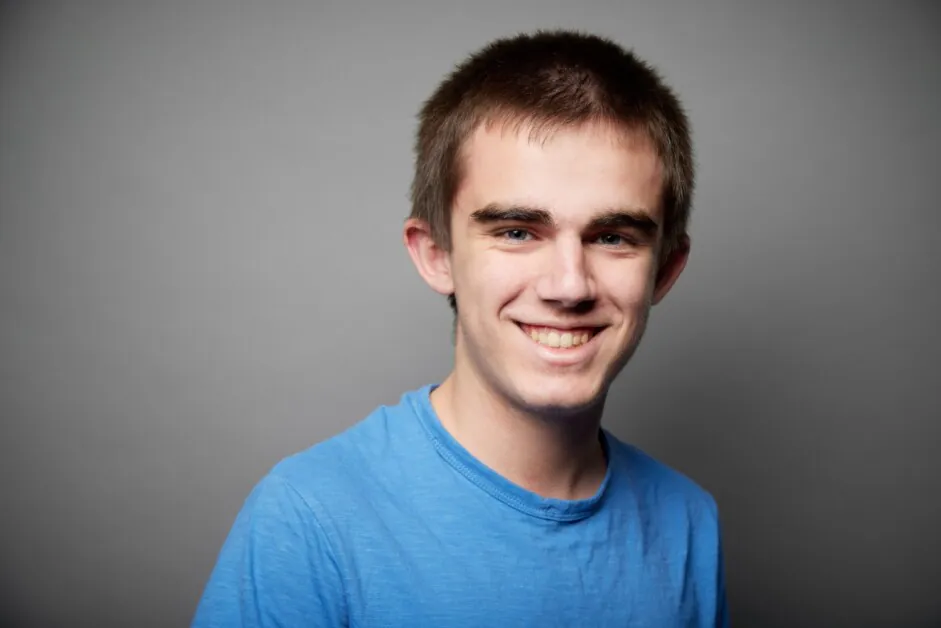
Ben Koska, Pendiri dan CEO SF Tensor, adalah peneliti AI dan insinyur sistem yang dikenal karena karyanya pada komputasi kinerja tinggi, optimasi kernel, dan pelatihan model yang efisien. Latar belakangnya mencakup pengembangan infrastruktur AI tingkat rendah, meningkatkan throughput pelatihan, dan merancang alat yang membuat pengembangan model lanjutan dapat diakses tanpa overhead teknik yang berat. Ia fokus pada membangun sistem yang mendorong batas kecepatan, portabilitas, dan keandalan di seluruh perangkat keras heterogen.
SF Tensor adalah perusahaan yang ia pimpin untuk mewujudkan filosofi tersebut menjadi platform praktis. Ini memperkenalkan model pemrograman terpadu, pengoptimasi kernel, dan lapisan orkestrasi cross-cloud yang dirancang untuk menghilangkan kompleksitas beban kerja AI terdistribusi. Platform ini bertujuan memberikan insinyur lingkungan yang bersih, bebas perangkat keras, di mana mereka dapat menulis sekali, mengirimkan di mana saja, dan secara otomatis mencapai kinerja tinggi. Misi SF Tensor adalah membuat komputasi AI secara dramatis lebih cepat, lebih mudah dikelola, dan bebas dari kunci vendor.
Anda mendirikan SF Tensor pada usia 19 tahun setelah memimpin teknik di beberapa perusahaan rintisan. Apa yang menginspirasi Anda untuk mengambil tantangan mereinventasi infrastruktur AI begitu awal dalam karir Anda?
Masalah yang kami pecahkan adalah salah satu yang saya pedulikan secara mendalam, karena itu adalah masalah yang saya temui sendiri. Ketika kami mengembangkan apa yang sekarang menjadi inti tumpukan SF Tensor, kami tidak bekerja pada proyek komersial, itu sebenarnya adalah upaya akademis. Kami menerima hibah untuk melakukan beberapa penelitian menarik tetapi menghabiskan sebagian besar waktu kami untuk mengurus infrastruktur dan optimasi, bukan melakukan penelitian. Kami menemukan bahwa orang-orang lebih tertarik pada teknologi infrastruktur kami, bukan proyek penelitian kami.
SF Tensor menghadapi salah satu masalah terberat di AI — memutuskan ketergantungan pada CUDA NVIDIA. Bagaimana Anda mendekati perancangan sistem yang dapat mencapai portabilitas perangkat keras yang sebenarnya tanpa mengorbankan kinerja
Pada akhirnya, semua AI berkembang menjadi matematika sederhana. Setiap model pada dasarnya adalah serangkaian operasi matematika yang perlu kita hitung hasilnya. Dengan memperlakukannya terutama sebagai masalah matematika dan tidak sebagai masalah ilmu komputer, kita dapat mengidentifikasi himpunan terkecil konstrain pada perhitungan, lalu menghasilkan jutaan hingga milyaran cara untuk mengubah perhitungan menjadi kode mesin, menemukan yang tercepat. Itu lebih mudah dikatakan daripada dilakukan, karena kita tidak bisa benar-benar menjalankan milyaran program yang berbeda untuk menemukan yang tercepat, jadi untuk memotong ruang pencarian kita, kita harus mengembangkan model matematika yang akurat untuk memperkirakan kecepatan program tertentu untuk perangkat keras tertentu, yang merupakan salah satu inovasi inti yang membuat apa yang kita lakukan hari ini menjadi mungkin.
Blog perusahaan menyoroti inovasi sekitar optimasi compiler dan orkestrasi cross-cloud. Bisakah Anda menjelaskan bagaimana pendekatan SF Tensor berbeda dari kerangka kerja yang ada seperti PyTorch atau JAX?
Kami belum menulis blog teknis tentang hal itu, tetapi kami sebenarnya mendukung kerangka kerja seperti PyTorch dan JAX, memungkinkan kode yang ditulis dalam kerangka kerja tersebut untuk dioptimalkan oleh tumpukan kami. Ada beberapa keputusan arsitektur yang JAX dan PyTorch buat yang membedakannya dari tumpukan kami, tetapi yang paling signifikan adalah bahwa kami memperlakukan seluruh model sebagai satu perhitungan yang harus diselesaikan, bukan modul individual yang harus dioptimalkan secara terpisah dan kemudian bersama-sama. Untuk itu, kami tidak menerapkan teknik optimasi compiler tradisional dan mencoba menerapkan setiap optimasi individual, melainkan kami menciptakan ruang pencarian jutaan hingga milyaran kernel potensial dan membuat klaim bahwa tidak ada manusia yang bisa mengembangkan aturan untuk mengubah kode menjadi yang tercepat, jadi kita harus menciptakan semua kombinasi dan kemudian mengidentifikasi yang tercepat.
Banyak perusahaan rintisan fokus pada efisiensi pelatihan, tetapi Anda menekankan “pajak infrastruktur” — waktu yang hilang peneliti dalam mengelola komputasi bukan berinovasi. Bagaimana SF Tensor menangani ketidakseimbangan ini?
Kami percaya bahwa kedua masalah tersebut harus ditangani, dan banyak pekerjaan kami berfokus pada mengatasi efisiensi pelatihan, tetapi masalah yang paling akut yang bisa kami pecahkan saat ini tanpa bergantung pada inovasi masa depan adalah pajak infrastruktur karena itu adalah masalah yang sudah kami pecahkan untuk diri kami sendiri.
Anda telah menyebutkan pencapaian hingga 80% pengurangan biaya pelatihan. Apa optimasi atau terobosan arsitektur yang membuat hal itu memungkinkan?
Seluruh tumpukan perangkat lunak kami dibangun atas gagasan bahwa compiler berbasis pencarian akan selalu mengalahkan aturan yang dibuat manusia. Sampai sekarang, konstrain terbesar pada compiler tersebut adalah fakta bahwa tidak mungkin untuk melakukan benchmark dan peringkat milyaran atau bahkan jutaan kernel. Oleh karena itu, perlu bagi kami untuk menciptakan model matematika komputasi yang dapat memperkirakan waktu yang dibutuhkan untuk perhitungan tertentu atau serangkaian perhitungan pada perangkat keras tertentu. Dengan melakukan itu, kami dapat memperluas ruang pencarian kami dan kemudian memotongnya, yang merupakan keharusan jika Anda ingin menemukan kernel tercepat secara konsisten.
Bagaimana latar belakang Anda dalam membangun bahasa pemrograman Emma mempengaruhi arsitektur dan filosofi SF Tensor terhadap kinerja dan abstraksi?
Jangan bilang kepada investor saya, tetapi di hati, saya masih seorang insinyur compiler. Saya selalu tertarik untuk menemukan cara membuat hal-hal sedikit lebih cepat. Dalam mengembangkan Emma, kami membuang compiler seluruhnya 4 atau 5 kali; kami memulai dari awal, setiap kali karena kami menemukan optimasi yang tidak bisa kami implementasikan dengan konstrain saat itu, memaksa kami untuk merancang ulang sistem untuk menjadi lebih umum, sambil tetap memungkinkan kami untuk turun ke tingkat optimasi terendah saat diperlukan, sering melawan prinsip-prinsip desain compiler dan bahasa yang umum. Pembelajaran dan arsitektur yang dihasilkan tersebut, yang hampir dua tahun terlihat seperti optimasi kecil dan taruhan yang salah, telah berkompromi menjadi sistem yang memungkinkan kami untuk sekarang berinovasi lebih cepat dan mengoptimalkan lebih baik daripada sistem yang mengikuti prinsip-prinsip umum karena prinsip-prinsip tersebut pada dasarnya dirancang untuk CPU, bukan GPU dan model AI.
Anda telah bekerja pada pelatihan skala besar di lebih dari 4.000 GPU — apa pelajaran terbesar yang dipelajari dari mengelola komputasi pada skala itu?
Salah satu pelajaran besar adalah bahwa kegagalan perangkat keras jauh lebih umum dan jauh lebih bermasalah daripada yang mungkin diasumsikan. Setelah menghabiskan banyak waktu bekerja dengan program tradisional dan compiler, umumnya, komputer melakukan tepat seperti yang diperintahkan, dan jika sesuatu salah, itu hampir selalu kesalahan orang yang menulis kode. Dengan GPU, di sisi lain, kegagalan perangkat keras adalah kejadian umum, terutama dalam pelatihan terdistribusi pada cluster yang sangat besar. Berbarengan dengan itu adalah fakta bahwa tidak seperti CPU yang umumnya bertindak dalam cara yang deterministik dan dapat diprediksi, GPU terkadang tanpa alasan yang jelas melakukan hal-hal seperti menurunkan kecepatan clock, memperlambat seluruh proses pelatihan karena satu chip berjalan lebih lambat.
Y Combinator telah mendukung beberapa perusahaan infrastruktur paling transformatif di teknologi. Bagaimana pengalaman itu membentuk pendekatan Anda dalam menskalakan produk dan visi SF Tensor?
Masuk ke Y Combinator, saya pikir taruhan yang kami inginkan saat itu sudah ambisius. Setelah beberapa minggu, definisi ambisius kami telah berubah drastis, dan kami menggandakan taruhan pada taruhan yang bahkan lebih besar. Selain itu, rasa komunitas dan pembelajaran yang saya dapat mengambil telepon atau mengirim email kepada hampir semua perusahaan atau orang di luar sana dan menerima respons dan saran dalam hitungan jam hingga hari, telah mengubah cara kami memikirkan menangani masalah dan mengadopsi pendekatan yang jauh lebih kolaboratif.
Menghadap ke depan, Anda telah menunjukkan minat pada model non-LLM, robotika, dan data sintetis. Bagaimana area-area tersebut sesuai dengan visi jangka panjang perusahaan?
LLM adalah teknologi yang sangat menarik dan akan memiliki bagian integral dalam bagaimana dunia terlihat di masa depan, tetapi alasan mereka jauh lebih maju daripada area AI lainnya terutama karena ada banyak uang yang diinvestasikan dalam pengembangannya, dan ada cukup banyak orang yang berkolaborasi pada masalah tersebut sehingga mereka telah menjadi cukup dioptimalkan. Jika kita bisa menurunkan hambatan masuk, memungkinkan peneliti di seluruh negara dan planet, bahkan mereka dengan sumber daya terbatas dan pengetahuan yang sangat terbatas tentang optimasi, melakukan penelitian mereka seefisien dan se murah mungkin. Dalam hal itu, saya pikir kita akan melihat generasi baru model yang akan menangani masalah yang LLM tidak cocok untuknya, baik karena mereka berinteraksi dengan dunia fisik atau karena mereka adalah masalah yang tidak dapat diekspresikan dengan baik dalam bahasa.
Apa yang Anda pikir tumpukan infrastruktur AI akan terlihat seperti lima tahun dari sekarang — dan di mana Anda melihat peran SF Tensor di dalamnya?
Lima tahun dari sekarang, saya harap banyak perusahaan akan mengembangkan dan merilis chip khusus mereka sendiri, dan peneliti akan dapat memanfaatkan dan utilize them without needing to write code specifically for them, ideally without even needing to know that they exist. Itu adalah masa depan yang kita kerjakan dan yang saya percaya kita akan memiliki peran penting dalam membentuknya.
Terima kasih atas wawancara yang luar biasa, pembaca yang ingin mempelajari lebih lanjut harus mengunjungi SF Tensor.


