एआई की मूल बातें
आईटी ऑपरेशन्स (ITOps) क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
IT operations (ITOps) वह कार्य है जो संगठन पर निर्भर तकनीकी सेवाओं को चलाता है। यह कंप्यूट, नेटवर्क, पहचान, एंडपॉइंट, क्लाउड प्लेटफ़ॉर्म, डेटाबेस, स्टोरेज, बैकअप और उन संचालन प्रक्रियाओं को शामिल करता है जो इन घटकों को उपलब्ध, सुरक्षित और समर्थन योग्य बनाये रखती हैं।
आधुनिक ITOps केवल डैशबोर्ड देखता नेटवर्क ऑपरेशन्स सेंटर तक सीमित नहीं है। टीमें बढ़ते हुए सॉफ़्टवेयर‑परिभाषित इन्फ्रास्ट्रक्चर, प्लेटफ़ॉर्म सेवाओं, स्वचालन और वितरित स्वामित्व का प्रबंधन करती हैं, जबकि घटनाओं, क्षमता, निरंतरता और सेवा स्तरों की जवाबदेही बनाए रखती हैं।
मुख्य बिंदु
- ITOps ऑन‑प्रेमाइसेस, क्लाउड और एज वातावरण में सेवाओं और उनकी निर्भरताओं का प्रबंधन करता है।
- ऑब्ज़रवेबिलिटी, कॉन्फ़िगरेशन और इन्वेंटरी उन विफलताओं की व्याख्या के लिए आवश्यक संदर्भ प्रदान करती हैं।
- इंसिडेंट मैनेजमेंट सेवा को पुनर्स्थापित करता है; प्रॉब्लम मैनेजमेंट आवर्ती या प्रणालीगत कारणों को संबोधित करता है।
- ITOps, ITSM, SRE, DevOps, SecOps और AIOps के साथ ओवरलैप करता है लेकिन किसी एक के समान नहीं है।
सेवाएँ, संपत्तियाँ और कॉन्फ़िगरेशन
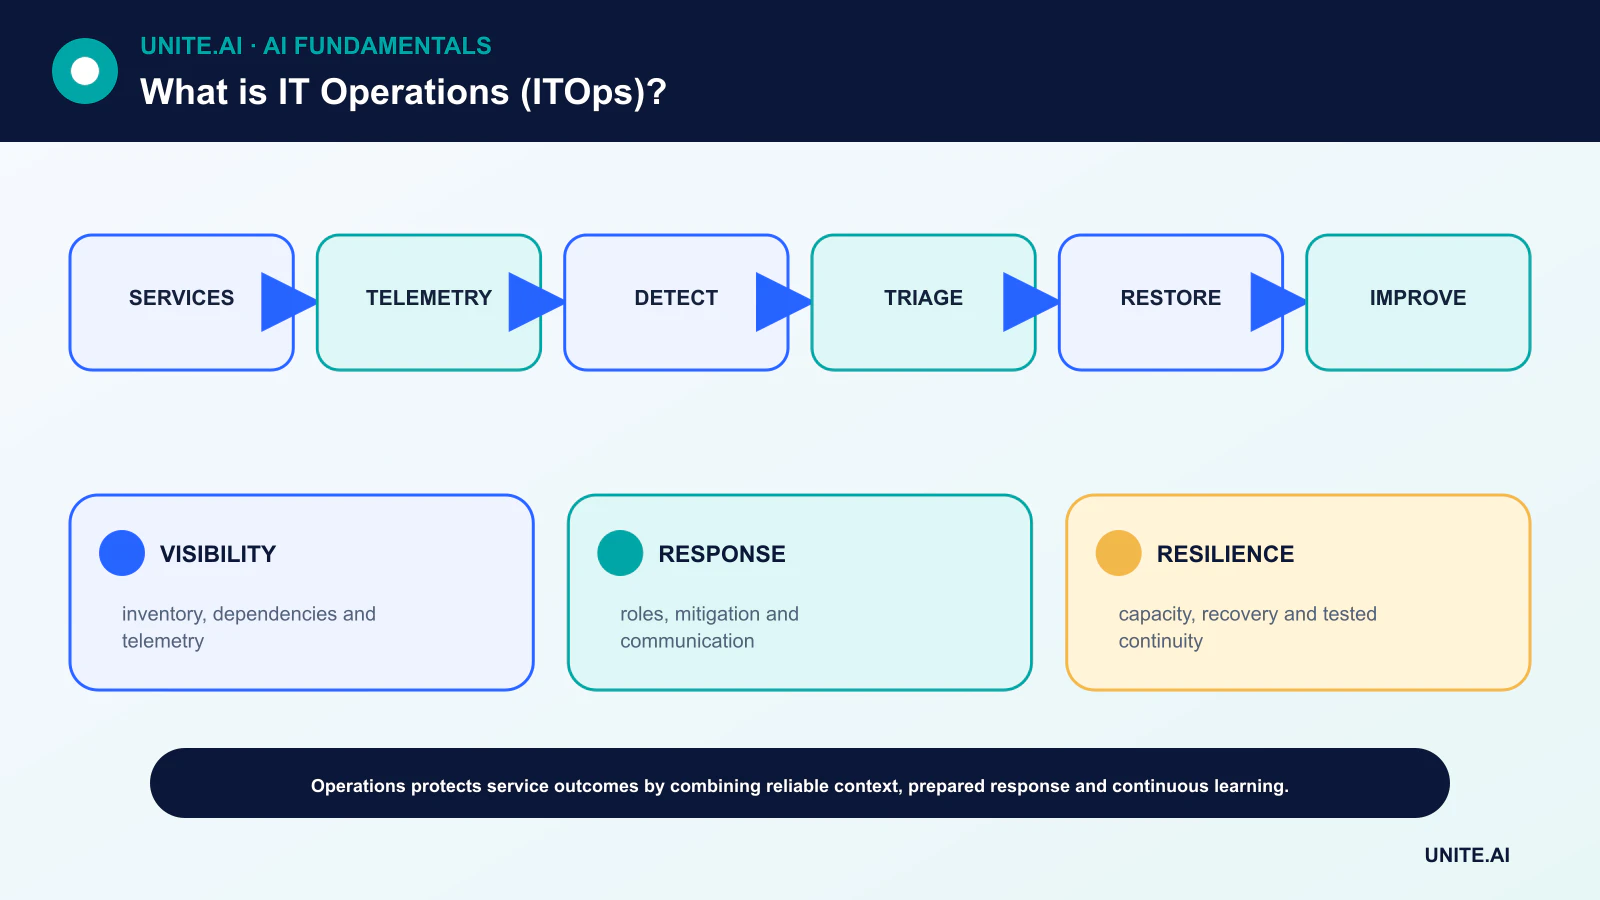
ऑपरेशन्स की शुरुआत यह जानने से होती है कि कौन‑सी सेवाएँ मौजूद हैं, उनका स्वामित्व किसके पास है, कौन‑से उपयोगकर्ता उन पर निर्भर हैं और कौन‑सी इन्फ्रास्ट्रक्चर उनका समर्थन करती है। संपत्ति इन्वेंटरी घटकों को दर्ज करती है; कॉन्फ़िगरेशन मैनेजमेंट संबंधित संबंधों और नियंत्रित स्थिति को रिकॉर्ड करती है।
एक ऐसी इन्वेंटरी जो कभी मिलान नहीं की जाती, भ्रामक बन जाती है। जहाँ उपयोगी हो, खोज को स्वचालित करें, प्राधिकृत स्रोतों की पहचान करें और भरोसे या ताज़गी को रिकॉर्ड करें, बजाय यह मानने के कि हर निर्भरता मानचित्र पूर्ण है।
ऑब्ज़रवेबिलिटी और सेवा उद्देश्यों
मेट्रिक्स व्यवहार को मापते हैं, लॉग घटनाओं को रिकॉर्ड करते हैं और ट्रेस सेवाओं के बीच कार्य को ट्रैक करते हैं। सिंथेटिक चेक उपयोगकर्ता यात्रा का परीक्षण कर सकते हैं। उपयोगी ऑब्ज़रवेबिलिटी प्रश्नों और सेवा उद्देश्यों से शुरू होती है, फिर उत्तर देने के लिए आवश्यक संकेत एकत्र करती है।
अलर्टिंग को उन स्थितियों की पहचान करनी चाहिए जिनके लिए समय पर कार्रवाई आवश्यक है। उपयोगकर्ता प्रभाव के बिना थ्रेशोल्ड शोर पैदा करते हैं, जबकि निर्भरता संदर्भ की कमी निदान को धीमा करती है। AIOps सहसंबंध में मदद कर सकता है, लेकिन इसके लिए विश्वसनीय टेलीमेट्री और संचालन प्रतिक्रिया की आवश्यकता होती है।
इंसिडेंट, प्रॉब्लम और परिवर्तन प्रबंधन
इंसिडेंट मैनेजमेंट पता लगाने, ट्रायेज, शमन, संचार और पुनर्प्राप्ति का समन्वय करता है। स्पष्ट भूमिकाएँ दबाव में भ्रम को कम करती हैं। एक अस्थायी वर्कअराउंड सेवा को पुनर्स्थापित कर सकता है जबकि बाद में प्रॉब्लम जांच गहरी कारणों को संबोधित करती है।
परिवर्तन प्रबंधन जोखिम का मूल्यांकन और रिकॉर्ड करता है बिना प्रत्येक परिवर्तन को कतार में बदले। मानक, स्वचालित और कम‑जोखिम वाले परिवर्तन पूर्व‑स्वीकृत मार्गों का पालन कर सकते हैं; उच्च‑प्रभाव वाले परिवर्तन अधिक साक्ष्य, शेड्यूलिंग और रोलबैक तैयारी की मांग करते हैं।
क्षमता, लचीलापन और निरंतरता
टीमें संसाधन मांग का पूर्वानुमान लगाती हैं, बाधाओं को हटाती हैं और लोड के तहत व्यवहार का परीक्षण करती हैं। बैकअप केवल तभी उपयोगी होते हैं जब पुनर्स्थापना का परीक्षण किया गया हो। रेडंडंसी तभी मदद करती है जब विफलता मोड स्वतंत्र हों और फेलओवर वास्तव में काम करे।
बिज़नेस कंटिन्यूइटी प्राथमिकताओं, रिकवरी टाइम और स्वीकार्य डेटा हानि को परिभाषित करती है। पहचान, DNS, क्लाउड कंट्रोल प्लेन्स और विक्रेताओं पर निर्भरताओं को अभ्यास में शामिल किया जाना चाहिए, न कि उपलब्ध मान कर।
ITOps, ITSM, SRE और DevOps
आईटी सेवा प्रबंधन सेवाओं को संगठनात्मक आवश्यकताओं के साथ संरेखित करने की प्रक्रियाएँ प्रदान करता है। साइट रिलायबिलिटी इंजीनियरिंग (SRE) ऑपरेशन्स में सॉफ़्टवेयर इंजीनियरिंग लागू करती है और सेवा‑स्तर उद्देश्यों तथा एरर बजट का उपयोग करती है। DevOps विकास और ऑपरेशन्स के फीडबैक को जोड़ता है।
SecOps खतरों और प्रतिक्रिया पर केंद्रित है, जबकि ITOps व्यापक सेवा स्वास्थ्य को बनाए रखता है। संगठनात्मक चार्ट अलग होते हैं; महत्वपूर्ण आवश्यकता स्पष्ट स्वामित्व और इन डोमेनों के बीच साझा साक्ष्य है।
ITOps ऑपरेटिंग मॉडल
आईटी ऑपरेशन्स संगठन की तकनीकी सेवाओं को उपलब्ध, प्रदर्शन‑उपयुक्त, सुरक्षित और पुनर्प्राप्ति योग्य बनाये रखता है। दायरा सामान्यतः एंडपॉइंट, पहचान, नेटवर्क, सर्वर, क्लाउड, स्टोरेज, सहयोग, डेटाबेस, मॉनिटरिंग, सर्विस डेस्क, बैकअप और विक्रेता सेवाओं को शामिल करता है। आधुनिक ITOps स्वामित्व वाले इन्फ्रास्ट्रक्चर और प्रबंधित प्लेटफ़ॉर्म दोनों को कवर करता है, इसलिए जब ऑपरेशन आउटसोर्स किया जाता है तब भी ज़िम्मेदारी स्पष्ट होनी चाहिए। एक कॉन्फ़िगरेशन या सेवा इन्वेंटरी तकनीकी घटकों को मालिकों, उपयोगकर्ताओं, निर्भरताओं, डेटा वर्गीकरण और व्यापारिक महत्त्व से जोड़ती है।
सेवा प्रबंधन घटनाओं, अनुरोधों, समस्याओं, परिवर्तनों, संपत्तियों, ज्ञान और सेवा स्तरों को व्यवस्थित करता है। इंसिडेंट मैनेजमेंट सेवा को पुनर्स्थापित करता है; प्रॉब्लम मैनेजमेंट आवर्ती कारणों की जाँच करता है; परिवर्तन सक्षम करना जोखिम का आकलन और समन्वय करता है। प्रत्येक परिवर्तन को धीमी मंजूरी मानना बायपास बनाता है, जबकि अनियंत्रित स्वचालन अनियंत्रित विफलता उत्पन्न करता है। मानक कम‑जोखिम वाले परिवर्तन पूर्व‑स्वीकृत और स्वचालित हो सकते हैं; उच्च‑जोखिम वाले परिवर्तन साक्ष्य, संचार, रोलबैक और प्रभाव के आधार पर शेड्यूलिंग की आवश्यकता रखते हैं।
विश्वसनीयता, क्षमता और निरंतरता
मॉनिटरिंग को केवल डिवाइस गिनती पर नहीं, बल्कि उपयोगकर्ता‑उन्मुख सेवाओं और उनकी निर्भरताओं पर आधारित होना चाहिए। उपलब्धता, लेटेंसी, क्षमता, ताज़गी और समर्थन उद्देश्यों को व्यापार मालिकों के साथ परिभाषित करें। कार्रवाई योग्य लक्षणों और एरर‑बजट उपयोग पर अलर्ट दें; घटनाओं को स्वामित्व और हालिया परिवर्तनों से समृद्ध करें। क्षमता योजना मॉडल मांग, संतृप्ति, लाइसेंस और लीड टाइम को ध्यान में रखते हैं। क्लाउड इलास्टिसिटी प्रोविजनिंग विलंब को कम करती है लेकिन कोटा, क्षेत्रीय सीमाएँ या लागत नियंत्रण को समाप्त नहीं करती।
बिज़नेस कंटिन्यूइटी के लिए परीक्षण किए गए बैकअप, पुनर्स्थापना, पहचान पुनर्प्राप्ति, नेटवर्क विकल्प, विक्रेता संपर्क और मैन्युअल प्रक्रियाएँ आवश्यक हैं। प्रत्येक सेवा के लिए रिकवरी‑टाइम और रिकवरी‑पॉइंट उद्देश्यों को परिभाषित करें। बैकअप तब तक पुनर्प्राप्ति का प्रमाण नहीं है जब तक उसे पुनर्स्थापित और सत्यापित नहीं किया गया हो। रैनसमवेयर, क्षेत्रीय नुकसान, समाप्त प्रमाणपत्र, पहचान आउटेज और सप्लायर विफलता का अभ्यास करें। जहाँ संभव हो, कॉन्फ़िगरेशन और इन्फ्रास्ट्रक्चर को कोड के रूप में ट्रैक करें ताकि पुनर्प्राप्ति पुनरुत्पादित हो सके।
सुरक्षा, स्वचालन और मीट्रिक्स
न्यूनतम विशेषाधिकार, पैच और कमजोरियों का प्रबंधन, एंडपॉइंट नियंत्रण, नेटवर्क विभाजन, लॉगिंग और इंसिडेंट रिस्पॉन्स का उपयोग करें। दोहराव वाले कार्यों को आइडेम्पोटेंट, सीमाएँ, अनुमोदन और ऑडिट के साथ स्वचालित करें। सेवा उपलब्धता, घटना पुनरावृत्ति, अनुरोध पूर्ति, परिवर्तन विफलता, पुनर्प्राप्ति, पैच एक्सपोज़र, क्षमता, लागत और उपयोगकर्ता संतुष्टि को मापें—केवल टिकट बंद होने से नहीं। ITOps सफल तब होता है जब तकनीक कार्य को पूर्वानुमानित रूप से समर्थन करती है और विफलता से पुनर्प्राप्त हो सकती है, न कि जब इन्फ्रास्ट्रक्चर व्यस्त दिखे या डैशबोर्ड में अधिक हरे संकेत हों।
व्यावहारिक उदाहरण: सहयोग सेवा की पुनर्प्राप्ति
एक कंपनी सहयोग प्लेटफ़ॉर्म के लिए चार‑घंटे का रिकवरी‑टाइम उद्देश्य और एक‑घंटे का रिकवरी‑पॉइंट उद्देश्य निर्धारित करती है। वह पहचान, DNS, नेटवर्क, डेटा, कुंजियाँ, कॉन्फ़िगरेशन, इंटीग्रेशन और विक्रेता निर्भरताओं की इन्वेंटरी बनाती है। एक रिकवरी अभ्यास मानता है कि प्राथमिक क्षेत्र और एडमिन अकाउंट उपलब्ध नहीं हैं। ऑपरेटर एक स्वतंत्र रूप से संरक्षित इमरजेंसी पहचान को सक्रिय करते हैं, सेवा कॉन्फ़िगरेशन और डेटा को एक अलग किए गए क्षेत्र में पुनर्स्थापित करते हैं, और अनुमतियों, संदेशों, इंटीग्रेशन और क्लाइंट एक्सेस को मान्य करते हैं। व्यवसाय मालिक वास्तविक उपयोगकर्ता यात्राओं के साथ पुनर्स्थापित सेवा की पुष्टि करते हैं, न कि केवल इन्फ्रास्ट्रक्चर स्वास्थ्य जांच पर निर्भर रहते हैं।
अभ्यास वास्तविक डेटा हानि, बीता समय, मैन्युअल चरण, विफल संपर्क और छिपी निर्भरताओं को रिकॉर्ड करता है। एक बैकअप जो फ़ाइलें पुनर्स्थापित करता है लेकिन एन्क्रिप्शन कुंजियाँ या पहचान नीति नहीं, उसे अधूरा माना जाता है। सुधारात्मक कार्यों को मालिक और तिथियों के साथ सौंपा जाता है, और रनबुक को अपडेट करके पुनः परीक्षण किया जाता है। मॉनिटरिंग और संचार टेम्प्लेट शामिल किए जाते हैं। संगठन रिकवरी साक्ष्य को बैकअप जॉब की सफलता की बजाय मापता है, यह मानते हुए कि भरोसेमंद ITOps को वास्तविक विफलता स्थितियों में उपयोगकर्ताओं को आवश्यक सेवा पुनर्स्थापित करनी चाहिए।
कार्यान्वयन साक्ष्य और संचालन तत्परता
एक प्रोडक्शन निर्णय को सफल डेमॉन्स्ट्रेशन से अधिक चाहिए। इच्छित उपयोगकर्ताओं, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताओं, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादित बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या पर्यावरणों का परीक्षण करें जो सबसे अधिक सेवा‑हीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनरुत्पादित कर सके और साक्ष्य को आकर्षक प्रोटोटाइप से अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार सौंपें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर इंजेक्ट किए गए विफलताओं के साथ मॉनिटरिंग सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व साक्ष्य की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को बना रहने मानें। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर या उद्देश्यों में परिवर्तन हो, पुनः‑मूल्यांकन करें। एक रखरखाव किया गया सिस्टम दस्तावेज़ीकृत रिकवरी, घटना सीखना, हटाने और रख‑रखाव प्रक्रियाओं, तथा एक स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
ITOps का मुख्य लक्ष्य क्या है?
सहमति वाले सुरक्षा, प्रदर्शन, निरंतरता और लागत प्रतिबंधों के भीतर भरोसेमंद तकनीकी सेवाओं को प्रदान करना और पुनर्स्थापित करना।
क्या क्लाउड इन्फ्रास्ट्रक्चर पूरी तरह से क्लाउड प्रदाता द्वारा संचालित होता है?
नहीं। प्रदाता आधारभूत प्लेटफ़ॉर्म के कुछ हिस्सों को संचालित करते हैं, जबकि ग्राहक कॉन्फ़िगरेशन, पहचान, डेटा, वर्कलोड, मॉनिटरिंग और कई सेवा‑स्तर निर्णयों के लिए जिम्मेदार रहते हैं।
प्राथमिक संदर्भ