
एआई की मूल बातें
डेटा फैब्रिक क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
A डेटा फैब्रिक एक वास्तुशिल्प पैटर्न है जो वितरित प्रणालियों में डेटा की खोज, कनेक्शन, शासन और डिलीवरी के लिए उपयोग किया जाता है। यह एक साझा मेटाडाटा और नियंत्रण परत प्रदान करता है जिससे लोग और अनुप्रयोग भरोसेमंद डेटा खोज सकें, बिना प्रत्येक डेटासेट को एक ही भौतिक स्टोर में बाध्य किए।
डेटा फैब्रिक कोई एकल उत्पाद नहीं है और यह स्रोत‑प्रणाली के अंतर को मिटाता नहीं है। इसका मूल्य सटीक मेटाडाटा, स्पष्ट स्वामित्व, लागू करने योग्य नीति, विश्वसनीय एकीकरण और यह प्रमाण पर निर्भर करता है कि उपभोक्ता अपने उद्देश्य के अनुरूप डेटा प्राप्त करें।
मुख्य बिंदु
- समृद्ध मेटाडाटा वाला नियंत्रण प्लेन कैटलॉग, लाइनिएज, गुणवत्ता, नीति और पहुँच को जोड़ता है।
- डेटा वितरित रह सकता है और कार्यभार के अनुसार कॉपी, स्ट्रीम, रूपांतरित या वर्चुअल किया जा सकता है।
- डेटा फैब्रिक प्रौद्योगिकी‑उन्मुख है; डेटा मेष डोमेन स्वामित्व और डेटा‑एज़‑ए‑प्रोडक्ट पर ज़ोर देता है।
- स्वचालन शासन को स्केल करने में मदद करता है, परन्तु उत्तरदायी मालिक अभी भी अर्थ, गुणवत्ता और अनुमत उपयोग को परिभाषित करते हैं।
नियंत्रण प्लेन और डेटा प्लेन
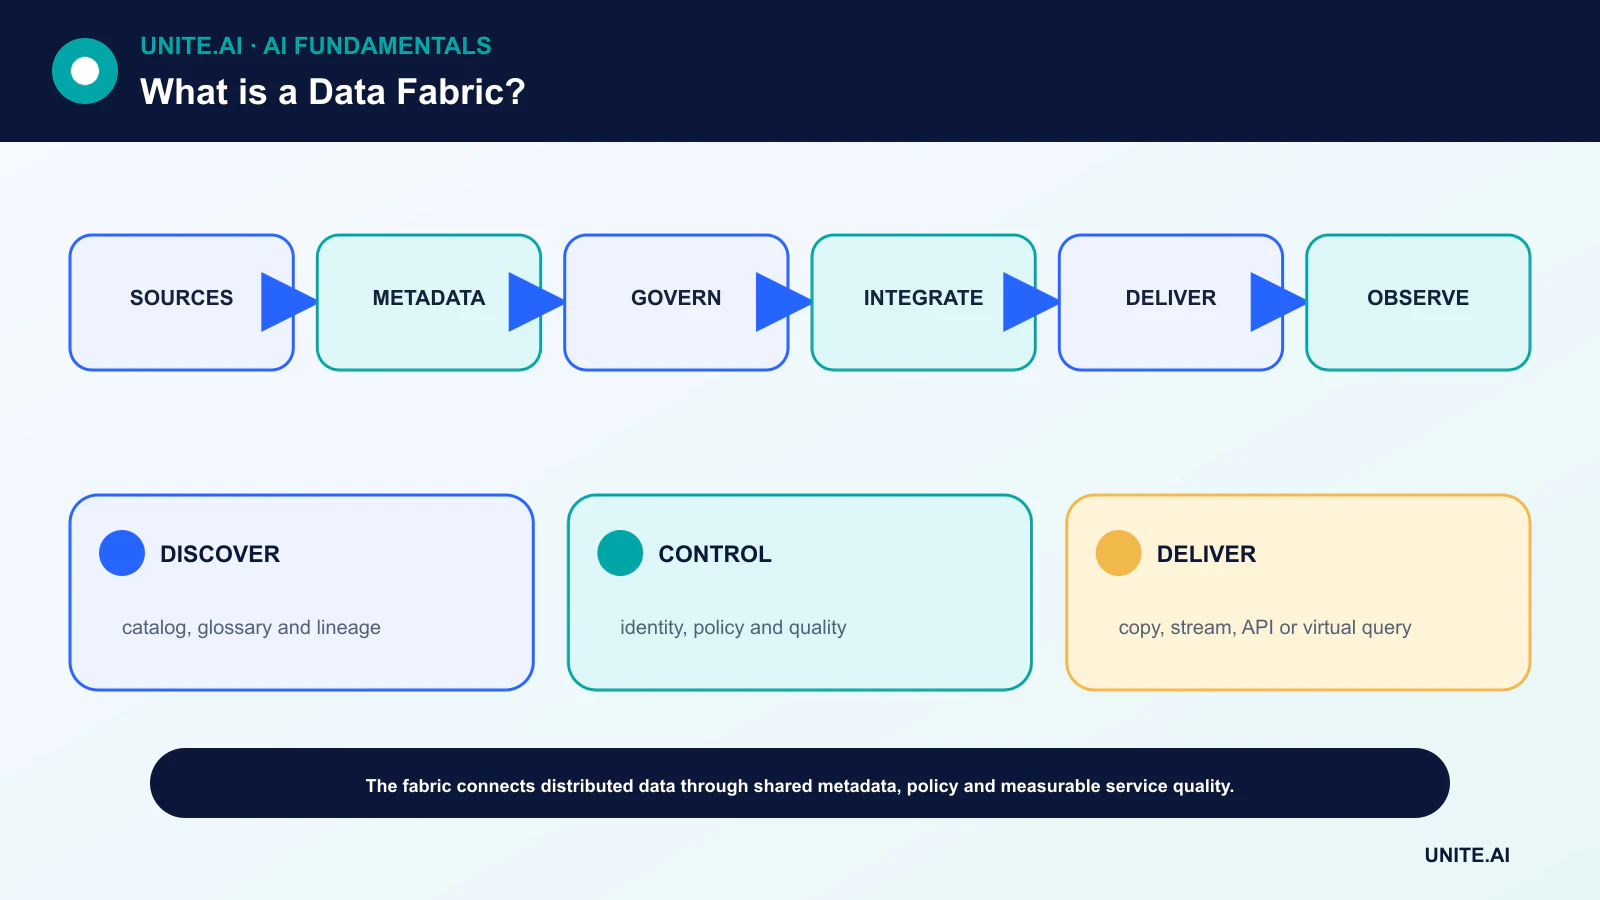
डेटा प्लेन में डेटाबेस, फ़ाइलें, स्ट्रीम, API और उन पाइपलाइन शामिल हैं जो उन्हें स्थानांतरित या क्वेरी करती हैं। नियंत्रण प्लेन तकनीकी और व्यावसायिक मेटाडाटा रिकॉर्ड करता है: स्कीमा, मालिक, वर्गीकरण, गुणवत्ता माप, लाइनिएज, नीतियां और उपयोग।
एक कैटलॉग या नॉलेज ग्राफ इन तथ्यों को जोड़ सकता है जिससे उपभोक्ता डेटासेट की खोज कर सके और उसके संदर्भ को समझ सके। फिर फैब्रिक मेटाडाटा का उपयोग करके पहुँच, रूपांतरण, अवलोकनशीलता और विभिन्न प्लेटफ़ॉर्म पर नीति प्रवर्तन को निर्देशित करता है।
एक अनिवार्य स्टोर के बिना एकीकरण
कुछ कार्यभार डेटा को ETL के माध्यम से कॉपी करते हैं; अन्य परिवर्तन‑डेटा कैप्चर, इवेंट स्ट्रीम, API या क्वेरी वर्चुअलाइज़ेशन का उपयोग करते हैं। सही पैटर्न ताज़गी, प्रदर्शन, संगतता, संप्रभुता, लागत और स्रोत‑प्रणाली की सीमाओं पर निर्भर करता है।
वर्चुअल पहुँच प्रतिलिपि को कम कर सकती है, परन्तु उपभोक्ताओं को स्रोत की विलंबता और उपलब्धता के जोखिम में डाल सकती है। भौतिक सामग्रीकरण प्रदर्शन और पुनरुत्पादनशीलता को बढ़ाता है, परन्तु समकालिकता और जीवन‑चक्र की जिम्मेदारियां उत्पन्न करता है।
शासन, अर्थविज्ञान और गुणवत्ता
एक व्यावसायिक शब्दकोश ग्राहक, ऑर्डर या सक्रिय खाता जैसे शब्दों को साझा अर्थ प्रदान करता है। लाइनिएज दिखाता है कि किसी फ़ील्ड की उत्पत्ति कहाँ हुई और वह कैसे बदला। वर्गीकरण और नीति निर्धारित करती है कि कौन संवेदनशील रिकॉर्ड तक पहुँच सकता है और किस उद्देश्य से।
गुणवत्ता नियमों को विशिष्ट उपयोग मामलों से जोड़ा जाना चाहिए। डैशबोर्ड के लिए पर्याप्त पूर्णता स्वचालित निर्णयों के लिए असुरक्षित हो सकती है। एक फैब्रिक को ताज़गी, सत्यापन इतिहास और ज्ञात सीमाओं को उजागर करना चाहिए, न कि केवल किसी संपत्ति को प्रमाणित के रूप में लेबल करना।
डेटा फैब्रिक, मेष और लेकहाउस
डेटा मेष एक सामाजिक‑तकनीकी दृष्टिकोण है जो डोमेन टीमों को इंटरऑपरेबल डेटा उत्पादों की जिम्मेदारी देता है। डेटा फैब्रिक साझा तकनीकी सेवाओं और मेटाडाटा स्वचालन पर ज़ोर देता है। संगठनों के लिए इन्हें मिलाया जा सकता है: डोमेन स्वामित्व एक सामान्य फैब्रिक के माध्यम से संचालित हो सकता है।
लेकहाउस डेटा‑लेक की लचीलापन को वेयरहाउस‑शैली प्रबंधन और क्वेरी सुविधाओं के साथ जोड़ता है। यह एक भाग लेने वाला प्लेटफ़ॉर्म हो सकता है, परन्तु यह संपूर्ण क्रॉस‑सिस्टम फैब्रिक नहीं है। इसी प्रकार, केवल वेयरहाउस या कैटलॉग सभी एकीकरण और नीति कार्यों को प्रदान नहीं करता।
कार्यान्वयन और मूल्यांकन
सबसे पहले एक मूल्यवान क्रॉस‑सिस्टम उपयोग केस से शुरू करें और न्यूनतम स्रोत, मालिक, नीतियां और सेवा‑स्तर की अपेक्षाओं की सूची बनाएं। स्वचालित सिफ़ारिशें जोड़ने से पहले पहचान, मेटाडाटा मानक, अनुबंध, परीक्षण और अवलोकनशीलता स्थापित करें।
खोज समय, पहुँच‑स्वीकृति समय, घटना दर, डेटा ताज़गी, पुन: उपयोग और उपभोक्ता विश्वास को मापें। फैब्रिक को संरचित और असंरचित डेटा शासन तथा साइबर सुरक्षा से जोड़ें; नियंत्रण के बिना कनेक्टिविटी जोखिम को बढ़ा सकती है।
डेटा‑फैब्रिक आर्किटेक्चर और मेटाडाटा प्लेन
डेटा फैब्रिक एक वास्तुशिल्प दृष्टिकोण है जो साझा मेटाडाटा, शासन, एकीकरण और पहुँच सेवाओं के माध्यम से वितरित डेटा को जोड़ता है। यह एक डेटाबेस या उत्पाद नहीं है। स्रोत वेयरहाउस, लेक, संचालन प्रणाली, स्ट्रीम और SaaS प्लेटफ़ॉर्म में रह सकते हैं, जबकि कैटलॉग डेटासेट का वर्णन करते हैं, लाइनिएज परिवर्तन को ट्रेस करता है, नीतियां पहुँच को नियंत्रित करती हैं, और अर्थविज्ञान परिभाषाएँ अवधारणाओं को पुन: उपयोग योग्य बनाती हैं। वर्चुअलाइज़ेशन, प्रतिकृति, API और पाइपलाइन पूरक डिलीवरी विधियां हैं जिन्हें विलंबता, पैमाना, स्रोत क्षमता और संगतता की जरूरतों के आधार पर चुना जाता है।
सक्रिय मेटाडाटा स्कीमा, स्वामित्व, उपयोग, गुणवत्ता, वर्गीकरण, लाइनिएज, क्वेरी पैटर्न और संचालन घटनाओं को कैप्चर करता है और स्वचालन को प्रेरित कर सकता है। एक नॉलेज ग्राफ व्यावसायिक अवधारणाओं को भौतिक फ़ील्ड और नीतियों से जोड़ सकता है। स्वचालन जॉइन की सिफ़ारिश, ड्रिफ्ट का पता लगाना, वर्गीकरण का प्रसारण या घटनाओं का रूटिंग कर सकता है, परन्तु अनुमानित मेटाडाटा को विश्वसनीयता और देखरेख की आवश्यकता होती है। एक कैटलॉग जो डिलीवरी और नियंत्रण से जुड़ा नहीं है, वह दस्तावेज़ीकरण ऋण बन जाता है; अर्थविज्ञान स्वामित्व के बिना स्वचालित एकीकरण तेज़ असंगतता पैदा करता है।
एकीकरण, शासन और डेटा उत्पाद
बैच ETL, परिवर्तन‑डेटा कैप्चर, स्ट्रीम, फेडरेशन और रिवर्स ETL की ताज़गी और विफलता सेमांटिक अलग-अलग होते हैं। प्राधिकृत स्रोत, पहचानकर्ता, अनुबंध, इवेंट समय, देर से डेटा, विलोपन और पुनर्संयोजन को परिभाषित करें। वर्चुअल क्वेरी प्रतिलिपियों से बचती है लेकिन स्रोत के प्रदर्शन और उपलब्धता पर निर्भर करती है; सामग्रीकरण गति बढ़ाता है परन्तु ताज़गी और रखरखाव की बाध्यताएँ उत्पन्न करता है। संवेदनशील नीति को व्युत्पन्न डेटा, कैश, एम्बेडिंग और निर्यात के लिए पालन या पुनर्मूल्यांकन करना चाहिए।
उच्च‑मूल्य वाले डेटासेट को उत्पाद के रूप में मानें जिसमें मालिक, उपयोगकर्ता, दस्तावेज़ीकरण, सेवा अपेक्षाएँ, परीक्षण और समर्थन हों। फेडरेटेड स्वामित्व डोमेनों को अर्थ प्रबंधित करने देता है जबकि साझा मानक इंटरऑपरेबिलिटी को बनाए रखते हैं। केंद्रीय टीमें प्लेटफ़ॉर्म क्षमताएँ और शासन प्रदान करती हैं, न कि प्रत्येक फ़ील्ड का स्वामित्व। खोज समय, पुन: उपयोग, डेटा गुणवत्ता, पहुँच लीड टाइम, घटना समाधान, विश्वसनीय मीट्रिक अपनाना और लागत को मापें। कैटलॉग प्रविष्टियों या कनेक्टरों की संख्या यह प्रमाण नहीं है कि लोग विश्वसनीय डेटा खोज और उपयोग कर सकते हैं।
कार्यान्वयन रणनीति
सबसे पहले एक क्रॉस‑डोमेन यात्रा से शुरू करें जिसकी देरी और जोखिम ज्ञात हों। स्रोत और अनुबंधों की सूची बनाएं, पहचान और वर्गीकरण स्थापित करें, लाइनिएज और गुणवत्ता को जोड़ें, फिर दोहराए जाने वाले नियंत्रणों को स्वचालित करें। मूल्य प्रदान करने से पहले पूरे एंटरप्राइज़ को मॉडल करने के लिए कई‑सालों का प्रयास न करें। स्रोत आउटेज, स्कीमा परिवर्तन, रद्द पहुँच, देर से इवेंट और आपदा पुनर्प्राप्ति का परीक्षण करें। डेटा फैब्रिक तब सफल होता है जब वितरित डेटा को शासन और उपयोग करना आसान हो जाता है, बिना उन प्रणालियों की संचालन वास्तविकताओं और जवाबदेही को मिटाए जहाँ से वह उत्पन्न होता है।
व्यावहारिक उदाहरण: ग्राहक‑डेटा फैब्रिक
एक कंपनी वाणिज्य, समर्थन, मार्केटिंग और उत्पाद डेटा को जोड़ती है जबकि संचालन प्रणालियों को प्राधिकार देती है। एक साझा कैटलॉग ग्राहक, खाता, ऑर्डर, सहमति और इंटरैक्शन परिभाषाओं को भौतिक फ़ील्ड से जोड़ता है। परिवर्तन‑डेटा कैप्चर द्वारा शासित उत्पाद फ़ीड होते हैं, जबकि वर्चुअलाइज़ेशन कम‑वॉल्यूम वर्तमान लुकअप को सेवा देता है और सामग्रीकृत तालिकाएँ विश्लेषण का समर्थन करती हैं। पहचान, लाइनिएज, गुणवत्ता और नीति को AI व्यक्तिगतकरण लेयर को डेटा उपयोग की अनुमति देने से पहले लागू किया जाता है।
सहमति वापस लेने को वेयरहाउस तालिकाओं, खोज सूचकांकों, एम्बेडिंग और सक्रियण प्रणालियों के माध्यम से प्रसारित किया जाता है, साथ ही पूर्णता का प्रमाण होता है। स्कीमा अनुबंध और पुनर्संयोजन परीक्षण स्रोत परिवर्तन का पता लगाते हैं। मालिक ताज़गी और गुणवत्ता अपेक्षाएँ प्रकाशित करते हैं, और उपयोग मेटाडाटा अप्रयुक्त प्रतियों को हटाने में मदद करता है। पायलट पहुँच लीड टाइम, विश्वसनीय मीट्रिक पुन: उपयोग, घटना समाधान और गोपनीयता अनुपालन को मापता है। फैब्रिक को सफल माना जाता है क्योंकि एक क्रॉस‑डोमेन यात्रा विश्वसनीय और शासनीय बनती है—न कि इसलिए कि विक्रेता ने सबसे अधिक स्रोतों को जोड़ा।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताओं, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादक बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक सेवा‑हीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, विलंबता, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक रूपांतरण और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार सौंपें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग की पुष्टि करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑दुनिया के प्रमाण की समीक्षा करें, न कि यह मानते हुए कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर या लक्ष्य बदलें, पुनः मूल्यांकन करें। एक रखरखाव प्रणाली को दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, विलोपन और रखरखाव प्रक्रियाओं, तथा वह स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या बदलना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या डेटा फैब्रिक सभी डेटा को एक ही स्थान पर ले जाता है?
नहीं। यह वितरित डेटा का समन्वय कर सकता है और कार्यभार के अनुसार भौतिक स्थानांतरण या वर्चुअलाइज़ेशन चुन सकता है।
क्या डेटा फैब्रिक डेटा मेष के समान है?
नहीं। फैब्रिक मुख्यतः सक्षम करने वाली वास्तुशिल्प और स्वचालन को वर्णित करता है; मेष मुख्यतः विकेंद्रीकृत डोमेन स्वामित्व और डेटा‑प्रोडक्ट जिम्मेदारियों को वर्णित करता है। वे साथ-साथ मौजूद हो सकते हैं।
प्राथमिक संदर्भ











