
Anderson का एंगल
तीन चुनौतियाँ जिनका सामना स्टेबल डिफ्यूजन को करना होगा

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
stability.ai के Stable Diffusion की रिलीज़ कुछ सप्ताह पहले हुई। यह लेटेंट डिफ्यूज़न पर आधारित छवि-संश्लेषण मॉडल तकनीक के सबसे महत्वपूर्ण सार्वजनिक खुलासों में से एक हो सकता है 1999 में DeCSS के बाद से; यह निश्चित रूप से AI-निर्मित चित्रों के क्षेत्र की सबसे बड़ी घटना है, जब से 2017 में deepfakes कोड GitHub पर कॉपी किया गया और उससे अलग शाखाएँ बनीं, जो आगे चलकर DeepFaceLab और FaceSwapबनीं, साथ ही रीयल-टाइम स्ट्रीमिंग deepfake सॉफ़्टवेयर DeepFaceLive.
एक झटके में उपयोगकर्ताओं की निराशा जो जुड़ी थी सामग्री संबंधी पाबंदियों से, DALL-E 2 के छवि-संश्लेषण API में दूर हो गई, क्योंकि पता चला कि Stable Diffusion का NSFW फ़िल्टर कोड की सिर्फ़ एक पंक्तिबदलकर बंद किया जा सकता है। अश्लील सामग्री पर केंद्रित Stable Diffusion के Reddit समुदाय लगभग तुरंत उभरे और उतनी ही जल्दी बंद भी कर दिए गए। दूसरी ओर Discord पर डेवलपर और उपयोगकर्ता आधिकारिक तथा NSFW समुदायों में बँट गए, और Twitter पर Stable Diffusion की कल्पनाशील रचनाएँ भरने लगीं।
अभी इस प्रणाली को अपनाने वाले डेवलपर लगभग हर दिन कोई अद्भुत नवाचार सामने लाते दिखते हैं। प्लगइन और तीसरे पक्ष के सहायक उपकरण तेज़ी से लिखे जा रहे हैं Krita, Photoshop, Cinema4D, Blenderऔर कई अन्य एप्लिकेशन प्लेटफ़ॉर्म के लिए।
इसी बीच प्रॉम्प्ट तैयार करने की कला यानी अब पेशेवर बन चुकी “AI से फुसफुसाकर बात करने” की कला, जो “Filofax binder” के बाद सबसे कम टिकने वाला करियर विकल्प साबित हो सकती है, पहले ही व्यावसायिक रूप ले रही है। Stable Diffusion से शुरुआती कमाई Patreon के स्तरपर हो रही है। आगे अधिक परिष्कृत सेवाओं का आना तय है, उन लोगों के लिए जो सोर्स कोड को Conda के ज़रिये इंस्टॉल करने की जटिलता या वेब-आधारित संस्करणों के कठोर NSFW फ़िल्टर से नहीं जूझना चाहते।
विकास की गति और उपयोगकर्ताओं की मुक्त खोज इतनी तेज़ है कि बहुत आगे देखना मुश्किल है। मूलतः हमें अभी ठीक-ठीक नहीं पता कि हमारे सामने क्या है, या इसकी सारी सीमाएँ और संभावनाएँ क्या हो सकती हैं।
फिर भी, आइए उन तीन बाधाओं को देखें जो तेज़ी से बने और बढ़ रहे Stable Diffusion समुदाय के लिए सबसे दिलचस्प और चुनौतीपूर्ण हो सकती हैं, और जिन्हें वह उम्मीद है कि पार कर पाएगा।
1: टाइल-आधारित प्रसंस्करण प्रक्रियाओं का अनुकूलन
सीमित हार्डवेयर संसाधनों और प्रशिक्षण चित्रों के रिज़ॉल्यूशन की कड़ी सीमाओं को देखते हुए, संभव है कि डेवलपर Stable Diffusion के परिणामों की गुणवत्ता और रिज़ॉल्यूशन दोनों बेहतर करने के वैकल्पिक तरीके निकालें। ऐसे कई प्रोजेक्ट प्रणाली की सीमाओं का ही उपयोग करेंगे, जैसे उसका मूल रिज़ॉल्यूशन सिर्फ़ 512×512 पिक्सल होना।
कंप्यूटर विज़न और छवि-संश्लेषण के प्रयासों में सामान्यतः जैसा होता है, Stable Diffusion को वर्गाकार चित्रों पर प्रशिक्षित किया गया। यहाँ उन्हें दोबारा सैंपल करके 512×512 किया गया, ताकि मूल चित्रों को एक समान रूप दिया जा सके और वे मॉडल को प्रशिक्षित करने वाले GPU की सीमाओं में समा सकें।
इसलिए Stable Diffusion 512×512 के संदर्भ में “सोचता” है, यदि वह सोचता है तो, और निश्चित ही वर्गाकार रूप में। प्रणाली की सीमाएँ परख रहे बहुत से उपयोगकर्ता बताते हैं कि इसी सीमित पक्षानुपात पर सबसे भरोसेमंद और कम त्रुटिपूर्ण परिणाम मिलते हैं (नीचे हाथ-पैरों की समस्याओं वाला भाग देखें)।
हालाँकि अलग-अलग कार्यान्वयनों में रिज़ॉल्यूशन बढ़ाने के लिए RealESRGAN (और खराब बने चेहरों को सुधारने के लिए GFPGAN) का उपयोग होता है, कई उपयोगकर्ता चित्रों को 512×512 पिक्सल के हिस्सों में बाँटकर उन्हें जोड़ने और बड़ी संयुक्त रचनाएँ बनाने के तरीके विकसित कर रहे हैं।

1024×576 का यह चित्र, जिसका रिज़ॉल्यूशन सामान्यतः एक ही Stable Diffusion रेंडर में संभव नहीं होता, Stable Diffusion की DoggettX शाखा से attention.py नाम की Python फ़ाइल कॉपी करके दूसरी शाखा में पेस्ट करने से बना। यह शाखा टाइल-आधारित अपस्केलिंग लागू करती है। स्रोत: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
हालाँकि ऐसे कुछ प्रयास अपने मूल कोड या दूसरी लाइब्रेरी का उपयोग करते हैं, GOBIG का txt2imghd पोर्ट जल्द ही यह सुविधा मुख्य शाखा में लाने वाला है। GOBIG, अधिक VRAM माँगने वाले ProgRockDiffusion का एक मोड है। txt2imghd जहाँ GOBIG का विशेष पोर्ट है, वहीं समुदाय के दूसरे डेवलपर उसके अलग-अलग कार्यान्वयन बना रहे हैं।

मूल 512×512 पिक्सल रेंडर में ऐसा अमूर्त चित्र जो इस उदाहरण के लिए सुविधाजनक है (बाएँ और बाएँ से दूसरा); ESGRAN से इसका रिज़ॉल्यूशन बढ़ाया गया, जो अब लगभग सभी Stable Diffusion संस्करणों का हिस्सा है; और GOBIG के कार्यान्वयन से इसे “विशेष ध्यान” दिया गया। इससे ऐसे विवरण बनते हैं जो कम से कम उस चित्र-खंड की सीमाओं में बेहतर ढंग से बढ़ाए गए लगते हैं। स्रोत: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
ऊपर के अमूर्त उदाहरण में विवरणों के कई “छोटे राज्य” हैं, जो केवल अपने हिस्से को देखने वाली इस अपस्केलिंग विधि के अनुकूल हैं। लेकिन ऐसा सुसंगत, गैर-दोहराव वाला रिज़ॉल्यूशन-वृद्धि परिणाम बनाने के लिए, जो दिखे नहीं कि कई हिस्से जोड़कर बनाया गया है, अधिक चुनौतीपूर्ण कोड-आधारित समाधान चाहिए हो सकते हैं। खासकर मानव चेहरों में हम असामान्यताओं और चुभने वाले कृत्रिम दोषों को तुरंत पहचानते हैं। इसलिए अंततः चेहरों को अलग समाधान की ज़रूरत पड़ सकती है।
Stable Diffusion में अभी रेंडर करते समय चेहरे पर उसी तरह ध्यान केंद्रित करने का तंत्र नहीं है जिस तरह मनुष्य चेहरे की जानकारी को प्राथमिकता देते हैं। Discord समुदायों में कुछ डेवलपर ऐसा “अधिक ध्यान” लागू करने के तरीके सोच रहे हैं, लेकिन फिलहाल शुरुआती रेंडर के बाद चेहरा हाथ से सुधारना कहीं आसान है; आगे चलकर यह स्वचालित भी हो सकता है।
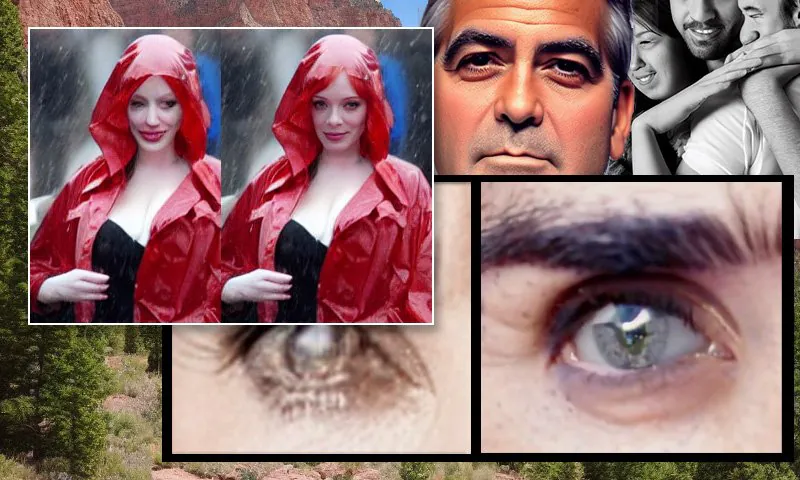
मानव चेहरे का अपना पूर्ण आंतरिक अर्थगत तर्क होता है, जो किसी इमारत के निचले कोने की “टाइल” में नहीं मिलता। इसलिए अभी Stable Diffusion के परिणाम में किसी अधूरे स्केच जैसे चेहरे को “ज़ूम इन” करके दोबारा बनाना बहुत प्रभावी हो सकता है।

बाएँ: इस प्रॉम्प्ट पर Stable Diffusion का पहला प्रयास: ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’। दाएँ: पहले रेंडर के धुँधले, स्केच जैसे चेहरे को Img2Img के ज़रिये Stable Diffusion का पूरा ध्यान देकर दोबारा बनाने से मिला बेहतर चेहरा (नीचे के एनिमेटेड चित्र देखें)।
अलग Textual Inversion समाधान के बिना (नीचे देखें), यह केवल उन प्रसिद्ध व्यक्तियों के चित्रों पर काम करेगा जिनका पर्याप्त प्रतिनिधित्व पहले से उन LAION उपसमूहों में है जिनसे Stable Diffusion प्रशिक्षित हुआ। इसलिए यह Tom Cruise, Brad Pitt, Jennifer Lawrence और उन सीमित प्रसिद्ध मीडिया हस्तियों के लिए काम करेगा जिनकी बहुत सारी तस्वीरें स्रोत डेटा में मौजूद हैं।
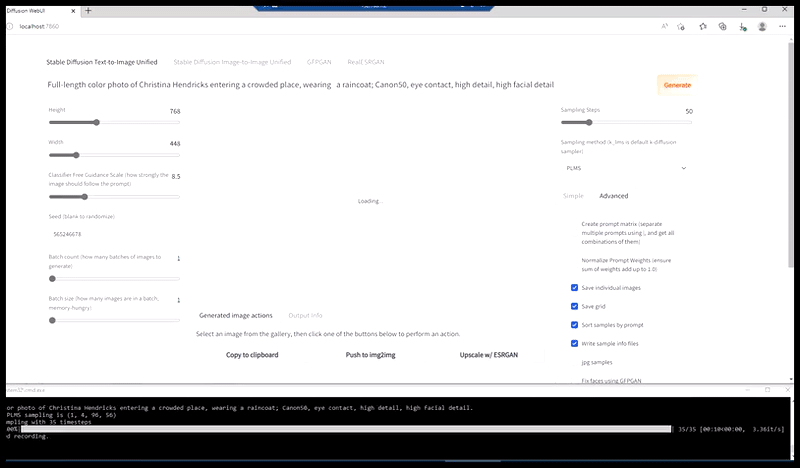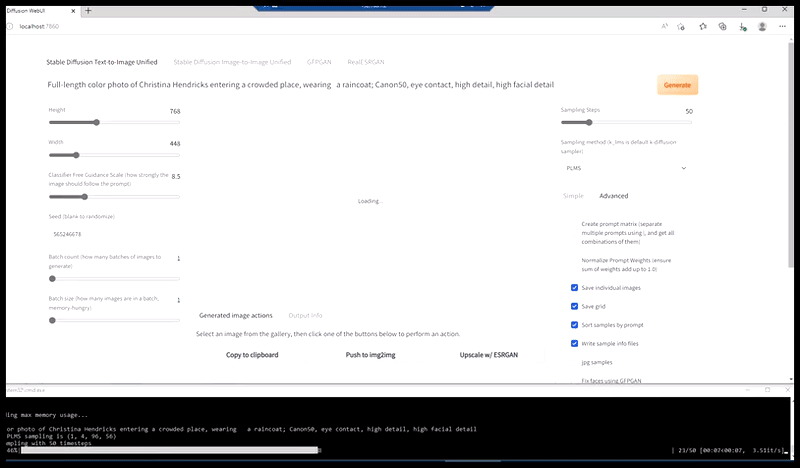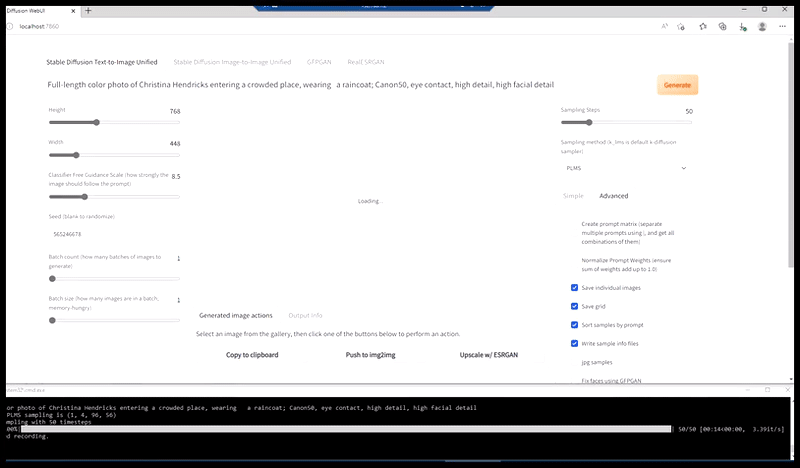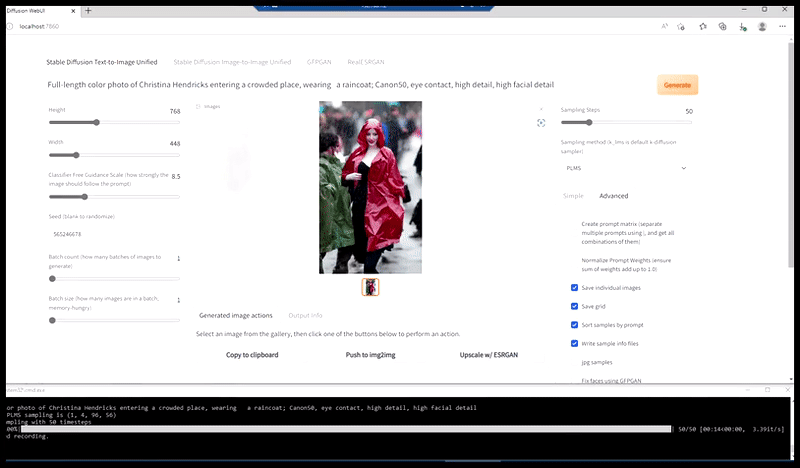
इस प्रॉम्प्ट से एक संभाव्य प्रेस फ़ोटो बनाना: ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’।
लंबे और लगातार करियर वाली हस्तियों की छवि Stable Diffusion आमतौर पर उनकी हाल की, यानी अधिक उम्र की, बनाता है। कम उम्र का रूप पाने के लिए प्रॉम्प्ट में ‘young’ या ‘in the year [YEAR]’ जैसे शब्द जोड़ना ज़रूरी होगा।

लगभग 40 वर्ष के प्रमुख, बहुत अधिक फ़ोटोग्राफ़ किए गए और निरंतर करियर वाली अभिनेत्री Jennifer Connelly LAION की उन कुछ हस्तियों में हैं जिनसे Stable Diffusion अलग-अलग उम्र के चित्र बना सकता है। स्रोत: स्थानीय, पहले से तैयार Stable Diffusion पैकेज, v1.4 चेकपॉइंट; उम्र-संबंधी प्रॉम्प्ट।
इसका बड़ा कारण 2000 के दशक के मध्य से डिजिटल प्रेस फ़ोटोग्राफ़ी का फैलना है, जो महँगी इमल्शन-आधारित फ़ोटोग्राफ़ी की जगह आई, और बाद में ब्रॉडबैंड गति बढ़ने से चित्रों की मात्रा में हुई वृद्धि।
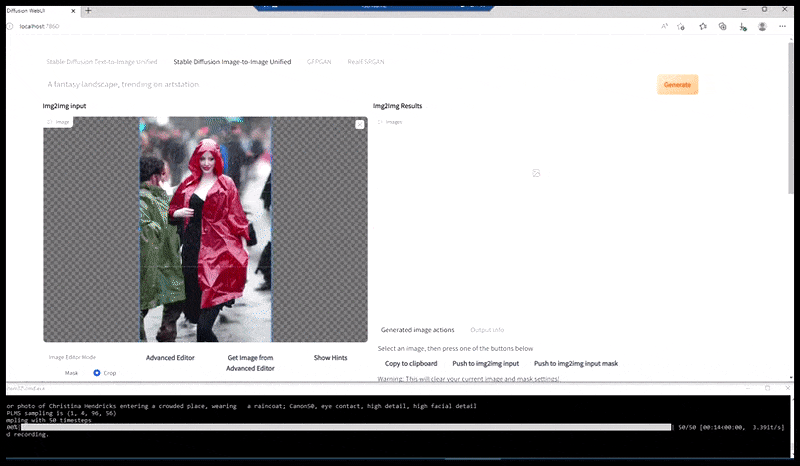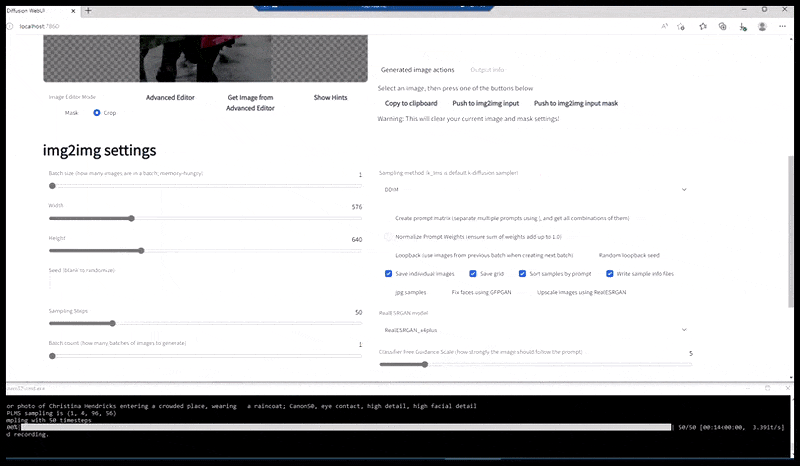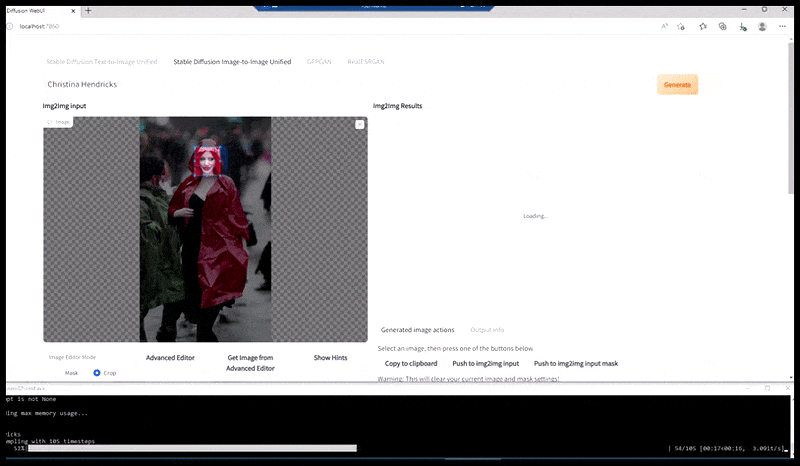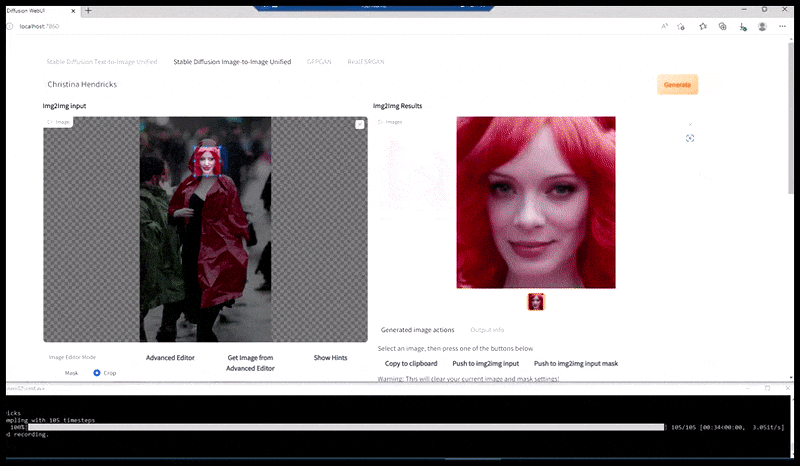
बना हुआ चित्र Stable Diffusion में Img2Img को दिया जाता है। वहाँ “फ़ोकस क्षेत्र” चुना जाता है, और सिर्फ़ उसी क्षेत्र का अधिकतम आकार का नया रेंडर बनाया जाता है। इससे Stable Diffusion चेहरे को दोबारा बनाने पर अपने सभी उपलब्ध संसाधन लगा सकता है।
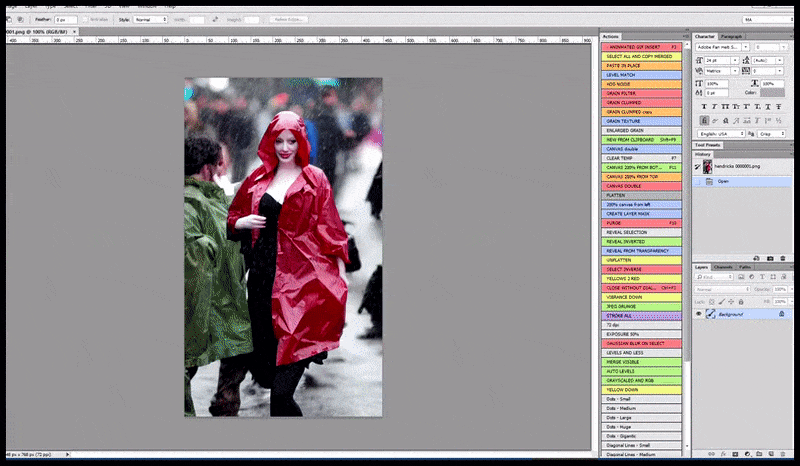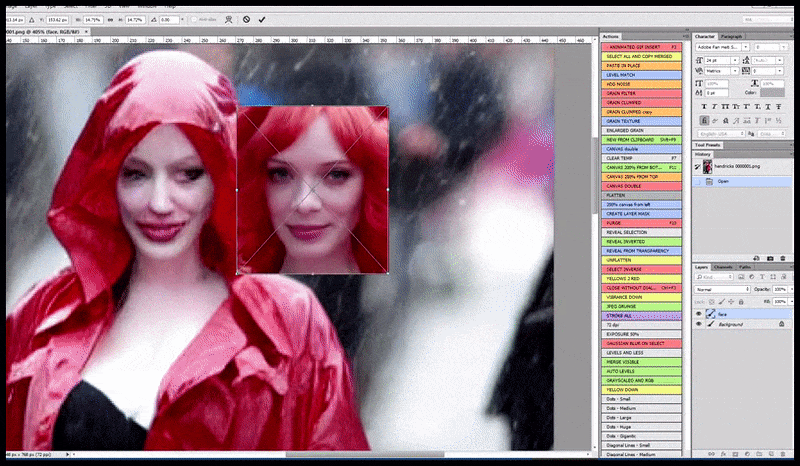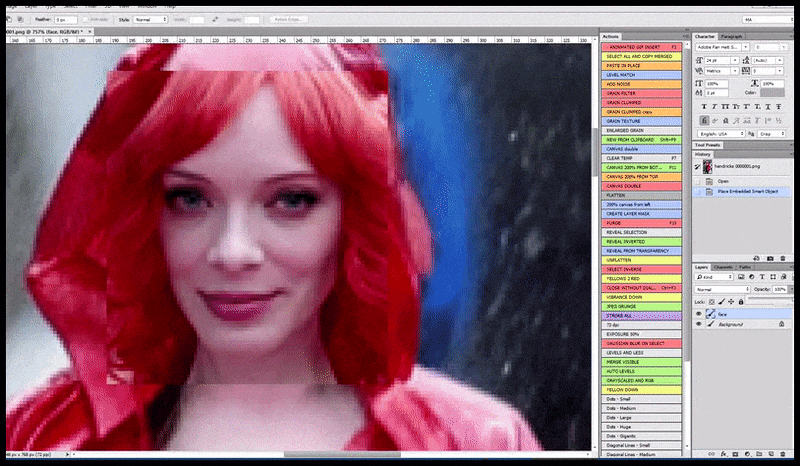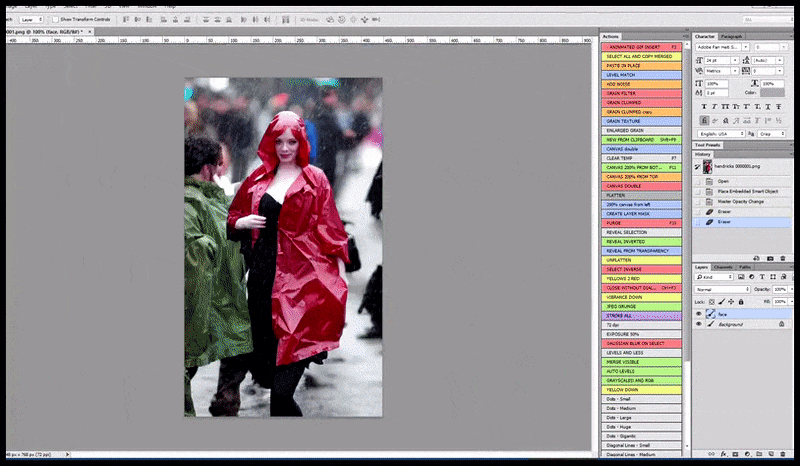
“अधिक ध्यान” से बने चेहरे को मूल चित्र में वापस जोड़ना। चेहरे के अलावा यह प्रक्रिया सिर्फ़ उन चीज़ों पर काम करेगी जिनका संभावित रूप ज्ञात, सुसंगत और अपने आप में पूर्ण हो, जैसे मूल फ़ोटो के किसी हिस्से में स्पष्ट घड़ी या कार। उदाहरण के लिए दीवार का एक हिस्सा बड़ा करके जोड़ने पर बहुत अजीब दीवार बनेगी, क्योंकि टाइल रेंडर होते समय इस “पहेली के टुकड़े” के लिए बड़ा संदर्भ मौजूद नहीं था।
डेटाबेस की कुछ हस्तियाँ समय में पहले से “जमी” हुई मिलती हैं, या तो इसलिए कि उनकी मृत्यु कम उम्र में हो गई, जैसे Marilyn Monroe, या वे मुख्यधारा में सिर्फ़ थोड़े समय के लिए प्रसिद्ध हुईं, जिससे कम अवधि में बहुत चित्र बने। Stable Diffusion से पूछना शायद आधुनिक और पुरानी हस्तियों की एक तरह की “वर्तमान” लोकप्रियता-सूची देता है। कुछ पुरानी और वर्तमान हस्तियों के बहुत समान चित्र बनाने के लिए पर्याप्त स्रोत चित्र नहीं हैं, जबकि बहुत पहले मर चुके या लोकप्रियता खो चुके कुछ सितारों की लगातार लोकप्रियता के कारण उनकी ठीक-ठाक समान छवि मिल सकती है।

Stable Diffusion के रेंडर जल्दी बता देते हैं कि प्रशिक्षण डेटा में किन प्रसिद्ध चेहरों का अच्छा प्रतिनिधित्व है। लेखन के समय किशोरावस्था के अंतिम वर्षों में बेहद लोकप्रिय होने के बावजूद Millie Bobby Brown कम उम्र की और कम जानी-पहचानी थीं जब LAION का स्रोत डेटा वेब से एकत्र किया गया। इसलिए इस समय Stable Diffusion से उनसे बहुत मिलता-जुलता उच्च-गुणवत्ता चित्र बनाना कठिन है।
जहाँ डेटा उपलब्ध है, Stable Diffusion में टाइल-आधारित रिज़ॉल्यूशन वृद्धि चेहरे पर ध्यान देने से भी आगे बढ़ सकती है। चेहरे की विशेषताएँ अलग करके, जोड़ने से पहले स्थानीय GPU की पूरी शक्ति एक-एक प्रमुख विशेषता पर लगाई जा सकती है, जिससे और सटीक तथा विस्तृत चेहरे मिल सकते हैं। यह प्रक्रिया भी फिलहाल हाथ से होती है।

यह चेहरों तक सीमित नहीं है, लेकिन उन वस्तु-भागों तक सीमित है जिनकी स्थिति मूल वस्तु के बड़े संदर्भ में कम से कम उतनी ही अनुमानित हो और जो ऐसे उच्च-स्तरीय एम्बेडिंग के अनुरूप हों जिनके विशाल पैमाने के डेटासेट में मिलने की उचित उम्मीद की जा सके।
असली सीमा डेटासेट में उपलब्ध संदर्भ डेटा की मात्रा है, क्योंकि अंततः बहुत गहराई तक दोहराए गए विवरण पूरी तरह “भ्रमित” यानी काल्पनिक और कम प्रामाणिक हो जाएँगे।
इतनी बारीकी से किए गए ये विस्तार Jennifer Connelly के मामले में काम करते हैं, क्योंकि अलग-अलग उम्र में उनका अच्छा प्रतिनिधित्व LAION-aesthetics में है, जो LAION 5B का मुख्य उपसमूह है और Stable Diffusion उसका उपयोग करता है। सामान्य रूप से LAION में भी उनका अच्छा प्रतिनिधित्व है। कई अन्य मामलों में डेटा की कमी सटीकता घटाएगी, जिससे फ़ाइन-ट्यूनिंग, यानी अतिरिक्त प्रशिक्षण (नीचे “अनुकूलन” देखें), या Textual Inversion (नीचे देखें) ज़रूरी होगा।
टाइल Stable Diffusion से उच्च-रिज़ॉल्यूशन परिणाम लेने का शक्तिशाली और अपेक्षाकृत सस्ता तरीका है। लेकिन इस तरह की एल्गोरिद्मिक टाइल-आधारित वृद्धि, यदि उसमें व्यापक और उच्च-स्तरीय ध्यान का कोई तंत्र न हो, तो कई प्रकार की सामग्री में अपेक्षित मानकों से पीछे रह सकती है।
2: मानव हाथ-पैरों की समस्याएँ सुलझाना
मानव शरीर के सिरों की जटिलता दिखाते समय Stable Diffusion अपने नाम के अनुरूप स्थिर नहीं रहता। हाथ अचानक कई हो सकते हैं, उँगलियाँ मिल सकती हैं, बिना माँगे तीसरा पैर आ सकता है, और मौजूद हाथ-पैर बिना निशान गायब हो सकते हैं। उसके बचाव में यह कहना होगा कि अन्य समान मॉडलों में भी यह समस्या है, और निश्चित ही DALL-E 2 में भी।

अगस्त 2022 के अंत में DALL-E 2 और Stable Diffusion (1.4) के बिना संपादन वाले परिणाम, दोनों में हाथ-पैरों की समस्या दिखती है। प्रॉम्प्ट है ‘A woman embracing a man’।
Stable Diffusion के प्रशंसक जो उम्मीद करते हैं कि आगामी 1.5 चेकपॉइंट, यानी बेहतर मापदंडों वाला और अधिक गहनता से प्रशिक्षित संस्करण, हाथ-पैरों की गड़बड़ी ठीक करेगा, संभवतः निराश होंगे। नया मॉडल, जो लगभग दो सप्ताह मेंजारी होगा, अभी stability.ai के व्यावसायिक पोर्टल DreamStudioपर पहली बार उपलब्ध कराया जा रहा है। वहाँ 1.5 डिफ़ॉल्ट रूप से उपयोग होता है, और उपयोगकर्ता नए परिणामों की तुलना अपने स्थानीय या अन्य 1.4 सिस्टम के रेंडर से कर सकते हैं:

स्रोत: स्थानीय 1.4 तैयार पैकेज और https://beta.dreamstudio.ai/

स्रोत: स्थानीय 1.4 तैयार पैकेज और https://beta.dreamstudio.ai/

स्रोत: स्थानीय 1.4 तैयार पैकेज और https://beta.dreamstudio.ai/
जैसा अक्सर होता है, डेटा की गुणवत्ता मुख्य योगदान देने वाला कारण हो सकती है।
Stable Diffusion और DALL-E 2 जैसे छवि-संश्लेषण सिस्टम को डेटा देने वाले खुले डेटाबेस व्यक्तियों और लोगों के बीच की गतिविधियों, दोनों के लिए कई लेबल दे सकते हैं। ये लेबल उनसे जुड़े चित्रों या चित्र-खंडों के साथ मिलकर प्रशिक्षण में शामिल होते हैं।

Stable Diffusion उपयोगकर्ता LAION-aesthetics में खोज करके मॉडल में प्रशिक्षित अवधारणाएँ देख सकते हैं। यह प्रणाली को डेटा देने वाले बड़े LAION 5B डेटासेट का उपसमूह है। चित्र लेबल के वर्णक्रम में नहीं, बल्कि उनके “सौंदर्य स्कोर” के अनुसार क्रमबद्ध हैं। स्रोत: https://rom1504.github.io/clip-retrieval/
मानव बाँह को दिखाने वाले व्यक्तिगत लेबल और श्रेणियों का अच्छा पदानुक्रम कुछ इस तरह होगा: body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

हाथ के हिस्सों का बारीक अर्थगत विभाजन। इतना असामान्य रूप से विस्तृत विखंडन भी प्रत्येक “उँगली” को एक ही इकाई मानता है और उँगली के तीन तथा अंगूठे के दो खंडों का हिसाब नहीं रखता। स्रोत: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
वास्तव में, पूरे डेटासेट के स्रोत चित्रों पर इतनी समानता से टिप्पणी लगी होने की संभावना कम है। बिना पर्यवेक्षण वाले लेबलिंग एल्गोरिद्म संभवतः ऊँचे स्तर पर, जैसे “हाथ”, रुक जाएँगे और अंदर के पिक्सल, जिनमें तकनीकी तौर पर “उँगली” की जानकारी है, को बिना लेबल का समूह छोड़ देंगे। उनसे विशेषताएँ मनमाने ढंग से निकाली जाएँगी, जो बाद के रेंडर में चुभने वाली गड़बड़ी बन सकती हैं।

जैसा होना चाहिए (ऊपर दाएँ, यदि वह अपरकट नहीं है), और जैसा अक्सर होता है (नीचे दाएँ), क्योंकि लेबलिंग संसाधन सीमित हैं, या डेटासेट में लेबल हों भी तो वास्तु-रचना उनका सीमित उपयोग करती है।
इसलिए यदि लेटेंट डिफ्यूज़न मॉडल बाँह बनाने तक पहुँचता है, तो लगभग निश्चित है कि वह उसके सिरे पर हाथ बनाने की कोशिश करेगा, क्योंकि arm>hand न्यूनतम आवश्यक पदानुक्रम है, जो वास्तु-रचना की “मानव शरीर-रचना” संबंधी जानकारी में काफ़ी ऊँचे स्तर पर है।
इसके बाद “उँगलियाँ” सबसे छोटी इकाई हो सकती हैं, जबकि मानव हाथ दिखाते समय उँगलियों और अंगूठे के 14 और उपभागों पर विचार करना चाहिए।
यदि यह सिद्धांत सही है तो कोई वास्तविक उपाय नहीं है, क्योंकि पूरे क्षेत्र में हाथ से टिप्पणी लगाने के लिए बजट की कमी है, और ऐसे पर्याप्त प्रभावी एल्गोरिद्म नहीं हैं जो कम त्रुटि-दर के साथ लेबलिंग स्वचालित कर सकें। वास्तव में मॉडल फिलहाल डेटासेट की कमियाँ ढकने के लिए मानव शरीर-रचना की एकरूपता पर निर्भर हो सकता है।
वह इस पर निर्भर नहीं रह सकता , इसका एक संभावित कारण हाल में Stable Diffusion के Discord पर प्रस्तावित किया गया: मॉडल वास्तविक मानव हाथ में सही संख्या में उँगलियाँ होने को लेकर भ्रमित हो सकता है, क्योंकि उसे डेटा देने वाले LAION-आधारित डेटाबेस में ऐसे कार्टून पात्र हैं जिनकी उँगलियाँ कम हो सकती हैं (यह खुद एक मेहनत बचाने वाला शॉर्टकटहै)।

Stable Diffusion और समान मॉडलों में “लापता उँगली” समस्या के दो संभावित दोषी। नीचे: Stable Diffusion को डेटा देने वाले LAION-aesthetics डेटासेट से कार्टून हाथों के उदाहरण। स्रोत: https://www.youtube.com/watch?v=0QZFQ3gbd6I
यदि यह सही है, तो एकमात्र स्पष्ट उपाय मॉडल को फिर प्रशिक्षित करना है, जिसमें अवास्तविक मानव-आधारित सामग्री हटाई जाए और अंग के सचमुच अनुपस्थित होने के मामलों, जैसे अंग-विच्छेदित लोगों, को अपवाद के रूप में सही लेबल दिया जाए। केवल डेटा-संयोजन के नज़रिए से भी यह बड़ी चुनौती होगी, खासकर कम संसाधनों वाले सामुदायिक प्रयासों के लिए।
दूसरा तरीका ऐसे फ़िल्टर लगाना होगा जो रेंडर करते समय इस तरह की सामग्री, जैसे “तीन/पाँच उँगलियों वाला हाथ”, को सामने आने से रोकें, लगभग वैसे ही जैसे OpenAI ने एक हद तक फ़िल्टर किया है GPT-3 और DALL-E 2को, ताकि मूल मॉडलों को दोबारा प्रशिक्षित किए बिना उनके परिणामों का नियमन हो सके।

Stable Diffusion में उँगलियों और यहाँ तक कि हाथ-पैरों के बीच अर्थगत भेद भयावह ढंग से धुँधला हो सकता है। यह David Cronenberg जैसे निर्देशकों की 1980 के दशक की डरावनी फ़िल्मों की “बॉडी हॉरर” धारा की याद दिलाता है। स्रोत: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
हालाँकि फिर से इसके लिए ऐसे लेबल चाहिए होंगे जो सभी प्रभावित चित्रों पर शायद मौजूद न हों। इसलिए वही व्यवस्था और बजट संबंधी चुनौती बनी रहती है।
कहा जा सकता है कि आगे दो रास्ते बचते हैं: समस्या पर और डेटा लगाना, और तीसरे पक्ष के व्याख्यात्मक सिस्टम लगाना जो इस तरह की शारीरिक गलतियाँ अंतिम उपयोगकर्ता तक पहुँचने के समय हस्तक्षेप कर सकें। कम से कम दूसरा रास्ता OpenAI को “बॉडी हॉरर” रेंडर का पैसा वापस करने का तरीका देगा, यदि कंपनी ऐसा करना चाहे।
3: अनुकूलन
Stable Diffusion के भविष्य की सबसे रोमांचक संभावनाओं में से एक है उपयोगकर्ताओं या संगठनों द्वारा संशोधित सिस्टम बनाना। ऐसे बदलाव पूर्व-प्रशिक्षित LAION के दायरे से बाहर की सामग्री जोड़ने देंगे, आदर्श रूप से पूरे मॉडल को फिर प्रशिक्षित करने की बेकाबू लागत के बिना, और पहले से परिपक्व, सक्षम मॉडल में बड़ी मात्रा में नई तस्वीरें प्रशिक्षित करने के जोखिम के बिना।
तुलना के लिए: तीस छात्रों की उन्नत कक्षा में दो कम प्रतिभाशाली छात्र आएँ तो वे या तो ढलकर बराबरी कर लेंगे, या अलग-थलग अपवाद के रूप में असफल होंगे। दोनों ही स्थितियों में कक्षा का औसत प्रदर्शन शायद नहीं बदलेगा। लेकिन यदि 15 कम प्रतिभाशाली छात्र आएँ तो पूरी कक्षा के अंकों का वितरण प्रभावित होने की संभावना है।
उसी तरह लगातार और महँगे मॉडल प्रशिक्षण से बने संबंधों का परस्पर सहयोगी और काफ़ी नाज़ुक जाल अत्यधिक नए डेटा से बिगड़ सकता है, और कुछ मामलों में लगभग नष्ट हो सकता है, जिससे मॉडल के परिणामों की गुणवत्ता हर जगह गिर सकती है।
ऐसा करने का मुख्य औचित्य तब है जब आप संबंधों और चीज़ों के बारे में मॉडल की अवधारणात्मक समझ पर पूरी तरह कब्ज़ा करके उसका उपयोग सिर्फ़ अपनी जोड़ी हुई सामग्री जैसी चीज़ें बनाने के लिए करना चाहते हों।
इसलिए किसी मौजूदा Stable Diffusion चेकपॉइंट में Simpsons के 500,000 फ़्रेम प्रशिक्षित करने से अंततः मूल संस्करण की तुलना में बेहतर Simpsons सिम्युलेटर मिल सकता है, बशर्ते पर्याप्त व्यापक अर्थगत संबंध इस प्रक्रिया में बचे रहें (जैसे Homer Simpson eating a hotdog, जिसके लिए हॉट डॉग संबंधी ऐसा डेटा चाहिए हो सकता है जो आपके अतिरिक्त डेटा में न हो लेकिन मूल चेकपॉइंट में मौजूद हो)। यह भी मानना होगा कि आप अचानक Simpsons की सामग्री छोड़कर fabulous landscape by Greg Rutkowski बनाने नहीं लगेंगे, क्योंकि अतिरिक्त प्रशिक्षण के बाद मॉडल का ध्यान बहुत बड़े पैमाने पर दूसरी तरफ़ मुड़ चुका होगा और वह ऐसे काम पहले जितना अच्छा नहीं कर सकेगा।
इसका एक उल्लेखनीय उदाहरण waifu-diffusionहै, जिसने सफलतापूर्वक 56,000 एनिमे चित्रों से अतिरिक्त प्रशिक्षण एक तैयार और प्रशिक्षित Stable Diffusion चेकपॉइंट में किया है। हालाँकि शौकिया उपयोगकर्ता के लिए यह कठिन है, क्योंकि मॉडल को कम से कम 30GB VRAM चाहिए। यह NVIDIA की आगामी 40XX श्रृंखला के उपभोक्ता स्तर पर उपलब्ध होने की संभावना से कहीं अधिक है।

waifu-diffusion के ज़रिये Stable Diffusion में अनुकूलित सामग्री का प्रशिक्षण: इस स्तर का चित्रांकन देने के लिए मॉडल को दो सप्ताह का अतिरिक्त प्रशिक्षण लगा। बाईं तरफ़ के छह चित्र दिखाते हैं कि प्रशिक्षण बढ़ने पर नए डेटा के आधार पर विषय के अनुरूप सुसंगत परिणाम बनाने में मॉडल ने कैसी प्रगति की। स्रोत: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Stable Diffusion चेकपॉइंट की ऐसी अलग विकास-शाखाओं पर बहुत मेहनत लग सकती है, जो अंत में तकनीकी ऋण के कारण अटक जाए। आधिकारिक Discord के डेवलपर पहले ही संकेत दे चुके हैं कि बाद के चेकपॉइंट आवश्यक नहीं कि पुराने संस्करणों के अनुकूल हों, यहाँ तक कि उन प्रॉम्प्ट के तर्क के साथ भी जो पहले काम करते थे। उनकी प्राथमिकता पुराने एप्लिकेशन और प्रक्रियाओं का समर्थन करने के बजाय सर्वोत्तम संभव मॉडल पाना है।
इसलिए कोई कंपनी या व्यक्ति चेकपॉइंट को अलग शाखा बनाकर व्यावसायिक उत्पाद में बदलने का निर्णय ले तो प्रभावी रूप से वापस लौटने का रास्ता नहीं है। उस समय उनका मॉडल एक “hard fork” बन जाता है और stability.ai के बाद के संस्करणों से मूल विकास के लाभ नहीं ले सकता। यह काफ़ी बड़ी प्रतिबद्धता है।
अभी Stable Diffusion को अनुकूलित करने की अधिक बड़ी उम्मीद Textual Inversionहै, जिसमें उपयोगकर्ता कुछ गिने-चुने चित्रों से प्रशिक्षण करता है जो CLIPके अनुरूप हों।

तेल अवीव विश्वविद्यालय और NVIDIA का संयुक्त काम Textual Inversion, मूल मॉडल की क्षमताएँ नष्ट किए बिना अलग और नई इकाइयों को प्रशिक्षण में जोड़ने देता है। स्रोत: https://textual-inversion.github.io/
Textual Inversion की मुख्य दिखाई देने वाली सीमा यह है कि बहुत कम चित्र उपयोग करने की सलाह दी जाती है, कभी केवल पाँच। इससे एक सीमित इकाई बनती है जो फ़ोटो जैसी असली वस्तुएँ डालने के बजाय शैली हस्तांतरण के कामों में अधिक उपयोगी हो सकती है।
फिर भी Stable Diffusion के अलग-अलग Discord समुदायों में अभी कहीं अधिक प्रशिक्षण चित्रों के साथ प्रयोग चल रहे हैं, और यह देखना बाकी है कि यह तरीका कितना उपयोगी साबित होगा। फिर से, इसमें बहुत VRAM, समय और धैर्य लगता है।
इन सीमाओं के कारण Stable Diffusion के उत्साहियों के कुछ अधिक परिष्कृत Textual Inversion प्रयोग देखने के लिए हमें कुछ समय प्रतीक्षा करनी पड़ सकती है। यह भी देखना होगा कि आधिकारिक चेकपॉइंट की अद्भुत क्षमताएँ बचाए रखते हुए यह तरीका “आपको तस्वीर में” Photoshop से काटकर चिपकाने से बेहतर ढंग से रख पाएगा या नहीं।
पहली बार 6 सितंबर 2022 को प्रकाशित।


