
एजीआई और भविष्य की एआई
आधुनिक जनरेटिव एआई अनुप्रयोगों में वेक्टर डेटाबेस की भूमिका

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुवेक्टर डेटाबेस उच्च-आयामी डेटा जैसे एम्बेडिंग्स के लिए तीव्र समानता खोज सक्षम करते हैं…
और देखें
- वेक्टर डेटाबेस उच्च-आयामी डेटा जैसे एम्बेडिंग्स के लिए तीव्र समानता खोज सक्षम करते हैं, जो प्रभावी जेनरेटिव एआई अनुप्रयोगों के लिए एक मूलभूत आवश्यकता है।
- माइक्रोसॉफ्ट और ओरेकल जैसी प्रमुख तकनीकी कंपनियां एआई उपकरणों और रिट्रीवल ऑगमेंटेड जेनरेशन को शक्ति प्रदान करने के लिए वेक्टर डेटाबेस क्षमताओं में निवेश कर रही हैं।
- वेक्टर डेटाबेस खोज को कीवर्ड मिलान से शब्दार्थ पुनर्प्राप्ति में बदल देते हैं, जो पाठ, छवियों और ऑडियो में उपयोगकर्ता के इरादे को समझता है।
बड़े पैमाने पर जनरेटिव एआई अनुप्रयोगों के प्रभावी ढंग से काम करने के लिए, उन्हें एक अच्छी प्रणाली की आवश्यकता होती है जो बहुत सारे डेटा को संभाल सके। ऐसी ही एक महत्वपूर्ण प्रणाली वेक्टर डेटाबेस है। जो इस डेटाबेस को अलग बनाता है वह इसकी कई प्रकार के डेटा जैसे कि पाठ, ध्वनि, चित्र और वीडियो को संख्यात्मक वेक्टर रूप में संभालने की क्षमता है।
वेक्टर डेटाबेस उच्च-आयामी वेक्टर को कुशलतापूर्वक संभालने के लिए डिज़ाइन किया गया एक विशेष भंडारण प्रणाली है। ये वेक्टर, जिन्हें बहु-आयामी स्थान में बिंदुओं के रूप में सोचा जा सकता है, अक्सर छवियों, पाठ या ध्वनि जैसे अधिक जटिल डेटा के एम्बेडिंग या संकुचित प्रतिनिधित्व का प्रतिनिधित्व करते हैं।
वेक्टर डेटाबेस इन वेक्टरों के बीच तेजी से समानता खोज की अनुमति देते हैं, जिससे विशाल डेटासेट से सबसे समान आइटम को तेजी से पुनर्प्राप्त करना संभव हो जाता है।
वेक्टर डेटाबेस क्या हैं?
वेक्टर डेटाबेस एक विशेष भंडारण प्रणाली है जो उच्च-आयामी वेक्टर को कुशलतापूर्वक संभालने के लिए डिज़ाइन की गई है। ये वेक्टर, जिन्हें बहु-आयामी स्थान में बिंदुओं के रूप में सोचा जा सकता है, अक्सर एम्बेडिंग या छवियों, पाठ या ध्वनि जैसे अधिक जटिल डेटा के संकुचित प्रतिनिधित्व का प्रतिनिधित्व करते हैं।
वेक्टर डेटाबेस इन वेक्टरों के बीच तेजी से समानता खोज की अनुमति देते हैं, जिससे विशाल डेटासेट से सबसे समान आइटम को तेजी से पुनर्प्राप्त करना संभव हो जाता है।
पारंपरिक डेटाबेस बनाम वेक्टर डेटाबेस
वेक्टर डेटाबेस:
- उच्च-आयामी डेटा को संभालना: वेक्टर डेटाबेस उच्च-आयामी स्थान में डेटा को संभालने और संग्रहीत करने के लिए डिज़ाइन किए गए हैं। यह मशीन लर्निंग जैसे अनुप्रयोगों के लिए विशेष रूप से उपयोगी है, जहां डेटा बिंदु (जैसे छवियां या पाठ) को बहु-आयामी स्थान में वेक्टर के रूप में प्रस्तुत किया जा सकता है।
- समानता खोज के लिए अनुकूलित: वेक्टर डेटाबेस की एक प्रमुख विशेषता यह है कि वे समानता खोज कर सकते हैं। इसका मतलब है कि उपयोगकर्ता डेटा को समान मैच के आधार पर पुनर्प्राप्त कर सकते हैं, न कि केवल सटीक मैचों के आधार पर। यह छवि या पाठ पुनर्प्राप्ति जैसे कार्यों के लिए अमूल्य है।
- विशाल डेटासेट के लिए स्केलेबल: क्योंकि एआई और मशीन लर्निंग अनुप्रयोगों में डेटा की मात्रा बढ़ रही है, वेक्टर डेटाबेस को बड़े पैमाने पर डेटा को संभालने के लिए डिज़ाइन किया गया है। यह सुनिश्चित करता है कि वे विशाल डेटासेट को संभालने में सक्षम हैं और प्रदर्शन से समझौता नहीं करते हैं।
पारंपरिक डेटाबेस:
- संरचित डेटा संग्रहण: पारंपरिक डेटाबेस, जैसे कि रिलेशनल डेटाबेस, संरचित डेटा को संग्रहीत करने के लिए डिज़ाइन किए गए हैं। इसका मतलब है कि डेटा को पूर्व-निर्धारित तालिकाओं, पंक्तियों और कॉलम में व्यवस्थित किया जाता है, जो डेटा अखंडता और संगतता सुनिश्चित करता है।
- सीआरयूडी ऑपरेशन के लिए अनुकूलित: पारंपरिक डेटाबेस मुख्य रूप से सीआरयूडी (स्रजन, पढ़ने, अद्यतन और विलोपन) ऑपरेशन के लिए अनुकूलित होते हैं। इसका मतलब है कि वे डेटा एंट्री बनाने, पढ़ने, अद्यतन करने और मिटाने में कुशल होते हैं, जो विभिन्न अनुप्रयोगों के लिए उपयुक्त होते हैं, वेब सेवाओं से लेकर उद्यम सॉफ़्टवेयर तक।
- निश्चित स्कीमा: पारंपरिक डेटाबेस की एक विशेषता यह है कि उनके पास एक निश्चित स्कीमा होती है। एक बार जब डेटाबेस संरचना परिभाषित हो जाती है, तो इसे बदलना जटिल और समय लेने वाला हो सकता है। यह सख्तता डेटा संगतता सुनिश्चित करती है लेकिन आधुनिक डेटाबेस की तुलना में कम लचीला हो सकता है।
पारंपरिक डेटाबेस अक्सर एम्बेडिंग की जटिलता से जूझते हैं, जिसे वेक्टर डेटाबेस आसानी से संबोधित करते हैं।
वेक्टर प्रतिनिधित्व
वेक्टर डेटाबेस के कामकाज में मूलभूत अवधारणा विभिन्न प्रकार के डेटा को संख्यात्मक वेक्टर के रूप में प्रस्तुत करना है। आइए एक छवि का उदाहरण लें। जब आप एक बिल्ली की तस्वीर देखते हैं, तो यह आपके लिए एक प्यारी बिल्ली की तस्वीर हो सकती है, लेकिन मशीन के लिए यह एक अद्वितीय 512-आयामी वेक्टर हो सकती है जैसे:
[0.23, 0.54, 0.32, …, 0.12, 0.45, 0.90]
वेक्टर डेटाबेस के साथ, जनरेटिव एआई अनुप्रयोग अधिक कार्य कर सकते हैं। यह अर्थ के आधार पर जानकारी खोज सकता है और लंबे समय तक चीजों को याद रख सकता है। दिलचस्प बात यह है कि यह विधि केवल छवियों तक ही सीमित नहीं है। संदर्भ और अर्थ से भरपूर पाठ डेटा को भी वेक्टर रूप में रखा जा सकता है।
जनरेटिव एआई और वेक्टर डेटाबेस की आवश्यकता
जनरेटिव एआई अक्सर एम्बेडिंग शामिल करता है। उदाहरण के लिए, प्राकृतिक भाषा प्रसंस्करण (एनएलपी) में शब्द एम्बेडिंग। शब्द या वाक्य वेक्टर में परिवर्तित हो जाते हैं जो अर्थ संबंधी अर्थ को पकड़ लेते हैं। जब मानव-जैसा पाठ उत्पन्न करने वाले मॉडल को तेजी से समान एम्बेडिंग की तुलना और पुनर्प्राप्ति करने की आवश्यकता होती है, ताकि उत्पन्न पाठ संदर्भ संबंधी अर्थों को बनाए रखे।
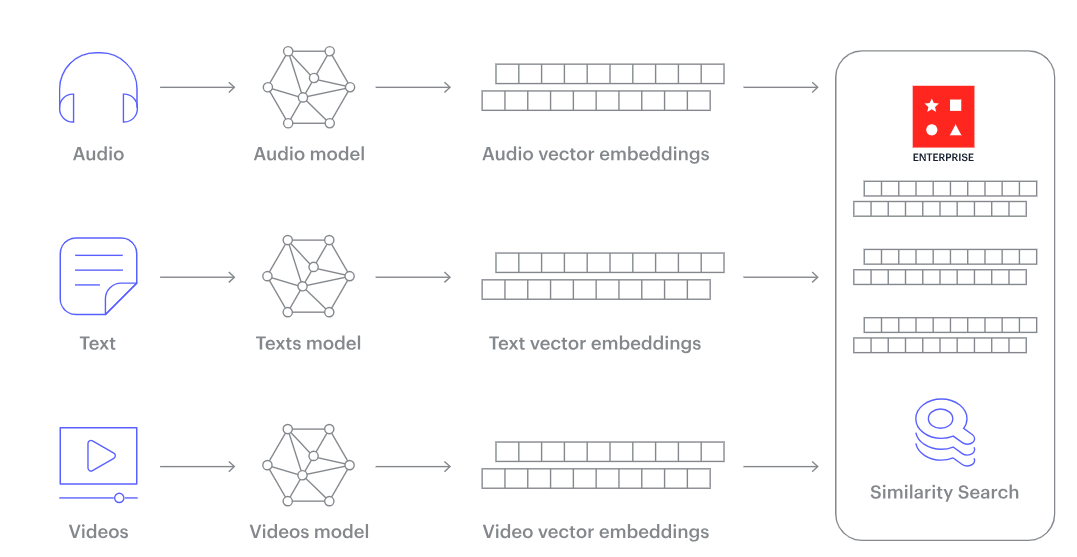
इसी तरह, छवि या ध्वनि उत्पादन में, एम्बेडिंग पैटर्न और विशेषताओं को एन्कोड करने में एक महत्वपूर्ण भूमिका निभाती है। इन मॉडलों के लिए ऑप्टिमल रूप से काम करने के लिए, उन्हें एक डेटाबेस की आवश्यकता होती है जो समान वेक्टर की तुरंत पुनर्प्राप्ति की अनुमति देता है, जिससे वेक्टर डेटाबेस जनरेटिव एआई पज़ल का एक आवश्यक घटक बन जाता है।
एम्बेडिंग बनाने के लिए प्राकृतिक भाषा में अक्सर पूर्व-प्रशिक्षित मॉडल का उपयोग किया जाता है:
- जीपीटी-3 और जीपीटी-4: ओपनएआई का जीपीटी-3 (जनरेटिव प्री-ट्रेन्ड ट्रांसफॉर्मर 3) एनएलपी समुदाय में एक महत्वपूर्ण मॉडल रहा है, जिसमें 175 बिलियन पैरामीटर हैं। इसके बाद जीपीटी-4, जिसमें पैरामीटर की संख्या और भी अधिक है, उच्च गुणवत्ता वाले एम्बेडिंग बनाने में सीमाओं को आगे बढ़ाता है। ये मॉडल विविध डेटासेट पर प्रशिक्षित होते हैं, जो उन्हें व्यापक भाषाई नुांसों को पकड़ने में सक्षम बनाते हैं।
- बीईआरटी और इसके संस्करण: बीईआरटी (बिडायरेक्शनल एन्कोडर रिप्रेजेंटेशन फ्रॉम ट्रांसफॉर्मर) गूगल द्वारा एक और महत्वपूर्ण मॉडल है, जिसमें रोबर्टा, डिस्टिलबीईआरटी जैसे कई संस्करण हैं। बीईआरटी का बिडायरेक्शनल प्रशिक्षण, जो पाठ को दोनों दिशाओं में पढ़ता है, संदर्भ को समझने में विशेष रूप से कुशल है।
- इलेक्ट्रा: एक हालिया मॉडल जो कुशल है और बड़े मॉडल जैसे जीपीटी-3 और बीईआरटी के समान प्रदर्शन करता है, लेकिन कम गणना संसाधनों की आवश्यकता होती है। इलेक्ट्रा पूर्व-प्रशिक्षण के दौरान वास्तविक और नकली डेटा के बीच भेदभाव करता है, जो अधिक परिष्कृत एम्बेडिंग के उत्पादन में मदद करता है।

उपरोक्त प्रक्रिया को समझना:
प्रारंभ में, एक एम्बेडिंग मॉडल का उपयोग वांछित सामग्री को वेक्टर एम्बेडिंग में परिवर्तित करने के लिए किया जाता है। एक बार उत्पन्न होने के बाद, इन एम्बेडिंग को वेक्टर डेटाबेस में संग्रहीत किया जाता है। आसान ट्रेसबिलिटी और प्रासंगिकता के लिए, इन संग्रहीत एम्बेडिंग में उनके मूल सामग्री से जुड़ी एक लिंक या संदर्भ बना रहता है।
(MSFT )बाद में, जब कोई उपयोगकर्ता या प्रणाली अनुप्रयोग से एक प्रश्न पूछता है, तो वही एम्बेडिंग मॉडल कार्रवाई में आता है। यह प्रश्न को संबंधित एम्बेडिंग में परिवर्तित करता है। इन नए एम्बेडिंग को तब वेक्टर डेटाबेस में खोजा जाता है, जहां वे समान वेक्टर प्रतिनिधित्व की तलाश करते हैं। पहचाने गए मेल का सीधा संबंध उनकी मूल सामग्री से होता है, जिससे उपयोगकर्ता के प्रश्न का उत्तर सटीक और प्रासंगिक परिणामों के साथ मिलता है।
वेक्टर डेटाबेस न्यूकमर्स के लिए बढ़ता निवेश
एआई की बढ़ती लोकप्रियता के साथ, कई कंपनियां अपने अल्गोरिदम को बेहतर और तेज बनाने के लिए वेक्टर डेटाबेस में अधिक पैसा लगा रही हैं। यह वेक्टर डेटाबेस स्टार्टअप जैसे पाइनकोन, क्रोमा डीबी, और वेविएट में हालिया निवेश के साथ देखा जा सकता है।
(ORCL )
बड़ी कंपनियों जैसे माइक्रोसॉफ्ट के पास भी अपने उपकरण हैं। उदाहरण के लिए, एज़्योर कॉग्निटिव सर्च व्यवसायों को वेक्टर डेटाबेस का उपयोग करके एआई टूल बनाने की अनुमति देता है।
ओरेकल ने हाल ही में अपने डेटाबेस 23सी के लिए नए फीचर्स की घोषणा की, जिसमें एक एकीकृत वेक्टर डेटाबेस शामिल है। नाम “एआई वेक्टर सर्च” का उपयोग करके, यह डेटा को वेक्टर के रूप में संग्रहीत और खोज करने के लिए एक नया डेटा प्रकार, इंडेक्स और खोज उपकरण प्रदान करेगा, जिसमें दस्तावेज़ और छवियां शामिल हैं। यह रिट्रीवल ऑगमेंटेड जेनरेशन (आरएजी) का समर्थन करता है, जो बड़े भाषा मॉडल को व्यवसायिक डेटा के साथ जोड़ता है ताकि भाषा प्रश्नों के उत्तर देने में सुधार किया जा सके, बिना निजी डेटा साझा किए।
वेक्टर डेटाबेस के प्राथमिक विचार
दूरी मेट्रिक्स
समानता खोज की प्रभावशीलता चुने हुए दूरी मेट्रिक्स पर निर्भर करती है। सामान्य मेट्रिक्स में यूक्लिडियन दूरी और कोसाइन समानता शामिल हैं, जो विभिन्न प्रकार के वेक्टर वितरण के लिए उपयुक्त हैं।
इंडेक्सिंग
वेक्टर की उच्च-आयामिता को देखते हुए, पारंपरिक इंडेक्सिंग विधियाँ उपयुक्त नहीं हैं। वेक्टर डेटाबेस हायरार्किकल नेविगेबल स्मॉल वर्ल्ड (एचएनएसडब्ल्यू) ग्राफ या एनोय ट्री जैसी तकनीकों का उपयोग करते हैं, जो वेक्टर स्पेस को कुशलतापूर्वक विभाजित करने और तेजी से निकटतम पड़ोसी खोज की अनुमति देते हैं।

एनोय ट्री (स्रोत)
एनोय एक ऐसी विधि है जो बाइनरी सर्च ट्री का उपयोग करती है। यह हमारे डेटा स्पेस को कई बार विभाजित करती है और केवल एक हिस्से को देखती है ताकि निकटतम पड़ोसी को ढूंढा जा सके।
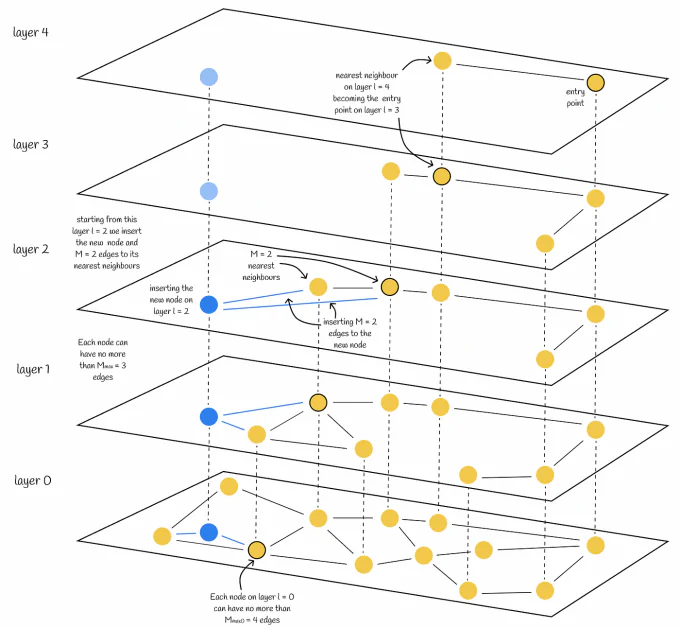
हायरार्किकल नेविगेबल स्मॉल वर्ल्ड (एचएनएसडब्ल्यू) ग्राफ (स्रोत)
एचएनएसडब्ल्यू ग्राफ, दूसरी ओर, नेटवर्क की तरह हैं। वे डेटा बिंदुओं को एक विशेष तरीके से जोड़ते हैं ताकि खोज तेजी से हो सके। ये ग्राफ तेजी से निकटतम बिंदुओं को खोजने में मदद करते हैं।
स्केलेबिलिटी
जैसे-जैसे डेटासेट बढ़ते हैं, तेजी से पुनर्प्राप्ति समय बनाए रखने की चुनौती भी बढ़ जाती है। वितरित प्रणाली, जीपीयू त्वरण, और अनुकूलित मेमोरी प्रबंधन वेक्टर डेटाबेस द्वारा स्केलेबिलिटी से निपटने के कुछ तरीके हैं।
वेक्टर डेटाबेस की भूमिका: निहितार्थ और अवसर
1. आगामी जनरेटिव एआई मॉडल के लिए प्रशिक्षण डेटा: जनरेटिव एआई मॉडल, जैसे कि डीएलएल-ई और जीपीटी-3, विशाल डेटासेट पर प्रशिक्षित होते हैं। यह डेटा अक्सर विभिन्न स्रोतों से वेक्टर को निकालता है, जिसमें छवियां, पाठ, कोड और अन्य डोमेन शामिल हैं। वेक्टर डेटाबेस इन डेटासेट को सावधानीपूर्वक प्रबंधित और व्यवस्थित करते हैं, जिससे एआई मॉडल विश्व के ज्ञान को आत्मसात कर सकते हैं और वेक्टर के भीतर पैटर्न और संबंधों का विश्लेषण कर सकते हैं।
2. फ्यू-शॉट लर्निंग को आगे बढ़ाना: फ्यू-शॉट लर्निंग एक एआई प्रशिक्षण तकनीक है जहां मॉडल को बहुत कम डेटा पर प्रशिक्षित किया जाता है। वेक्टर डेटाबेस इस दृष्टिकोण को बढ़ावा देते हैं bằng एक मजबूत वेक्टर इंडेक्स बनाए रखना। जब एक मॉडल को कुछ वेक्टर दिखाए जाते हैं – जैसे कि कुछ पक्षी की तस्वीरें – तो यह तेजी से व्यापक अवधारणा को समझने में सक्षम होता है कि पक्षी क्या हैं और इन वेक्टरों के बीच समानता और संबंधों को पहचानकर।
3. रिकमेंडेशन सिस्टम में सुधार: रिकमेंडेशन सिस्टम वेक्टर डेटाबेस का उपयोग करके उपयोगकर्ता की पसंद के अनुसार सामग्री की सिफारिश करते हैं। उपयोगकर्ता के व्यवहार, प्रोफ़ाइल और प्रश्नों का विश्लेषण करके, उनके हितों को दर्शाने वाले वेक्टर निकाले जाते हैं। प्रणाली तब वेक्टर डेटाबेस में खोजती है ताकि वह सामग्री वेक्टर ढूंढ सके जो इन हित वेक्टरों के समान हों, सुनिश्चित करते हुए कि सिफारिशें सटीक हों।
4. सेमेंटिक जानकारी पुनर्प्राप्ति: पारंपरिक खोज विधियां सटीक कीवर्ड मिलान पर निर्भर करती हैं। हालांकि, वेक्टर डेटाबेस प्रणाली को खोज को अधिक सार्थक बनाने में सक्षम बनाते हैं, जो प्रश्न के अर्थ को समझने पर केंद्रित होती है, न कि केवल इसके शब्दों के मिलान पर। जब उपयोगकर्ता एक प्रश्न दर्ज करते हैं, तो संबंधित वेक्टर की तुलना डेटाबेस में वेक्टर से की जाती है, जो प्रश्न के इरादे से मेल खाते हैं, न कि केवल इसके शब्दों से।
5. मल्टीमॉडल खोज: मल्टीमॉडल खोज एक उभरती हुई तकनीक है जो विभिन्न स्रोतों से डेटा को एकीकृत करती है, जैसे कि पाठ, छवियां, ऑडियो और वीडियो। वेक्टर डेटाबेस इस दृष्टिकोण के लिए आधार प्रदान करते हैं क्योंकि वे विभिन्न मॉडलिटी से वेक्टर के संयुक्त विश्लेषण की अनुमति देते हैं। इसके परिणामस्वरूप एक समग्र खोज अनुभव होता है, जहां उपयोगकर्ता एक ही प्रश्न के आधार पर विभिन्न स्रोतों से जानकारी प्राप्त कर सकते हैं, जिससे समृद्ध अंतर्दृष्टि और व्यापक परिणाम मिलते हैं।
निष्कर्ष
एआई की दुनिया तेजी से बदल रही है। यह कई उद्योगों को छू रहा है, नई चुनौतियों के साथ-साथ नए अवसर भी ला रहा है। जनरेटिव एआई में तेजी से प्रगति वेक्टर डेटाबेस की महत्वपूर्ण भूमिका को रेखांकित करती है जो बहु-आयामी डेटा को प्रबंधित और विश्लेषण करने में मदद करते हैं।
वे विशेष भंडारण प्रणाली हैं जो उच्च-आयामी वेक्टर को संभालने में सक्षम होती हैं, जो विभिन्न प्रकार के डेटा जैसे छवियों, पाठ या ध्वनि को संख्यात्मक वेक्टर रूप में प्रस्तुत करती हैं।


