

एआई मॉडल और प्लेटफ़ॉर्म
SEER: स्व-पर्यवेक्षित कंप्यूटर विजन मॉडल में एक बड़ी सफलता?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
पिछले दशक में, आर्टिफिशियल इंटेलिजेंस (एआई) और मशीन लर्निंग (एमएल) ने बहुत प्रगति की है। आज, वे अधिक सटीक, कुशल और सक्षम हैं जितना वे कभी थे। आधुनिक एआई और एमएल मॉडल छवियों या वीडियो फ़ाइलों में वस्तुओं को सटीक रूप से पहचान सकते हैं। इसके अलावा, वे मानव बुद्धिमत्ता के समानांतर पाठ और भाषण उत्पन्न कर सकते हैं।
आज के एआई और एमएल मॉडल लेबल वाले डेटासेट पर प्रशिक्षण पर बहुत अधिक निर्भर होते हैं जो उन्हें यह सिखाते हैं कि पाठ के ब्लॉक की व्याख्या कैसे करें, छवि या वीडियो फ्रेम में वस्तुओं की पहचान कैसे करें और कई अन्य कार्य करें।
हालांकि उनकी क्षमताओं के बावजूद, एआई और एमएल मॉडल परिपूर्ण नहीं हैं, और वैज्ञानिक ऐसे मॉडल बनाने के लिए काम कर रहे हैं जो दी गई जानकारी से सीख सकते हैं, और लेबल वाले या एनोटेटेड डेटा पर निर्भर नहीं करते हैं। इस दृष्टिकोण को स्व-पर्यवेक्षित लर्निंग कहा जाता है, और यह एमएल और एआई मॉडल बनाने के लिए सबसे कुशल तरीकों में से एक है जो “सामान्य ज्ञान” या पृष्ठभूमि ज्ञान रखते हैं जो आज के एआई मॉडल की क्षमताओं से परे समस्याओं का समाधान कर सकते हैं।
स्व-पर्यवेक्षित लर्निंग ने पहले से ही प्राकृतिक भाषा प्रसंस्करण में अपने परिणाम दिखाए हैं क्योंकि यह विकसितकर्ताओं को बड़े मॉडल को प्रशिक्षित करने की अनुमति देता है जो एक बड़ी मात्रा में डेटा के साथ काम कर सकते हैं, और प्राकृतिक भाषा अनुमान, मशीन अनुवाद और प्रश्न उत्तर देने जैसे क्षेत्रों में कई सफलताएं हासिल की हैं।
फेसबुक (META ) एआई द्वारा सीर मॉडल कंप्यूटर विजन क्षेत्र में स्व-पर्यवेक्षित लर्निंग की क्षमताओं को अधिकतम करने का लक्ष्य रखता है। सीर या सेल्फ-सुपरवाइज्ड एक स्व-पर्यवेक्षित कंप्यूटर विजन लर्निंग मॉडल है जिसमें एक अरब से अधिक पैरामीटर हैं, और यह इंटरनेट पर पाए जाने वाले यादृच्छिक समूह की छवियों से पैटर्न खोजने या सीखने में सक्षम है, उचित एनोटेशन या लेबल की आवश्यकता के बिना।
कंप्यूटर विजन में स्व-पर्यवेक्षित लर्निंग की आवश्यकता
डेटा एनोटेशन या डेटा लेबलिंग मशीन लर्निंग और आर्टिफिशियल इंटेलिजेंस मॉडल के विकास में प्री-प्रोसेसिंग चरण है। डेटा एनोटेशन प्रक्रिया कच्चे डेटा जैसे छवियों या वीडियो फ्रेम की पहचान करती है, और फिर डेटा पर लेबल जोड़ती है ताकि मॉडल को डेटा के संदर्भ को निर्दिष्ट किया जा सके। ये लेबल मॉडल को डेटा पर सटीक पूर्वानुमान लगाने की अनुमति देते हैं।
कंप्यूटर विजन मॉडल पर काम करने वाले विकसितकर्ताओं के सामने सबसे बड़ी बाधा और चुनौती उच्च गुणवत्ता वाले एनोटेटेड डेटा खोजना है। आज के कंप्यूटर विजन मॉडल लेबल वाले या एनोटेटेड डेटासेट पर निर्भर करते हैं ताकि वे छवि में वस्तुओं को पहचानने के लिए पैटर्न सीख सकें।
डेटा एनोटेशन, और कंप्यूटर विजन मॉडल में इसका उपयोग निम्नलिखित चुनौतियों को प्रस्तुत करता है:
संगत डेटासेट गुणवत्ता का प्रबंधन
विकसितकर्ताओं के सामने सबसे बड़ी बाधा उच्च गुणवत्ता वाले डेटासेट तक निरंतर पहुंच प्राप्त करना है क्योंकि उच्च गुणवत्ता वाले डेटासेट जिसमें उचित लेबल और स्पष्ट छवियां होती हैं, बेहतर शिक्षा और सटीक मॉडल का परिणाम होता है। हालांकि, उच्च गुणवत्ता वाले डेटासेट तक निरंतर पहुंच प्राप्त करने की अपनी चुनौतियां हैं।
वर्कफोर्स मैनेजमेंट
डेटा लेबलिंग अक्सर वर्कफोर्स मैनेजमेंट समस्याओं के साथ आता है, मुख्य रूप से क्योंकि बड़ी मात्रा में असंरचित और बिना लेबल वाला डेटा को संसाधित और लेबल करने के लिए एक बड़ी संख्या में श्रमिकों की आवश्यकता होती है, जबकि गुणवत्ता के साथ मात्रा के बीच संतुलन बनाए रखना आवश्यक है।
वित्तीय प्रतिबंध
संभवतः सबसे बड़ी बाधा डेटा लेबलिंग प्रक्रिया के साथ जुड़े वित्तीय प्रतिबंध हैं, और अधिकांश समय, डेटा लेबलिंग लागत परियोजना की कुल लागत का एक महत्वपूर्ण प्रतिशत होती है।
जैसा कि आप देख सकते हैं, डेटा एनोटेशन कंप्यूटर विजन मॉडल के विकास में एक बड़ी बाधा है, खासकर जब जटिल मॉडल विकसित करने की बात आती है जो बड़ी मात्रा में प्रशिक्षण डेटा के साथ काम करते हैं। यही कारण है कि कंप्यूटर विजन उद्योग को जटिल और उन्नत कंप्यूटर विजन मॉडल विकसित करने के लिए स्व-पर्यवेक्षित लर्निंग की आवश्यकता है जो वर्तमान मॉडल की क्षमताओं से परे कार्य कर सकते हैं।
यह कहा जा रहा है, कंप्यूटर विजन में स्व-पर्यवेक्षित लर्निंग के लिए पहले से ही कई मॉडल हैं जो नियंत्रित वातावरण में अच्छा प्रदर्शन कर रहे हैं, और मुख्य रूप से इमेजनेट डेटासेट पर। हालांकि ये मॉडल अच्छा काम कर सकते हैं, वे कंप्यूटर विजन में स्व-पर्यवेक्षित लर्निंग की प्राथमिक शर्त को पूरा नहीं करते हैं: किसी भी अनबाउंड डेटासेट या यादृच्छिक छवि से सीखना, न कि केवल एक अच्छी तरह से परिभाषित डेटासेट से। जब आदर्श रूप से लागू किया जाता है, तो स्व-पर्यवेक्षित लर्निंग अधिक सटीक और कुशल कंप्यूटर विजन मॉडल विकसित करने में मदद कर सकती है जो लागत प्रभावी और व्यावहारिक भी हैं।
सीर या सेल्फ-सुपरवाइज्ड मॉडल: एक परिचय
एआई और एमएल उद्योग में हाल के रुझानों से पता चलता है कि मॉडल प्री-प्रशिक्षण दृष्टिकोण जैसे सेमी-सुपरवाइज्ड, कमजोर-पर्यवेक्षित और स्व-पर्यवेक्षित लर्निंग गहरे शिक्षण मॉडल के प्रदर्शन में काफी सुधार कर सकते हैं डाउनस्ट्रीम कार्यों के लिए।
इन गहरे शिक्षण मॉडल के प्रदर्शन में सुधार के लिए दो मुख्य कारक हैं जिन्होंने बड़ा योगदान दिया है:
विशाल डेटासेट पर प्री-प्रशिक्षण
विशाल डेटासेट पर प्री-प्रशिक्षण आमतौर पर बेहतर सटीकता और प्रदर्शन का परिणाम होता है क्योंकि यह मॉडल को विभिन्न डेटा के संपर्क में लाता है। बड़ा डेटासेट मॉडल को डेटा में पैटर्न को बेहतर ढंग से समझने में मदद करता है, और अंततः वास्तविक दुनिया के दृश्यों में मॉडल के प्रदर्शन में सुधार होता है।
कुछ सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल जैसे जीपीटी-3 मॉडल और वेव2वेक 2.0 मॉडल विशाल डेटासेट पर प्रशिक्षित होते हैं। जीपीटी-3 भाषा मॉडल में 300 अरब शब्दों से अधिक का प्री-प्रशिक्षण डेटासेट है, जबकि वेव2वेक 2.0 मॉडल में 53,000 घंटे से अधिक ऑडियो डेटा है।
विशाल क्षमता वाले मॉडल
अधिक पैरामीटर वाले मॉडल अक्सर सटीक परिणाम देते हैं क्योंकि अधिक पैरामीटर मॉडल को डेटा में हस्तक्षेप या शोर पर ध्यान केंद्रित करने के बजाय डेटा में आवश्यक वस्तुओं पर ध्यान केंद्रित करने की अनुमति देते हैं।
विकसितकर्ताओं ने पहले अनलेबल्ड या अनक्यूरेटेड डेटा पर स्व-पर्यवेक्षित लर्निंग मॉडल को प्रशिक्षित करने का प्रयास किया है, लेकिन छोटे डेटासेट के साथ जिसमें केवल कुछ मिलियन छवियां हैं।लेकिन क्या स्व-पर्यवेक्षित लर्निंग मॉडल उच्च सटीकता प्राप्त कर सकते हैं जब उन्हें बड़ी मात्रा में अनलेबल्ड और अनक्यूरेटेड डेटा पर प्रशिक्षित किया जाता है? यह वह प्रश्न है जिसका उत्तर सीर मॉडल देने का प्रयास करता है।
सीर मॉडल एक गहरे शिक्षण ढांचा है जो क्यूरेटेड या लेबल वाले डेटासेट की परवाह किए बिना इंटरनेट पर उपलब्ध छवियों को पंजीकृत करने का लक्ष्य रखता है। सीर ढांचा विकसितकर्ताओं को बड़े और जटिल एमएल मॉडल को यादृच्छिक डेटा पर बिना किसी पर्यवेक्षण के प्रशिक्षित करने की अनुमति देता है, अर्थात मॉडल स्वयं डेटा का विश्लेषण करता है और बिना किसी मैनुअल इनपुट के पैटर्न या जानकारी सीखता है।
सीर मॉडल का अंतिम लक्ष्य प्री-प्रशिक्षण प्रक्रिया के लिए रणनीतियों को विकसित करने में मदद करना है जो अनक्यूरेटेड डेटा का उपयोग करके हस्तांतरण शिक्षण में शीर्ष-स्तरीय प्रदर्शन प्रदान करता है। इसके अलावा, सीर मॉडल निरंतर सीखने वाले प्रणालियों का निर्माण करने का भी लक्ष्य रखता है जो डेटा की एक अंतहीन धारा से स्वयं-पर्यवेक्षित तरीके से सीख सकते हैं। सीर ढांचे को बड़ी क्षमता वाले मॉडल को यादृच्छिक और अनक्यूरेटेड छवियों पर प्रशिक्षित किया जाता है जो इंटरनेट से निकाले जाते हैं। इन छवियों पर प्रशिक्षित मॉडल छवि मेटाडेटा या एनोटेशन पर निर्भर नहीं करते हैं या डेटा को फिल्टर करने के लिए। हाल के समय में, स्व-पर्यवेक्षित लर्निंग ने डाउनस्ट्रीम कार्यों के लिए पर्यवेक्षित ढंग से पूर्व-प्रशिक्षित मॉडल की तुलना में बेहतर परिणाम दिखाए हैं जब मॉडल को अनक्यूरेटेड डेटा पर प्रशिक्षित किया जाता है।
यह ध्यान देने योग्य है कि डेटासेट स्थिर नहीं है, और डेटासेट में छवियां हर तीन महीने में ताज़ा की जाती हैं। हालांकि, डेटासेट को ताज़ा करने से मॉडल के प्रदर्शन पर कोई प्रभाव नहीं पड़ता है।
सीर ढांचे और रेगनेट: क्या है कनेक्शन?
सीर मॉडल का विश्लेषण करने के लिए, यह रेगनेट आर्किटेक्चर पर केंद्रित है जिसमें 700 मिलियन पैरामीटर हैं जो सीर के स्व-पर्यवेक्षित लर्निंग पर अनक्यूरेटेड डेटा के लक्ष्य के साथ संरेखित होते हैं दो प्राथमिक कारणों से:
- वे प्रदर्शन और दक्षता के बीच एक आदर्श संतुलन प्रदान करते हैं।
- वे बहुत लचीले हैं, और पैरामीटर की संख्या के लिए स्केल करने के लिए उपयोग किए जा सकते हैं।

सीर ढांचा: विभिन्न क्षेत्रों से पूर्व कार्य
सीर ढांचे का उद्देश्य बड़े मॉडल आर्किटेक्चर को अनक्यूरेटेड या अलेबल्ड डेटासेट पर स्व-पर्यवेक्षित लर्निंग का उपयोग करके प्रशिक्षित करने की सीमाओं का अन्वेषण करना है, और मॉडल को विभिन्न क्षेत्रों में पूर्व कार्य से प्रेरणा लेता है।
दृश्य विशेषताओं का अनपर्यवेक्षित प्री-प्रशिक्षण
स्व-पर्यवेक्षित लर्निंग को कंप्यूटर विजन में कुछ समय के लिए लागू किया गया है जिसमें ऑटोएनकोडर, इंस्टेंस-लेवल भेदभाव, या क्लस्टरिंग जैसे तरीकों का उपयोग किया जाता है। हाल के समय में, कॉन्ट्रास्टिव लर्निंग का उपयोग करने वाले तरीकों ने संकेत दिया है कि डाउनस्ट्रीम कार्यों के लिए मॉडल को अनपर्यवेक्षित तरीके से प्रशिक्षित करना पर्यवेक्षित लर्निंग दृष्टिकोण से बेहतर प्रदर्शन कर सकता है।
दृश्य विशेषताओं के अनपर्यवेक्षित लर्निंग से मुख्य बात यह है कि जब तक आप फ़िल्टर्ड डेटा पर प्रशिक्षण ले रहे हैं, पर्यवेक्षित लेबल की आवश्यकता नहीं होती है। सीर मॉडल यह अन्वेषण करने का प्रयास करता है कि क्या मॉडल सटीक प्रतिनिधित्व सीख सकता है जब बड़े मॉडल आर्किटेक्चर को बड़ी मात्रा में अनक्यूरेटेड, अलेबल्ड और यादृच्छिक छवियों पर प्रशिक्षित किया जाता है।
दृश्य विशेषताओं को स्केल पर सीखना
पूर्व के मॉडलों ने कमजोर-पर्यवेक्षित लर्निंग, पर्यवेक्षित लर्निंग और सेमी-सुपरवाइज्ड लर्निंग पर लाखों फ़िल्टर्ड छवियों पर प्री-प्रशिक्षण से लाभान्वित हुए हैं। इसके अलावा, मॉडल विश्लेषण ने यह भी संकेत दिया है कि मॉडल को अरबों छवियों पर प्रशिक्षित करने से अकेले प्रशिक्षित मॉडल की तुलना में बेहतर सटीकता मिलती है।
इसके अलावा, मॉडल को बड़े पैमाने पर प्रशिक्षित करने के लिए आमतौर पर डेटा फ़िल्टरिंग चरणों पर निर्भर करता है ताकि छवियां लक्ष्य अवधारणाओं के साथ प्रतिध्वनित हों। ये फ़िल्टरिंग चरण या तो एक पूर्व-प्रशिक्षित वर्गीकारक की भविष्यवाणियों का उपयोग करते हैं, या इमेजनेट वर्गों के सिंसेट के रूप में हैशटैग का उपयोग करते हैं। सीर मॉडल अलग तरह से काम करता है क्योंकि यह किसी पूर्व निर्धारित सेट की विशेषताओं या अवधारणाओं से मेल खाने के लिए डेटा को क्यूरेट करने का प्रयास नहीं करता है।
छवि पहचान के लिए आर्किटेक्चर को स्केल करना
मॉडल आमतौर पर बड़े आर्किटेक्चर को बेहतर गुणवत्ता वाली दृश्य विशेषताओं पर प्रशिक्षित करने से लाभान्वित होते हैं। यह विशेष रूप से तब महत्वपूर्ण होता है जब प्री-प्रशिक्षण को कॉन्ट्रास्टिव लर्निंग के साथ किया जाता है क्योंकि इस मामले में मॉडल को डेटासेट के उदाहरणों के बीच भेदभाव सीखने की आवश्यकता होती है ताकि यह बेहतर दृश्य प्रतिनिधित्व सीख सके।
हालांकि, छवि पहचान के लिए आर्किटेक्चर को स्केल करना मॉडल की गहराई और चौड़ाई को बदलने से अधिक है। सीर मॉडल रेगनेट्स परिवार के मॉडल का उपयोग करके बड़े पैमाने पर स्व-पर्यवेक्षित लर्निंग के लाभों को दिखाता है।
सीर: विधियों और घटकों का उपयोग
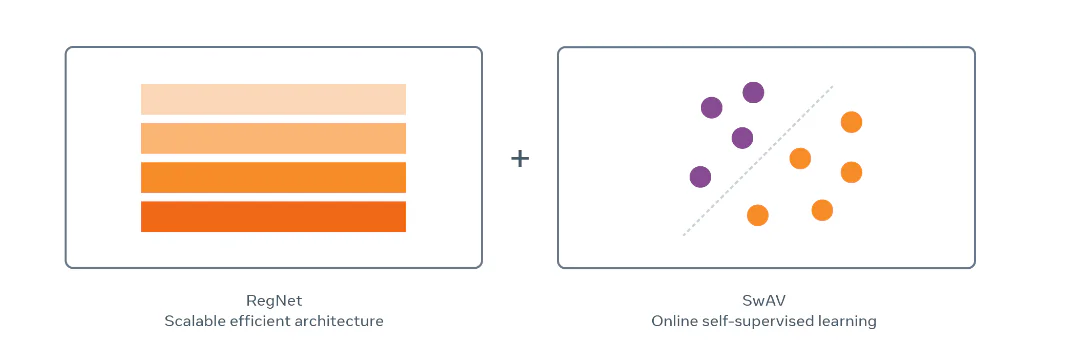
सीर ढांचे में दृश्य प्रतिनिधित्व सीखने के लिए मॉडल को प्री-प्रशिक्षित करने के लिए विभिन्न विधियों और घटकों का उपयोग किया जाता है। सीर ढांचे द्वारा उपयोग किए जाने वाले मुख्य विधियों और घटकों में से कुछ हैं: रेगनेट, और स्वाव। आइए सीर ढांचे में उपयोग की जाने वाली विधियों और घटकों पर संक्षेप में चर्चा करें।
स्वाव के साथ स्व-पर्यवेक्षित प्री-प्रशिक्षण
सीर ढांचे को स्वाव के साथ प्री-प्रशिक्षित किया जाता है, जो एक ऑनलाइन स्व-पर्यवेक्षित लर्निंग दृष्टिकोण है। स्वाव ऑनलाइन क्लस्टरिंग विधि है जिसका उपयोग कॉन्वनेट फ्रेमवर्क को बिना एनोटेशन के प्रशिक्षित करने के लिए किया जाता है। स्वाव ढांचा एक एम्बेडिंग का उत्पादन करके काम करता है जो एक ही छवि के विभिन्न दृश्यों के बीच संगत क्लस्टर असाइनमेंट उत्पन्न करता है। सिस्टम तब डेटा संवर्द्धन के प्रति अवरोधी क्लस्टर का खनन करके सेमांटिक प्रतिनिधित्व सीखता है।
अभ्यास में, स्वाव ढांचा एक छवि के विभिन्न दृश्यों की विशेषताओं की तुलना उनके स्वतंत्र क्लस्टर असाइनमेंट का उपयोग करके करता है। यदि ये असाइनमेंट समान या समान विशेषताओं को पकड़ते हैं, तो एक छवि के असाइनमेंट की भविष्यवाणी दूसरे दृश्य की विशेषता का उपयोग करके की जा सकती है।
SEER मॉडल K क्लस्टर मानता है। प्रत्येक क्लस्टर एक सीखने योग्य d-आयामी वेक्टर vk से जुड़ा होता है। B छवियों के बैच में प्रत्येक छवि i को दो व्यू, xi1 और xi2, में बदला जाता है। कॉन्वनेट इन व्यू से फीचर निकालता है, जिससे दो फीचर सेट (f11, …, fB2) और (f12, …, fB2) मिलते हैं। ऑप्टिमल ट्रांसपोर्ट सॉल्वर प्रत्येक फीचर सेट को स्वतंत्र रूप से क्लस्टर प्रोटोटाइप आवंटित करता है।
ऑप्टिमल ट्रांसपोर्ट सॉल्वर फीचर को क्लस्टरों में समान रूप से बांटता है और ऐसे तुच्छ समाधान से बचाता है जिसमें सभी प्रतिनिधित्व एक ही प्रोटोटाइप में पहुंच जाएं। फिर दोनों सेट के आवंटन आपस में बदले जाते हैं: व्यू xi1 के क्लस्टर आवंटन yi1 का पूर्वानुमान दूसरे व्यू xi2 के फीचर प्रतिनिधित्व fi2 से किया जाता है, और इसके विपरीत भी।
प्रोटोटाइप के भार और कॉन्वनेट को सभी उदाहरणों पर लॉस न्यूनतम करने के लिए प्रशिक्षित किया जाता है। क्लस्टर पूर्वानुमान लॉस l फीचर के डॉट प्रोडक्ट से प्राप्त सॉफ्टमैक्स और क्लस्टर आवंटन के बीच क्रॉस-एंट्रॉपी है।

रेगनेटवाई: स्केल कुशल मॉडल परिवार
मॉडल क्षमता को स्केल करना और डेटा की आवश्यकता उन आर्किटेक्चर की होती है जो न केवल मेमोरी के मामले में कुशल होते हैं, बल्कि रनटाइम और रेगनेट्स ढांचे के मामले में भी कुशल होते हैं जो विशेष रूप से इस उद्देश्य के लिए डिज़ाइन किए गए हैं।
रेगनेट परिवार की आर्किटेक्चर 4 चरणों के साथ परिभाषित की जाती है जहां प्रत्येक चरण में एक ही ब्लॉक की एक श्रृंखला होती है, जबकि ब्लॉक की संरचना को स्थिर रखा जाता है, मुख्य रूप से रेज़िडुअल बॉटलनेक ब्लॉक।
सीर ढांचा रेगनेटवाई आर्किटेक्चर पर केंद्रित है और मानक रेगनेट्स आर्किटेक्चर में एक स्क्वीज़-एंड-एक्ससिटेशन जोड़ने का प्रयास करता है ताकि उनके प्रदर्शन में सुधार किया जा सके। इसके अलावा, रेगनेटवाई मॉडल में 5 पैरामीटर होते हैं जो एक निश्चित संख्या में फ्लॉप्स के साथ अच्छे उदाहरणों की खोज में मदद करते हैं जो उचित संसाधनों का उपभोग करते हैं। सीर मॉडल अपने स्व-पर्यवेक्षित प्री-प्रशिक्षण कार्य पर सीधे रेगनेटवाई आर्किटेक्चर को लागू करके अपने परिणामों में सुधार करने का प्रयास करता है।
रेगनेटवाई 256जीएफ आर्किटेक्चर: सीर मॉडल मुख्य रूप से रेगनेटवाई परिवार में रेगनेटवाई 256जीएफ आर्किटेक्चर पर केंद्रित है, और इसके पैरामीटर रेगनेट्स आर्किटेक्चर के स्केलिंग नियम का उपयोग करते हैं। पैरामीटर निम्नलिखित हैं:

रेगनेटवाई 256जीएफ आर्किटेक्चर में 4 चरण हैं जिनकी चरण चौड़ाई (528, 1056, 2904, 7392) और चरण गहराई (2,7,17,1) है, जो 696 मिलियन पैरामीटर से अधिक हैं। 512 वी100 32जीबी एनवीडिया जीपीयू पर प्रशिक्षण के दौरान, प्रत्येक पुनरावृत्ति 8,704 छवियों के बैच आकार के लिए लगभग 6125एमएस लेती है। एक बिलियन से अधिक छवियों के डेटासेट पर मॉडल को प्रशिक्षित करने के लिए, 8,704 छवियों के बैच आकार के साथ 512 जीपीयू पर, 114,890 पुनरावृत्तियों की आवश्यकता होती है, और प्रशिक्षण लगभग 8 दिनों तक चलता है।
पैमाने पर अनुकूलन और प्रशिक्षण
सीर मॉडल स्व-पर्यवेक्षित तरीकों को लागू करने और उन्हें बड़े पैमाने पर अनुकूल बनाने के लिए कई समायोजन प्रस्तावित करता है। ये तरीके हैं:
- लर्निंग दर अनुसूची।
- प्रति जीपीयू मेमोरी की खपत को कम करना।
- प्रशिक्षण गति को अनुकूलित करना।
- बड़े पैमाने पर प्री-प्रशिक्षण डेटा।
आइए उन पर संक्षेप में चर्चा करें।
लर्निंग दर अनुसूची
सीर मॉडल दो लर्निंग दर अनुसूचियों का उपयोग करने की संभावना का अन्वेषण करता है: कोसाइन वेव लर्निंग दर अनुसूची, और निश्चित लर्निंग दर अनुसूची।
कोसाइन वेव लर्निंग अनुसूची का उपयोग विभिन्न मॉडलों की तुलना के लिए किया जाता है क्योंकि यह अद्यतनों की संख्या के अनुसार अनुकूलन करता है। हालांकि, कोसाइन वेव लर्निंग अनुसूची बड़े पैमाने पर प्रशिक्षण के लिए अनुकूल नहीं है क्योंकि यह प्रशिक्षण के दौरान छवियों को अलग तरह से वजन देता है, और यह शेड्यूलिंग के लिए पूर्ण अद्यतनों का उपयोग करता है।
निश्चित लर्निंग दर अनुसूची लर्निंग दर को तब तक निश्चित रखती है जब तक नुकसान गैर-घटता नहीं है, और फिर लर्निंग दर को 2 से विभाजित किया जाता है। विश्लेषण से पता चलता है कि निश्चित लर्निंग दर अनुसूची बेहतर काम करती है क्योंकि इसमें प्रशिक्षण को अधिक लचीला बनाने की गुंजाइश है। हालांकि, क्योंकि मॉडल केवल 1 बिलियन छवियों पर प्रशिक्षित होता है, यह अपने सबसे बड़े मॉडल, रेगनेट 256जीएफ को प्रशिक्षित करने के लिए कोसाइन वेव लर्निंग दर का उपयोग करता है।
प्रति जीपीयू मेमोरी की खपत को कम करना
मॉडल प्रशिक्षण अवधि के दौरान जीपीयू की आवश्यकता को कम करने के लिए मिश्रित सटीकता और ग्रेडिएंट चेकपॉइंटिंग का उपयोग करता है। मॉडल एनवीडिया एपेक्स लाइब्रेरी के ओ1 ऑप्टिमाइजेशन स्तर का उपयोग करके 16-बिट फ्लोटिंग पॉइंट सटीकता में संचालन जैसे कि कनवोल्यूशन और जीईएमएमएस करने के लिए करता है। मॉडल पायटॉर्च के ग्रेडिएंट चेकपॉइंटिंग कार्यान्वयन का भी उपयोग करता है जो स्मृति के लिए गणना का व्यापार करता है।
इसके अलावा, मॉडल अग्रिम पास के दौरान की गई किसी भी मध्यवर्ती सक्रियण को त्यागता है, और पीछे की ओर पास के दौरान इन सक्रियणों की पुनर्गणना करता है।
प्रशिक्षण गति को अनुकूलित करना
मेमोरी का उपयोग अनुकूलित करने के लिए मिश्रित सटीकता का उपयोग करने से प्रशिक्षण अवधि को तेज करने का अतिरिक्त लाभ है क्योंकि त्वरणकारी एफपी16 के कम आकार का लाभ उठाते हैं जब इसकी तुलना एफपी32 से की जाती है। यह मेमोरी-बैंडविथ बोतलनेक को बेहतर बनाने से प्रशिक्षण अवधि को तेज करने में मदद करता है।
सीर मॉडल बैचनॉर्म परत को जीपीयू के पार सिंक्रनाइज़ करता है ताकि प्रक्रिया समूह बनाए जा सकें; यह आम तौर पर अधिक समय लेने वाले वैश्विक सिंक्रनाइज़ेशन के बजाय किया जाता है। अंत में, सीर मॉडल द्वारा उपयोग किया जाने वाला डेटा लोडर प्रशिक्षण बैच की एक बड़ी मात्रा को पूर्व-लोड करता है जो पायटॉर्च के डेटा लोडर की तुलना में अधिक डेटा के माध्यम से जाने की अनुमति देता है।
बड़े पैमाने पर प्री-प्रशिक्षण डेटा
सीर मॉडल प्री-प्रशिक्षण के लिए 1 बिलियन से अधिक छवियों का उपयोग करता है, और यह एक डेटा लोडर का उपयोग करता है जो सीधे इंटरनेट और इंस्टाग्राम से यादृच्छिक छवियों का नमूना लेता है। क्योंकि सीर मॉडल इन छवियों को जंगली और ऑनलाइन प्रशिक्षित करता है, यह इन छवियों पर कोई पूर्व-प्रसंस्करण नहीं करता है और न ही उन्हें डी-डुप्लिकेशन या हैशटैग फिल्टरिंग जैसी प्रक्रियाओं का उपयोग करके क्यूरेट करता है।
यह ध्यान देने योग्य है कि डेटासेट स्थिर नहीं है, और डेटासेट में छवियां हर तीन महीने में ताज़ा की जाती हैं। हालांकि, डेटासेट को ताज़ा करने से मॉडल के प्रदर्शन पर कोई प्रभाव नहीं पड़ता है।
सीर मॉडल कार्यान्वयन
सीर मॉडल एक रेगनेटवाई 256जीएफ को स्वाव के साथ प्री-प्रशिक्षित करता है, प्रति छवि छवि के छह क्रॉप के साथ, प्रत्येक छवि का रिज़ॉल्यूशन 2×224 + 4×96 है। प्री-प्रशिक्षण चरण के दौरान, मॉडल एक 3-परत एमएलपी या मल्टी-लेयर परसेप्ट्रोन का उपयोग करता है जिसमें 10444×8192, 8192×8192, और 8192×256 के प्रोजेक्शन हेड होते हैं।
मॉडल हेड में बैचनॉर्म परतों के बजाय 16,000 प्रोटोटाइप का उपयोग करता है, और तापमान ती को 0.1 पर सेट किया जाता है। सिंखोरन नियमितीकरण पैरामीटर को 0.05 पर सेट किया जाता है, और यह अल्गोरिदम के 10 पुनरावृत्तियों को निष्पादित करता है। मॉडल जीपीयू के पार बैचनॉर्म सांख्यिकी को सिंक्रनाइज़ करता है, और 64 के आकार के साथ कई प्रक्रिया समूह बनाता है सिंक्रनाइजेशन के लिए।
इसके अलावा, मॉडल लार्स या लेयर-वाइज एडाप्टिव रेट स्केलिंग ऑप्टिमाइज़र, 10-5 का वजन क्षय, एक्टिवेशन चेकपॉइंट, और ओ1 मिश्रित-सटीकता अनुकूलन का उपयोग करता है। मॉडल तब 512 एनवीडिया जीपीयू पर 8,192 यादृच्छिक छवियों के बैच आकार के साथ स्टोकास्टिक ग्रेडिएंट डिसेंट का उपयोग करके प्रशिक्षित किया जाता है, जो प्रति जीपीयू 16 छवियों का परिणाम है।
लर्निंग दर पहले 8,000 प्रशिक्षण अद्यतनों के लिए 0.15 से 9.6 तक रैखिक रूप से बढ़ाई जाती है। वार्मअप के बाद, मॉडल एक कोसाइन लर्निंग दर अनुसूची का पालन करता है जो 0.0096 के अंतिम मान तक घट जाती है। कुल मिलाकर, सीर मॉडल 122,000 पुनरावृत्तियों पर 1 बिलियन छवियों पर प्रशिक्षित होता है।
सीर ढांचा: परिणाम
स्व-पर्यवेक्षित प्री-प्रशिक्षण दृष्टिकोण द्वारा उत्पन्न विशेषताओं की गुणवत्ता का अध्ययन और विश्लेषण विभिन्न बेंचमार्क और डाउनस्ट्रीम कार्यों पर किया जाता है। मॉडल एक कम-शॉट सेटिंग को भी मानता है जो डाउनस्ट्रीम कार्यों के लिए छवियों और उनके लेबल तक सीमित पहुंच प्रदान करता है।
बड़े पूर्व-प्रशिक्षित मॉडल को फाइन-ट्यूनिंग करना
यह इमेजनेट बेंचमार्क पर वस्तु वर्गीकरण के लिए मॉडल को स्थानांतरित करके यादृच्छिक डेटा पर पूर्व-प्रशिक्षित मॉडल की गुणवत्ता को मापता है। परिणाम निम्नलिखित मापदंडों पर निर्धारित किए जाते हैं:
प्रयोगात्मक सेटिंग
मॉडल 6 रेगनेट आर्किटेक्चर को स्वाव के साथ 1 बिलियन से अधिक सार्वजनिक इंस्टाग्राम छवियों पर प्रशिक्षित करता है, जिनमें विभिन्न क्षमताएं हैं: रेगनेटवाई-{8,16,32,64,128,256}जीएफ। मॉडल को फिर इमेजनेट पर वस्तु वर्गीकरण के उद्देश्य से फाइन-ट्यून किया जाता है, जिसमें 1.28 मिलियन मानक प्रशिक्षण छवियां होती हैं जिनमें उचित लेबल होते हैं, और 50,000 से अधिक छवियों का मानक सत्यापन सेट मूल्यांकन के लिए होता है।
मॉडल स्वाव के रूप में समान डेटा प्रसंस्करण तकनीकों को लागू करता है, और 35 प्रशिक्षण युगों (epochs) के लिए 0.0125 की लर्निंग दर के साथ एसजीडी ऑप्टिमाइज़र या स्टोकास्टिक ग्रेडिएंट डिसेंट के साथ फाइन-ट्यून करता है, जो 30 युगों के बाद 10 के कारक द्वारा कम हो जाता है, 0.9 की गति और 10-4 का वजन क्षय। मॉडल 224×224 के केंद्रीय फसल का उपयोग करके सत्यापन डेटासेट पर शीर्ष-1 सटीकता की रिपोर्ट करता है।
अन्य स्व-पर्यवेक्षित प्री-प्रशिक्षण दृष्टिकोणों की तुलना
निम्नलिखित तालिका में रेगनेटवाई-256जीएफ जैसे सबसे बड़े पूर्व-प्रशिक्षित मॉडल की तुलना स्व-पर्यवेक्षित लर्निंग दृष्टिकोण का उपयोग करने वाले मौजूदा पूर्व-प्रशिक्षित मॉडल से की जाती है।

जैसा कि आप देख सकते हैं, सीर मॉडल इमेजनेट पर 84.2% की शीर्ष-1 सटीकता प्राप्त करता है, और सिमसीएलआरवी2, सबसे अच्छा मौजूदा पूर्व-प्रशिक्षित मॉडल को 1% से पीछे छोड़ देता है।
इसके अलावा, निम्नलिखित आंकड़े सीर ढांचे की तुलना विभिन्न क्षमता वाले मॉडल से करते हैं। जैसा कि आप देख सकते हैं, मॉडल क्षमता की परवाह किए बिना, रेगनेट ढांचे को स्वाव के साथ जोड़ने से प्री-प्रशिक्षण के दौरान सटीक परिणाम मिलते हैं।

सीर मॉडल यादृच्छिक और सार्वजनिक छवियों पर प्री-प्रशिक्षित होता है, और इसमें रेगनेट आर्किटेक्चर और स्वाव स्व-पर्यवेक्षित लर्निंग तरीका है। सीर मॉडल की तुलना सिमसीएलआरवी2 और वीआईटी मॉडल से की जाती है, जिनमें विभिन्न नेटवर्क आर्किटेक्चर होते हैं। अंत में, मॉडल को इमेजनेट डेटासेट पर फाइन-ट्यून किया जाता है, और शीर्ष-1 सटीकता की रिपोर्ट की जाती है।
मॉडल क्षमता का प्रभाव
मॉडल क्षमता प्री-प्रशिक्षण के दौरान मॉडल के प्रदर्शन पर महत्वपूर्ण प्रभाव डालती है, और निम्नलिखित आंकड़े इसकी तुलना करते हैं जब मॉडल को स्क्रैच से प्रशिक्षित किया जाता है।

यह स्पष्ट रूप से देखा जा सकता है कि पूर्व-प्रशिक्षित मॉडल का शीर्ष-1 सटीकता स्कोर मॉडल को स्क्रैच से प्रशिक्षित करने की तुलना में अधिक है, और अंतर बड़ी संख्या में पैरामीटर के साथ बढ़ जाता है। यह भी स्पष्ट है कि हालांकि मॉडल क्षमता पूर्व-प्रशिक्षित और स्क्रैच से प्रशिक्षित दोनों मॉडलों के प्रदर्शन में सुधार करती है, पूर्व-प्रशिक्षित मॉडलों पर इसका प्रभाव अधिक होता है जब बड़ी संख्या में पैरामीटर की बात आती है।
एक संभावित कारण यह है कि इमेजनेट डेटासेट पर मॉडल को स्क्रैच से प्रशिक्षित करने से ओवरफिटिंग हो सकती है क्योंकि डेटासेट का आकार छोटा है।
कम-शॉट लर्निंग
कम-शॉट लर्निंग सीर मॉडल के प्रदर्शन का मूल्यांकन करने के लिए एक कम-शॉट सेटिंग को संदर्भित करता है, अर्थात केवल डाउनस्ट्रीम कार्यों के लिए छवियों और उनके लेबल तक सीमित पहुंच।
प्रयोगात्मक सेटिंग
सीर ढांचे में दो डेटासेट का उपयोग कम-शॉट लर्निंग के लिए किया जाता है, अर्थात प्लेस205 और इमेजनेट। इसके अलावा, मॉडल मानता है कि डाउनस्ट्रीम कार्यों के लिए छवियों और उनके लेबल दोनों तक सीमित पहुंच है। यह सीमित पहुंच सेटिंग स्व-पर्यवेक्षित लर्निंग के लिए डिफ़ॉल्ट सेटिंग से अलग है, जहां मॉडल को पूरे डेटासेट तक पहुंच होती है, और केवल छवि लेबल तक पहुंच सीमित होती है।
प्लेस205 डेटासेट पर परिणाम
निम्नलिखित आंकड़े प्लेस205 डेटासेट पर प्री-प्रशिक्षण के दौरान मॉडल के प्रदर्शन को दर्शाते हैं।

दृष्टिकोण की तुलना उसी रेगनेटवाई-128जीएफ आर्किटेक्चर के साथ की जाती है जो इमेजनेट डेटासेट पर पर्यवेक्षित रूप से प्री-प्रशिक्षित होता है। परिणाम आश्चर्यजनक हैं क्योंकि यह देखा जा सकता है कि प्लेस205 डेटासेट पर फाइन-ट्यूनिंग के लिए उपलब्ध प्रशिक्षण डेटा के हिस्से की परवाह किए बिना लगभग 2.5% की स्थिर लाभ है।
पर्यवेक्षित और स्व-पर्यवेक्षित प्री-प्रशिक्षण प्रक्रियाओं के बीच अंतर को दिया जा सकता है क्योंकि प्रशिक्षण डेटा की प्रकृति में अंतर है। जंगली छवियों से सीखे गए विशेषताएं दृश्य को वर्गीकृत करने के लिए अधिक उपयुक्त हो सकती हैं। इसके अलावा, प्लेस205 जैसे असंतुलित डेटासेट के लिए प्री-प्रशिक्षण का लाभ हो सकता है।
इमेजनेट पर परिणाम

उपरोक्त तालिका सीर मॉडल के दृष्टिकोण की तुलना स्व-पर्यवेक्षित प्री-प्रशिक्षण दृष्टिकोणों और सेमी-सुपरवाइज्ड दृष्टिकोणों के साथ कम-शॉट लर्निंग पर करती है। यह ध्यान देने योग्य है कि इन सभी तरीकों में इमेजनेट डेटासेट पर प्री-प्रशिक्षण के लिए 1.2 मिलियन छवियों का उपयोग किया जाता है, और वे केवल लेबल तक पहुंच को प्रतिबंधित करते हैं। दूसरी ओर, सीर मॉडल को केवल 1 से 10% इमेजनेट डेटासेट को देखने की अनुमति है।
जैसा कि आप देख सकते हैं, इन दृष्टिकोणों को नेटवर्क को इमेजनेट डेटासेट से अधिक छवियों को देखने का लाभ मिलता है। लेकिन यह आश्चर्यजनक है कि सीर मॉडल अभी भी 80% के आसपास की शीर्ष-1 सटीकता स्कोर प्राप्त कर सकता है, जो ऊपर सूचीबद्ध दृष्टिकोणों की सटीकता से थोड़ा कम है।
मॉडल क्षमता का प्रभाव
आंकड़े कम-शॉट लर्निंग पर मॉडल क्षमता के प्रभाव की चर्चा करते हैं: 1%, 10%, और 100% इमेजनेट डेटासेट।

यह देखा जा सकता है कि मॉडल क्षमता में वृद्धि से डेटासेट में छवियों और लेबल दोनों तक पहुंच कम होने पर सटीकता स्कोर में सुधार हो सकता है।
अन्य बेंचमार्क पर स्थानांतरण
सीर मॉडल का प्रदर्शन आगे मूल्यांकन करने और विश्लेषण करने के लिए डाउनस्ट्रीम कार्यों पर पूर्व-प्रशिक्षित विशेषताओं को स्थानांतरित किया जाता है।
छवि वर्गीकरण का रैखिक मूल्यांकन

उपरोक्त तालिका सीर के पूर्व-प्रशिक्षित रेगनेटवाई-256जीएफ और रेगनेटवाई128-जीएफ की विशेषताओं की तुलना इमेजनेट डेटासेट पर पर्यवेक्षित और बिना पर्यवेक्षण के साथ समान आर्किटेक्चर के साथ करती है। विशेषताओं की गुणवत्ता का मूल्यांकन करने के लिए, मॉडल के वज़न स्थिर रखे जाते हैं और डाउनस्ट्रीम कार्यों के प्रशिक्षण सेट का उपयोग करके इन विशेषताओं पर एक रैखिक वर्गीकारक प्रशिक्षित किया जाता है, और निम्नलिखित बेंचमार्क को ध्यान में रखता है: ओपन-इमेजेस (ओपिम), इनेचुरलिस्ट (इनेट), प्लेस205 (प्लेस), और पास्कल वीओसी (वीओसी)।
वस्तु पहचान और सेगमेंटेशन
आंकड़े प्री-प्रशिक्षित विशेषताओं की तुलना वस्तु पहचान और सेगमेंटेशन पर करते हैं और उन्हें मूल्यांकन करते हैं।

सीर ढांचे में एक मास्क-आरसीएनएन मॉडल को सीओसीओ बेंचमार्क पर प्री-प्रशिक्षित रेगनेटवाई-64जीएफ और रेगनेटवाई-128जीएफ के साथ निर्माण खंड के रूप में प्रशिक्षित किया जाता है। दोनों आर्किटेक्चर और डाउनस्ट्रीम कार्यों के लिए, सीर का स्व-पर्यवेक्षित प्री-प्रशिक्षण दृष्टिकोण पर्यवेक्षित प्रशिक्षण से 1.5 से 2 एपी पॉइंट्स बेहतर प्रदर्शन करता है।
कमजोर-पर्यवेक्षित प्री-प्रशिक्षण के साथ तुलना
इंटरनेट पर उपलब्ध अधिकांश छवियों में मेटा विवरण या अल्ट टेक्स्ट, विवरण, या भौगोलिक स्थान होते हैं जो प्री-प्रशिक्षण के दौरान लाभ प्रदान कर सकते हैं। पूर्व कार्य ने संकेत दिया है कि एक क्यूरेटेड या लेबल वाले हैशटैग सेट की भविष्यवाणी करने से परिणामी दृश्य विशेषताओं की गुणवत्ता में सुधार हो सकता है। हालांकि, इस दृष्टिकोण को छवियों को फिल्टर करने और मेटाडेटा की उपस्थिति की आवश्यकता होती है।
निम्नलिखित आंकड़े रेसनेटएक्सट101-32dx8d आर्किटेक्चर की तुलना यादृच्छिक छवियों पर प्रशिक्षित आर्किटेक्चर के साथ करते हैं, और हैशटैग और मेटाडेटा के साथ लेबल वाली छवियों पर प्रशिक्षित आर्किटेक्चर के साथ शीर्ष-1 सटीकता की रिपोर्ट करते हैं।

यह देखा जा सकता है कि हालांकि सीर ढांचे में प्री-प्रशिक्षण के दौरान मेटाडेटा का उपयोग नहीं किया जाता है, इसकी सटीकता मेटाडेटा का उपयोग करके प्री-प्रशिक्षित मॉडल के समान है।
एब्लेशन अध्ययन
एब्लेशन अध्ययन एक विशिष्ट घटक के प्रभाव का विश्लेषण करने के लिए किया जाता है ताकि मॉडल के समग्र प्रदर्शन को समझा जा सके। एब्लेशन अध्ययन घटक को मॉडल से हटाकर किया जाता है, और यह समझने के लिए कि घटक को हटाने से मॉडल कैसे प्रदर्शन करता है। यह विकसितकर्ताओं को उस विशिष्ट घटक के प्रभाव का एक संक्षिप्त विवरण प्रदान करता है।
मॉडल आर्किटेक्चर का प्रभाव
मॉडल आर्किटेक्चर मॉडल के प्रदर्शन पर महत्वपूर्ण प्रभाव डालता है, खासकर जब मॉडल को स्केल किया जाता है या प्री-प्रशिक्षण डेटा के विनिर्देशों को संशोधित किया जाता है।
निम्नलिखित आंकड़े मॉडल आर्किटेक्चर को बदलने के प्रभाव को दर्शाते हैं जब इमेजनेट डेटासेट पर रैखिक रूप से मूल्यांकन किया जाता है। विशेषताओं का मूल्यांकन सीधे किया जा सकता है क्योंकि मूल्यांकन मॉडल को स्क्रैच से इमेजनेट पर प्रशिक्षित करने के लिए अनुकूल नहीं है।

यह देखा जा सकता है कि रेसनेटएक्सट्स और रेसनेट आर्किटेक्चर के लिए, पेनुल्टिमेट लेयर से विशेषताएं वर्तमान सेटिंग्स के साथ बेहतर काम करती हैं। दूसरी ओर, रेगनेट आर्किटेक्चर अन्य आर्किटेक्चर को पीछे छोड़ देता है।
कुल मिलाकर, यह निष्कर्ष निकाला जा सकता है कि मॉडल क्षमता में वृद्धि विशेषताओं की गुणवत्ता में सुधार का परिणाम है, और लॉगरिदमिक लाभ है।
प्री-प्रशिक्षण डेटा को स्केल करना
मॉडल को बड़े डेटासेट पर प्रशिक्षित करने से दो मुख्य कारणों से दृश्य विशेषताओं की गुणवत्ता में सुधार हो सकता है: अधिक अनोखी छवियां, और अधिक पैरामीटर। आइए इन कारणों पर एक संक्षिप्त नज़र डालें कि वे मॉडल के प्रदर्शन को कैसे प्रभावित करते हैं।
अनोखी छवियों की संख्या में वृद्धि

निम्नलिखित आंकड़े दो आर्किटेक्चर की तुलना करते हैं, रेगनेट8 और रेगनेट16, जिनमें समान पैरामीटर होते हैं लेकिन विभिन्न संख्या में अनोखी छवियों पर प्रशिक्षित होते हैं। सीर ढांचे में मॉडल को 1 बिलियन छवियों के लिए 1 पुनरावृत्ति या 32 अनोखी छवियों के लिए 32 पुनरावृत्तियों के लिए प्रशिक्षित किया जाता है, और एक हाफ-वेव कोसाइन लर्निंग दर का उपयोग किया जाता है।
यह देखा जा सकता है कि मॉडल का प्रदर्शन अच्छा होने के लिए अनोखी छवियों की संख्या को इमेजनेट डेटासेट में मौजूद छवियों से अधिक होना चाहिए। इस मामले में, मॉडल इमेजनेट डेटासेट में मौजूद छवियों से अधिक अनोखी छवियों को खिलाते हुए अच्छा प्रदर्शन करता है।
अधिक पैरामीटर
आंकड़े रेगनेट-128जीएफ आर्किटेक्चर का उपयोग करके 1 बिलियन छवियों पर प्रशिक्षित मॉडल के प्रदर्शन को दर्शाते हैं। यह देखा जा सकता है कि मॉडल का प्रदर्शन धीरे-धीरे पैरामीटर की संख्या में वृद्धि के साथ बढ़ता है।

वास्तविक दुनिया में स्व-पर्यवेक्षित कंप्यूटर विजन
अब तक, हमने स्व-पर्यवेक्षित लर्निंग और कंप्यूटर विजन के लिए सीर मॉडल के सिद्धांतों पर चर्चा की है। अब, आइए वास्तविक दुनिया के दृश्यों में स्व-पर्यवेक्षित कंप्यूटर विजन के काम करने के तरीके और सीर के भविष्य के बारे में चर्चा करें।
सीर मॉडल प्राकृतिक भाषा प्रसंस्करण उद्योग में किए गए काम का प्रतिद्वंद्वी है, जहां उच्च-स्तरीय राज्य-ऑफ-द-आर्ट मॉडल लाखों शब्दों के साथ प्रशिक्षित होते हैं और ट्रिलियन पैरामीटर के साथ प्रशिक्षित होते हैं। डाउनस्ट्रीम कार्यों पर प्रदर्शन आमतौर पर प्रशिक्षण मॉडल के लिए इनपुट डेटा की मात्रा में वृद्धि के साथ बढ़ता है, और कंप्यूटर विजन कार्यों के लिए भी यही सच है।
हालांकि, प्राकृतिक भाषा प्रसंस्करण के लिए स्व-पर्यवेक्षित लर्निंग का उपयोग करना कंप्यूटर विजन के लिए स्व-पर्यवेक्षित लर्निंग का उपयोग करने से अलग है। यह इसलिए है क्योंकि जब पाठ के साथ काम किया जाता है, तो सेमांटिक अवधारणाओं को विचारों में तोड़ दिया जाता है, लेकिन जब छवियों के साथ काम किया जाता है, तो मॉडल को यह तय करना होता है कि कौन सा पिक्सल किस अवधारणा से संबंधित है।
इसके अलावा, विभिन्न छवियों में विभिन्न दृश्य होते हैं, और हालांकि कई छवियों में एक ही वस्तु हो सकती है, अवधारणा महत्वपूर्ण रूप से भिन्न हो सकती है। उदाहरण के लिए, बिल्ली की छवियों के साथ एक डेटासेट पर विचार करें। हालांकि प्राथमिक वस्तु, बिल्ली सभी छवियों में सामान्य है, अवधारणा महत्वपूर्ण रूप से भिन्न हो सकती है क्योंकि बिल्ली एक छवि में खड़ी हो सकती है, जबकि अगली छवि में एक गेंद के साथ खेल रही हो सकती है, और इसी तरह। क्योंकि छवियों में अक्सर विभिन्न अवधारणाएं होती हैं, यह आवश्यक है कि मॉडल कई छवियों को देखकर अवधारणाओं के आसपास के अंतर को समझने में सक्षम हो।
उच्च-आयामी और जटिल छवि डेटा के साथ कुशलता से काम करने के लिए मॉडल को स्केल करने के लिए दो घटकों की आवश्यकता होती है:
- एक कॉन्वोल्यूशनल न्यूरल नेटवर्क या सीएनएन जो बड़ी मात्रा में छवि डेटासेट से दृश्य अवधारणाओं को सीखने के लिए पर्याप्त बड़ा हो।
- एक अल्गोरिदम जो बड़ी मात्रा में छवियों से पैटर्न सीखने में सक्षम हो बिना लेबल, एनोटेशन या मेटाडेटा के।
सीर मॉडल कंप्यूटर विजन के क्षेत्र में इन घटकों को लागू करने का प्रयास करता है। सीर मॉडल स्वाव, एक स्व-पर्यवेक्षित लर्निंग ढांचे की प्रगति का लाभ उठाने का प्रयास करता है जो ऑनलाइन क्लस्टरिंग का उपयोग करके छवियों को जोड़ता है और समान दृश्य अवधारणाओं वाली छवियों को पहचानने में मदद करता है।
स्वाव आर्किटेक्चर के साथ, सीर मॉडल कंप्यूटर विजन में स्व-पर्यवेक्षित लर्निंग को अधिक प्रभावी बनाने में सक्षम है, और प्रशिक्षण समय को 6 गुना तक कम कर देता है।
इसके अलावा, 1 बिलियन से अधिक छवियों पर प्रशिक्षण देने के लिए बड़े पैमाने पर मॉडल की आवश्यकता होती है, जिसमें एक मॉडल आर्किटेक्चर होता है जो न केवल रनटाइम और मेमोरी के मामले में कुशल हो, बल्कि सटीकता के मामले में भी हो। यहीं पर रेगनेट मॉडल आते हैं, जो कॉन्वनेट मॉडल हैं जो ट्रिलियन पैरामीटर को स्केल कर सकते हैं और मेमोरी सीमाओं और रनटाइम नियमों के अनुसार अनुकूलित किए जा सकते हैं।
निष्कर्ष: एक स्व-पर्यवेक्षित भविष्य
स्व-पर्यवेक्षित लर्निंग एआई और एमएल उद्योग में एक प्रमुख बिंदु रहा है क्योंकि यह एआई मॉडल को इंटरनेट पर उपलब्ध बड़ी मात्रा में डेटा से सीधे जानकारी सीखने की अनुमति देता है, न कि क्यूरेटेड और लेबल वाले डेटासेट पर जो केवल एआई मॉडल को प्रशिक्षित करने के लिए ही बनाए गए हैं।
स्व-पर्यवेक्षित लर्निंग एआई और एमएल के भविष्य के लिए एक महत्वपूर्ण अवधारणा है क्योंकि यह विकसितकर्ताओं को वास्तविक दुनिया की स्थितियों में अनुकूलन करने में सक्षम एआई मॉडल बनाने की अनुमति देती है, और इसके कई उपयोग हैं। सीर मॉडल स्व-पर्यवेक्षित लर्निंग के कार्यान्वयन में एक मील का पत्थर है कंप्यूटर विजन उद्योग में।
सीर मॉडल कंप्यूटर विजन उद्योग को बदलने की पहली कदम है, और लेबल वाले डेटासेट पर हमारी निर्भरता को कम करने का प्रयास करता है। सीर मॉडल का उद्देश्य डेटासेट को एनोटेट करने की आवश्यकता को समाप्त करना है जो विकसितकर्ताओं को विविध और बड़ी मात्रा में डेटा के साथ काम करने की अनुमति देगा। सीर मॉडल का कार्यान्वयन विशेष रूप से उन विकसितकर्ताओं के लिए उपयोगी है जो सीमित छवियों या मेटाडेटा वाले क्षेत्रों में मॉडल बनाने पर काम कर रहे हैं, जैसे कि चिकित्सा उद्योग।
इसके अलावा, मानव एनोटेशन को समाप्त करने से विकसितकर्ताओं को मॉडल को तेजी से विकसित और तैनात करने की अनुमति मिलेगी, जो उन्हें तेजी से और अधिक सटीकता के साथ तेजी से विकसित होने वाली स्थितियों का जवाब देने की अनुमति देगा।



