
स्वास्थ्य
स्वास्थ्य सेवा में क्रांति लाना : चिकित्सा में बड़े भाषा मॉडल के प्रभाव और भविष्य का अन्वेषण

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुगूगल के मेड-पाल्म 2 ने अमेरिकी मेडिकल लाइसेंसिंग परीक्षा के प्रश्नों पर विशेषज्ञ-स्तरीय…
और देखें
- गूगल के मेड-पाल्म 2 ने अमेरिकी मेडिकल लाइसेंसिंग परीक्षा के प्रश्नों पर विशेषज्ञ-स्तरीय प्रदर्शन हासिल किया है।
- स्टैनफोर्ड के निगम शाह विशिष्ट चिकित्सा डेटा पर एलएलएम को एक पर्यवेक्षित इंटर्न की तरह प्रशिक्षित करने की वकालत करते हैं।
- ओपन-सोर्स मेडिट्रॉन मॉडल को अधिक नैदानिक विश्वसनीयता के लिए संकलित चिकित्सा स्रोतों पर प्रशिक्षित किया गया है।
चिकित्सा और स्वास्थ्य सेवा में बड़े भाषा मॉडल (एलएलएम) के एकीकरण और अनुप्रयोग एक महत्वपूर्ण विषय रहा है और इसका विकास जारी है।
हेल्थकेयर इंफॉर्मेशन मैनेजमेंट एंड सिस्टम्स सोसाइटी ग्लोबल कॉन्फ्रेंस और अन्य उल्लेखनीय आयोजनों में उल्लेख किया गया है, जैसे कि गूगल (GOOGL ) जैसी कंपनियां स्वास्थ्य सेवा में जनरेटिव एआई की संभावना का अन्वेषण करने में अग्रणी हैं। उनकी पहल, जैसे कि मेड-पीएलएम 2, स्वास्थ्य सेवा समाधानों में एआई-संचालित समाधानों के विकास को दर्शाती है, विशेष रूप से निदान, रोगी देखभाल और प्रशासनिक दक्षता जैसे क्षेत्रों में।
गूगल का मेड-पीएलएम 2, स्वास्थ्य सेवा क्षेत्र में एक अग्रणी एलएलएम, ने प्रभावशाली क्षमता प्रदर्शित की है, विशेष रूप से यू.एस. मेडिकल लाइसेंसिंग परीक्षा शैली के प्रश्नों में “विशेषज्ञ” स्तर हासिल किया है। यह मॉडल, और इसके जैसे अन्य, स्वास्थ्य पेशेवरों द्वारा जानकारी तक पहुंच और उपयोग के तरीके को क्रांतिकारी बनाने का वादा करते हैं, संभावित रूप से निदान की सटीकता और रोगी देखभाल की दक्षता में सुधार करते हैं।
हालांकि, इन प्रगति के साथ-साथ, इन प्रौद्योगिकियों के व्यावहारिक और सुरक्षा पहलुओं के बारे में चिंताएं भी उठाई गई हैं। उदाहरण के लिए, मॉडल प्रशिक्षण के लिए विशाल इंटरनेट डेटा स्रोतों पर निर्भरता, जबकि कुछ संदर्भों में लाभदायक हो सकती है, चिकित्सा उद्देश्यों के लिए हमेशा उपयुक्त या विश्वसनीय नहीं हो सकती है। निगम शाह, पीएचडी, एमबीबीएस, स्टैनफोर्ड हेल्थ केयर के मुख्य डेटा वैज्ञानिक, बताते हैं, इन मॉडलों के प्रदर्शन के बारे में महत्वपूर्ण प्रश्न वास्तविक चिकित्सा सेटिंग्स में हैं और उनके वास्तविक प्रभाव रोगी देखभाल और स्वास्थ्य सेवा दक्षता पर है।
डॉ. शाह का दृष्टिकोण एलएलएम का उपयोग चिकित्सा में एक अधिक अनुकूलित दृष्टिकोण की आवश्यकता पर जोर देता है। सामान्य-उद्देश्य मॉडल के बजाय, जो व्यापक इंटरनेट डेटा पर प्रशिक्षित होते हैं, उन्हें विशिष्ट, प्रासंगिक चिकित्सा डेटा पर प्रशिक्षित किया जाना चाहिए। यह दृष्टिकोण एक चिकित्सा इंटर्न को प्रशिक्षित करने के समान है – उन्हें विशिष्ट कार्य देना, उनके प्रदर्शन की देखभाल करना, और जैसे ही वे योग्यता प्रदर्शित करते हैं, उन्हें अधिक स्वायत्तता देना।
इसी संदर्भ में, ईपीएफएल शोधकर्ताओं द्वारा मेडिट्रॉन का विकास एक दिलचस्प प्रगति का प्रतिनिधित्व करता है। मेडिट्रॉन, एक ओपन-सोर्स एलएलएम जो विशेष रूप से चिकित्सा अनुप्रयोगों के लिए तैयार किया गया है, एक महत्वपूर्ण कदम है। पबमेड और क्लिनिकल दिशानिर्देशों जैसे प्रतिष्ठित स्रोतों से क्यूरेटेड चिकित्सा डेटा पर प्रशिक्षित, मेडिट्रॉन चिकित्सा पेशेवरों के लिए एक अधिक केंद्रित और संभावित रूप से अधिक विश्वसनीय उपकरण प्रदान करता है। इसकी ओपन-सोर्स प्रकृति न केवल पारदर्शिता और सहयोग को बढ़ावा देती है, बल्कि व्यापक शोध समुदाय द्वारा निरंतर सुधार और तनाव परीक्षण की भी अनुमति देती है।

MEDITRON-70B की चार विकल्प वाले MedQA के USMLE-शैली के प्रश्नों पर सटीकता 70.2% है।
Meditron और Med-PaLM 2 जैसे टूल स्वास्थ्य सेवा की विशिष्ट जरूरतों पर ध्यान बढ़ने को दर्शाते हैं। प्रासंगिक, उच्च गुणवत्ता वाले चिकित्सा डेटा से प्रशिक्षण और क्लिनिकल परिवेश में सुरक्षा तथा विश्वसनीयता सुनिश्चित करना महत्वपूर्ण है। अंतरराष्ट्रीय रेड क्रॉस समिति जैसे मानवीय संदर्भों से विविध डेटा शामिल करना वैश्विक स्वास्थ्य की अलग-अलग जरूरतों का ध्यान रखने और सामाजिक रूप से जिम्मेदार टूल बनाने के उद्देश्य से मेल खाता है।
Nature में प्रकाशित Large language models encode clinical knowledge शोध इन मॉडलों की चिकित्सा संबंधी क्षमताओं और सीमाओं की पड़ताल करता है। लक्षण, रोग और उपचार जटिल हैं और बदलते रहते हैं; इसलिए मॉडल को नवीनतम ज्ञान और दिशानिर्देशों के साथ भी अद्यतन रहना चाहिए।
शोध का MultiMedQA बेंचमार्क छह मौजूदा चिकित्सा प्रश्नोत्तर डेटासेट को HealthSearchQA से जोड़ता है, जिसमें इंटरनेट पर अक्सर खोजे जाने वाले स्वास्थ्य प्रश्न हैं। यह तथ्यात्मकता, समझ, तर्क, संभावित नुकसान और पक्षपात जैसे पहलुओं का मूल्यांकन करता है, ताकि सीमित पुराने स्वचालित मानकों की कमियाँ दूर हों।
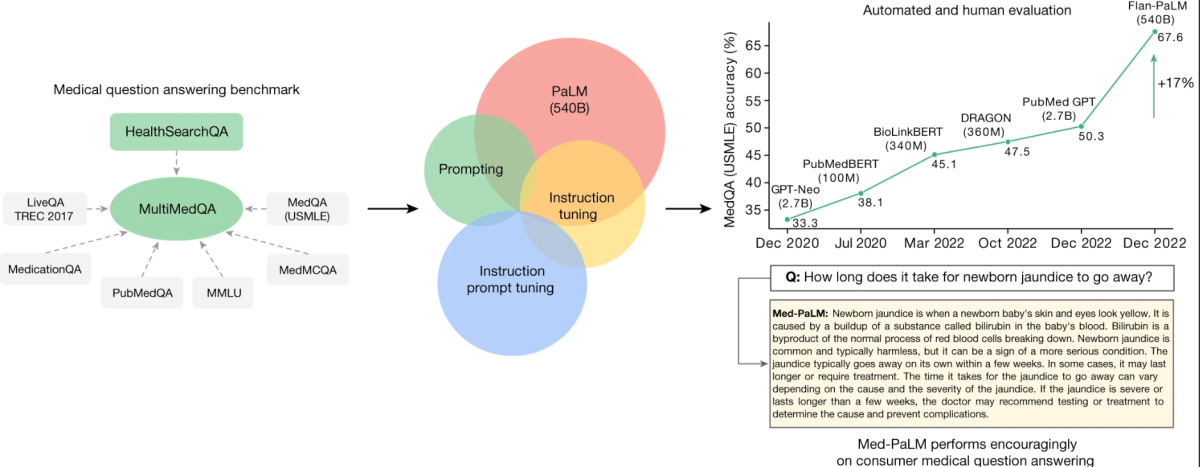
MultiMedQA: चिकित्सा परीक्षा के प्रश्नों सहित चिकित्सा प्रश्नोत्तर का बेंचमार्क।
अध्ययन ने 540 अरब पैरामीटर वाले PaLM और निर्देशों के अनुसार अनुकूलित Flan-PaLM को MultiMedQA पर परखा। Flan-PaLM ने सभी बहुविकल्पीय डेटासेट में उस समय के सर्वोत्तम परिणाम दिए। MedQA पर इसकी सटीकता 67.6% थी, जिसे शोध ने पिछले सर्वोत्तम परिणाम से 17% से अधिक सुधार बताया।
इस शोध में एक महत्वपूर्ण पहलू यह है कि यह विस्तृत मानव मूल्यांकन ढांचे को प्रस्तुत करता है, जो मॉडल के उत्तरों का मूल्यांकन वैज्ञानिक सहमति और संभावित हानिकारक परिणामों के लिए करता है। Flan-PaLM के लंबे उत्तरों में 61.9% वैज्ञानिक सहमति के अनुरूप थे, जबकि Med-PaLM के लिए यह अनुपात 92.6% था, जो चिकित्सकों के उत्तरों के करीब था। Flan-PaLM की तुलना में Med-PaLM के उत्तरों में संभावित नुकसान भी काफी कम हुआ।
मेड-पीएलएम के उत्तरों का मानव मूल्यांकन इसकी कई क्षेत्रों में प्रवीणता को उजागर करता है, जो चिकित्सक-उत्पन्न उत्तरों के साथ निकटता से संरेखित है। यह मेड-पीएलएम की क्षमता को एक सहायक उपकरण के रूप में चिकित्सा सेटिंग्स में प्रदर्शित करता है।
मेडक्यूए
मेडक्यूए डेटासेट में यूएसएमएलई शैली के प्रश्न शामिल हैं, प्रत्येक में चार या पांच विकल्प हैं। इसमें 11,450 प्रश्नों का एक विकास सेट और 1,273 प्रश्नों का एक परीक्षण सेट शामिल है।
प्रारूप: प्रश्नोत्तर, बहुविकल्पीय, खुला विषय-क्षेत्र।
डेटासेट का उदाहरण प्रश्न: एक 65 वर्षीय पुरुष, जो उच्च रक्तचाप से पीड़ित है, नियमित स्वास्थ्य जांच के लिए डॉक्टर के पास आता है। वर्तमान दवाओं में एटेनोलोल, लिसिनोप्रिल और एटोरवास्टेटिन शामिल हैं। उसकी नाड़ी 86 बार प्रति मिनट है, श्वसन दर 18 बार प्रति मिनट है, और रक्तचाप 145/95 मिमी पारा है। कार्डियक परीक्षा में एंड डायस्टोलिक मुरमुर का पता चलता है। निम्नलिखित में से कौन सा यह शारीरिक परीक्षा का सबसे संभावित कारण है?
उत्तर (सही उत्तर बोल्ड में): (ए) बाएं वेंट्रिकल की कम प्रसारक्षमता (compliance), (बी) माइट्रल वाल्व का मिक्सोमैटस डिजनरेशन (सी) पेरिकार्डियम की सूजन (डी) एओर्टिक रूट का फैलाव (ई) माइट्रल वाल्व की पत्तियों की मोटाई।
अध्ययन ने आम लोगों के चिकित्सा प्रश्नों के उत्तर देने में महत्वपूर्ण कमियाँ भी पाईं। शोधकर्ताओं ने कुछ उदाहरणों से नए डोमेन के अनुकूल बनाने के लिए निर्देश-प्रॉम्प्ट ट्यूनिंग का तरीका प्रस्तुत किया, जिससे Med-PaLM बना। समझ, ज्ञान-स्मरण और तर्क में सुधार के बावजूद उसका प्रदर्शन चिकित्सकों से कम था।
निर्देश ट्यूनिंग प्रदर्शन में सुधार करती है
- सामान्य अनुप्रयोग: निर्देश ट्यूनिंग, जिसमें एलएलएम को विशिष्ट निर्देशों या दिशानिर्देशों के साथ फाइन-ट्यून किया जाता है, विभिन्न डोमेन में प्रदर्शन में सुधार दिखाया गया है। यह तकनीक अन्य क्षेत्रों जैसे कानूनी, वित्तीय या शैक्षिक डोमेन में एलएलएम आउटपुट की सटीकता और प्रासंगिकता में सुधार के लिए लागू की जा सकती है।
मॉडल आकार को स्केल करना
- व्यापक निहितार्थ: मॉडल आकार को बढ़ाने से प्रदर्शन में सुधार होने का अवलोकन चिकित्सा प्रश्न उत्तर देने तक सीमित नहीं है। बड़े मॉडल, जिनमें अधिक पैरामीटर होते हैं, अधिक सूक्ष्म और जटिल प्रतिक्रियाओं को संसाधित और उत्पन्न करने की क्षमता रखते हैं। यह स्केलिंग ग्राहक सेवा, रचनात्मक लेखन और तकनीकी समर्थन जैसे क्षेत्रों में लाभदायक हो सकती है, जहां सूक्ष्म समझ और प्रतिक्रिया उत्पादन महत्वपूर्ण है।
चेन ऑफ थॉट (सीओटी) प्रॉम्प्टिंग
- विविध डोमेन उपयोग: सीओटी प्रॉम्प्टिंग का उपयोग, हालांकि चिकित्सा डेटासेट में हमेशा प्रदर्शन नहीं सुधारता, जटिल समस्या समाधान की आवश्यकता वाले अन्य डोमेन में मूल्यवान हो सकता है। उदाहरण के लिए, तकनीकी समस्या निवारण या जटिल निर्णय लेने के दृश्यों में, सीओटी प्रॉम्प्टिंग एलएलएम को चरणबद्ध तरीके से जानकारी संसाधित करने के लिए मार्गदर्शन कर सकती है, जिससे अधिक सटीक और तर्कसंगत आउटपुट हो सकते हैं।
स्व-संगतता से सटीकता में वृद्धि
- व्यापक अनुप्रयोग: स्व-संगतता की तकनीक, जिसमें कई आउटपुट उत्पन्न किए जाते हैं और सबसे संगत उत्तर चुना जाता है, विभिन्न क्षेत्रों में प्रदर्शन में सुधार कर सकती है। वित्त या कानून जैसे क्षेत्रों में जहां सटीकता सर्वोपरि है, इस पद्धति का उपयोग उत्पन्न आउटपुट को क्रॉस-वरिफाई करने के लिए किया जा सकता है ताकि विश्वसनीयता बढ़ सके।
अनिश्चितता और चयनात्मक भविष्यवाणी
- क्रॉस-डोमेन प्रासंगिकता: अनिश्चितता के अनुमानों को संवाद करना उन क्षेत्रों में महत्वपूर्ण है जहां गलत सूचना गंभीर परिणामों का कारण बन सकती है, जैसे कि स्वास्थ्य सेवा और कानून। एलएलएम की क्षमता का उपयोग अनिश्चितता व्यक्त करने और जब विश्वास कम हो तो भविष्यवाणी को चुनिंदा रूप से स्थगित करने के लिए किया जा सकता है, जो इन क्षेत्रों में असटीक जानकारी के प्रसार को रोकने के लिए एक महत्वपूर्ण उपकरण हो सकता है।
इन मॉडल्स का वास्तविक अनुप्रयोग प्रश्नों के उत्तर देने से परे है। उन्हें रोगी शिक्षा, निदान प्रक्रिया में सहायता करने और यहां तक कि चिकित्सा छात्रों को प्रशिक्षित करने के लिए भी उपयोग किया जा सकता है। हालांकि, उनकी तैनाती को सावधानी से प्रबंधित किया जाना चाहिए ताकि मानव पर्यवेक्षण के बिना एआई पर निर्भरता से बचा जा सके।
चिकित्सा ज्ञान के विकसित होने के साथ, एलएलएम को भी अनुकूलन और सीखना चाहिए। इसके लिए निरंतर सीखने और अद्यतन के तंत्र की आवश्यकता है, ताकि मॉडल समय के साथ प्रासंगिक और सटीक बने रहें।


