
Anderson का एंगल
NVIDIA का eDiffi डिफ्यूजन मॉडल शब्दों से चित्र बनाने और बहुत कुछ की सुविधा देता है

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
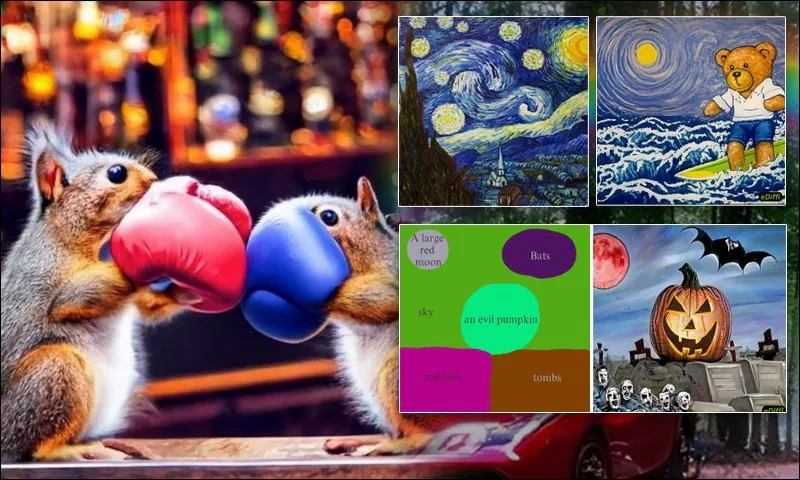
मुख्य बिंदुNVIDIA का eDiffi बेहतर टेक्स्ट-टू-इमेज नियंत्रण के लिए विशेषज्ञ डिनॉइज़रों के एक समूह…
और देखें
- NVIDIA का eDiffi बेहतर टेक्स्ट-टू-इमेज नियंत्रण के लिए विशेषज्ञ डिनॉइज़रों के एक समूह का उपयोग करता है।
- यह मॉडल बारीक विवरण और वैश्विक संरचना में सुधार के लिए T5 और CLIP एनकोडर को एकीकृत करता है।
- eDiffi रंगों को प्रॉम्प्ट तत्वों से मैप करके सटीक लेआउट के लिए शब्दों के साथ पेंटिंग सक्षम करता है।
Stable Diffusion जैसे लेटेंट डिफ्यूजन आधारित जनरेटिव इमेज मॉडल से सटीक रचनाएँ बनाना बिल्लियों को हाँकने जैसा हो सकता है। अपेक्षाकृत सरल टेक्स्ट प्रॉम्प्ट से असाधारण विवरण और चित्र बनाने वाली कल्पनाशील तथा व्याख्यात्मक क्षमताओं को बंद करना कठिन भी होता है, जब आप छवि निर्माण पर Photoshop जैसे सटीक नियंत्रण की तलाश में हों।
अब NVIDIA (NVDA ) के शोधकर्ताओं का नया तरीका, ensemble diffusion for images (eDiffi), पूरी पाइपलाइन में एक ही विधि के बजाय कई एम्बेडिंग और व्याख्यात्मक विधियाँ मिलाता है। इससे उत्पन्न सामग्री पर कहीं अधिक नियंत्रण मिलता है। नीचे के उदाहरण में उपयोगकर्ता तत्वों को रंगता है, जहाँ हर रंग टेक्स्ट प्रॉम्प्ट के एक शब्द को दर्शाता है:
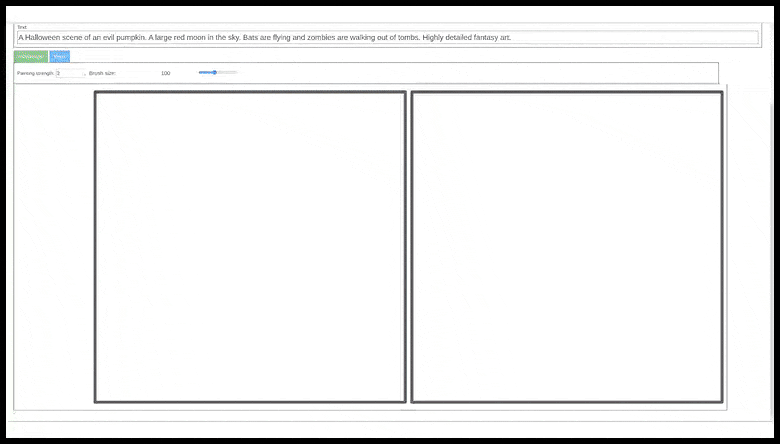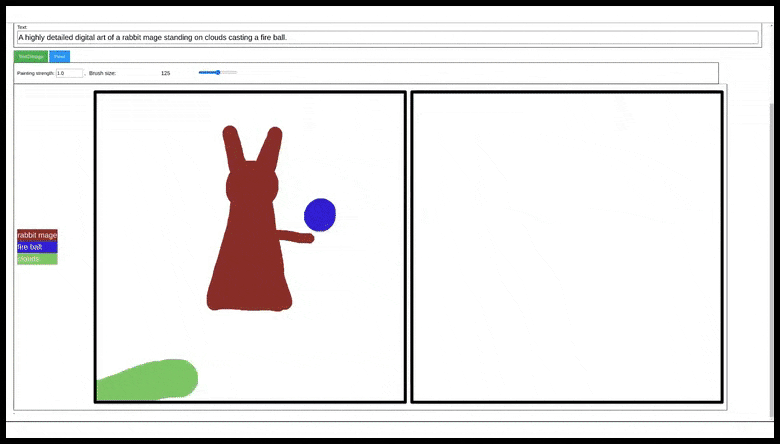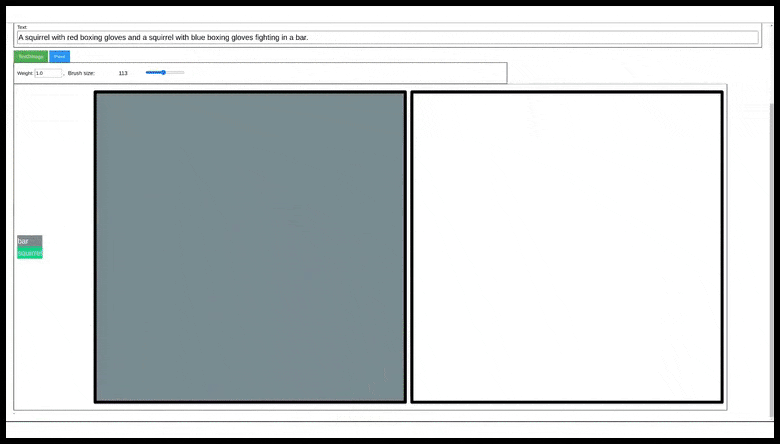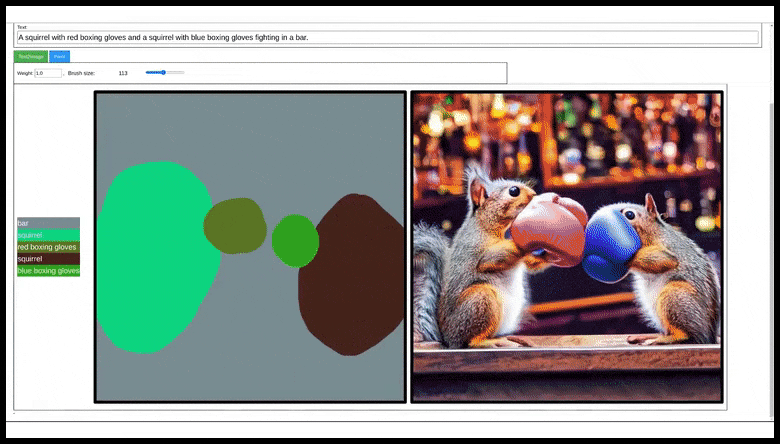
शब्दों से चित्र बनाना NVIDIA के eDiffi मॉडल की दो नई क्षमताओं में से एक है। हर लगाया गया रंग प्रॉम्प्ट के एक शब्द को दर्शाता है, जो निर्माण के दौरान बाईं ओर दिखाई देता है। रंगा हुआ क्षेत्र केवल उसी तत्व से बनेगा। अधिक उदाहरण और बेहतर रिज़ॉल्यूशन आधिकारिक वीडियो में देखें। https://www.youtube.com/watch?v=k6cOx9YjHJc
दरअसल यह मास्क से चित्र बनाना है और Stable Diffusion के inpainting प्रतिमान को उलट देता है। उस प्रतिमान में खराब या असंतोषजनक छवियाँ सुधारी जाती हैं, या ऐसी छवियाँ बढ़ाई जाती हैं जिन्हें शुरुआत से ही वांछित आकार दिया जा सकता था।
यहाँ रंगे गए हिस्से के किनारे एक अवधारणा से जुड़े केवल एक विशिष्ट तत्व की अनुमत अनुमानित सीमाएँ तय करते हैं। उपयोगकर्ता अंतिम कैनवास का आकार शुरू में तय करके अलग-अलग तत्व जोड़ सकता है।

नए शोधपत्र के उदाहरण। स्रोत: https://arxiv.org/pdf/2211.01324.pdf
eDiffi की विविध विधियाँ लंबे और विस्तृत प्रॉम्प्ट के हर तत्व को शामिल करने में भी बेहतर काम करती हैं। Stable Diffusion और OpenAI का DALL-E 2 प्रॉम्प्ट के कुछ हिस्सों को प्राथमिकता देते हैं। यह इस बात पर निर्भर हो सकता है कि संबंधित शब्द कितनी जल्दी आते हैं, या एक पूर्ण और प्रॉम्प्ट के अनुरूप व्यापक रचना के लिए जरूरी तत्वों को अलग करना कितना कठिन है:

शोधपत्र से: eDiffi प्रॉम्प्ट को अधिक गहराई से संसाधित करके अधिकतम संभव तत्व चित्रित कर सकता है। सबसे दाएँ कॉलम के बेहतर eDiffi परिणाम चुनकर दिखाए गए हैं, लेकिन Stable Diffusion और DALL-E 2 की तुलना वाली छवियाँ भी इसी तरह चुनी गई हैं।
इसके अतिरिक्त, विशेष T5 टेक्स्ट-टू-टेक्स्ट एन्कोडर से eDiffi समझ में आने वाला अंग्रेजी पाठ चित्रित कर सकता है। माँग अप्रत्यक्ष हो सकती है, जैसे चित्र में [x] का कुछ पाठ है, या स्पष्ट हो सकती है, जैसे टी-शर्ट पर Nvidia Rocks लिखा है:

eDiffi का विशेष टेक्स्ट-टू-टेक्स्ट प्रसंस्करण चित्रों में पाठ को शब्दशः दिखाने देता है। पाठ केवल ऐसी टेक्स्ट-टू-इमेज व्याख्यात्मक परत से नहीं गुजरता जो परिणाम को बिगाड़ देती है।
एक और लाभ यह है कि शैली के प्रॉम्प्ट के रूप में केवल एक संदर्भ छवि दी जा सकती है। इसके लिए किसी विधा या शैली के अनेक उदाहरणों पर DreamBooth मॉडल या टेक्स्ट एम्बेडिंग प्रशिक्षित करने की जरूरत नहीं है।

संदर्भ छवि की शैली टेक्स्ट-टू-इमेज प्रॉम्प्ट या इमेज-टू-इमेज प्रॉम्प्ट पर भी लागू की जा सकती है।
नए शोधपत्र का शीर्षक eDiffi: विशेषज्ञ डीनॉइज़र समूह वाले टेक्स्ट-टू-इमेज डिफ्यूजन मॉडल है।
T5 टेक्स्ट एन्कोडर
Google के Text-to-Text Transfer Transformer (T5) का उपयोग eDiffi के बेहतर परिणामों का महत्वपूर्ण कारण है। सामान्य लेटेंट डिफ्यूजन पाइपलाइन प्रशिक्षण छवियों और इंटरनेट से संग्रह के समय उनसे जुड़े कैप्शन के संबंध पर केंद्रित होती है। कैप्शन बाद में हाथ से बदले भी जा सकते हैं, लेकिन यह महँगा और इसलिए दुर्लभ हस्तक्षेप है।

जुलाई 2020 के T5 शोधपत्र से: पाठ आधारित परिवर्तन eDiffi तथा संभवतः अन्य लेटेंट डिफ्यूजन मॉडलों के जनरेटिव इमेज वर्कफ़्लो में मदद कर सकते हैं। स्रोत: https://arxiv.org/pdf/1910.10683.pdf
स्रोत पाठ को दूसरे ढंग से लिखकर T5 मॉड्यूल चलाने से मॉडल में मूलतः सीखे गए संबंधों और निरूपणों से अधिक सटीक परिणाम मिल सकते हैं। यह लगभग post facto मैनुअल लेबलिंग जैसा है, जिसमें अनुरोधित टेक्स्ट प्रॉम्प्ट की शर्तों के प्रति अधिक विशिष्टता और उपयोगिता होती है।
लेखक समझाते हैं:
“डिफ्यूजन मॉडल पर अधिकांश मौजूदा काम में एक ही डीनॉइज़िंग मॉडल सभी शोर स्तरों पर साझा होता है। समय की गतिशीलता एक सरल टाइम एम्बेडिंग से दर्शाई जाती है, जिसे MLP नेटवर्क द्वारा मॉडल में दिया जाता है। हमारा तर्क है कि सीमित क्षमता वाले साझा मॉडल से डीनॉइज़िंग डिफ्यूजन की जटिल समयगत गतिशीलता डेटा से प्रभावी ढंग से नहीं सीखी जा सकती।
“इसके बजाय हम विशेषज्ञ डीनॉइज़र का समूह जोड़कर मॉडल की क्षमता बढ़ाने का प्रस्ताव देते हैं। हर विशेषज्ञ शोर स्तरों की एक खास सीमा में विशेषज्ञता रखता है। इससे सैंपलिंग धीमी किए बिना क्षमता बढ़ती है, क्योंकि हर शोर स्तर पर संसाधित तत्व का मूल्यांकन करने की गणनात्मक जटिलता समान रहती है।”

eDiffi का वैचारिक कार्यप्रवाह।
DALL-E 2 और Stable Diffusion के मौजूदा CLIP एन्कोडिंग मॉड्यूल भी उपयोगकर्ता के पाठ के लिए वैकल्पिक चित्रात्मक व्याख्याएँ ढूँढ सकते हैं। लेकिन वे मूल मॉडल जैसी जानकारी पर प्रशिक्षित होते हैं और eDiffi के T5 की तरह अलग व्याख्यात्मक परत के रूप में इस्तेमाल नहीं होते।
लेखकों के अनुसार eDiffi में पहली बार T5 और CLIP एन्कोडर को एक ही पाइपलाइन में शामिल किया गया है:
“दोनों एन्कोडर अलग उद्देश्यों से प्रशिक्षित हैं, इसलिए एक ही इनपुट पाठ से उनके एम्बेडिंग अलग छवियों के निर्माण को प्रोत्साहित करते हैं। CLIP टेक्स्ट एम्बेडिंग उत्पन्न छवियों का समग्र रूप तय करने में मदद करते हैं, लेकिन परिणाम अक्सर पाठ के बारीक विवरण छोड़ देते हैं।
“इसके विपरीत, केवल T5 टेक्स्ट एम्बेडिंग से बनी छवियाँ पाठ में वर्णित अलग-अलग वस्तुओं को बेहतर दर्शाती हैं, लेकिन उनका समग्र रूप कम सटीक होता है। दोनों को साथ इस्तेमाल करने से हमारे मॉडल में सबसे अच्छे इमेज जनरेशन परिणाम मिलते हैं।”
डिफ्यूजन प्रक्रिया में हस्तक्षेप और संवर्द्धन
शोधपत्र बताता है कि सामान्य लेटेंट डिफ्यूजन मॉडल निर्माण के शुरुआती चरणों में केवल पाठ पर निर्भर होकर शुद्ध शोर से छवि तक की यात्रा शुरू करता है।
जब शोर टेक्स्ट प्रॉम्प्ट का वर्णन दर्शाने वाली मोटी रूपरेखा में बदलता है, तो प्रक्रिया का पाठ द्वारा निर्देशित पक्ष लगभग समाप्त हो जाता है। बाकी प्रक्रिया दृश्य विशेषताएँ निखारने पर केंद्रित होती है।
इसलिए पाठ द्वारा निर्देशित शोर की व्याख्या के शुरुआती चरण में जो तत्व तय नहीं हुआ, उसे बाद में छवि में जोड़ना कठिन होता है। टेक्स्ट-टू-लेआउट और लेआउट-टू-इमेज प्रक्रियाओं में अपेक्षाकृत कम ओवरलैप होता है और छवि संवर्द्धन तक पहुँचते-पहुँचते मूल लेआउट के तत्व काफी परस्पर उलझ जाते हैं।

शोधपत्र से: शोर से छवि बनने की प्रक्रिया आगे बढ़ने पर पाइपलाइन के विभिन्न हिस्सों के अटेंशन मैप। नीचे की पंक्ति में CLIP का प्रभाव तेजी से घटता है, जबकि T5 रेंडरिंग में काफी आगे तक छवि को प्रभावित करता रहता है।
पेशेवर संभावनाएँ
परियोजना पृष्ठ और YouTube वीडियो के उदाहरण प्रचार के अनुकूल, मीम जैसे प्यारे चित्र बनाने पर केंद्रित हैं। हमेशा की तरह NVIDIA का शोध अपनी नवीनतम खोज की फोटोरियलिस्टिक या VFX वर्कफ़्लो सुधारने तथा deepfake छवियाँ और वीडियो बेहतर बनाने की क्षमता को कम करके प्रस्तुत करता है।
उदाहरणों में नया या शौकिया उपयोगकर्ता किसी तत्व की जगह के लिए मोटे किनारे बनाता है। अधिक व्यवस्थित VFX वर्कफ़्लो में eDiffi से टेक्स्ट-टू-इमेज द्वारा वीडियो तत्व के कई फ्रेमों की व्याख्या कराना संभव हो सकता है। वहाँ किनारे बहुत सटीक और, उदाहरण के लिए, ग्रीन स्क्रीन या एल्गोरिद्मिक विधियों से पृष्ठभूमि हटाए गए पात्रों पर आधारित हो सकते हैं।

Runway ML पहले से AI आधारित रोटोस्कोपिंग देता है। यहाँ विषय के आसपास का ग्रीन स्क्रीन अल्फा लेयर दर्शाता है। अलगाव मशीन लर्निंग से किया गया है, वास्तविक हरी पृष्ठभूमि हटाने की एल्गोरिद्मिक प्रक्रिया से नहीं। स्रोत: https://twitter.com/runwayml/status/1330978385028374529
प्रशिक्षित DreamBooth पात्र और eDiffi वाली इमेज-टू-इमेज पाइपलाइन से किसी भी लेटेंट डिफ्यूजन मॉडल की बड़ी समस्या, समयगत स्थिरता, पर नियंत्रण पाना शुरू किया जा सकता है। लगाए गए चित्र के किनारे और सामग्री उपयोगकर्ता के कैनवास के सापेक्ष पहले से तय होंगे। उत्पन्न सामग्री की समयगत निरंतरता, जैसे असली Tai Chi अभ्यासकर्ता को रोबोट में बदलना, एक स्थिर DreamBooth मॉडल से मिल सकती है जिसने अपना प्रशिक्षण डेटा याद कर लिया हो। यह व्याख्येयता के लिए खराब, लेकिन पुनरुत्पादकता, निष्ठा और निरंतरता के लिए अच्छा है।
विधि, डेटा और परीक्षण
शोधपत्र के अनुसार eDiffi को सार्वजनिक और स्वामित्व वाले डेटासेट के संग्रह पर प्रशिक्षित किया गया। पूर्वप्रशिक्षित CLIP मॉडल से कड़ा फ़िल्टर लगाकर ऐसी छवियाँ हटाई गईं जो आउटपुट का समग्र सौंदर्य स्कोर घटा सकती थीं। अंतिम संग्रह में लगभग एक अरब टेक्स्ट-इमेज जोड़े हैं। प्रशिक्षण छवियों की सबसे छोटी भुजा 64 पिक्सेल से अधिक बताई गई है।
प्रक्रिया के लिए कई मॉडल प्रशिक्षित किए गए। बेस और सुपर-रिज़ॉल्यूशन, दोनों मॉडलों में AdamW ऑप्टिमाइज़र, 0.0001 लर्निंग रेट, 0.01 वेट डिके और 2,048 का बड़ा बैच आकार इस्तेमाल हुआ।
बेस मॉडल 256 NVIDIA A100 GPU पर प्रशिक्षित हुआ। दोनों सुपर-रिज़ॉल्यूशन मॉडल में प्रत्येक के लिए 128 NVIDIA A100 GPU इस्तेमाल हुए।
सिस्टम NVIDIA की अपनी PyTorch लाइब्रेरी Imaginaire पर आधारित था। COCO और Visual Genome डेटासेट मूल्यांकन के लिए इस्तेमाल हुए, लेकिन अंतिम मॉडलों में शामिल नहीं थे। परीक्षण में विशेष रूप से MS-COCO संस्करण इस्तेमाल हुआ। प्रतिस्पर्धी प्रणालियाँ GLIDE, Make-A-Scene, DALL-E 2, Stable Diffusion और Google की Imagen तथा Parti थीं।
समान पिछले काम के अनुरूप मूल्यांकन में zero-shot FID-30K इस्तेमाल हुआ। COCO वैलिडेशन सेट से 30,000 कैप्शन यादृच्छिक रूप से चुने गए, न कि प्रशिक्षण में इस्तेमाल चित्र या पाठ। इन्हें छवियाँ बनाने के टेक्स्ट प्रॉम्प्ट के रूप में दिया गया।
फिर उत्पन्न और वास्तविक संदर्भ छवियों के बीच Fréchet Inception Distance (FID) निकाली गई और उत्पन्न छवियों का CLIP स्कोर भी दर्ज किया गया।

COCO 2014 वैलिडेशन डेटासेट पर अत्याधुनिक तरीकों के मुकाबले zero-shot FID परीक्षणों के परिणाम; कम स्कोर बेहतर है।
eDiffi ने zero-shot FID में सबसे कम, यानी सबसे अच्छा, स्कोर पाया, यहाँ तक कि कहीं अधिक पैरामीटर वाली प्रणालियों के मुकाबले भी। Parti में 20 अरब पैरामीटर हैं, जबकि परीक्षण के लिए प्रशिक्षित सबसे उच्च स्पेसिफिकेशन वाले eDiffi मॉडल में 9.1 अरब थे।
निष्कर्ष
NVIDIA का eDiffi मौजूदा प्रणालियों में लगातार अधिक डेटा और जटिलता जोड़ने का स्वागतयोग्य विकल्प है। यह लेटेंट डिफ्यूजन आधारित जनरेटिव इमेज प्रणालियों में तत्वों के परस्पर उलझाव और संपादन न कर पाने जैसी कठिन बाधाओं के लिए अधिक बुद्धिमान और परतदार तरीका अपनाता है।
Stable Diffusion के subreddit और Discord समूहों में उपलब्ध होने वाले eDiffi कोड को सीधे जोड़ने या उसके सिद्धांत अलग ढंग से लागू करने की चर्चा चल रही है। लेकिन नई पाइपलाइन इतनी भिन्न है कि SD में यह पूरे संस्करण स्तर का बदलाव होगा। कुछ पिछड़ी संगतता छोड़नी पड़ेगी, लेकिन अंतिम छवियों पर बहुत बेहतर नियंत्रण मिल सकता है, बिना लेटेंट डिफ्यूजन की आकर्षक कल्पनाशक्ति खोए।
पहली बार प्रकाशित: 3 नवंबर 2022।


