
एआई मॉडल और प्लेटफ़ॉर्म
हरित स्क्रीन जेनरेशन को स्थिर वितरण के लिए बेहतर बनाना

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
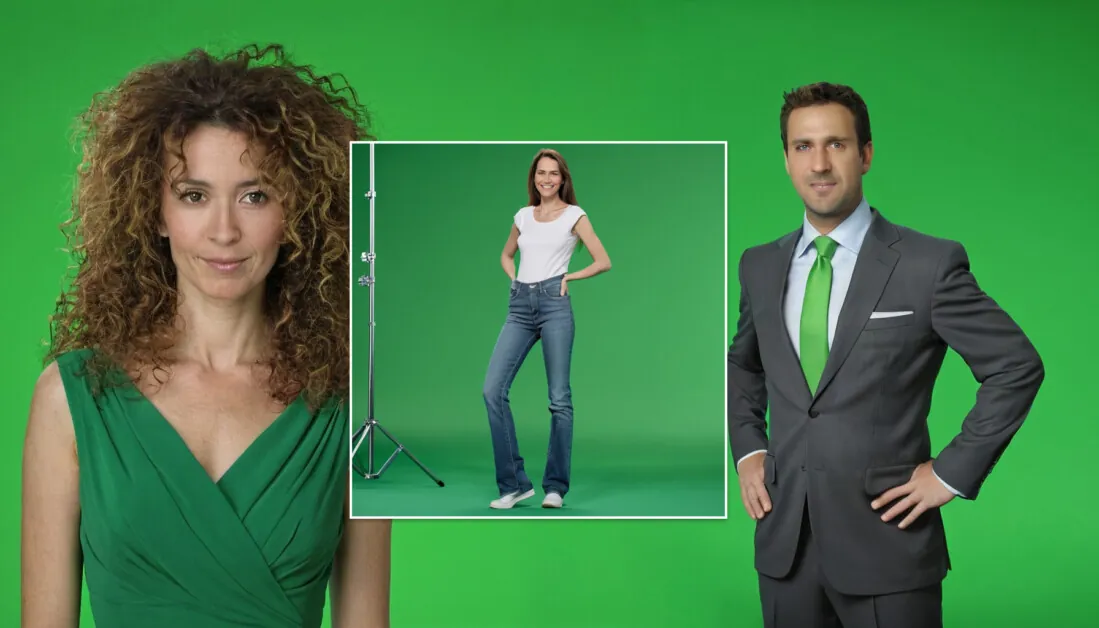
विजुअल जेनरेटिव एआई के आसपास समुदाय और निवेशकों के उत्साह के बावजूद, ऐसी प्रणालियों का आउटपुट वास्तविक दुनिया के उपयोग के लिए हमेशा तैयार नहीं होता है; एक उदाहरण यह है कि जेन एआई प्रणालियां अक्सर पूरी छवियों (या वीडियो के मामले में छवियों की एक श्रृंखला) का आउटपुट करती हैं, न कि विशिष्ट, अलग-अलग तत्वों का जो मल्टीमीडिया में विभिन्न अनुप्रयोगों और दृश्य प्रभाव व्यावसायिकों के लिए आमतौर पर आवश्यक होते हैं।
एक सरल उदाहरण यह है कि क्लिप-आर्ट जो उपयोगकर्ता द्वारा चुने गए लक्ष्य पृष्ठभूमि पर तैरने के लिए डिज़ाइन किया गया है:

लाइट-ग्रे चेकर्ड पृष्ठभूमि, शायद फोटोशॉप उपयोगकर्ताओं के लिए सबसे अधिक परिचित है, अल्फा चैनल, या पारदर्शिता चैनल का प्रतिनिधित्व करने के लिए आई है, यहां तक कि सरल उपभोक्ता आइटम जैसे स्टॉक छवियों में भी।
इस तरह की पारदर्शिता तीस साल से अधिक समय से उपलब्ध है; 1990 के दशक की शुरुआत की डिजिटल क्रांति के बाद से, उपयोगकर्ता वीडियो और छवियों से तत्वों को निकालने में सक्षम हो गए हैं जो एक बढ़ती जटिलता की श्रृंखला के माध्यम से उपकरण और तकनीकों का उपयोग करके।
उदाहरण के लिए, नीले पर्दे और हरे पर्दे की पृष्ठभूमि को वीडियो फुटेज से ‘ड्रॉप आउट’ करने की चुनौती, जो एक बार महंगी रासायनिक प्रक्रियाओं और ऑप्टिकल प्रिंटर्स (साथ ही हाथ से बनाए गए मैट्स) का काम था, एडोब के आफ्टर इफेक्ट्स और फोटोशॉप अनुप्रयोगों जैसी प्रणालियों में कुछ मिनटों का काम बन जाएगा।
एक बार जब कोई तत्व अलग हो जाता है, तो अल्फा चैनल (जो एक मास्क की तरह है जो किसी भी गैर-प्रासंगिक सामग्री को ढक देता है) किसी भी तत्व को आसानी से किसी भी नए पृष्ठभूमि पर या अन्य अलग-अलग तत्वों के साथ संयोजित करने की अनुमति देता है।

अल्फा चैनल के उदाहरण, निचली पंक्ति में उनके प्रभावों के साथ। स्रोत: https://helpx.adobe.com/photoshop/using/saving-selections-alpha-channel-masks.html
ड्रॉपिंग आउट
कंप्यूटर दृष्टि में, अल्फा चैनल का निर्माण सेमांटिक सेगमेंटेशन के दायरे में आता है, जिसमें मेटा के सेगमेंट एनीथिंग जैसे ओपन-सोर्स परियोजनाएं पाठ-प्रेरित विधि प्रदान करती हैं लक्ष्य वस्तुओं को अलग करने और निकालने के लिए, सेमैंटिक रूप से बढ़े हुए वस्तु पहचान के माध्यम से।
सेगमेंट एनीथिंग फ्रेमवर्क का उपयोग विभिन्न दृश्य प्रभाव निष्कर्षण और अलगाव कार्य प्रवाह में किया गया है, जैसे कि अल्फा-क्लिप परियोजना।

सेगमेंट एनीथिंग का उपयोग करके निष्कर्षण के उदाहरण, अल्फा-क्लिप फ्रेमवर्क में:
अल्फा चैनल को असाइन करने के लिए कई विकल्प हैं जो सेमांटिक सेगमेंटेशन विधियों के रूप में कार्य कर सकते हैं।
हालांकि, सेमांटिक सेगमेंटेशन प्रशिक्षित डेटा पर निर्भर करता है जो आवश्यक वस्तुओं की सभी श्रेणियों को शामिल नहीं कर सकता है। हालांकि बड़ी मात्रा में डेटा पर प्रशिक्षित मॉडल व्यापक श्रृंखला की वस्तुओं को पहचानने में सक्षम हो सकते हैं (प्रभावी रूप से मूल मॉडल या विश्व मॉडल बन जाते हैं), वे अभी भी उन वर्गों द्वारा सीमित हैं जिनके लिए वे सबसे प्रभावी ढंग से प्रशिक्षित हैं।

सेगमेंट एनीथिंग जैसे सेमांटिक सेगमेंटेशन प्रणाली कुछ वस्तुओं या वस्तुओं के हिस्सों की पहचान करने में संघर्ष कर सकती हैं, जैसा कि यहां अस्पष्ट प्रॉम्प्ट्स से आउटपुट में दिखाया गया है। स्रोत: https://maucher.pages.mi.hdm-stuttgart.de/orbook/deeplearning/SAM.html
किसी भी मामले में, सेमांटिक सेगमेंटेशन एक पोस्ट फैक्टो प्रक्रिया है, जैसा कि एक हरित पर्दा प्रक्रिया है, और बिना एक एकल स्वाथ के पृष्ठभूमि रंग के लाभ के बिना तत्वों को अलग करना होगा जो प्रभावी ढंग से पहचाना और हटाया जा सकता है।
इसलिए, यह कभी-कभी उपयोगकर्ता समुदाय को लगता है कि छवियों और वीडियो का निर्माण किया जा सकता है जो वास्तव में हरित पर्दे की पृष्ठभूमि होती है जो पारंपरिक तरीकों से तुरंत हटा दी जा सकती है।
दुर्भाग्य से, लोकप्रिय लेटेंट डिफ्यूजन मॉडल जैसे स्टेबल डिफ्यूजन अक्सर एक वास्तविक हरित पर्दा पृष्ठभूमि को प्रस्तुत करने में कुछ कठिनाई होती है। यह इसलिए है क्योंकि मॉडल के प्रशिक्षण डेटा में आमतौर पर इस विशेष परिदृश्य के कई उदाहरण नहीं होते हैं।

उपर, हम देखते हैं कि स्टेबल डिफ्यूजन ने छवि की प्रामाणिकता को पृष्ठभूमि के एक ही तीव्रता को बनाने की आवश्यकता से ऊपर रखा है, पारंपरिक हरित पर्दे की स्थिति में होने वाली वास्तविक दुनिया की समस्याओं को प्रभावी ढंग से पुनः उत्पन्न करता है। नीचे, हम देखते हैं कि ‘हरा’ अवधारणा अग्रभूमि छवि में प्रदूषित हो गई है। जितना अधिक प्रॉम्प्ट ‘हरे’ अवधारणा पर केंद्रित होता है, यह समस्या उतनी ही खराब होने की संभावना है। स्रोत: https://stablediffusionweb.com/
उन्नत तरीकों के बावजूद, दोनों महिला की पोशाक और पुरुष की टाई (उपर दिखाई देने वाली निचली छवियों में) हरित पृष्ठभूमि के साथ ‘ड्रॉप आउट’ होने की प्रवृत्ति रखते हैं – एक समस्या जो 1970 और 1980 के दशक में फोटोकेमिकल एमुल्शन डाई हटाने के दिनों से वापस आती है।
जैसा कि हमेशा, मॉडल की कमियों को विशिष्ट डेटा को समस्या पर फेंककर पार किया जा सकता है, और महत्वपूर्ण प्रशिक्षण संसाधनों को समर्पित करके। स्टैनफोर्ड की 2024 की पेशकश लेयरडिफ्यूज जैसी प्रणालियां एक फाइन-ट्यून मॉडल बनाती हैं जो अल्फा चैनल के साथ छवियों का उत्पादन करने में सक्षम हैं:

स्टैनफोर्ड लेयरडिफ्यूज परियोजना को एक मिलियन उपयुक्त छवियों पर प्रशिक्षित किया गया था जो मॉडल को पारदर्शिता क्षमता प्रदान करने में सक्षम था। स्रोत: https://arxiv.org/pdf/2402.17113
दुर्भाग्य से, इस दृष्टिकोण के अलावा आवश्यक प्रशिक्षण संसाधनों के अलावा, लेयरडिफ्यूज के लिए उपयोग किया जाने वाला डेटासेट सार्वजनिक रूप से उपलब्ध नहीं है, जो मॉडल को प्रशिक्षित करने वालों के उपयोग को सीमित करता है। यहां तक कि अगर यह बाधा मौजूद नहीं थी, तो यह दृष्टिकोण विशिष्ट उपयोग के मामलों के लिए अनुकूलित या विकसित करने में कठिन है।
2024 के बाद, एडोब रिसर्च ने स्टोनी ब्रुक विश्वविद्यालय के साथ मिलकर मैगिक बनाया, जो कस्टम-निर्मित डिफ्यूजन छवियों पर प्रशिक्षित एआई निष्कर्षण दृष्टिकोण है।

2024 के पेपर से, मैगिक में फाइन-ग्रेनेड अल्फा चैनल निष्कर्षण का एक उदाहरण। स्रोत: https://openaccess.thecvf.com/content/CVPR2024/papers/Burgert_MAGICK_A_Large-scale_Captioned_Dataset_from_Matting_Generated_Images_using_CVPR_2024_paper.pdf
मैगिक को प्रशिक्षित करने के लिए 150,000 निकाले गए, एआई-जनित वस्तुओं का उपयोग किया गया ताकि प्रणाली निष्कर्षण की एक स्वाभाविक समझ विकसित कर सके:
(ADBE )
मैगिक प्रशिक्षण डेटासेट के नमूने।
इस डेटासेट के रूप में, स्रोत पत्र के अनुसार, इसका उत्पादन करना बहुत कठिन था – इस कारण से कि डिफ्यूजन तरीकों में ठोस रंग के स्वाथ का निर्माण करने में कठिनाई होती है। इसलिए, उत्पन्न मैट्स का मैनुअल चयन आवश्यक था।
यह लॉजिस्टिक बोतलनेक एक बार फिर से एक ऐसी प्रणाली की ओर ले जाता है जिसे आसानी से विकसित या अनुकूलित नहीं किया जा सकता है, बल्कि इसकी प्रारंभिक प्रशिक्षित सीमा के भीतर उपयोग किया जाना चाहिए।
TKG-DM – ‘नेटिव’ क्रोमा निष्कर्षण एक लेटेंट डिफ्यूजन मॉडल के लिए
एक नए सहयोग में, जर्मन और जापानी शोधकर्ताओं ने विशेष रूप से क्यूरेट किए गए डेटासेट पर प्रशिक्षित करने की आवश्यकता के बिना बेहतर परिणाम प्राप्त करने में सक्षम एक विकल्प का प्रस्ताव दिया है।

TKG-DM एक जनरेटिव छवि को बीज देने वाले यादृच्छिक शोर को बदल देता है ताकि यह किसी भी रंग में एक ठोस, कुंजीयोग्य पृष्ठभूमि का उत्पादन करने में बेहतर ढंग से सक्षम हो। स्रोत: https://arxiv.org/pdf/2411.15580
नई विधि यादृच्छिक शोर को अनुकूलित करके समस्या को हल करती है जिससे एक लेटेंट डिफ्यूजन मॉडल (एलडीएम) जैसे स्टेबल डिफ्यूजन में एक छवि उत्पन्न की जाती है।
यह दृष्टिकोण एक पिछले जांच पर आधारित है जो स्टेबल डिफ्यूजन वितरण के रंग योजना में, और यह किसी भी प्रकार की पृष्ठभूमि रंग का उत्पादन करने में सक्षम है, अन्य विधियों की तुलना में अग्रभूमि सामग्री में कुंजी पृष्ठभूमि रंग के प्रवेश के साथ कम (या कोई)।

प्रारंभिक शोर एक चैनल मीन शिफ्ट द्वारा सशर्त है जो डीनोइज़िंग प्रक्रिया के पहलुओं को प्रभावित करने में सक्षम है बिना रंग संकेत को अग्रभूमि सामग्री में उलझाए।
पेपर में कहा गया है:
‘हमारे व्यापक प्रयोगों से पता चलता है कि TKG-DM FID और मास्क-FID स्कोर में क्रमशः 33.7% और 35.9% की वृद्धि करता है। ‘
‘इस प्रकार, हमारा प्रशिक्षण-मुक्त मॉडल फाइन-ट्यून किए गए मॉडल को पार करता है, विभिन्न दृश्य सामग्री निर्माण कार्यों के लिए सटीक अग्रभूमि और पृष्ठभूमि नियंत्रण के लिए एक कुशल और बहुमुखी समाधान प्रदान करता है। ‘
नई पेपर का शीर्षक TKG-DM: प्रशिक्षण-मुक्त क्रोमा की कुंजी सामग्री जेनरेशन डिफ्यूजन मॉडल है, और यह सात शोधकर्ताओं से होसे विश्वविद्यालय, टोक्यो और आरपीटीयू कैसरस्लाउटर्न-लांडाउ और डीएफकेआई जीएमबीएच, कैसरस्लाउटर्न में है।
विधि
नई विधि स्टेबल डिफ्यूजन की वास्तुकला को विस्तारित करती है जो प्रारंभिक गाउसियन शोर को एक चैनल मीन शिफ्ट (सीएमएस) के माध्यम से सशर्त करती है, जो वांछित पृष्ठभूमि/अग्रभूमि पृथक्करण को प्रोत्साहित करने के लिए डिज़ाइन किए गए शोर पैटर्न का उत्पादन करती है।

प्रस्तावित प्रणाली के कार्य के लिए योजना।
सीएमएस प्रत्येक रंग चैनल के माध्यम को समायोजित करता है, डीनोइज़िंग प्रक्रिया के सामान्य विकास को बनाए रखते हुए।
लेखकों का कहना है:
‘अग्रभूमि वस्तु को क्रोमा की कुंजी पृष्ठभूमि पर उत्पन्न करने के लिए, हम एक प्रारंभिक शोर चयन रणनीति लागू करते हैं जो एक 2D गाउसियन मास्क का उपयोग करके प्रारंभिक [शोर] और प्रारंभिक रंग [शोर] को संयोजित करती है। ‘
‘यह मास्क एक 2D गाउसियन मास्क का उपयोग करके एक क्रमिक संक्रमण बनाता है जो मूल शोर को अग्रभूमि क्षेत्र में संरक्षित करता है और पृष्ठभूमि क्षेत्र में रंग-विस्थापित शोर लागू करता है।’

पृष्ठभूमि क्रोमा रंग के लिए वांछित रंग चैनल को एक शून्य पाठ प्रॉम्प्ट के साथ इन्स्टेंट किया जाता है, जबकि वास्तविक अग्रभूमि सामग्री उपयोगकर्ता के पाठ निर्देश से सेमेंटिक रूप से बनाई जाती है।
स्व-ध्यान और क्रॉस-ध्यान का उपयोग छवि के दो पहलुओं (क्रोमा पृष्ठभूमि और अग्रभूमि सामग्री) को अलग करने के लिए किया जाता है। स्व-ध्यान अग्रभूमि वस्तु की आंतरिक स्थिरता में मदद करता है, जबकि क्रॉस-ध्यान पाठ प्रॉम्प्ट के प्रति वफादारी बनाए रखता है। पेपर में कहा गया है कि поскольку पृष्ठभूमि छवियां आमतौर पर विस्तार से विवरण और जोर देने में कम होती हैं, उनका कमजोर प्रभाव अपेक्षाकृत आसानी से पार किया जा सकता है और शुद्ध रंग के स्वाथ से बदल दिया जा सकता है।

क्रोमा-शैली के उत्पादन प्रक्रिया में स्व-ध्यान और क्रॉस-ध्यान के प्रभाव का दृश्यीकरण।
डेटा और परीक्षण
TKG-DM का परीक्षण स्टेबल डिफ्यूजन V1.5 और स्टेबल डिफ्यूजन SDXL का उपयोग करके किया गया था।
छवियों को 512x512px और 1024x1024px पर उत्पन्न किया गया था, क्रमशः।
छवियों का निर्माण स्टेबल डिफ्यूजन में मूल DDIM शेड्यूलर का उपयोग करके किया गया था, 7.5 के मार्गदर्शन स्केल पर, 50 डीनोइज़िंग चरणों के साथ। लक्षित पृष्ठभूमि रंग हरा था, अब प्रमुख ड्रॉपआउट विधि।
नई विधि की तुलना डीपफ्लॉयड से की गई थी, जो मैगिक के लिए उपयोग की जाने वाली सेटिंग्स के तहत; फाइन-ट्यून किए गए लो-रैंक डिफ्यूजन मॉडल ग्रीनबैक लोरा के साथ; और इसके अलावा ऊपर उल्लिखित लेयरडिफ्यूज के साथ।
डेटा के लिए, मैगिक डेटासेट से 3000 छवियों का उपयोग किया गया था।

मैगिक डेटासेट से उदाहरण, जिनमें से 3000 छवियों को नए सिस्टम के परीक्षण के लिए क्यूरेट किया गया था। स्रोत: https://ryanndagreat.github.io/MAGICK/Explorer/magick_rgba_explorer.html
मेट्रिक्स के लिए, लेखकों ने अग्रभूमि गुणवत्ता का मूल्यांकन करने के लिए फ्रेचेट इन्सेप्शन डिस्टेंस (एफआईडी) का उपयोग किया। उन्होंने मास्क-एफआईडी स्कोर का मूल्यांकन करने के लिए एक परियोजना-विशिष्ट मेट्रिक भी विकसित किया, जो बायरेफनेट प्रणाली का उपयोग करता है।

पिछले तरीकों के खिलाफ बायरेफनेट प्रणाली की दृश्य तुलना। स्रोत: https://arxiv.org/pdf/2401.03407
पाठ प्रेरितों के साथ सेमेंटिक संरेखण का परीक्षण करने के लिए, सीएलआईपी-वाक्य (सीएलआईपी-एस) और सीएलआईपी-इमेज (सीएलआईपी-आई) विधियों का उपयोग किया गया था। सीएलआईपी-एस प्रॉम्प्ट वफादारी का मूल्यांकन करता है, और सीएलआईपी-आई ग्राउंड ट्रुथ के साथ दृश्य समानता का मूल्यांकन करता है।

नई विधि के लिए पहला सेट गुणात्मक परिणाम, इस बार स्टेबल डिफ्यूजन V1.5 के लिए। कृपया बेहतर रिज़ॉल्यूशन के लिए स्रोत पीडीएफ से परामर्श लें।
लेखकों का दावा है कि परिणाम (उपर और नीचे, एसडी1.5 और एसडीएक्सएल, क्रमशः) यह प्रदर्शित करते हैं कि टीकेजी-डीएम बिना प्रॉम्प्ट इंजीनियरिंग या मॉडल को प्रशिक्षित या फाइन-ट्यून करने की आवश्यकता के बिना बेहतर परिणाम प्राप्त करता है।

एसडीएक्सएल गुणात्मक परिणाम। कृपया बेहतर रिज़ॉल्यूशन के लिए स्रोत पीडीएफ से परामर्श लें।
वे यह भी देखते हैं कि जब एक प्रॉम्प्ट हरित पृष्ठभूमि को उत्पन्न करने के लिए दिया जाता है, तो स्टेबल डिफ्यूजन 1.5 एक साफ पृष्ठभूमि का उत्पादन करने में कठिनाई होती है, जबकि एसडीएक्सएल (हालांकि थोड़ा बेहतर प्रदर्शन करता है) अस्थिर हल्दी हरे रंग का उत्पादन करता है जो क्रोमा प्रक्रिया में हस्तक्षेप कर सकता है।
वे आगे यह भी देखते हैं कि लेयरडिफ्यूज अच्छी तरह से अलग पृष्ठभूमि का उत्पादन करता है, लेकिन कभी-कभी विवरण खो देता है, जैसे कि सटीक संख्या या अक्षर, और लेखकों का मानना है कि यह डेटासेट की सीमाओं के कारण है। वे यह भी जोड़ते हैं कि मास्क उत्पादन कभी-कभी विफल हो जाता है, जिससे ‘अनकट’ छवियां हो जाती हैं।
मात्रात्मक परीक्षणों के लिए, हालांकि लेयरडिफ्यूज एसडीएक्सएल में एफआईडी के लिए एक स्पष्ट लाभ प्रतीत होता है, लेखकों का जोर है कि यह एक विशेष डेटासेट के कारण है जो एक ‘बेक्ड’ और गैर-लचीला उत्पाद का गठन करता है। जैसा कि पहले उल्लेख किया गया है, डेटासेट में शामिल नहीं की गई किसी भी वस्तु या वर्ग, या पर्याप्त रूप से कवर नहीं किए गए, अच्छा प्रदर्शन नहीं कर सकते हैं, जबकि नए वर्गों को समायोजित करने के लिए आगे फाइन-ट्यूनिंग प्रयासों का बोझ उपयोगकर्ता पर पड़ता है।

तुलना के लिए मात्रात्मक परिणाम। पेपर का सुझाव है कि लेयरडिफ्यूज का स्पष्ट लाभ लचीलेपन की कमी और डेटा क्यूरेशन और प्रशिक्षण के बोझ के कारण है।
पेपर में कहा गया है:
‘डीपफ्लॉयड के उच्च एफआईडी, मास्क-एफआईडी, और सीएलआईपी-आई स्कोर उनके आउटपुट और ग्राउंड ट्रुथ के बीच समानता को दर्शाते हैं, जो डीपफ्लॉयड के आउटपुट के आधार पर है। हालांकि, यह समानता इसे एक निष्पक्ष बेंचमार्क के रूप में उपयुक्त बनाती है, क्योंकि यह एक अंतर्निहित लाभ प्रदान करती है। इसका कम सीएलआईपी-एस स्कोर कमजोर पाठ संरेखण को भी दर्शाता है।’
‘कुल मिलाकर, ये परिणाम हमारे मॉडल की क्षमता को रेखांकित करते हैं जो फाइन-ट्यूनिंग के बिना उच्च-गुणवत्ता वाले अग्रभूमि का उत्पादन करता है, एक कुशल क्रोमा की कुंजी सामग्री उत्पादन समाधान प्रदान करता है। ‘
अंत में, शोधकर्ताओं ने प्रॉम्प्ट अनुपालन का मूल्यांकन करने के लिए उपयोगकर्ता अध्ययन किया। सौ प्रतिभागियों को प्रत्येक विधि से तीस छवि जोड़े का मूल्यांकन करने के लिए कहा गया था, जिनमें बायरेफनेट और मैनुअल रिफाइनमेंट का उपयोग करके सभी उदाहरणों से विषयों को निकाला गया था। लेखकों के प्रशिक्षण-मुक्त दृष्टिकोण को इस अध्ययन में पसंद किया गया था।

उपयोगकर्ता अध्ययन के परिणाम।
TKG-DM स्टेबल डिफ्यूजन के लिए लोकप्रिय तृतीय-पक्ष प्रणाली कंट्रोलनेट के साथ संगत है, और लेखकों का दावा है कि यह इस तरह के पृथक्करण को प्राप्त करने की कंट्रोलनेट की मूल क्षमता से बेहतर परिणाम उत्पन्न करता है।
निष्कर्ष
शायद इस नए पेपर से सबसे उल्लेखनीय बात यह है कि लेटेंट डिफ्यूजन मॉडल कितने जुड़े हुए हैं, इसके विपरीत लोकप्रिय सार्वजनिक धारणा है कि वे आसानी से छवियों और वीडियो के विभिन्न पहलुओं को अलग कर सकते हैं जब वे नए सामग्री का उत्पादन करते हैं।
अध्ययन आगे इस बात पर जोर देता है कि शोध और शौक समुदाय ने मॉडल की कमियों के लिए एक पोस्ट फैक्टो समाधान के रूप में फाइन-ट्यूनिंग पर कितना निर्भर है। एक ऐसी स्थिति में जहां एक फाइन-ट्यून किया गया मॉडल या तो एक सीमित संख्या में वर्गों पर बहुत अच्छा प्रदर्शन करेगा, या एक बहुत बड़ी मात्रा में संभावित वर्गों और वस्तुओं पर सहनीय रूप से प्रदर्शन करेगा, उच्च मात्रा में प्रशिक्षण सेट में डेटा के अनुसार।
इसलिए, यह देखकर ताजगी होती है कि कम से कम एक समाधान है जो ऐसी श्रमसाध्य और विवादास्पद समाधानों पर निर्भर नहीं करता है।
* 1978 की फिल्म सुपरमैन की शूटिंग के दौरान, अभिनेता क्रिस्टोफर रीव को नीले पर्दे की प्रक्रिया के लिए एक टरकोईज़ सुपरमैन पोशाक पहनने की आवश्यकता थी, ताकि प्रतिष्ठित नीली पोशाक को मिटाया जा सके। पोशाक का नीला रंग बाद में रंग ग्रेडिंग के माध्यम से बहाल किया गया था।


