Anderson का एंगल
एआई की सहायता से टाइपोग्राफी के माध्यम से भावना व्यक्त करना

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मुख्य बिंदुवाक्-मॉड्यूलेटेड टाइपोग्राफी पिच, अवधि और प्रबलता को बेसलाइन शिफ्ट, कर्निंग और फ़ॉन्ट…
और देखें
- वाक्-मॉड्यूलेटेड टाइपोग्राफी पिच, अवधि और प्रबलता को बेसलाइन शिफ्ट, कर्निंग और फ़ॉन्ट वेट पर मैप करती है।
- गतिशील कैप्शन स्थिर कैप्शन की तुलना में खराब स्कोर करते हैं क्योंकि एनिमेटेड पढ़ना दर्शकों के लिए संज्ञानात्मक भार बढ़ाता है।
- संज्ञानात्मक भार के कारण स्थिर मॉड्यूलेटेड टेक्स्ट ने 67% सही स्कोर किया, जबकि एनिमेटेड टेक्स्ट ने 63% स्कोर किया।
वर्तमान प्रवृत्तियों और नवाचारों को टेक्स्ट संचार (जिसमें ईमेल, संदेश और कैप्शनिंग सिस्टम शामिल हैं) में लिखित और बोली जाने वाली भाषा के बीच भावनात्मक अंतर को सुलझाने के लिए क्रूड और अनुमानित तरीकों से निपटना होगा।
उदाहरण के लिए, पिछले कुछ वर्षों में बड़े और छोटे अक्षरों का बारी-बारी से इस्तेमाल सोशल मीडिया की तीखी बहसों में एक उत्तेजक मीम के रूप में लोकप्रिय हो गए हैं, जबकि बहुत घृणित कैप्स लॉक (साथ ही साथ कुछ टिप्पणी मंचों द्वारा अनुमत बोल्ड और चौंकाने वाले टाइपोग्राफिक प्रभाव) मॉडरेटरों से हस्तक्षेप का कारण बनता है। ये एक-आयामी और केवल व्यापक रूप से प्रतिनिधित्व करने वाले तरीके हैं जो लिखित शब्द के इरादे को स्पष्ट करने के लिए हैं।
इसी समय, भावनाओं और भावनाओं को व्यक्त करने वाले एक हाइब्रिड पाठ/दृश्य अभिव्यक्ति के रूप में इमोटिकॉन और इमोजी की लोकप्रियता में वृद्धि के साथ, प्राकृतिक भाषा प्रसंस्करण (एनएलपी) अनुसंधान क्षेत्र ने हाल के वर्षों में सक्रिय रूप से भाग लिया है, साथ ही साथ एनिमेटेड जीआईएफ के अर्थ में रुचि के साथ जो उपयोगकर्ता टिप्पणी थ्रेड में पोस्ट करते हैं।
लिखित भाषा ने समय के साथ इन ‘अतिरिक्त’ भाषाई तरीकों का एक अभिनव कोष विकसित किया है, जो या तो भावना को प्रॉक्सी करने का प्रयास करते हैं या बोली जाने वाले शब्द में टोनल जानकारी की अनुपस्थिति में इसे उत्पन्न करते हैं।
आम तौर पर, हालांकि, हमें लिखित शब्द के संदर्भ से भावना का यथासंभव सही अनुमान लगाने की आवश्यकता होती है। उदाहरण के लिए, उद्गार ‘ओह, ओह, ओह!’ लेडी मैकबेथ के विक्षिप्त रात्रिकालीन एकालाप के अंत में आता है और यह दिखाता है कि स्वर अर्थ को कितना प्रभावित कर सकता है।
अधिकांश अनुकूलन में, यह पीड़ादायक विलाप 2-6 सेकंड तक रहता है; ट्रेवर नन के 1976 के रॉयल शेक्सपियर कंपनी के मैकबेथ उत्पादन में, जूडी डेंच ने इस पंक्ति को शायद अब तक अटूट रिकॉर्ड 24.45 सेकंड तक खींचा, जो इस भूमिका की एक यादगार व्याख्या थी।
(यूट्यूब की अपनी स्व-उपशीर्षक प्रणाली इस क्लिप के लिए डेन्च के उलुलेशन को [संगीत] के रूप में वर्णित करती है)
प्रोसोडी को टाइपोग्राफी में अनुवाद करना
ब्राजील से एक हालिया शोध पत्र एक भाषण-नियंत्रित टाइपोग्राफी प्रणाली का प्रस्ताव करता है जो संभावित रूप से ऐसे प्रोसोडी और अन्य पैरालिंग्विस्टिक घटकों को सीधे उपशीर्षक वाले भाषण में शामिल कर सकता है, इससे भावना का एक ऐसा आयाम जुड़ सकता है जिसे [चिल्लाना] जैसे वर्णन पहले जोड़कर या पारंपरिक उपशीर्षकों के अन्य सपाट तरीकों से पर्याप्त रूप से व्यक्त नहीं किया जा सकता।
‘हम एक नए मॉडल का प्रस्ताव करते हैं जो भाषण-नियंत्रित टाइपोग्राफी है, जहां भाषण से ध्वनिक विशेषताएं पाठ के दृश्य रूप को संशोधित करने के लिए उपयोग की जाती हैं। इससे एक दिए गए उच्चारण के लिप्यंतरण को न केवल उन शब्दों का प्रतिनिधित्व करने की अनुमति मिल सकती है जो कहे जा रहे हैं, बल्कि वे कैसे कहे जा रहे हैं। ‘
‘इससे हमें आशा है कि हम टाइपोग्राफिक पैरामीटर का पता लगा सकते हैं जो सामान्य रूप से प्रोसोडिक विशेषताओं के लिए दृश्य प्रॉक्सी के रूप में मान्यता प्राप्त हो सकते हैं: परिमाण, पिच और अवधि।’

प्रोसोडी को टाइपोग्राफिक स्टाइलिंग में अनुवादित करने की प्रक्रिया। सबसे अधिक लचीला और व्यापक रूप से तैनात करने योग्य प्रणाली का उत्पादन करने के लिए, लेखकों ने खुद को बेसलाइन शिफ्ट, कर्निंग और बोल्डनेस तक सीमित रखा, जो एक OpenType फ़ॉन्ट की बहुमुखी प्रतिभा द्वारा प्रदान की जाती है। स्रोत: https://arxiv.org/pdf/2202.10631.pdf
शोध पत्र शीर्षक है छिपी हुई चीखें, फुसफुसाहट और चीखें: क्या पाठ को केवल उसके शब्दों से अधिक सुनने के लिए बनाया जा सकता है?, और यह ब्राज़ील के Universidade Estadual de Campinas के शोधकर्ताओं कैलुआ डी लासेर्डा पाटाका और पाउला डोर्नहोफर पारो कोस्टा से आया है।
बोल्ड शब्द
हालांकि परियोजना का व्यापक उद्देश्य प्रोसोडी और अन्य पैरालिंग्विस्टिक भाषा सुविधाओं को उपशीर्षक में व्यक्त करने वाली प्रणाली विकसित करना है, लेखकों का मानना है कि इस प्रकार की प्रणाली अंततः श्रवण दुनिया में एक व्यापक दर्शक वर्ग विकसित कर सकती है।
इस क्षेत्र में कई पहले के प्रयास हैं, जिनमें 1983 की एक परियोजना शामिल है जिसने एक उपशीर्षक प्रणाली का प्रस्ताव किया था जो ‘विशेष प्रभाव, रंग और बड़े अक्षर [उस] समृद्ध स्वर-संबंधी जानकारी [को दर्शाने के लिए] इस्तेमाल किए जा सकते हैं जिससे बहरे बच्चे वंचित रहते हैं।’
इसके विपरीत, ब्राज़ील की परियोजना स्वचालित प्रतिलेखन और भावात्मक अवस्था पहचान में नई प्रगति का लाभ उठा सकती है। इनके संयोजन से ऐसा कार्यप्रवाह बनता है जो भाषण की ध्वनि रिकॉर्डिंग के घटकों को आयात कर उनकी विशेषताएँ निर्धारित कर सके।
एक बार प्रोसोडिक विशेषताएं निकाली और संसाधित की जाती हैं, तो उन्हें भाषण के शब्दों के समय-स्टैम्प के साथ मैप किया जाता है, जो टोकन का उत्पादन करते हैं जो उपशीर्षक टाइपोग्राफी के नियम-आधारित संशोधन को लागू करने के लिए उपयोग किए जा सकते हैं (ऊपर देखें)।
यह परिणाम दिखा सकता है कि किसी अक्षरांश को कितना खींचा गया है, फुसफुसाकर कहा गया है या उस पर कितना ज़ोर दिया गया है। ऐसी संदर्भ-संबंधी जानकारी साधारण प्रतिलेखन में खो जाती है।

परियोजना के परीक्षण चरण से, ध्यान दें कि कैसे कर्निंग (एक शब्द में अक्षरों के बीच की दूरी) को एक खींचे गए उच्चारण को प्रतिबिंबित करने के लिए चौड़ा किया गया है।
लेखक स्पष्ट करते हैं कि उनका काम भावना और भावात्मक अवस्था की पहचान अनुसंधान में सीधे योगदान देने के लिए नहीं है, बल्कि भाषण की विशेषताओं को वर्गीकृत करने और उन्हें नए दृश्य संकेतों की एक सरल और सीमित श्रृंखला के साथ प्रतिनिधित्व करने का प्रयास करता है।
कम से कम, प्रणाली द्वारा प्रदान किए गए अतिरिक्त जोर से वाक्यों को स्पष्ट करता है जहां क्रिया का विषय श्रोताओं के लिए स्पष्ट नहीं हो सकता है जो ध्वनि (विकलांगता या प्लेबैक की परिस्थितियों के माध्यम से) सुन नहीं सकते हैं।
मेरे अपने 2017 के उदाहरण को उधार लेने के लिए, जिसने यह देखने के लिए देखा कि मशीन लर्निंग सिस्टम कठिनाई हो सकती है वाक्य में क्रिया और वस्तु की स्थिति को समझने में, यह आसानी से देखा जा सकता है कि जोर कितना अर्थ बदल सकता है, यहां तक कि एक सरल वाक्य में भी:
मैं ने वह नहीं चुराया। (किसी और ने इसे चुरा लिया)
मैंने वह नहीं चुराया। (मैं यह आरोप नकारता हूं कि मैंने इसे चुराया)
मैंने वह चुराया नहीं। (मैं इसका मालिक हूं, चोरी लागू नहीं होती है)
मैंने वह नहीं चुराया। (लेकिन मैंने कुछ और चुरा लिया)
संभावित रूप से, एक यांत्रिक प्रोसोडी> टाइपोग्राफी कार्यप्रवाह जैसा कि ब्राजीलियाई लेखक सुझाव देते हैं, भावात्मक कंप्यूटिंग अनुसंधान के लिए डेटासेट के विकास में एक सहायक के रूप में भी उपयोगी हो सकता है, क्योंकि यह शुद्ध पाठ-आधारित डेटा को सुविधाजनक बनाता है जो कुछ पहले से अनुमानित पैरालिंग्विस्टिक आयामों को शामिल करता है।
इसके अलावा, शोधकर्ता नोट करते हैं, प्रोसोडी जागरूक पाठ का अतिरिक्त भाषाई पेलोड ग्राहक संतुष्टि मूल्यांकन और पाठ सामग्री से अवसाद के अनुमान जैसे विभिन्न एनएलपी-आधारित कार्यों में उपयोगी हो सकता है।
लचीली टाइपोग्राफी
शोधकर्ताओं के विकसित ढाँचे में बेसलाइन शिफ्ट के द्वारा अक्षर को वाक्य की आधार रेखा से ऊपर या नीचे रखा जा सकता है; कर्निंग से शब्द के अक्षरों के बीच की दूरी घटाई या बढ़ाई जा सकती है; और फ़ॉन्ट-वेट से अक्षरों का मोटापन बदला जा सकता है।
इन तीन शैलियों को भाषण से निकाली गई विशेषताओं के साथ मैप किया जाता है जिन्हें परियोजना ने स्वयं को सीमित रखा है: क्रमशः, पिच, अवधि, और परिमाण।

एक वाक्य पर स्टाइलिंग की प्रगति। #1 में, हम निकाली गई प्रक्रिया में परिभाषित सिलेबल सीमाओं को देखते हैं। #2 में, हम प्रत्येक तीन मॉड्यूलेशन (परिमाण/वजन, कर्निंग/अवधि, और पिच/बेसलाइन शिफ्ट) का एक प्रतिनिधित्व देखते हैं, जो व्यक्तिगत रूप से लागू किए जाते हैं। #3 में, हम अंतिम आउटपुट में संयुक्त टाइपोग्राफिक मॉड्यूलेशन को 117 प्रतिभागियों के एक परीक्षण में प्रस्तुत किया जाता है।
एक ही फ़ॉन्ट में वेरिएशन जैसे बोल्ड और इटैलिक के लिए एक अतिरिक्त और अलग फ़ॉन्ट की आवश्यकता हो सकती है, शोधकर्ताओं ने गूगल इम्प्लीमेंटेशन का उपयोग किया ओपनटाइप फ़ॉन्ट इंटर, जो एक ही फ़ॉन्ट में वजन की एक ग्रैन्युलर श्रृंखला को एकीकृत करता है।

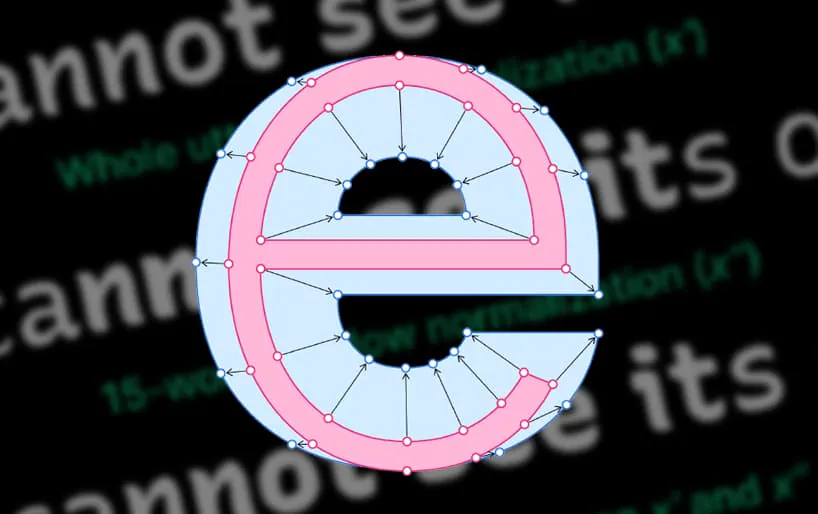
शोध पत्र से, इंटर फ़ॉन्ट से एक ओपनटाइप ग्लिफ़ के बारे में एक चार्ट जो न्यूनतम बेस स्प्लाइन के स्केलेटन के साथ बोल्ड जोर की एक श्रृंखला को व्यक्त कर सकता है।
परीक्षण
कर्निंग और बेसलाइन शिफ्ट की अभिव्यक्ति को एक ब्राउज़र प्लगइन में शामिल किया गया था, जिसने 117 श्रवण-सक्षम प्रतिभागियों पर परीक्षण संभव बनाया।
परीक्षण के लिए डेटासेट विशेष रूप से परियोजना के लिए बनाया गया था, जिसमें एक अभिनेता ने कुछ कविताओं को कई बार अलग-अलग जोर के साथ पढ़ा, जो परियोजना द्वारा अध्ययन किए जा रहे तीन विशेषताओं के अनुरूप था। कविता इसलिए चुनी गई क्योंकि वह अप्राकृतिक लगे बिना, कवि के आशय से परे भी, तरह-तरह के ज़ोर की अनुमति देती है।
प्रतिभागियों को दो समूहों में विभाजित किया गया था। पहले समूह को 15 राउंड में अभिनेता की कविता के एक छंद का पढ़ने के साथ सिंक्रोनाइज़ और एनिमेटेड मॉड्यूलेटेड पाठ मिला, जो ऑडियो क्लिप के साथ समय के साथ अनरोल हुआ।
दूसरे समूह को ठीक वही कार्य मिले, लेकिन उन्हें स्थिर छवियों के साथ प्रस्तुत किया गया, जो ऑडियो क्लिप के दौरान नहीं बदले।
सही उत्तरों की औसत दर गैर-यादृच्छिक 67% थी स्थिर छवि समूह के लिए, और 63% एनिमेटेड पाठ समूह के लिए। परीक्षण के बाद शोधकर्ताओं द्वारा एकत्र किए गए प्रतिभागी टिप्पणियों ने उनके सिद्धांत की पुष्टि की कि गतिशील व्याख्या की संज्ञानात्मक भार में योगदान हो सकता है जो गैर-स्थिर परीक्षणों के लिए कम स्कोर का कारण बना। हालांकि, ऐसे कैप्शनिंग और संदेश प्रणालियों के लिए जिनके लिए यह फ्रेमवर्क होगा, आमतौर पर डिफ़ॉल्ट रूप से पूर्व-निर्मित पाठ प्रदान करता है।
प्रतिभागी टिप्पणियों से यह भी पता चला कि कर्निंग का उपयोग अवधि को इंगित करने के लिए सीमित है, एक टिप्पणीकर्ता ने उल्लेख किया कि जब अक्षर बहुत दूर होते हैं, तो एक शब्द को अलग करना मुश्किल हो जाता है।
शोधकर्ता आगे कहते हैं:
‘[कुछ] प्रतिभागियों को लगता है कि मॉडल को अधिक सूक्ष्म और जटिल भाषण के प्रतिनिधित्व करने में सक्षम होना चाहिए, जो एक अधिक विविध और अभिव्यंजक दृश्य शब्दावली के साथ होना चाहिए। जबकि यह एक सरल कार्य नहीं है, यह अभी भी कल्पना करना प्रोत्साहित करने वाला है कि भाषण-नियंत्रित टाइपोग्राफी के विभिन्न अनुप्रयोग कैसे विकसित हो सकते हैं क्योंकि यह नई क्षेत्र विकसित होती है।’
पहली बार 24 फरवरी 2022 को प्रकाशित।