
एआई मॉडल और प्लेटफ़ॉर्म
OCP में ASUS ने दो NVIDIA Vera CPU वाले XA P2N-E2 सर्वर का अनावरण किया

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
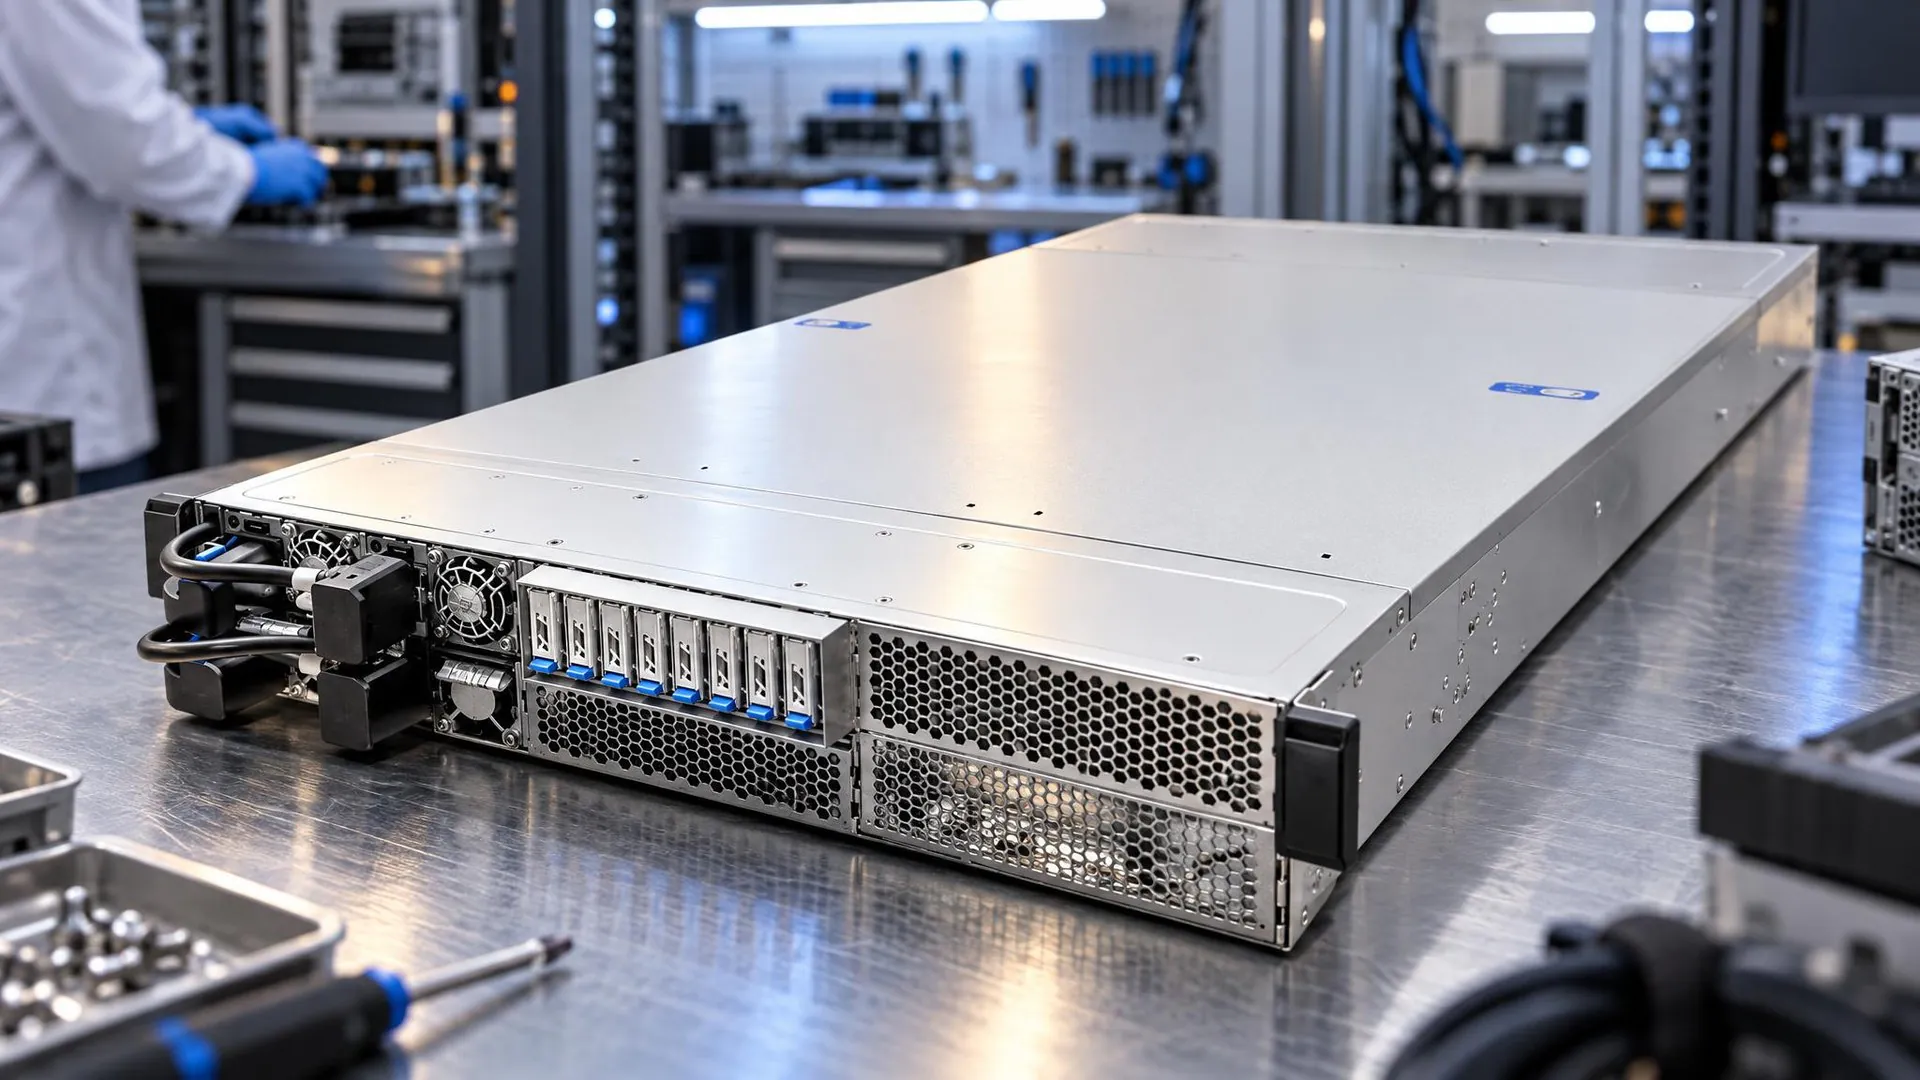
12 अक्टूबर, 2026 को कैलिफ़ोर्निया के सैन जोस में आयोजित OCP Global Summit 2026 में ASUS ने XA P2N-E2 पेश किया। यह NVIDIA MGX आर्किटेक्चर पर बना 2U सर्वर है, जिसमें दो NVIDIA Vera CPU लगे हैं। प्रेस विज्ञप्ति में कंपनी ने कहा कि यह सिस्टम एजेंटिक AI और रीइन्फोर्समेंट लर्निंग वर्कलोड के लिए डिज़ाइन किया गया है।
विज्ञप्ति के अनुसार, यह सर्वर AI अनुप्रयोगों की एक्ज़ीक्यूशन लेयर को लक्षित करता है। इसमें कोड एक्ज़ीक्यूशन, टूल का उपयोग, सैंडबॉक्सिंग, डेटा प्रोसेसिंग और ऑर्केस्ट्रेशन जैसे काम शामिल हैं—यानी ऐसे काम जो AI मॉडल तक सीमित नहीं हैं। XA P2N-E2 में अधिकतम दो डुअल-स्लॉट NVIDIA RTX PRO 6000 Blackwell Server Edition GPU लगाए जा सकते हैं। इस तरह 2U प्लेटफ़ॉर्म में CPU कंप्यूटिंग और GPU एक्सेलरेशन का मेल मिलता है। ASUS के मुताबिक, सिस्टम का सिंगल-थ्रेड CPU प्रदर्शन और उच्च-बैंडविड्थ, ऊर्जा-कुशल मेमोरी का लक्ष्य चुनौतीपूर्ण एक्ज़ीक्यूशन और मूल्यांकन कार्यों के दौरान AI एजेंट को तत्पर बनाए रखना है।
एयर-कूल्ड 2U चेसिस में दो Vera प्रोसेसर
“नया” चिह्नित XA P2N-E2 उत्पाद पृष्ठ में दो NVIDIA Vera प्रोसेसर दिए गए हैं। हर प्रोसेसर में स्पैशियल मल्टीथ्रेडिंग के साथ 88 कस्टम Olympus कोर हैं, जो 176 थ्रेड उपलब्ध कराते हैं। प्रति सॉकेट अधिकतम TDP 480W है। ASUS, Vera को AI एजेंट के लिए विशेष रूप से बनाया गया पहला CPU बताता है। ASUS की ओर से बताए गए वर्कफ़्लो में CPU सैंडबॉक्स के भीतर कोड एक्ज़ीक्यूशन, टूल के उपयोग, ऑर्केस्ट्रेशन और डेटा प्रोसेसिंग का काम संभालता है, जबकि GPU प्रशिक्षण और इन्फ़रेंस के लिए समर्पित रहते हैं।
दूसरी पीढ़ी का NVIDIA NVLink-C2C अधिकतम 1.8TB/s की सुसंगत CPU-से-CPU संचार गति देता है। उत्पाद पृष्ठ के अनुसार, कोर-से-कोर बैंडविड्थ अधिकतम 3.4TB/s है। मेमोरी में 16 SOCAMM2 मॉड्यूल हैं, जो 9600MT/s की गति से LPDDR5X चलाते हैं और अधिकतम 1.5TB क्षमता देते हैं। ASUS का कहना है कि यह कॉन्फ़िगरेशन पारंपरिक RDIMM मेमोरी की तुलना में दोगुनी तक ऊर्जा दक्षता और मेमोरी की बिजली खपत में 50% की कमी देता है।
स्टोरेज में आठ हॉट-स्वैप E1.S ड्राइव बे हैं। विस्तार के लिए दो PCIe Gen6 x16 स्लॉट और एक समर्पित डुअल-स्लॉट DPU/NIC स्लॉट दिया गया है। पूरी तरह एयर-कूल्ड चेसिस में प्रोसेसर, मेमोरी और GPU ज़ोन के बीच आगे से पीछे की ओर हवा का प्रवाह रहता है। इसमें 2+2 रिडंडेंट 2000W 80 PLUS Titanium बिजली आपूर्तियाँ हैं और इसे लिक्विड-कूलिंग इन्फ़्रास्ट्रक्चर की ज़रूरत नहीं है। MGX के मॉड्यूलर डिज़ाइन के तहत, होस्ट प्रोसेसर मॉड्यूल और GPU बे को अलग-अलग सर्विस किया जा सकता है। GPU बे में अधिकतम दो डुअल-स्लॉट RTX PRO 6000 Blackwell Server Edition GPU लगाए जा सकते हैं, जिनमें से हर एक की क्षमता अधिकतम 600W है।
एजेंटिक AI के लिए ASUS ने हार्डवेयर की चार बाधाएँ बताईं
10 अगस्त, 2026 की एक जानकारी में ASUS ने हार्डवेयर की ऐसी चार बाधाएँ बताईं, जो उसके अनुसार एजेंटिक AI के उपयोग को सीमित करती हैं: बड़े पैमाने पर पर्याप्त सिंगल-थ्रेड प्रदर्शन का अभाव, प्रति-कोर अपर्याप्त मेमोरी बैंडविड्थ, डाई के बीच डेटा पहुँचने में देरी और हार्डवेयर-स्तर पर सैंडबॉक्स आइसोलेशन का अभाव। कंपनी ने कहा कि XA P2N-E2, एजेंट के कोड एक्ज़ीक्यूशन के लिए हार्डवेयर-स्तर का सैंडबॉक्स आइसोलेशन देकर इस आख़िरी बाधा को दूर करता है। ASUS ने Vera CPU के लिए पारंपरिक x86 CPU की तुलना में 1.8 गुना तक सिंगल-थ्रेड प्रदर्शन, पारंपरिक x86 इन्फ़्रास्ट्रक्चर की तुलना में 1.8 गुना तेज़ सैंडबॉक्स कोड एक्ज़ीक्यूशन और 1.5 गुना तक तेज़ कोडिंग वर्कफ़्लो का दावा भी किया। ASUS ने इन आँकड़ों का श्रेय Vera CPU के 88-कोर डिज़ाइन, LPDDR5X की अधिकतम 1.2TB/s मेमोरी बैंडविड्थ और 3.4TB/s की आंतरिक इंटरकनेक्ट बैंडविड्थ को दिया।
अगस्त की उस जानकारी में XA P2N-E2 को ASUS के AMD EPYC 9006 प्रोसेसर पर आधारित सर्वरों के साथ लॉन्च किया गया बताया गया था। इनमें RS700A-E14B, RS720A-E14B और XA P8A-E14A सीरीज़ शामिल हैं। इन सिस्टम के लिए ASUS ने प्रति सॉकेट अधिकतम 256 कोर और पिछली पीढ़ी की तुलना में कुल प्रदर्शन में लगभग 70% बढ़ोतरी का उल्लेख किया। 16-चैनल DDR5 मेमोरी लगभग 1.6TB/s बैंडविड्थ देती है।
रैक-स्तरीय सिस्टम और NVIDIA प्लेटफ़ॉर्म तकनीकें
2U सर्वर के अलावा, ASUS OCP में रैक-स्तरीय सिस्टम भी दिखा रहा है। XA VR721-E3 ASUS AI POD में NVIDIA Vera Rubin NVL72 प्लेटफ़ॉर्म के ज़रिए 36 NVIDIA Vera CPU और 72 NVIDIA Rubin GPU एकीकृत किए गए हैं। पूरी तरह लिक्विड-कूल्ड इस आर्किटेक्चर को बड़े पैमाने पर AI प्रशिक्षण, पोस्ट-ट्रेनिंग और इन्फ़रेंस के लिए बनाया गया है। XR R1I12B-M1BHFS में NVIDIA HGX Rubin NVL8 के साथ GPU बेसबोर्ड के लिए डायरेक्ट-टू-चिप लिक्विड कूलिंग और Intel Xeon 6 प्रोसेसर के लिए एयर कूलिंग दी गई है।
ASUS ने NVIDIA DSX रेफ़रेंस डिज़ाइन और NVIDIA Omniverse DSX Blueprint का भी उल्लेख किया। कंपनी के अनुसार, ये प्रमाणित आर्किटेक्चर और उच्च-निष्ठा सिमुलेशन को एक साथ लाते हैं, ताकि AI फ़ैक्टरी के डिज़ाइन और संचालन को अनुकूलित करने के लिए तैनाती से पहले भौतिक रूप से सटीक डिजिटल ट्विन बनाए जा सकें। ASUS बूथ पर NVIDIA की चार तकनीकें दिखाई गई हैं: HGX Rubin NVL8 एक्सेलरेटेड कंप्यूटिंग, Spectrum-6 पर आधारित Spectrum-X Ethernet स्विचिंग, CMX Context Memory Storage Platform और Vera Rubin NVL72 के लिए Groq 3 LPX इन्फ़रेंस एक्सेलरेटर। विज्ञप्ति के अनुसार, यह एक्सेलरेटर NVL72 प्लेटफ़ॉर्म में अल्ट्राफ़ास्ट टोकन जनरेशन जोड़ता है, जिससे इन्फ़रेंस के दौरान प्रतिक्रिया तेज़ रहती है।
Intel और AMD के सिस्टम भी प्रदर्शित
Intel के प्रदर्शन में RS700-E12-RS4U और RS720-E12-RS12U शामिल हैं। ये Intel Xeon 6 प्रोसेसर से चलने वाले 1U और 2U डुअल-सॉकेट सर्वर हैं। इनमें DC-MHS डिज़ाइन और बिना औज़ार के सर्विसिंग की सुविधा है, और इन्हें एजेंटिक AI, वर्चुअलाइज़ेशन तथा डेटा-गहन वर्कलोड के लिए बनाया गया है। AMD के प्रदर्शन में RS700A-E14B-R16U पेश किया गया है। यह 6th Gen AMD EPYC 9006-series प्रोसेसर, जिसका कोडनेम “Venice” है, पर बना 1U डुअल-सॉकेट सिस्टम है। इसमें DC-MHS आर्किटेक्चर, PCIe 6.0 कनेक्टिविटी और अधिकतम 16 E3.S ड्राइव का समर्थन है। तापीय निगरानी और प्रबंधन के लिए इसमें ASUS Thermal Radar 3.0 दिया गया है।
एआई कार्यों में तेज़ी लाने के लिए, ESC8000A-E13P में AMD Instinct MI350P PCIe एक्सेलरेटर का समर्थन है, जबकि XA AM3A-E13 में 10U एयर-कूल्ड डिज़ाइन के तहत आठ AMD Instinct MI355X एक्सेलरेटर लगे हैं। ASUS के अनुसार, यह डिज़ाइन समर्पित चिल्ड-वॉटर इंफ्रास्ट्रक्चर के बिना उच्च-घनत्व वाली तैनाती संभव बनाता है। ASUS ने OCP Global Summit 2026 में अपने बूथ #B9 पर पूरा पोर्टफोलियो प्रदर्शित किया है। कंपनी ने बताया कि उसके सर्वर दुनिया भर में उपलब्ध हैं, हालांकि अलग-अलग उत्पादों और कॉन्फ़िगरेशन की उपलब्धता क्षेत्र के अनुसार बदलती है।


