Anderson का एंगल
AI मॉडलों का ‘रचनात्मक’ आउटपुट प्रदाताओं के बीच समान हो रहा है

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

नई शोध से पता चलता है कि प्रतिस्पर्धी कंपनियों के AI मॉडल अपनी रचनात्मक उत्तरों में अधिक समान हो रहे हैं, जिससे उपयोगकर्ताओं को मिलने वाले विचारों की विविधता घट सकती है।
संयुक्त राज्य से नई शोध ने पाया है कि प्रमुख AI मॉडलों की एक विस्तृत श्रृंखला में ‘रचनात्मक’ आउटपुट समय के साथ अधिक समान हो रहा है।
ड्यूक विश्वविद्यालय के लेखकों ने 2023 से 2026 तक के रिलीज़ को कवर करते हुए 12 प्रदाता परिवारों के 69 मॉडलों का परीक्षण किया, और पाया कि वास्तविक दुनिया के खुले‑प्रश्नों और एक मानक रचनात्मकता परीक्षण दोनों में आउटपुट विविधता में सांख्यिकीय रूप से महत्वपूर्ण गिरावट आई है – जिससे संकेत मिलता है कि सभी प्रमुख LLM प्रदाताओं में ‘रचनात्मक’ अनुरोधों के जवाब में समान विचारों की पेशकश बढ़ रही है।
परीक्षित प्रदाता परिवार थे Anthropic; Cohere; DeepSeek; Google; Meta; MiniMax; Mistral AI; Moonshot AI; OpenAI; Qwen; xAI; और Z.ai*:

नए शोधपत्र से: अध्ययन में इस्तेमाल किए गए मॉडल, जो मार्च 2023 से जुलाई 2026 के बीच जारी हुए। चार्ट में 12 AI प्रदाताओं के 69 मॉडल संस्करण हैं। यह तीन वर्षों में उनके वितरण और कुछ प्रदाताओं की बढ़ती रिलीज़ आवृत्ति को दिखाता है, जिसे शोधकर्ताओं को अपनी गणना में ध्यान में रखना पड़ा। Source
नए पेपर के लेखक कहते हैं**:
‘हम पाते हैं कि हमारे द्वारा परीक्षण किए गए खुले‑प्रश्नों के लिए LLM प्रतिक्रियाएँ समय के साथ अधिक समान होती जा रही हैं.
‘यह संकेत देता है कि LLMs खुले‑प्रश्न उत्तर उत्पन्न करने वाले कार्यों में कम रचनात्मक हो रहे हैं, जिससे उनके दीर्घकालिक रचनात्मक सहायक के रूप में उपयोगिता की जांच आवश्यक हो जाती है।’
हालाँकि ‘एल्गोरिदमिक मोनोकल्चर‘ एक स्थापित अध्ययन क्षेत्र बन गया है, AI‑जनित रचनात्मक आउटपुट में समानता की प्रवृत्तियों की जांच अब तक नहीं की गई, लेखक दावा करते हैं।
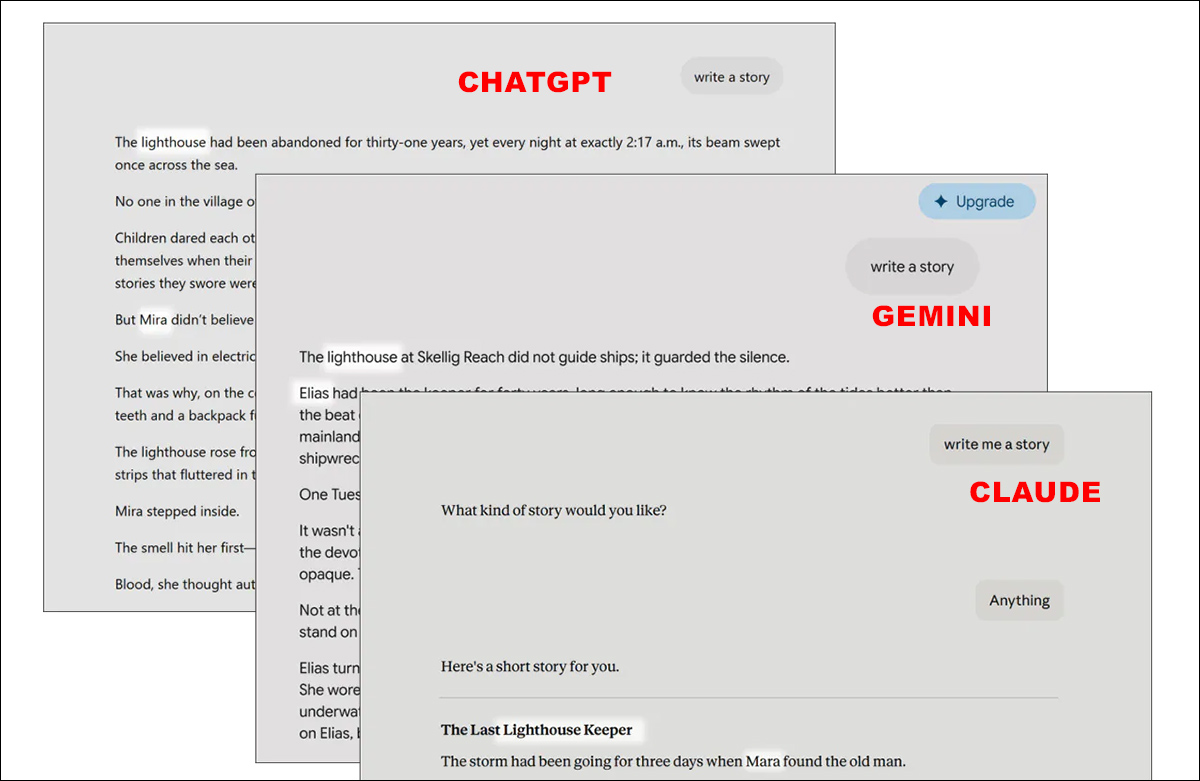
हालाँकि, अलग‑अलग घटनाओं ने कुछ समय से इस अभिसरण की ओर इशारा किया है, जिसमें कॉर्नेल विश्वविद्यालय के May 20026 अध्ययन में वर्णित अजीब मामला शामिल है, जहाँ विभिन्न LLM प्रदाताओं में ‘लाइटहाउस किपर’ के बारे में अजीब, टकराते जुनून और ‘Mara’ तथा ‘Elias’ जैसे कालातीत नाम दिखाए गए थे:

मई में कॉर्नेल विश्वविद्यालय के नए शोधपत्र में पाया गया कि खुले प्रॉम्प्ट दिए जाने पर अलग-अलग LLM प्रदाताओं के मॉडलों में असामान्य समानताएँ उभरती हैं। हालाँकि इन मॉडलों को प्रशिक्षित करने वाले विविध डेटा में अभी तक इसके कारण का कोई संकेत नहीं मिला है।
नया अध्ययन अधिक व्यवस्थित है: लेखकों ने तीन वर्षों के मॉडलों का परीक्षण वास्तविक दुनिया के रचनात्मक प्रॉम्प्ट और एक क्लासिक मनोविज्ञान परीक्षण के विरुद्ध किया, जो दैनिक वस्तुओं के असामान्य उपयोगों की मांग करता है। फिर उन्होंने मॉडल उत्तरों के अर्थ में दूरी को मापा, यह ट्रैक किया कि क्या ये दूरी क्रमिक पीढ़ियों में घट रही हैं।
नए कार्य के लेखकों, जिसका शीर्षक है क्या LLMs समान रूप से रचनात्मक हो रहे हैं? तीन वर्षों के मॉडलों से साक्ष्य, कहते हैं†:
‘हमारे निष्कर्ष, यद्यपि प्रारम्भिक हैं, LLMs को रचनात्मक साझेदार के रूप में दीर्घकालिक उपयोगिता के बारे में चिंताएँ उठाते हैं। भले ही मॉडल रचनात्मक कार्यों में अच्छा प्रदर्शन करें, अभिसारी आउटपुट LLM उपयोगकर्ताओं के सामने आने वाली संभावनाओं की सीमा को सीमित कर सकते हैं, और साथ ही उनकी अपनी सोच की व्यापकता को भी।’
‘यदि निबंध लेखन जैसे रचनात्मक कार्यों के लिए LLM का उपयोग मस्तिष्क गतिविधि को कम करता है, तो हमारे अध्ययन द्वारा सुझाए गए कम रचनात्मक LLMs के उपयोग से—क्या यह मानव रचनात्मकता पर LLMs के प्रभाव को और बिगाड़ सकता है, जैसा कि यह और अन्य अध्ययन में देखा गया है?’
पहले ही, LLM टेक्स्ट आउटपुट की विविध विशेषताएँ मीम्स के लिए सामग्री बन गई हैं; और, जैसा कि हमने इस साल मई में रिपोर्ट किया, कम से कम एक लेखक ने पहले ही एक पुस्तक स्वयं प्रकाशित की है जिसमें उल्लेखित ‘लाइटहाउस’ fixation प्रमुख मॉडलों में सामान्य रूप से दिखाया गया है।
इसलिए, ऐसे माहौल में जहाँ प्रकाशक धीर-धीरे पुस्तकें वापस ले रहे हैं जिन्हें वे AI‑लेखित होने का संदेह करते हैं या AI‑सहायता प्राप्त, नई शोध संकेत देती है कि हम ‘प्लॉट समानताएँ’ की वृद्धि की अपेक्षा कर सकते हैं जो स्पष्ट रूप से मानव‑लेखित कार्यों से उभरती हैं, जिसमें छात्रों द्वारा प्रस्तुत शैक्षणिक कार्य भी शामिल हैं।
जहाँ यह अभिसरण उत्पन्न हो रहा है, लेखक मानते हैं कि ओवरलैपिंग प्रशिक्षण डेटा और अधिक समान अनुकूलन उद्देश्यों के कारण मॉडल अवधारणाओं और अर्थ संबंधों की तुलनीय आंतरिक अभ्यावेदन की ओर धकेले जा रहे हैं – अंततः अधिक समान उत्तर उत्पन्न होते हैं†:
‘[यह] स्पष्ट नहीं है कि यह समानता अभी विकसित हो रही तकनीक का अस्थायी उपउत्पाद है या सांख्यिकीय भाषा मॉडलों की अनिवार्य – संभावित रूप से जटिल – विशेषता है।’
‘सम्भावित बल दोनों दिशाओं में संकेत देते हैं। बढ़ते शैक्षणिक कार्य यह दर्शाते हैं कि ओवरलैपिंग डेटा पर प्रशिक्षित और समान उद्देश्यों की ओर अनुकूलित जनरेटिव मॉडल अवधारणाओं और अर्थ संबंधों को में बढ़ती समान तरीकों से व्यवस्थित करेंगे, जिससे समान आउटपुट उत्पन्न होंगे।’
हालाँकि, लेखक कार्य का भी उल्लेख करते हैं जो दर्शाता है कि जैसे-जैसे मॉडल विकसित होते हैं, वे रचनात्मक आउटपुट के संदर्भ में फिर से अपनी अलग विशेषताओं के समूह में विभक्त हो सकते हैं।
विधि
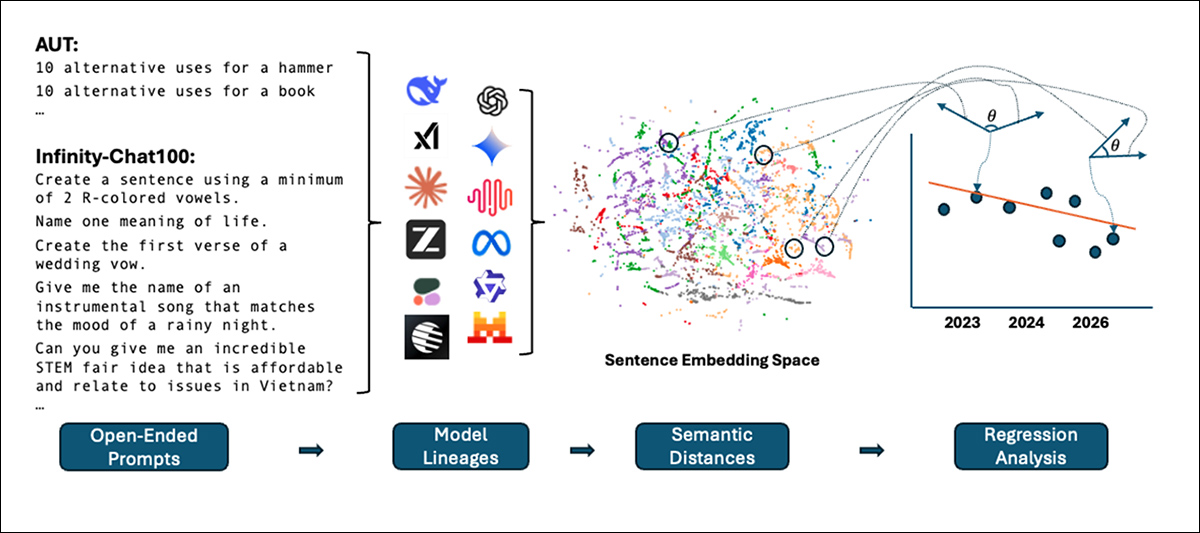
यह पता लगाने के लिए कि AI मॉडल अधिक समान हो रहे हैं या नहीं, शोधकर्ताओं ने खुले‑प्रश्नों से शुरुआत की, और विभिन्न पीढ़ियों के मॉडलों के उत्तरों को संकलित किया। प्रत्येक उत्तर को उसके अर्थ के संख्यात्मक प्रतिनिधित्व में परिवर्तित किया गया, जिससे उत्तरों की समानता या अंतर को मापना संभव हुआ।
Regression विश्लेषण का उपयोग यह स्थापित करने के लिए किया गया कि जैसे नए मॉडल जारी हुए, ये अंतर घट रहे हैं:

समय के साथ AI के आउटपुट अधिक समान हो रहे हैं या नहीं, यह मापने के लिए लेखकों की पद्धति। अलग-अलग मॉडल परिवारों को खुले रचनात्मक प्रॉम्प्ट दिए गए। उनके उत्तरों को अर्थ के आधार पर निरूपित करके आपसी दूरी मापी गई और रिग्रेशन विश्लेषण से देखा गया कि मॉडल की अगली पीढ़ियों में ये दूरियाँ कैसे बदलीं।
रचनात्मकता का विभिन्न पहलुओं से परीक्षण करने के लिए दो सेट प्रॉम्प्ट चुने गए। पहला, Alternate Uses Task (AUT), विचलनात्मक सोच का मानक मनोविज्ञान परीक्षण, सामान्य वस्तुओं के असामान्य उपयोगों की मांग करता है, अध्ययन में पुस्तक, जूता और हथौड़ा जैसी वस्तुओं का उपयोग किया गया। इसका स्थिर स्वरूप विभिन्न मॉडलों द्वारा उत्पन्न विचारों की तुलना के लिए एक नियंत्रित तरीका प्रदान करता है।
अतिरिक्त 100 प्रॉम्प्ट Infinity-Chat100 से निकाले गए, जो भाषा मॉडलों के साथ वास्तविक दुनिया की बातचीत से प्राप्त संग्रह है। ये कम प्रतिबंधित रचनात्मक कार्यों को कवर करते हैं, जिसमें सामग्री निर्माण, समस्या समाधान, विचार‑मंथन और विचार उत्पन्न करना शामिल है; ऐसे कार्य जो उत्पन्न उत्तरों और अपनाए गए दृष्टिकोणों में अधिक स्वतंत्रता की अनुमति देते हैं।
पूरा AUT और Infinity-Chat100 प्रॉम्प्ट सेट तब मार्च 2023 से जुलाई 2026 के बीच जारी मॉडलों को भेजा गया, जिसमें Anthropic, Google, Meta, OpenAI, DeepSeek और Mistral AI के 12 प्रदाताओं और सिस्टम शामिल थे। सभी प्रतिक्रियाएँ OpenRouter की API के माध्यम से समान सैंपलिंग सेटिंग्स के तहत एकत्र की गईं, जिसमें temperature (रचनात्मकता की स्वतंत्रता) और top-p दोनों को एक पर सेट किया गया।
मॉडलों को रिलीज़ माह के अनुसार व्यवस्थित किया गया ताकि यह जांचा जा सके कि नई पीढ़ियों के उत्तर अधिक समान हो रहे हैं या नहीं।
चूँकि रिलीज़ तिथियाँ प्रशिक्षण डेटा, आर्किटेक्चर या पोस्ट‑ट्रेनिंग में बदलाव को वास्तव में नहीं पकड़तीं, लेखकों ने इस प्रवृत्ति को मॉडल विकास के साथ एक संबंध के रूप में माना, न कि यह प्रमाण कि समय का बीतना स्वयं अभिसरण का कारण बनता है।
फिर मॉडलों के उत्तरों को all-MiniLM-L6-v2 sentence‑transformer का उपयोग करके एम्बेडिंग में परिवर्तित किया गया। प्रत्येक प्रतिक्रिया को एक संख्यात्मक वेक्टर के रूप में दर्शाया गया, जिससे समान अर्थ वाले उत्तरों को समान दिशा में रखा सके, और उनके अर्थात्मक दूरी को मापा जा सके।
AUT के लिए, प्रत्येक वस्तु के लिए सुझाए गए सभी उपयोगों को एक ही प्रतिक्रिया माना गया, जिससे प्रत्येक मॉडल के लिए दस एम्बेडिंग बनें। Infinity-Chat100 के लिए, प्रत्येक उत्तर को अलग‑अलग एम्बेड किया गया, जिससे प्रत्येक मॉडल के लिए 100 एम्बेडिंग बनें।
27 रिलीज़ महीनों को नौ समय‑अवधियों में समूहित किया गया, और केवल विभिन्न प्रदाताओं के मॉडल की तुलना की गई। प्रत्येक अवधि के भीतर उनके उत्तरों के बीच अर्थात्मक दूरी को मापा गया, जहाँ छोटी दूरी अधिक समानता दर्शाती है।
परिणामों में अधिक मॉडल वाले प्रदाताओं के प्रभुत्व को रोकने के लिए, विश्लेषण को 1,000 बार दोहराया गया, प्रत्येक प्रदाता से संतुलित नमूने लेकर।
परिणाम
फिर रैखिक प्रतिगमन का उपयोग इन दूरियों को समय के साथ ट्रैक करने के लिए किया गया, जहाँ निरंतर नकारात्मक ढाल यह संकेत देती है कि विभिन्न प्रदाताओं के मॉडल अधिक समान हो रहे थे:

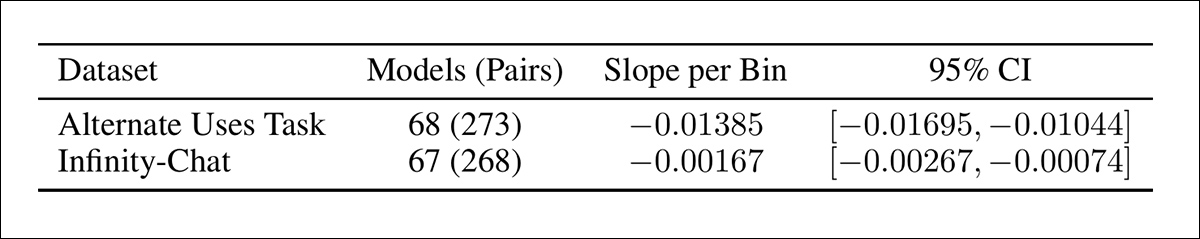
शुरुआती परीक्षण परिणाम दिखाते हैं कि अलग-अलग AI प्रदाताओं के रचनात्मक उत्तर समय के साथ अधिक समान हुए या नहीं। वैकल्पिक उपयोग कार्य और Infinity-Chat100, दोनों के प्रॉम्प्ट में अर्थगत दूरियाँ घटीं। बार-बार किए गए संतुलित नमूना परीक्षणों में लगातार ऋणात्मक रुझान मिले, जो मॉडल पीढ़ियों के बीच बढ़ती समानता दर्शाते हैं।
इन परिणामों में लेखक ने जोर दिया:
‘AUT और Infinity-Chat उत्तर सेट दोनों के लिए, हमने अवलोकन अवधि के दौरान प्रदाता‑अंतर आउटपुट दूरियों में गिरावट देखी।
‘यह समय के साथ LLM रचनात्मक आउटपुट की विविधता में कमी – या समानता में वृद्धि – का संकेत देता है।’
पुराने और नए मॉडलों के बीच अंतर Alternate Uses Task में सबसे स्पष्ट था। विभिन्न प्रदाताओं के उत्तरों के बीच औसत दूरी शुरुआती मॉडलों के लिए लगभग 0.50 से नई मॉडलों के लिए 0.40 से नीचे गिर गई, जिसका अर्थ है कि उनके उत्तर काफी हद तक अधिक समान हो गए। वही पैटर्न Infinity-Chat100 में भी मिला, हालांकि परिवर्तन छोटा था, औसत दूरी लगभग 0.34 से थोड़ा ऊपर 0.32 तक गिर गई।

परीक्षण परिणाम मापते हैं कि अलग-अलग AI प्रदाताओं के उत्तर समय के साथ कितनी तेजी से समान हुए। वैकल्पिक उपयोग कार्य में मॉडलों के बीच अंतर, Infinity-Chat की तुलना में कहीं अधिक तेजी से घटा। शोधकर्ताओं के बार-बार किए गए नमूना परीक्षणों में दोनों परिणाम स्थिर रहे।
यह निष्कर्ष सभी 1,000 संतुलित पुनःसैंपलिंग राउंड में भी बना रहा। प्रत्येक मामले में, नए मॉडल ने ऐसे उत्तर उत्पन्न किए जो पुराने मॉडलों की तुलना में अधिक निकट थे। इन गिरावटों का आकार, साथ ही शोधकर्ताओं के 95% विश्वसनीयता अंतराल, ऊपर दर्शाए गए हैं।
इस संबंध में, पेपर कहता है:
‘कार्य के उद्देश्य को देखते हुए AUT गिरावट की मात्रा विशेष रूप से उल्लेखनीय है। AUT स्पष्ट रूप से मॉडल को जितने मौलिक और अप्रत्याशित उपयोग संभव हों, उत्पन्न करने के निर्देश देकर विचलनात्मक सोच का परीक्षण करता है, जिससे यह ठीक वही स्थिति बनती है जहाँ आउटपुट में अंतर की अपेक्षा की जाती है।’
Infinity-Chat परिणाम दर्शाते हैं कि यही प्रवृत्ति बहुत व्यापक रचनात्मक कार्यों में भी दिखाई दी। इसके 100 प्रॉम्प्ट मॉडल को विभिन्न प्रकार के खुले‑प्रश्न उत्तर उत्पन्न करने के लिए कहते हैं, और इन उत्तरों की समानता समय के साथ बढ़ी।
परिवर्तन Alternate Uses Task की तुलना में छोटा था, लेकिन 2025 के बाद जारी मॉडलों में यह स्पष्ट हुआ। लेखक सुझाव देते हैं कि यह एक प्रारम्भिक संकेत हो सकता है कि विभिन्न AI प्रदाताओं के रचनात्मक आउटपुट सामान्य रूप से अधिक समान हो रहे हैं, न कि केवल किसी एक विशेष परीक्षण प्रकार में।
निष्कर्ष
LLM और VLM अभिसरण से जुड़ी समस्याएँ शोध समुदाय और उन डाउनस्ट्रीम मॉडलों के उपयोगकर्ताओं दोनों के लिए एक लगातार बढ़ता हुआ चिंता का स्रोत हैं। हम पहले और केवल ‘शुद्ध’ डेटा पीढ़ी के अंत की ओर पहुँच रहे हैं; और मॉडल प्रदाताओं की प्रतिद्वंद्वियों के डेटा को निकालने की दृढ़ता अनिवार्य रूप से अभिसरण का जोखिम बढ़ाती है, क्योंकि डेटा समान हो रहा है, और मॉडल प्रशिक्षण के सिद्धांत प्रदाताओं के बीच समान, यदि बिल्कुल समान नहीं भी हों, हैं।
इसलिए, मॉडल परिवारों में रचनात्मक आउटपुट की बढ़ती समानता से लड़ने के लिए em‑dashes को बदलने जैसी सरल उपाय संभव नहीं है, और प्रतिलिपि के मामलों के बजाय, वे अधिक सार्वजनिक और शर्मनाक तरीकों से उजागर होने की संभावना है।
* मॉडलों की पूरी सूची है: Claude-3-Haiku; Claude-Fable-5; Claude-Opus-4; Claude-Opus-4.1; Claude-Opus-4.5; Claude-Opus-4.6; Claude-Opus-4.7; Claude-Opus-4.8; Command-A; Command-R-08-2024; DeepSeek-Chat; DeepSeek-V3.1-Terminus; DeepSeek-V3.2; DeepSeek-V4-Pro; Gemini-2.5-Pro; Gemini-3-Flash-Preview; Gemini-3.1-Pro-Preview; Gemini-3.5-Flash; Llama-3.1-70B-Instruct; Llama-3.2-3B-Instruct; Llama-3.3-70B-Instruct; Llama-4-Maverick; MiniMax-01; MiniMax-M1; MiniMax-M2; MiniMax-M2.1; MiniMax-M2.5; MiniMax-M2.7; MiniMax-M3; Mistral-Large; Mistral-Large-2407; Mistral-Large-2512; Mistral-Medium-3; Mistral-Medium-3.5; Mistral-Medium-3.1; Mistral-Small-24B-Instruct-2501; Mistral-Small-2603; Mistral-Small-3.1-24B-Instruct; Mistral-Small-3.2-24B-Instruct; Mixtral-8x22B-Instruct; Kimi-K2; Kimi-K2-0905; Kimi-K2.5; Kimi-K2.6; GPT-3.5-Turbo; GPT-4; GPT-4.1; GPT-4o; GPT-5; GPT-5.1; GPT-5.2; GPT-5.3-Chat; GPT-5.4; GPT-5.5; GPT-5.6-Sol; Qwen-2.5-72B-Instruct; Qwen3-Max; Qwen3.5-Plus-20260420; Qwen3.6-Max-Preview; Qwen3.7-Max; Grok-4.20; Grok-4.3; Grok-4.5; GLM-4.5; GLM-4.6; GLM-4.7; GLM-5; GLM-5.1; और GLM-5.2
** ज़ोर लेखकों ने दिया है, मैंने नहीं।
† लेखकों के पाठ के भीतर दिए गए संदर्भों को मैंने हाइपरलिंक में बदला है।
पहली बार प्रकाशित: शुक्रवार, 21 अगस्त 2026
मूल लेख के स्रोत: unite.ai [1] · unite.ai [2] · unite.ai [3] · inc.com [4]