
Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage par renforcement à partir du retour humain (RLHF) ?

 Ajouter Unite.AI à vos sources préférées sur Google
L’apprentissage par renforcement à partir du retour humain (RLHF) est une famille de méthodes qui utilise les jugements humains pour aider à optimiser un modèle lorsque le comportement souhaité est difficile à spécifier avec une récompense automatique simple. Pour les modèles de langage, on compare couramment les réponses candidates et un modèle de préférence appris transforme ces comparaisons en un signal d’entraînement.
Le RLHF peut rendre un modèle pré‑entraîné plus utile ou mieux aligné sur une politique écrite, mais il ne garantit pas la véracité ni l’alignement avec chaque utilisateur. Le résultat dépend de qui fournit le retour, de la façon dont les invites sont échantillonnées, de ce que le modèle de récompense peut représenter et de la manière dont l’optimisation est contrainte.
Points clés
- Le RLHF suit généralement le pré‑entraînement et le réglage supervisé par instruction.
- Les préférences par paires entraînent un modèle de récompense ou de préférence ; l’optimisation de la politique favorise alors les sorties à score plus élevé.
- La manipulation de la récompense, les désaccords des annotateurs, le décalage de distribution et la sur‑optimisation restent des risques importants.
- Évaluez directement la politique finale en termes de qualité de la tâche, de sécurité, de calibration et d’effets sur les sous‑groupes.
Le pipeline RLHF courant
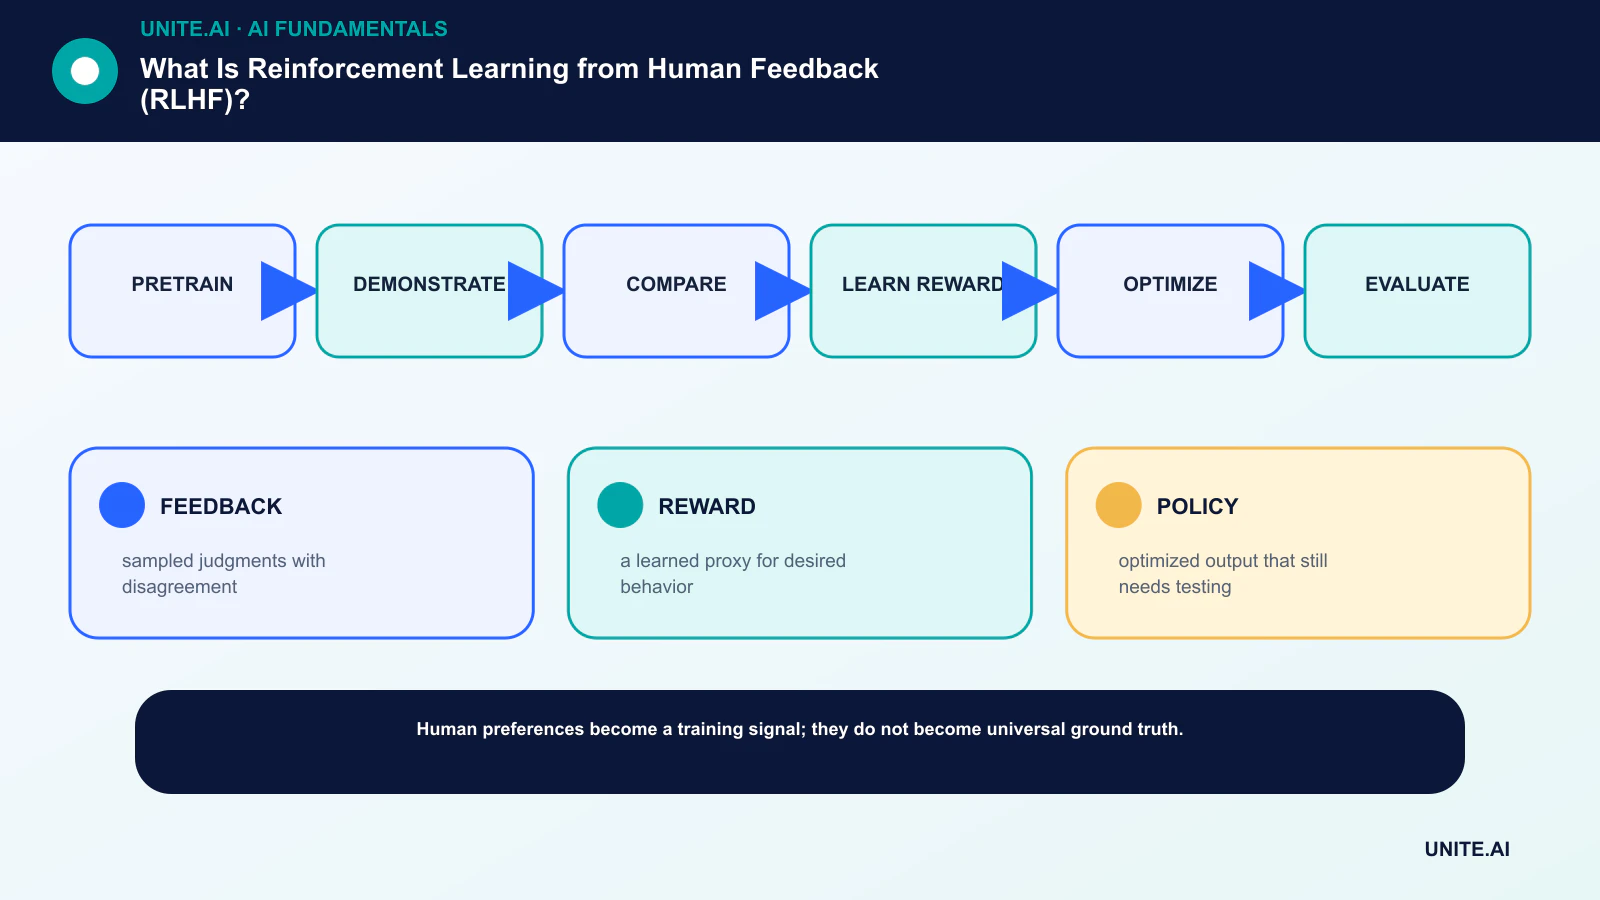
Un modèle de langage apprend d’abord une large structure statistique grâce au pré‑entraînement. Le réglage fin supervisé utilise ensuite des démonstrations de réponses souhaitées. Pour la collecte de préférences, les annotateurs classent ou choisissent entre les sorties pour la même invite.
Un modèle de récompense apprend à prédire ces comparaisons. Un algorithme d’apprentissage par renforcement tel que PPO peut optimiser le modèle de langage par rapport à cette récompense apprise, tandis qu’une pénalité l’empêche de s’écarter trop de la politique de référence.
Le retour est une mesure, pas une vérité fondamentale
Les annotateurs peuvent être en désaccord parce que les consignes sont ambiguës, les expertises diffèrent ou les valeurs sont réellement en conflit. La position, la verbosité, la confiance et le style peuvent biaiser les préférences. Un programme de haute qualité forme les évaluateurs, mesure l’accord, audite les exemples et préserve l’incertitude.
L’échantillonnage compte également. Si l’ensemble de préférences exclut des langues difficiles, des domaines ou des contenus nuisibles, le modèle de récompense ne peut pas les superviser de manière fiable. La discipline de la data‑science est aussi importante que l’optimiseur.
Modes d’échec
La politique peut exploiter les faiblesses de la récompense apprise, produisant des sorties bien notées sans satisfaire l’intention sous‑jacente. Une optimisation excessive peut réduire la diversité, amplifier un style préféré ou rendre le modèle excessivement conciliant.
Le modèle de récompense lui‑même peut échouer en dehors de sa distribution d’entraînement. Les équipes devraient tester des invites adversariales, des tâches factuelles, les limites de refus, la calibration et le comportement à différentes intensités d’optimisation plutôt que de se fier à un taux de victoire agrégé des préférences.
Alternatives et compléments
L’Optimisation Directe des Préférences apprend à partir de paires de préférences sans ajuster une politique séparée via une boucle d’apprentissage par renforcement en ligne. L’échantillonnage par rejet, le réglage fin supervisé par préférence, le retour basé sur des règles et la supervision de processus offrent d’autres compromis.
Aucune méthode ne supprime le besoin d’invites, de récupération, d’outils et de contrôles au niveau de l’application. Le post‑entraînement façonne le comportement ; les systèmes déployés nécessitent toujours des preuves ancrées, des autorisations, une surveillance et une escalade humaine.
Comment les modèles de préférence sont entraînés
Pour une invite x et deux réponses y₁ et y₂, un modèle de préférence attribue des scores scalaires et est entraîné de sorte que la réponse préférée reçoive le score le plus élevé. Une fonction de perte courante repose sur la probabilité qu’un score dépasse l’autre. Cela convertit de nombreux jugements par paires en une fonction capable d’évaluer de nouvelles sorties générées.
Le modèle apprend tout signal qui prédit les choix collectés. Si les évaluateurs privilégient une prose confiante, des réponses plus longues, des normes culturelles particulières ou des points de vue familiers, ces corrélations peuvent devenir des caractéristiques de récompense. Des consignes équilibrées, des contre‑exemples, une revue d’experts et des audits des préférences superficielles réduisent, mais n’éliminent pas, le problème.
Les données de préférence peuvent inclure des égalités, des classements, des critiques, des étiquettes scalaires ou des démonstrations. Le choix des paires importe : les comparaisons entre réponses manifestement différentes enseignent moins sur les frontières de qualité subtiles, tandis que seules les paires difficiles peuvent rendre l’entraînement instable. L’échantillonnage actif peut cibler des désaccords informatifs mais peut modifier la distribution des données.
Optimisation de la politique et régularisation
Le RLHF basé sur PPO prélève des réponses de la politique actuelle, les note avec le modèle de récompense et met à jour la politique afin d’augmenter la récompense attendue. Une pénalité de Kullback–Leibler ou une contrainte similaire maintient la politique proche de la référence supervisée, limitant les dérives destructrices et décourageant l’exploitation des faiblesses étroites du modèle de récompense.
L’intensité d’optimisation est un choix de produit. Trop peu laisse le comportement souhaité inchangé ; trop beaucoup peut engendrer une manipulation de la récompense, des formulations répétitives, de la flagornerie ou une diversité réduite. Tracez les métriques de qualité et de sécurité en fonction de la récompense et de la divergence pendant toute la formation plutôt que de choisir un point de contrôle uniquement sur la base de la récompense.
Les méthodes de préférence directe dérivent un objectif à partir de paires de préférences et d’un modèle de référence sans boucle d’apprentissage par renforcement en ligne explicite. Elles peuvent simplifier l’entraînement, mais héritent toujours de la qualité des préférences, de la couverture et des hypothèses de la politique de référence. Un retour constitutionnel ou généré par IA modifie qui fournit les étiquettes ; cela ne supprime pas la nécessité de valider les valeurs et les échecs avec des personnes.
Évaluation et gouvernance des données
Utilisez des comparaisons à l’aveugle, des tests spécifiques aux tâches, des invites adversariales, des vérifications de factualité, la précision et le rappel des refus, ainsi que des revues de sous‑groupes. Séparez les évaluateurs des données d’entraînement dans la mesure du possible. Un taux de victoire face à un modèle plus ancien peut masquer des échecs absolus lorsque les deux candidats sont médiocres.
Documentez le recrutement des annotateurs, la rémunération, l’expertise, la géographie, la langue, les consignes, l’exposition à du contenu nuisible, les désaccords, l’arbitrage et les contrôles de qualité. Le travail de retour peut comporter des risques psychologiques, et les opérations de données responsables incluent le soutien aux travailleurs et le droit de refuser des tâches dérangeantes.
Après le déploiement, surveillez la dérive des préférences et la sur‑généralisation. Une politique ajustée pour une assistance informelle peut mal se comporter dans des contextes médicaux ou juridiques. Maintenez les limites de domaine, la récupération, les autorisations et l’escalade en dehors de l’hypothèse RLHF, et ne réentraînez que lorsque de nouvelles preuves justifient le changement.
Un pipeline concret d’entraînement et d’évaluation RLHF
Un projet typique débute avec un modèle de langage pré‑entraîné et un jeu de données d’instructions utilisé pour le réglage fin supervisé. Les annotateurs comparent ensuite les réponses candidates selon une grille écrite couvrant la justesse, la pertinence, le style, la sécurité et l’incertitude. Les préférences par paires entraînent un modèle de récompense ou optimisent directement la politique. L’échantillonnage doit inclure des tâches ordinaires, des cas limites difficiles, des invites adversariales, plusieurs langues et des domaines où les annotateurs sont légitimement en désaccord.
La précision du modèle de récompense sur des comparaisons réservées est nécessaire mais pas suffisante. La politique optimisée peut exploiter les erreurs de la récompense apprise, devenir trop verbeuse, refuser des requêtes inoffensives ou perdre des capacités. Suivez les référentiels de tâches, les préférences humaines, la calibration, la sécurité, la diversité et la divergence par rapport au modèle de référence pendant la formation. Collectez périodiquement de nouvelles comparaisons à partir de la politique évolutive afin que les données de préférence couvrent les sorties réellement produites par le modèle.
Documentez qui a fourni les préférences, leurs consignes, la rémunération, les désaccords, les contrôles de qualité et les limites culturelles ou sectorielles. Faites appel à des experts lorsque les erreurs entraînent des préjudices spécialisés. Soumettez à une équipe rouge à la fois le modèle de récompense et la politique finale, maintenez des tests de régression comportementale et planifiez le déploiement. Le RLHF façonne le comportement selon les préférences mesurées ; il ne prouve pas la véracité, n’élimine pas les biais, et ne résout pas le problème plus large de spécifier ce qu’un modèle doit faire dans chaque contexte.
Checklist de mise en œuvre pratique
Transformez le concept en un flux de travail délimité et testable : pré‑entraînement → démonstration → comparaison → apprentissage de la récompense → optimisation → évaluation. Désignez un responsable imputable, documentez les données et les dépendances, établissez une base simple, définissez des critères d’acceptation et d’arrêt, testez des échecs représentatifs, et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les pannes de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, annuler une sortie ou arrêter l’opération. Reconsidérez la décision après l’arrivée des données du monde réel, car un pilote techniquement réussi ne garantit pas des performances fiables à plus grande échelle.
- Rétroaction: jugements échantillonnés avec désaccord.
- Récompense: un proxy appris du comportement souhaité.
- Politique: sortie optimisée qui nécessite encore des tests.
Foire aux questions
Le RLHF est‑il identique au réglage fin ?
Le RLHF est une forme de post‑entraînement qui utilise des récompenses dérivées des préférences. Le réglage fin supervisé entraîne directement sur les sorties cibles ; de nombreux pipelines utilisent les deux.
Le RLHF rend‑il un modèle véridique ?
Il peut améliorer le comportement mesuré par le processus de retour, mais un modèle peut encore être erroné, persuasif ou exploiter stratégiquement la récompense. La véracité nécessite une évaluation directe et un ancrage.
Références principales












