
Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage fédéré ?

 Ajouter Unite.AI à vos sources préférées sur Google
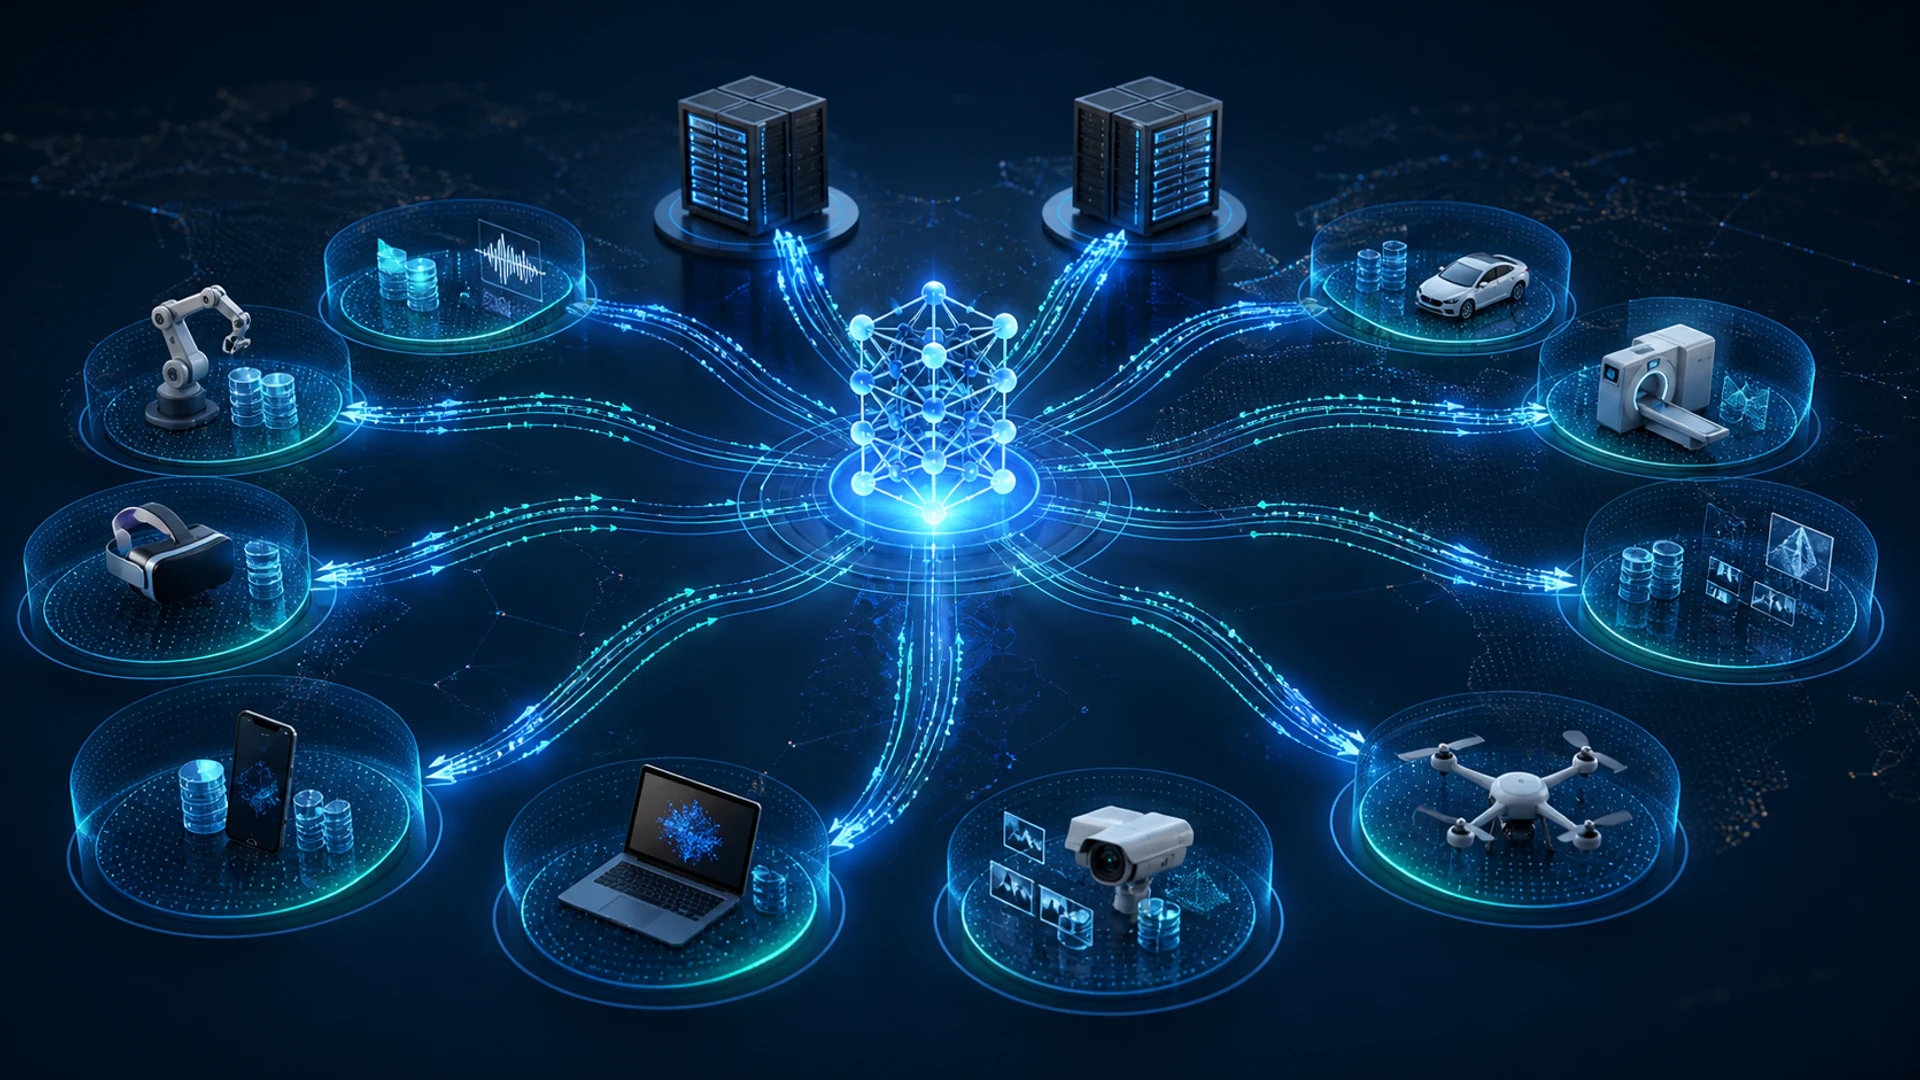
L’apprentissage fédéré entraîne un modèle partagé sur plusieurs appareils ou organisations tout en conservant les données d’entraînement brutes de chaque participant localement. Un coordinateur distribue les paramètres du modèle, les clients calculent les mises à jour sur leurs propres enregistrements, et une étape d’agrégation combine ces mises à jour.
Conserver les enregistrements localement est utile, mais cela n’est pas synonyme de confidentialité ou de sécurité. Les mises à jour du modèle peuvent divulguer des informations, des clients compromis peuvent empoisonner l’entraînement, et le coordinateur a toujours besoin d’authentification, de sécurité du transport, de contrôles d’accès et d’un modèle de confiance défini.
Points clés
- L’apprentissage fédéré déplace le calcul vers les données distribuées ; il ne déplace pas le jeu de données brut vers un formateur central.
- Les systèmes cross‑device impliquent de nombreux appareils intermittents, tandis que les systèmes cross‑silo concernent moins d’organisations plus stables.
- L’agrégation sécurisée et la confidentialité différentielle traitent des risques différents et peuvent être combinées.
- Les données non IID, la bande passante limitée, la participation peu fiable et les mises à jour malveillantes sont des contraintes de conception essentielles.
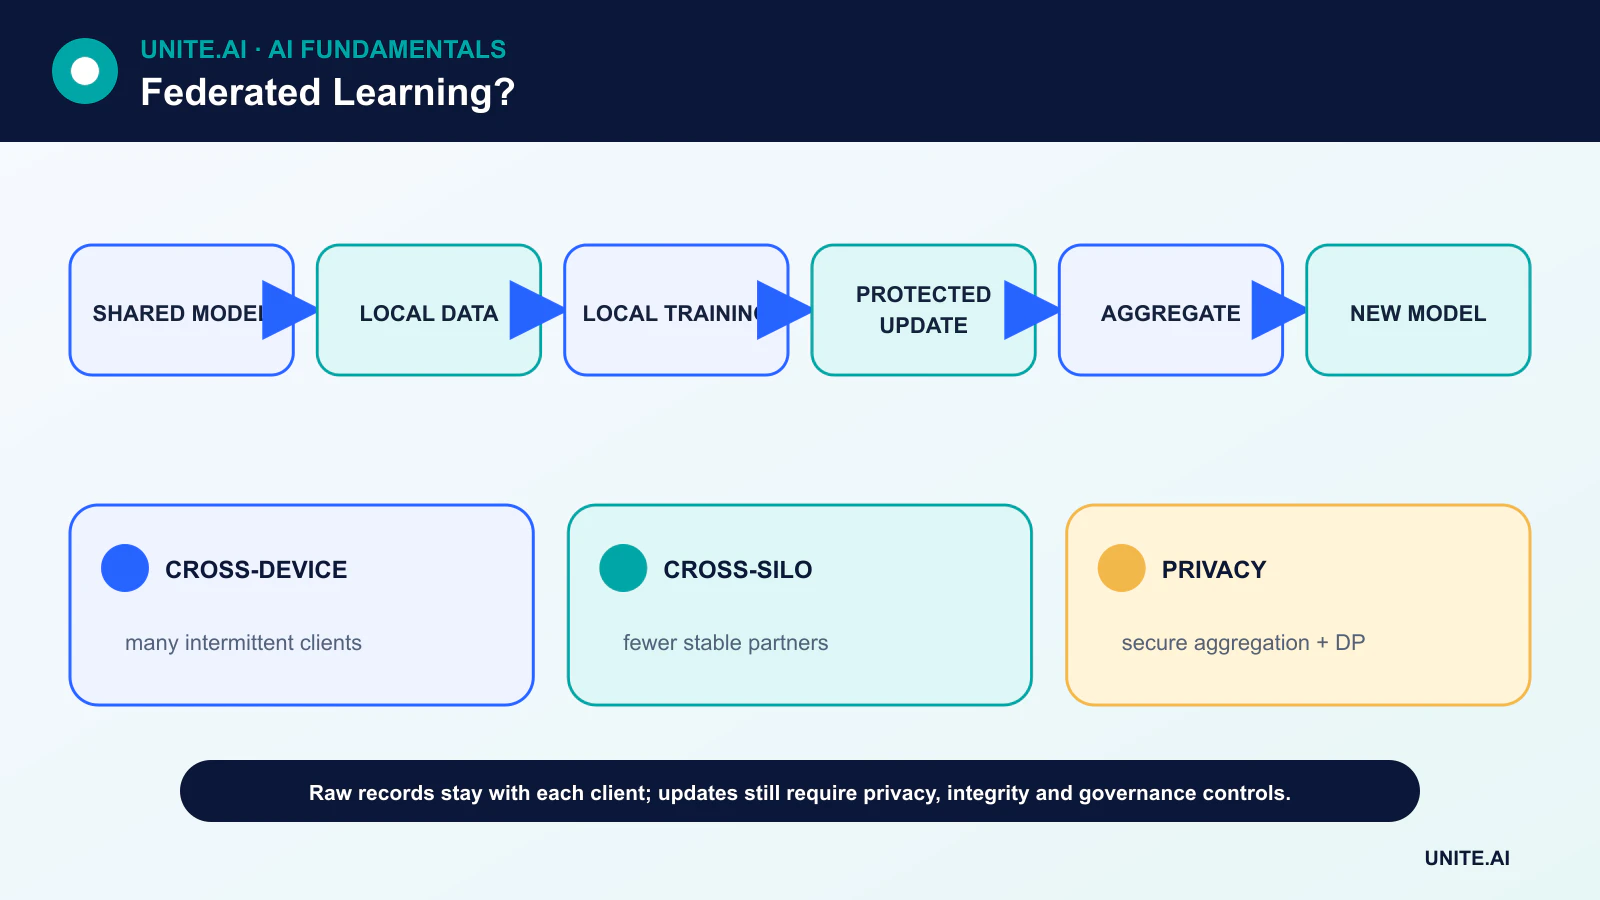
Le cycle de vie de la moyenne fédérée
Un round typique débute lorsqu’un coordinateur sélectionne des clients éligibles et envoie le modèle actuel. Chaque client s’entraîne localement pendant un nombre limité d’étapes, produisant une mise à jour de paramètres ou de gradients. Le coordinateur agrège les mises à jour éligibles — souvent en les pondérant selon le nombre d’exemples locaux — et publie le nouveau modèle partagé.
Seule une fraction des clients peut participer à chaque round. Le protocole doit tolérer les connexions perdues, les incompatibilités de version et les appareils qui ne peuvent pas s’entraîner pendant la charge, l’occupation ou lorsqu’ils sont hors ligne. La communication peut dominer le calcul, de sorte que la compression des mises à jour et la réduction du nombre de tours de communication comptent souvent plus que la vitesse brute des accélérateurs.
Cross‑device versus cross‑silo
L’apprentissage fédéré cross‑device peut impliquer des téléphones, des capteurs ou des navigateurs appartenant à de nombreux individus. Les clients sont nombreux, peu fiables et disponibles de façon intermittente. L’apprentissage fédéré cross‑silo connecte généralement un petit ensemble d’hôpitaux, de banques ou d’unités commerciales disposant d’une infrastructure stable et d’une gouvernance contractuelle.
Les deux contextes exigent des hypothèses différentes en matière d’identité, d’audit et de défaillance. Un projet cross‑silo peut négocier un schéma partagé et un processus de validation ; un service cross‑device doit gérer des millions de versions logicielles et des ensembles de données locaux très hétérogènes.
Agrégation sécurisée, confidentialité différentielle et chiffrement
L’agrégation sécurisée est un protocole cryptographique qui permet au serveur de récupérer un agrégat sans lire chaque mise à jour client. La confidentialité différentielle limite la dépendance du résultat publié à un enregistrement ou participant donné en tronquant les contributions et en ajoutant du bruit calibré.
Aucun des deux mécanismes ne résout tous les risques. L’agrégation sécurisée ne rend pas l’agrégat inoffensif, et la confidentialité différentielle impose un compromis précision‑confidentialité qui doit être géré avec un budget de confidentialité explicite. Le chiffrement protège les données en transit ou au repos ; il ne prévient pas, à lui seul, les inférences à partir d’un modèle.
Données non IID et qualité du modèle
Les données des clients sont rarement indépendantes et identiquement distribuées. Un modèle de clavier voit le vocabulaire de chaque personne ; les hôpitaux desservent des populations différentes ; les usines utilisent des équipements variés. Ces différences peuvent ralentir la convergence et masquer une mauvaise performance pour de petits groupes de clients.
L’évaluation doit inclure des métriques globales, des distributions par client ou par cohorte, la calibration et l’analyse des échecs. Un jeu de test central peut être pratique mais insuffisant. Cela relie l’apprentissage fédéré à la qualité des données en apprentissage automatique et à la gouvernance des données structurées et non structurées.
Menaces et contrôles opérationnels
Des clients malveillants peuvent soumettre des mises à jour empoisonnées, des clients sybil peuvent fausser l’agrégation, et un serveur compromis peut diffuser un modèle ciblé. Les défenses comprennent l’inscription authentifiée, la détection d’anomalies, l’agrégation robuste, la validation des mises à jour, les limites de taux et l’attestation logicielle reproductible lorsque cela est possible.
L’apprentissage fédéré s’insère dans un programme plus large de cybersécurité. Les équipes doivent documenter qui contrôle le coordinateur, quelles métadonnées sont collectées, comment les participants peuvent se désengager, comment les modèles sont restaurés et ce qui se passe lorsque les tests de confidentialité ou de qualité échouent.
Optimisation fédérée et hétérogénéité des données
L’apprentissage fédéré envoie un modèle ou une tâche de mise à jour aux clients participants, s’entraîne localement, puis agrège les mises à jour sans centraliser les exemples bruts. Dans la moyenne fédérée, les clients sélectionnés exécutent plusieurs étapes d’optimisation locale et le serveur calcule une moyenne pondérée, généralement par nombre d’exemples. Les tours de communication, les époques locales, la sélection et les taux d’apprentissage échangent bande passante contre convergence. Les contextes cross‑device impliquent de nombreux téléphones ou capteurs peu fiables ; les contextes cross‑silo impliquent moins d’organisations mais avec une puissance de calcul, une identité et une gouvernance plus fortes.
Les données client sont généralement non indépendantes et inégales : les utilisateurs diffèrent par leur comportement, la distribution des étiquettes, le volume et la disponibilité. L’entraînement local peut dériver dans des directions incompatibles, rendant une simple moyenne instable ou biaisée en faveur des clients actifs à fort volume. Les algorithmes peuvent recourir à des termes proximaux, à une optimisation serveur adaptative, à du clustering, à la personnalisation ou à des variables de contrôle. L’évaluation doit rendre compte des performances globales et au niveau du client, des clients de queue, de la fréquence de participation, de la convergence, de la communication et de l’énergie. Une bonne moyenne peut masquer le fait que de petites ou rares populations de clients reçoivent un modèle moins performant.
Confidentialité, sécurité et ingénierie des systèmes
Conserver les données localement ne garantit pas à lui seul la confidentialité. Les gradients et les mises à jour peuvent divulguer l’appartenance ou des caractéristiques, tandis que le modèle final peut mémoriser des exemples. L’agrégation sécurisée masque les mises à jour individuelles du serveur, et la confidentialité différentielle limite la contribution d’information en tronquant et en ajoutant du bruit, mais les deux réduisent l’utilité et augmentent la complexité opérationnelle. Définissez le modèle de menace, l’unité de confidentialité, le budget et les composants de confiance. Le chiffrement en transit est nécessaire mais ne prévient pas un client malveillant, une mise à jour empoisonnée, un coordinateur compromis ou une attaque d’inférence.
Les défenses comprennent des clients authentifiés, une agrégation robuste, des contrôles d’anomalies, des limites de mise à jour, des enclaves sécurisées dans certaines conceptions, et la validation contre des données propres. Les attaquants sybil peuvent créer de nombreux clients ; les portes dérobées peuvent survivre à la moyenne ; le rejet de mises à jour suspectes peut aussi exclure des comportements rares légitimes. Versionnez le code client, supportez les tours interrompus, prévenez la relecture, et concevez pour les retardataires et les contraintes des appareils. Le consentement, la conservation, les règles régionales et la suppression s’appliquent toujours aux données locales et aux mises à jour dérivées.
Exemple de déploiement et de gouvernance
Un clavier mobile peut entraîner des améliorations de prédiction de mots localement, mais le déploiement doit s’appuyer sur une population éligible selon les capacités de l’appareil et le consentement, collecter des mises à jour protégées tronquées, et les comparer à une référence figée. Validez les performances linguistiques et dialectales, la batterie, l’usage des données et le risque de mémorisation avant la mise à disposition. Les clients ont besoin de tâches d’entraînement signées et de mises à jour de modèle ; le serveur a besoin d’une configuration de round auditable et d’une capacité de rollback. L’apprentissage fédéré est une architecture d’apprentissage distribué sous contraintes, pas un substitut aux données représentatives, à l’ingénierie de la confidentialité ou à la responsabilité.
Exemple concret : apprentissage fédéré entre hôpitaux
Les hôpitaux entraînent un modèle partagé de qualité d’image sans regrouper les scanners. Un protocole commun définit les métadonnées des appareils, les étiquettes, le pré‑traitement, l’éligibilité des clients, les époques locales, le tronquage et l’agrégation sécurisée. Les sites conservent les données patients et soumettent des mises à jour protégées, tandis qu’un coordinateur évalue chaque round sur des ensembles de validation locaux. Les résultats rapportent les performances par site et les queues, pas seulement une moyenne pondérée par volume, car les petits hôpitaux et types d’appareils pourraient sinon être négligés.
Le modèle de menace couvre les mises à jour malveillantes, les fuites d’appartenance, les clients compromis et l’accès du coordinateur. La confidentialité différentielle est configurée avec un budget documenté et une utilité testée. Les paquets de modèle et de tâche sont signés ; les sites peuvent se retirer et les mises à jour sont auditées. Un round empoisonné ou instable ne remplace pas automatiquement le modèle déployé. Le projet conserve des références locales et une revue clinique, et il considère l’architecture fédérée comme un contrôle de confidentialité parmi d’autres obligations de consentement, de sécurité et de gouvernance.
Preuves de mise en œuvre et état de préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les dérives de distribution, les pannes de dépendances, les usages abusifs et les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche avec calibration ou incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attractif.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, le rollback et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage après incident, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
L’apprentissage fédéré garantit‑il que les données privées ne peuvent pas fuir ?
Non. Il réduit le déplacement des données brutes, mais les mises à jour et les modèles finaux peuvent encore révéler des informations. La confidentialité nécessite un modèle de menace ainsi que des contrôles techniques et organisationnels supplémentaires.
Quand l’entraînement centralisé est‑il plus simple ?
Lorsque les données peuvent être centralisées légalement et en toute sécurité, l’entraînement centralisé est souvent plus facile à déboguer, reproduire et surveiller. L’apprentissage fédéré n’est justifié que lorsque la distribution constitue une exigence réelle, et non simplement un objectif marketing.
Références principales












