
Fondamentaux de l’IA
Qu’est‑ce que le TinyML ? Apprentissage automatique sur microcontrôleurs

 Ajouter Unite.AI à vos sources préférées sur Google
Le TinyML apporte l’inférence d’apprentissage automatique aux appareils très contraints tels que les microcontrôleurs, les petits processeurs de signal numérique et les capteurs à faible consommation. Ces systèmes peuvent disposer de quelques kilo‑octets ou mégaoctets de mémoire, de budgets énergétiques stricts, d’une absence de connexion réseau continue et de délais en temps réel.
La valeur ne réside pas simplement dans un modèle plus petit. Le traitement près du capteur peut réduire la latence, la bande passante et l’exposition des données brutes tout en permettant des produits qui fonctionnent pendant de longues périodes sur batterie ou énergie récupérée.
Points clés
- Le TinyML est défini par l’ensemble du budget matériel et logiciel, et non par un seuil de taille de modèle unique.
- La quantification, les architectures compactes, les noyaux optimisés et une mise en mémoire tampon soigneuse rendent le déploiement possible.
- L’inférence sur l’appareil peut améliorer la confidentialité, mais les mises à jour sécurisées et la gouvernance des données restent importantes.
- Évaluez la précision en même temps que la latence, la mémoire maximale, l’énergie, le cycle de travail et la robustesse.
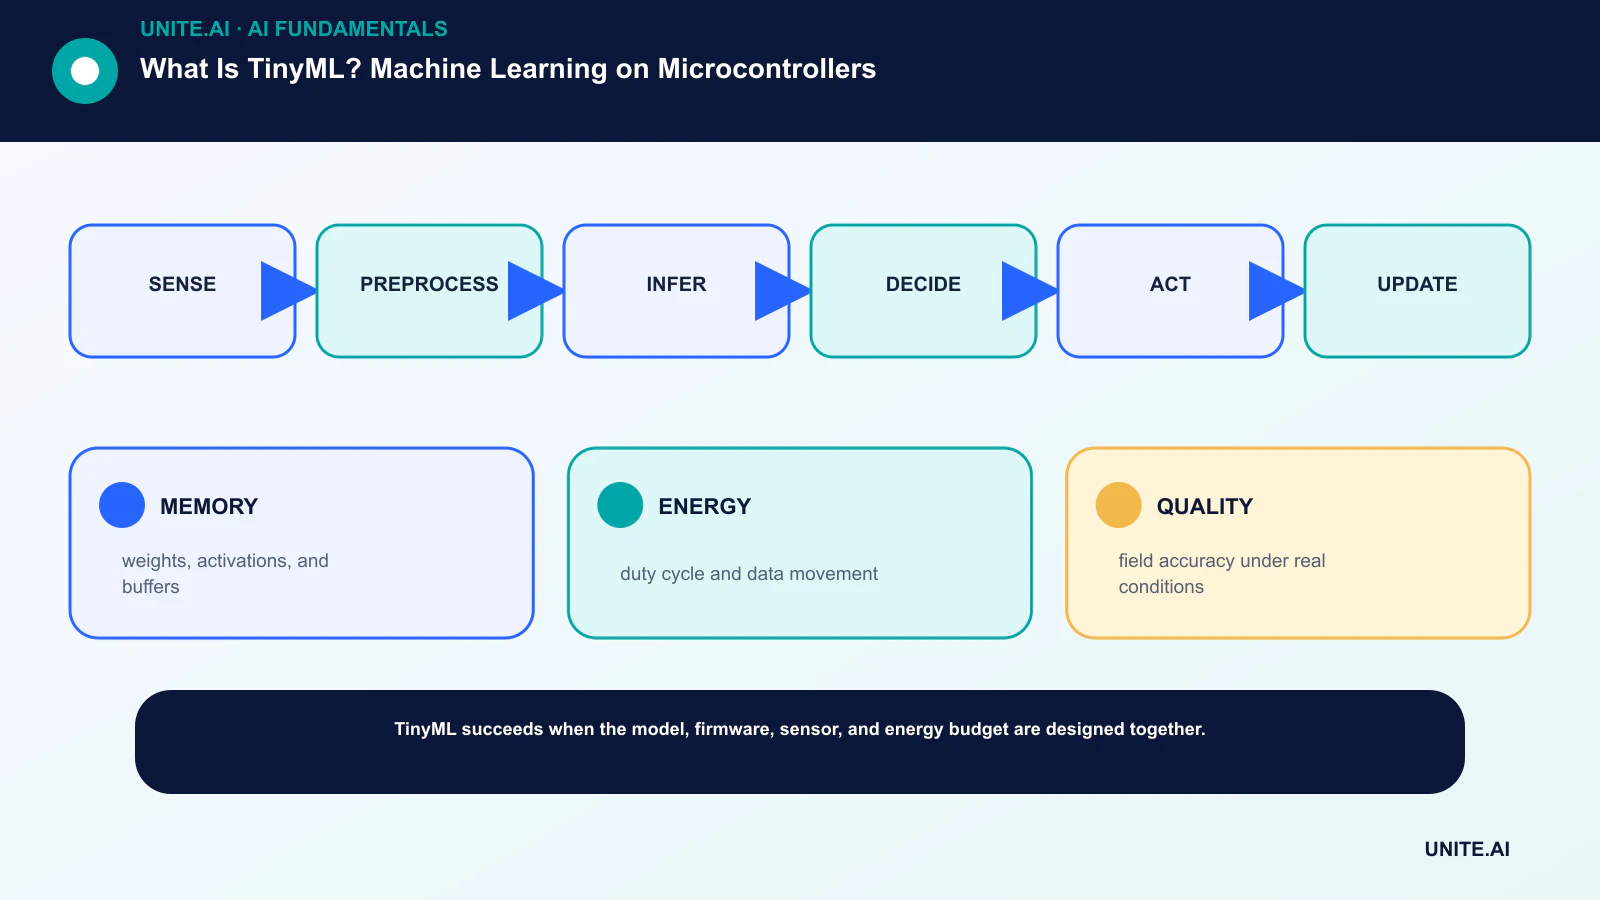
La pile TinyML
Un capteur capture de l’audio, du mouvement, des vibrations, des images ou tout autre signal. Le firmware le prétraite en caractéristiques ou tenseurs ; un modèle compact s’exécute via un runtime embarqué ; la logique applicative décide s’il faut réveiller un système plus grand ou agir localement.
Il s’agit d’une forme contrainte d’edge AI. Le matériel peut inclure un MCU, de la mémoire, des interfaces de capteur et parfois un accélérateur neuronal. Chaque tampon, opérateur et copie rivalisent pour des ressources limitées.
Faire tenir le modèle
La quantification remplace les valeurs haute précision par des représentations entières plus petites. L’élagage, la distillation, l’ingénierie des caractéristiques et la recherche d’architecture peuvent réduire le calcul ou le stockage. Le support des opérateurs dans le runtime cible contraint les modèles pratiques.
L’entraînement se fait souvent sur du matériel plus puissant, puis le modèle est converti et compilé pour l’appareil. L’apprentissage par transfert peut réduire les besoins en données, mais l’artéfact final doit être évalué après conversion car les changements numériques peuvent modifier la précision.
Données et changement d’environnement
Les enregistrements en laboratoire représentent rarement chaque microphone, position de montage, température, motif de vibration, accent ou condition de fond. Collectez des données provenant d’appareils et d’environnements représentatifs, maintenez les sources d’entraînement et de test indépendantes, et incluez des cas « aucun des précédents ».
Un déclencheur faux peut gaspiller de l’énergie ou agacer l’utilisateur ; une anomalie manquée peut être coûteuse. Sélectionnez les seuils en fonction des coûts réels d’erreur, et surveillez les performances sur le terrain via des résumés préservant la confidentialité ou des diagnostics échantillonnés, le cas échéant.
Mesurer l’ensemble de l’appareil
Le nombre d’opérations du modèle n’équivaut pas à la performance du produit. Rapportez la fréquence de réveil, le temps de prétraitement, la latence d’inférence, le pic de RAM, l’utilisation de la mémoire flash, la puissance moyenne et maximale, le comportement thermique et l’impact sur la batterie sous un cycle de travail explicite.
Préparez des mises à jour signées du firmware et du modèle, le rollback, l’identité de l’appareil et la réponse aux vulnérabilités. Les petits appareils peuvent rester déployés pendant des années, la maintenabilité fait donc partie de la qualité du modèle. Les contrôles de cybersécurité ne peuvent pas être reportés parce que l’appareil est petit.
Budgétisation de la mémoire et du calcul
La mémoire flash stocke le firmware, les poids du modèle et les constantes ; la RAM contient les tampons du capteur, les activations intermédiaires et l’état du runtime. La mémoire d’activation maximale peut dépasser la taille des poids, notamment dans les premières couches convolutionnelles. Les planificateurs de mémoire réutilisent les tampons dont les durées de vie ne se chevauchent pas, tandis que le flux continu de caractéristiques évite de stocker une fenêtre de signal complète.
Le nombre d’opérations est une estimation initiale, mais l’efficacité du noyau dépend de la forme du tenseur, de l’alignement, du support d’instructions et de l’accès à la mémoire. Une convolution depthwise peut réduire les calculs mais fonctionner mal sur du matériel sans noyau optimisé. Évaluez le modèle compilé sur la carte cible, pas seulement avec un profileur de bureau.
Le cycle de travail domine de nombreux produits. Le capteur et le MCU peuvent être en veille, se réveiller pour un déclencheur peu coûteux, exécuter un petit modèle, et n’activer un radio ou un processeur plus grand que lorsque cela est nécessaire. Mesurez l’ensemble du cycle de travail, incluant le capteur, la conversion, le prétraitement, le réveil, l’inférence, la communication et les fuites en veille.
Développement et conversion du modèle
Commencez par les contraintes de déploiement et collectez des données de capteur représentatives. Le prétraitement utilisé lors de l’entraînement doit correspondre exactement à l’implémentation en point fixe ou embarquée. Des différences de fréquence d’échantillonnage, de fenêtrage, de conversion de couleur, de normalisation ou d’extraction de caractéristiques peuvent faire échouer un modèle même si la conversion réussit.
La quantification post‑entraînement calibre les plages à partir d’échantillons représentatifs ; l’entraînement conscient de la quantification simule une précision moindre pendant l’apprentissage. Les échelles de poids par canal conservent souvent mieux la qualité convolutionnelle qu’une seule échelle. Les opérations non prises en charge peuvent être réécrites, approximées ou déplacées vers un repli plus lent, chacune nécessitant une nouvelle évaluation.
La compression doit être guidée par des hypothèses. L’élagage de poids non structurés ne peut pas accélérer un noyau dense embarqué ; la suppression structurée de canaux est plus facile à exploiter pour le matériel. La distillation transfère le comportement d’un enseignant plus grand mais peut également transférer ses biais et erreurs. Comparez avec les traitements de signal et les seuils de référence.
Applications, essais sur le terrain et maintenance
Les tâches TinyML courantes comprennent la détection de mots‑clés, la détection de mot d’éveil, la reconnaissance de gestes, la détection d’anomalies de vibration, l’occupation, les événements acoustiques et la vision simple. Le modèle peut servir de filtre plutôt que de décision finale, économisant la bande passante tout en transmettant les cas incertains ou importants à un système plus performant.
Les tests sur le terrain doivent couvrir les tolérances de l’appareil, le vieillissement du capteur, le montage, l’état de la batterie, la température, les conditions météorologiques, les utilisateurs et les interférences de fond. Suivez les déclencheurs faux par heure ou les événements manqués par cycle d’utilisation, pas seulement la précision équilibrée du test. Un seuil choisi en laboratoire peut nécessiter une calibration propre au produit.
Préparez des mises à jour OTA signées, le rollback, la télémétrie des versions de modèle et de longues périodes de support. Si les mises à jour sont impossibles, utilisez des modèles conservateurs et documentez la dérive environnementale attendue. La mise hors service doit révoquer les identifiants de l’appareil et traiter les données stockées, et non simplement arrêter la vente du produit.
Exemple pratique : un moniteur de vibration TinyML
Un petit accéléromètre monté sur un moteur échantillonne les vibrations sous charges normales et conditions de défaut connues. L’appareil découpe le signal, supprime le décalage, calcule des caractéristiques compactes dans le domaine temporel ou fréquentiel, et exécute un détecteur d’anomalies ou un classificateur. La fréquence d’échantillonnage doit saisir les fréquences pertinentes des roulements et de l’arbre sans submerger la mémoire ou l’énergie. Les étiquettes doivent provenir d’inspections vérifiées, et non simplement d’une alarme qui pourrait être erronée.
L’entraînement se fait sur une station de travail, suivi de la quantification, de la conversion et de la compilation pour le microcontrôleur cible. Mesurez la flash du modèle, le pic de RAM, le temps d’exécution, l’énergie et la précision sur l’appareil physique. L’arithmétique entière et la disponibilité des opérateurs peuvent modifier les sorties du modèle d’entraînement. Testez l’orientation du capteur, le montage, la température, la tension, la variation des composants et les vibrations de fond réelles, pas seulement les fichiers de laboratoire soigneusement sélectionnés.
L’appareil déployé nécessite une calibration, des mises à jour sécurisées du firmware, le reporting de version, un comportement de sécurité et un plan de dérive. Il peut ne transmettre qu’un score de santé ou des caractéristiques sélectionnées pour économiser l’énergie et protéger les données brutes, mais les fausses alarmes locales engendrent toujours un coût de maintenance. Utilisez un seuil progressif, exigez la persistance et combinez les preuves du modèle avec l’état de fonctionnement. Le TinyML est le plus précieux lorsque la latence locale, la confidentialité, la connectivité ou les contraintes énergétiques justifient ses limites d’ingénierie.
Les tests de production doivent inclure la récupération après coupure d’alimentation, la dérive de l’horloge, les déconnexions du capteur, les entrées corrompues, l’épuisement de la mémoire et les mises à jour interrompues. Définissez ce qui se passe lorsque le modèle ne peut pas s’exécuter ou que la confiance s’effondre : une valeur sûre par défaut, un indicateur de défaut explicite ou une règle conventionnelle peut être préférable à une supposition silencieuse. Suivez les versions du matériel et du firmware de la flotte afin qu’une erreur nouvellement observée puisse être isolée à une révision d’appareil, un environnement ou une version de modèle.
Liste de contrôle de mise en œuvre pratique
Transformez le concept en un flux de travail limité et testable : détecter → prétraiter → inférer → décider → agir → mettre à jour. Désignez un responsable imputable, documentez les données et les dépendances, établissez une base simple, définissez les critères d’acceptation et d’arrêt, testez des défaillances représentatives, et définissez la surveillance, le rollback et la révision avant d’étendre la portée. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui conçoivent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les défaillances de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la version, modifier un seuil, outrepasser une sortie ou arrêter l’opération. Reconsidérez la décision après l’arrivée des données du monde réel, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- MEMORY: poids, activations et tampons.
- ENERGY: cycle de travail et déplacement des données.
- QUALITY: précision sur le terrain dans des conditions réelles.
Foire aux questions
Le TinyML est‑il identique à l’IA mobile ?
Pas exactement. Les appareils mobiles sont des systèmes de périphérie avec des processeurs et une mémoire relativement grands. Le TinyML se concentre sur des contraintes beaucoup plus strictes de type embarqué et microcontrôleur.
Les modèles TinyML peuvent‑ils apprendre sur l’appareil ?
La plupart des déploiements s’entraînent ailleurs et effectuent l’inférence sur l’appareil. Une adaptation limitée est possible, mais la mémoire, l’énergie, la stabilité, la confidentialité et le rollback rendent l’entraînement sur l’appareil plus difficile.
Références principales












