Modèles et plateformes d’IA
Qu’est‑ce que la loi de Moore et comment influence‑t‑elle l’IA ?

 Ajouter Unite.AI à vos sources préférées sur Google
La loi de Moore est l’observation historique selon laquelle les circuits intégrés économiquement utiles augmentaient le nombre de composants à un rythme exponentiel. Ce n’est pas une loi physique et elle ne stipule pas que les ordinateurs deviennent automatiquement deux fois plus rapides selon un calendrier fixe.
Pour l’IA, la densité de transistors compte car elle permet d’ajouter davantage d’unités arithmétiques, de mémoire et d’interconnexions. Cependant, les progrès pratiques dépendent également de l’architecture, de la précision numérique, de l’emballage, de la bande passante mémoire, des algorithmes, des logiciels, de l’énergie, du rendement de fabrication et de la quantité de données utiles.
Points clés
- L’article original de Moore de 1965 décrivait une tendance économique et d’ingénierie, et non une garantie physique.
- L’augmentation de la fréquence d’horloge a ralenti ; les gains modernes proviennent de plus en plus du parallélisme et des accélérateurs spécialisés.
- Les performances de l’IA sont souvent limitées par les déplacements de mémoire et l’énergie, et non uniquement par le calcul arithmétique.
- Comparez les systèmes en fonction de la latence, du débit, de la qualité, de la consommation énergétique et du coût total au niveau de la charge de travail — pas du nombre de transistors.
Ce que Moore a réellement observé
Gordon Moore a tracé le nombre de composants dans les circuits intégrés de pointe et a prévu une croissance rapide continue au coût minimal par composant. Ce rythme a ensuite été généralement résumé comme un doublement approximatif tous les deux ans, bien que les formulations et les quantités mesurées varient.
Des dimensions plus petites peuvent augmenter la densité et réduire certains coûts de commutation, mais la complexité et l’économie de la fabrication déterminent si la tendance reste pertinente. Les noms de nœuds sont des désignations marketing et ne doivent pas être considérés comme une comparaison physique directe entre les fonderies.
Des cœurs plus rapides à l’informatique hétérogène
Le redimensionnement de tension à la Dennard permettait autrefois d’atteindre des fréquences d’horloge plus élevées sans une croissance proportionnelle de la puissance, mais cette relation s’est affaiblie. Les concepteurs se sont tournés vers les CPU multicœurs, les GPU, les unités tensor, les chiplets, l’emballage avancé et les accélérateurs spécifiques à un domaine.
Cette hétérogénéité est au cœur de l’apprentissage profond. Les opérations matricielles denses peuvent s’exécuter efficacement sur du matériel parallèle, tandis que les CPU coordonnent la logique irrégulière et les déplacements de données. L’élément le plus rapide n’aide pas si le pipeline ne peut pas le alimenter.
Mémoire, précision et algorithmes
L’entraînement et l’inférence déplacent de façon répétée les poids, les activations et les données de cache à travers une hiérarchie de mémoire sur puce et hors puce. La bande passante, la capacité, la localité et la communication peuvent dominer le coût. Une précision numérique moindre et la quantification réduisent les déplacements lorsque la qualité reste acceptable.
Les améliorations algorithmiques peuvent diminuer la puissance de calcul nécessaire pour atteindre un résultat cible. Les modèles parcimonieux, les méthodes d’efficacité des transformeurs, de meilleurs optimiseurs et des données de meilleure qualité influent tous sur les progrès effectifs ressentis par les utilisateurs.
Comment comparer le matériel d’IA
Les performances de pointe en opérations par seconde sont théoriques. Utilisez un modèle représentatif, une taille de lot, une longueur de séquence, une précision, une pile logicielle et un seuil de qualité. Renseignez la latence de bout en bout, le débit, l’énergie, l’empreinte mémoire, l’utilisation et le coût.
Les systèmes en périphérie peuvent privilégier la confidentialité et la faible consommation plutôt que le débit maximal ; les centres de données peuvent prioriser le nombre total de jetons ou d’échantillons par watt. Edge IA montre clairement pourquoi un chiffre unique ne peut pas décrire chaque système utile.
Pourquoi l’échelle des semi-conducteurs a changé
Les premiers progrès des circuits intégrés combinaient des dispositifs plus petits, une meilleure fabrication, un coût par composant réduit et des améliorations de conception. Pendant des années, la réduction des dimensions des transistors a également permis des commutations plus rapides et une énergie moindre par opération. Finalement, les fuites, les limites de tension, la densité thermique, les retards d’interconnexion et le coût de fabrication ont affaibli la relation simple entre un nouveau nœud de procédé et des cœurs à usage général plus rapides.
Les progrès modernes sont donc multidimensionnels. Les dispositifs FinFET et gate‑all‑around améliorent le contrôle électrostatique ; la lithographie extrême‑ultraviolet permet des motifs plus petits ; les chiplets permettent aux concepteurs de combiner des puces fabriquées avec différents procédés ; l’emballage avancé rapproche le calcul et la mémoire. Le rendement et l’emballage déterminent si une conception techniquement impressionnante est économique à grande échelle.
Le ralentissement d’un mécanisme d’échelle ne signifie pas que le matériel a cessé de s’améliorer. Cela signifie que les architectes doivent utiliser les transistors de façon plus délibérée. Les unités spécialisées échangent la flexibilité contre le débit ou l’efficacité sur des charges de travail sélectionnées, tandis que les caches et interconnexions plus grands tentent de les alimenter.
Comment les charges de travail IA sollicitent le matériel
L’entraînement alterne calcul avant, rétropropagation, mises à jour de l’optimiseur et communications entre accélérateurs. L’inférence varie du scoring par lots à la génération interactive de jetons. La multiplication matricielle est importante, mais les embeddings, la normalisation, les fonctions d’activation, l’attention, le routage, l’accès au cache et l’orchestration de l’hôte contribuent tous à la performance réelle.
L’intensité arithmétique — la quantité de calcul effectuée par octet déplacé — aide à expliquer si une charge de travail est limitée par le calcul ou par la bande passante. De petites tailles de lot et le décodage autorégressif laissent souvent les unités arithmétiques sous‑exploitées parce que les poids ou les données du cache doivent être récupérés de façon répétée. Des lots plus grands améliorent l’utilisation mais augmentent la latence et la mémoire.
Le format numérique modifie le compromis. Les formats FP32, BF16, FP16, FP8 et les formats entiers diffèrent en termes de plage, de précision, de prise en charge matérielle et d’erreur. L’entraînement à précision mixte conserve les opérations sensibles à une précision supérieure ; l’inférence quantifiée nécessite une calibration et des tests de qualité plutôt qu’une promesse que chaque modèle tolère la même largeur de bits.
Économie du système et perspectives futures
Le coût total de l’IA comprend l’achat ou la location d’accélérateurs, l’alimentation électrique, le refroidissement, le réseau, le stockage, l’ingénierie logicielle, la capacité inutilisée et les expériences infructueuses. Une puce plus rapide peut coûter davantage globalement si l’utilisation est faible ou si le modèle nécessite une topologie distribuée coûteuse. Mesurez la production utile à un seuil de qualité défini.
L’échelle est également limitée par les données et les algorithmes. Plus de calcul ne peut pas corriger des données mal étiquetées ou une évaluation qui récompense les raccourcis. Une attention efficace, de meilleurs optimiseurs, la parcimonie, la récupération, la distillation et les découvertes algorithmiques peuvent améliorer les résultats sans une augmentation proportionnelle du matériel, bien qu’ils puissent déplacer les coûts ailleurs.
Les systèmes futurs combineront les avancées de processus avec l’empilement tridimensionnel, la mémoire à bande passante élevée, les interconnexions optiques ou électriques avancées, le flux de données spécifique à un domaine et les logiciels co‑conçus. La loi de Moore reste un contexte historique précieux, mais la planification doit s’appuyer sur des courbes de charge de travail mesurées et des contraintes réalistes d’approvisionnement, d’énergie et de déploiement.
Lire correctement la loi de Moore dans la conception d’un système d’IA
Une analyse utile sépare la densité de transistors, les performances du CPU à usage général, le débit des accélérateurs, la capacité mémoire, la bande passante mémoire, les interconnexions, l’énergie, le rendement de fabrication et le coût. Ceux‑ci n’évoluent pas au même rythme. Une charge de travail IA dominée par le déplacement des poids du modèle peut gagner peu avec davantage d’unités arithmétiques, tandis qu’un petit modèle sur puce peut bénéficier considérablement d’un matériel spécialisé à faible précision. Citez la métrique exacte, la précision, la charge de travail et l’enveloppe énergétique plutôt que de considérer un nœud de procédé comme une performance.
L’échelle d’un modèle IA modifie également les exigences logicielles et systémiques. Des entraînements plus vastes nécessitent des algorithmes parallèles, des points de contrôle fiables, un réseau à haute vitesse, des pipelines de stockage et suffisamment de données pour exploiter la capacité supplémentaire. En inférence, la latence dépend de la longueur de l’invite, des jetons générés, du lot, de la mémoire cache et des objectifs de niveau de service. Les améliorations algorithmiques, la parcimonie, la quantification, la récupération et de meilleures données peuvent offrir des gains indépendants des tendances des transistors et parfois dépasser une génération de matériel.
Pour la planification, évaluez des modèles représentatifs sur les systèmes candidats et modélisez le coût total sur le cycle de vie du déploiement : prix d’acquisition ou du cloud, énergie, refroidissement, utilisation, ingénierie, migration et risque d’approvisionnement. Utilisez des scénarios plutôt qu’une prévision exponentielle unique. La loi de Moore reste une observation historique précieuse sur l’économie de l’intégration, mais elle ne garantit pas que l’IA devienne proportionnellement plus rapide, moins chère, plus performante ou plus durable selon un calendrier fixe.
Liste de vérification pour la mise en œuvre pratique
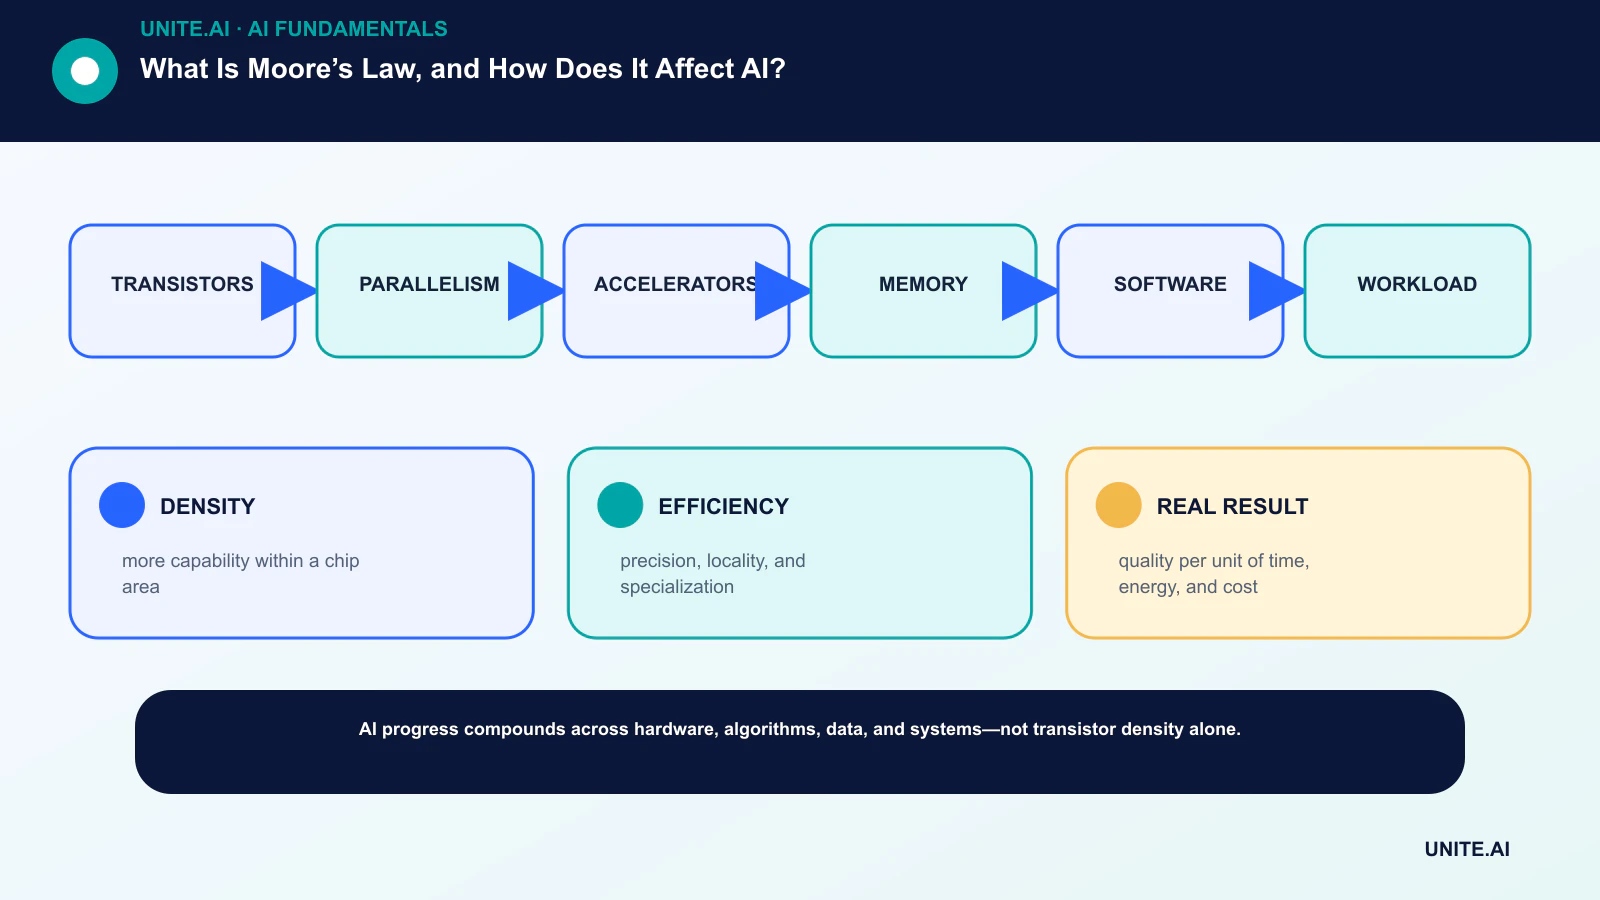
Transformez le concept en un flux de travail limité et testable : transistors → parallélisme → accélérateurs → mémoire → logiciel → charge de travail. Désignez un responsable, documentez les données et les dépendances, établissez une ligne de base simple, définissez les critères d’acceptation et d’arrêt, testez des échecs représentatifs et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les défaillances de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la version, modifier un seuil, remplacer une sortie ou arrêter l’opération. Réexaminez la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas des performances fiables à plus grande échelle.
- DENSITÉ: plus de capacité dans la zone d’une puce.
- EFFICACITÉ: précision, localité et spécialisation.
- RÉSULTAT RÉEL: qualité par unité de temps, d’énergie et de coût.
Questions fréquentes
La loi de Moore est‑elle terminée ?
La tendance historique simple a ralenti et changé de caractère, mais les progrès des semi‑conducteurs se poursuivent à travers les dispositifs, l’architecture, l’emballage, la mémoire et les logiciels. La pertinence de l’expression dépend du métrique utilisé.
Le double de transistors signifie‑t‑il le double de performances en IA ?
Non. Les performances dépendent de la façon dont les transistors sont utilisés ainsi que de la bande passante, de la précision, de la structure du modèle, de l’efficacité logicielle, de la puissance et des contraintes de la charge de travail.
Références principales