
Fondamentaux de l’IA
Modèles d’apprentissage automatique prêts à l’emploi vs modèles personnalisés

 Ajouter Unite.AI à vos sources préférées sur Google
Choisir une solution d’apprentissage automatique n’est rarement une simple décision d’achat versus construction. Le véritable continuum va d’une API hébergée ou d’un modèle empaqueté, en passant par le prompting, la récupération et le fine‑tuning, jusqu’à une architecture entièrement personnalisée entraînée sur des données propres à l’organisation.
L’option optimale est l’approche la moins complexe qui satisfait une exigence produit vérifiée. Un modèle sur mesure peut offrir du contrôle et de la différenciation, mais il engendre également une obligation continue de gérer les pipelines de données, les évaluations, la surveillance, la sécurité, les mises à jour et les retours en arrière.
Points clés
- Commencez par une tâche mesurable, une base non‑ML et des seuils d’acceptation.
- Évaluez les modèles candidats sur des données privées représentatives plutôt que sur les seuls scores de benchmarks publics.
- Intégrez les coûts d’intégration, de latence, de révision, de ré‑entraînement et d’incident dans le coût total de possession.
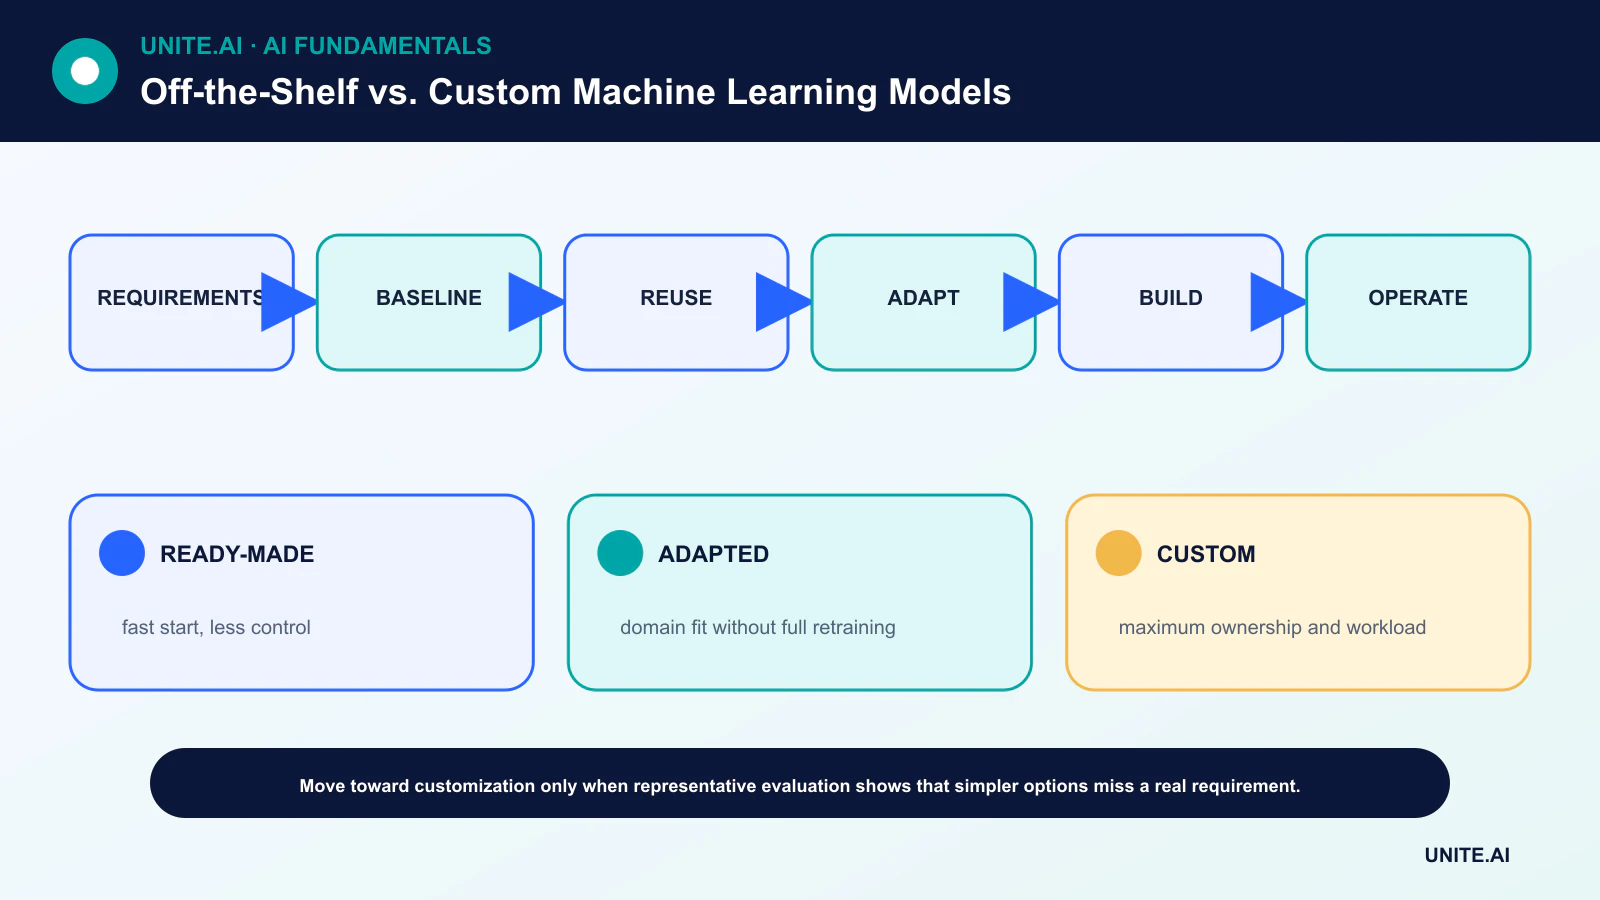
- Privilégiez des étapes réversibles: base, récupération ou prompt, fine‑tune, puis entraînement à partir de zéro uniquement lorsque les preuves le justifient.
Définir la décision avant de choisir un modèle
Spécifiez l’utilisateur, la décision, les entrées, les sorties, les coûts d’erreur, le budget de latence, le schéma de trafic et le chemin d’escalade. Déterminez si une règle déterministe ou un système de recherche résout une part suffisante du problème. Les Rules of ML de Google recommandent des bases simples et une infrastructure fiable avant de recourir à une modélisation complexe.
Créez un ensemble d’évaluation hors ligne qui reflète la production, y compris les cas rares et adversaires. Lorsque les décisions affectent des personnes, définissez des contrôles de sous‑groupes et des règles de révision humaine. Ces garde‑fous rendent les comparaisons concrètes au lieu de transformer le choix d’architecture en préférence.
Le continuum de réutilisation et d’adaptation
Une API hébergée offre une intégration rapide et une mise à l’échelle gérée, mais un contrôle limité sur les internes du modèle, les versions et la gestion des données. Un modèle pré‑entraîné ouvert augmente le contrôle du déploiement. La récupération ou le prompt engineering peuvent ajouter un contexte métier sans modifier les poids.
Le fine‑tuning ou les adaptateurs paramétriquement efficaces peuvent spécialiser le comportement. L’entraînement à partir de zéro n’est justifié que lorsque les données, l’objectif, l’échelle ou les exigences de propriété ne peuvent être satisfaits par la réutilisation. L’apprentissage par transfert capture souvent la majeure partie de la valeur avec nettement moins de données et de calcul.
Qualité, contrôle et verrouillage
Mesurez la qualité de la tâche, la calibration, la latence, le débit, la disponibilité et la cohérence des échecs. Un modèle fourni par un vendeur peut s’améliorer automatiquement mais peut aussi modifier son comportement ; un modèle auto‑hébergé peut être figé mais nécessite que l’équipe gère les mises à jour et les vulnérabilités.
Les clauses contractuelles doivent couvrir la conservation des données, l’utilisation de l’entraînement, le traitement régional, la propriété intellectuelle, les niveaux de service, les voies d’exportation et la dépréciation. La portabilité s’améliore lorsque l’application sépare les adaptateurs spécifiques au modèle de la logique métier et stocke des artefacts d’évaluation reproductibles.
Confidentialité, sécurité et opérations
Cartographiez chaque flux de données et chaque frontière de menace. Les entrées sensibles peuvent nécessiter un réseau privé, une inférence sur site ou de l’edge AI. L’auto‑hébergement ne rend pas automatiquement un système sûr ; il transfère la responsabilité de la sécurité et de la conformité à l’opérateur.
La responsabilité de la production comprend l’observabilité, les contrôles de dérive, la surveillance des abus, la réponse aux incidents et le retour en arrière. L’équipe opérationnelle doit pouvoir répondre quel modèle, quel prompt, quelle version de données et quelle politique ont produit le résultat.
Utiliser des preuves par étapes, pas l’idéologie
Effectuez un benchmark limité dans le temps avec le même jeu de données et les mêmes critères d’acceptation pour toutes les options. Estimez le temps d’ingénierie, l’annotation, l’utilisation d’accélérateurs, les frais du vendeur, le travail de révision, les coûts d’échec et la cadence attendue des changements.
Choisissez le candidat le plus simple qui franchit les garde‑fous, puis réévaluez lorsque les exigences ou les prix évoluent. La personnalisation est précieuse lorsqu’elle génère un bénéfice mesuré ou un contrôle nécessaire — pas simplement parce qu’un modèle sur mesure semble stratégiquement important.
Exigences et comparaison des coûts totaux
Un modèle prêt à l’emploi, une API ou un système empaqueté offre une capacité pré‑construite avec le support du vendeur et un déploiement initial plus rapide. Un modèle sur mesure est entraîné ou largement adapté à une tâche, des données et un environnement opérationnel spécifiques. Le choix commence par les exigences: résultat cible, qualité par sous‑groupe et cas limites, latence, débit, disponibilité, explicabilité, résidence des données, contrôle des mises à jour, intégration, sécurité et conséquence d’échec. Un benchmark ou une démonstration générique ne peut pas répondre si un produit satisfait ces exigences.
Le coût total comprend l’évaluation, la préparation des données, l’étiquetage, l’intégration, les licences ou l’usage, l’infrastructure, la surveillance, la révision, la réponse aux incidents, les mises à jour et la sortie. Le prêt à l’emploi réduit l’ingénierie initiale mais peut engendrer des coûts variables, un verrouillage, des changements de comportement et une observabilité limitée. Le développement sur mesure ajoute la responsabilité des données et du MLOps et peut encore dépendre de poids pré‑entraînés et de fournisseurs. Le coût du modèle doit être mesuré par tâche réussie à la qualité requise, et non par token ou exécution d’entraînement seule.
Évaluation, acquisition et adaptation
Construisez un jeu de test privé représentatif avant la sélection du vendeur et exécutez chaque candidat avec des prompts, prétraitements, seuils et limites opérationnelles identiques. Incluez des cas ambigus, adversaires, non pris en charge, multilingues et à forte conséquence. Mesurez la précision, la calibration, la latence, le coût, le refus, la sécurité et l’impact sur le flux de travail humain. Testez les pannes d’API, les limites de taux, le comportement régional et les changements de version. Les affirmations du vendeur nécessitent une documentation concernant l’entraînement, les droits, la confidentialité, la conservation, les sous‑processus, la sécurité, le support et la notification d’incident.
Les options d’adaptation forment un spectre: configuration, récupération, prompting, fine‑tuning, mises à jour paramétriquement efficaces, têtes personnalisées ou entraînement à partir de zéro. Utilisez la méthode la moins complexe qui satisfait les preuves. La récupération est appropriée pour des connaissances qui évoluent fréquemment ; le tuning peut façonner le format ou le comportement métier ; le code déterministe doit gérer les règles exactes. Validez les systèmes combinés car un modèle de base performant peut tout de même échouer à cause d’une mauvaise récupération, de permissions ou d’intégration.
Planification du cycle de vie et de la sortie
Les produits hébergés peuvent changer ou disparaître, tandis que les modèles sur mesure deviennent une dette technique sans propriétaire. Surveillez les dépendances de version, le comportement et les résultats, définissez les déclencheurs de ré‑entraînement ou de réévaluation, et maintenez la capacité de retour en arrière. Conservez les données et les interfaces nécessaires à la migration, négociez la suppression et l’exportation, et évitez d’exposer le schéma propriétaire d’un vendeur dans toute l’application. Le meilleur choix peut être hybride: capacité commerciale pour les tâches courantes et composants sur mesure lorsque la performance métier, le contrôle ou le risque créent une valeur durable.
Exemple pratique: choisir un modèle d’extraction de documents
Une entreprise crée un jeu de test privé d‑factures provenant de différents fournisseurs, langues, numérisations, écritures manuscrites et cas limites, puis compare une API gérée, un modèle pré‑entraîné ouvert, un modèle adapté et une base de règles. Elle mesure la précision des champs, l’erreur monétaire, les documents non pris en charge, la latence, le débit, la confidentialité, la résidence, l’intégration et le coût par facture correctement traitée. Les démonstrations des vendeurs et les benchmarks publics ne remplacent pas cette évaluation appariée.
Le hybride sélectionné utilise un service OCR commercial avec validation locale et révision humaine pour les faibles confiances ou les montants élevés. Les contrats définissent la conservation, les sous‑processus, les mises à jour et la suppression ; l’architecture conserve les fichiers source et un chemin de sortie. Une période d’ombre détecte les écarts de schéma et de fournisseur. La surveillance sépare l’OCR, l’extraction, la validation et les corrections des réviseurs. Si le comportement du vendeur change, l’équipe peut geler, basculer ou transférer davantage de travail vers son composant sur mesure sans réécrire le flux de travail financier.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et la conséquence de chaque échec important. Établissez une base reproductible et un ensemble d’évaluation versionné avant le tuning. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un réviseur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour les versions, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les vendeurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Quand une équipe doit‑elle entraîner un modèle à partir de zéro ?
Lorsque les options pré‑entraînées ou hébergées ne peuvent pas satisfaire les exigences validées et que l’équipe dispose de données propriétaires suffisantes, de capacité de calcul, d’expertise et d’une capacité opérationnelle à long terme.
Un modèle prêt à l’emploi est‑il sans entretien ?
Non. L’intégration, l’évaluation, les changements de version, la surveillance, les contrôles de confidentialité et le comportement de secours restent de la responsabilité de l’adoptant.
Références principales











