Fondamentaux de l’IA
Programmation et IA: Le parcours d’un débutant vers l’intelligence artificielle

 Ajouter Unite.AI à vos sources préférées sur Google
Vous pouvez commencer à apprendre l’IA sans expérience professionnelle préalable en programmation, mais la création de systèmes fiables nécessite finalement des compétences suffisantes en codage, données et évaluation pour examiner ce que les outils font. Le chemin le plus rapide est une petite série de projets ancrés dans les fondamentaux plutôt qu’une longue série de tutoriels décousus.
Le codage assisté par l’IA peut expliquer la syntaxe, générer des exemples et aider au débogage. Considérez sa sortie comme un brouillon: exécutez‑le, testez‑le, lisez la documentation et comprenez les données ainsi que les autorisations avant de lui faire confiance.
Points clés
- Apprenez les bases de Python, les notebooks, Git, la ligne de commande et la lecture des erreurs.
- Réalisez un petit projet d’apprentissage supervisé avant de passer aux agents ou aux grands modèles.
- Utilisez correctement les données d’entraînement, de validation et de test ; comparez avec une simple ligne de base.
- Laissez l’IA assister la boucle de rétroaction, mais vérifiez vous‑même le code, les sources, les licences, la sécurité et les résultats.
Étape 1: bases de la programmation
Apprenez les variables, les collections, les conditions, les boucles, les fonctions, les modules, les fichiers, les environnements et les exceptions. Entraînez‑vous à lire un CSV, transformer des enregistrements, appeler une API documentée, écrire un test et utiliser Git pour suivre les modifications.
Vous n’avez pas besoin de mathématiques avancées avant d’écrire du code, mais vous devriez apprendre les bases de la probabilité, des vecteurs, des moyennes, des distributions et des graphiques lorsqu’ils deviennent pertinents. La pensée computationnelle aide à transformer un objectif vague en étapes testables.
Étape 2: un projet complet d’apprentissage automatique
Choisissez un petit jeu de données public et une question de prédiction claire. Explorez les données, créez une division indépendante, construisez une ligne de base, entraînez un modèle simple, inspectez les erreurs et notez les limitations. Utilisez scikit-learn avant un réseau de neurones personnalisé lorsqu’il convient.
Ce projet rend les concepts d’apprentissage automatique concrets: caractéristiques, étiquettes, fuites, surapprentissage, métriques, reproductibilité et différence entre le score d’un modèle et une décision utile.
Étape 3: apprentissage profond et modèles de langage
Apprenez les tenseurs, les lots, la perte, la descente de gradient et la rétropropagation à travers un petit modèle d’image ou de texte. Puis utilisez un modèle pré‑entraîné via une API ou une bibliothèque ouverte, consignez les invites et les versions, et comparez‑le à une méthode plus simple.
Explorez l’IA générative à travers une application limitée avec récupération ou utilisation d’outils. Ajoutez validation, citations, autorisations et solution de repli afin que le projet enseigne l’ingénierie des systèmes ainsi que le prompting.
Utilisez les assistants de codage IA de manière délibérée
Demandez de petites fonctions, des tests, des explications, des cas limites et des références de documentation. Exécutez des vérifications statiques et des tests, examinez les changements de dépendances, et ne collez jamais de secrets ou de données privées sans autorisation. Si vous ne pouvez pas expliquer une ligne critique, ralentissez.
Un portfolio utile montre la question, les droits sur les données, la ligne de base, la méthode, l’évaluation, les erreurs et ce que vous amélioreriez. Des petits projets terminés et documentés démontrent davantage de discernement qu’un code copié à partir d’une grande démonstration.
Un parcours d’apprentissage pratique du problème au prototype
Commencez par une tâche précise et un petit ensemble d’exemples représentatifs plutôt que par une ambition large d’« apprendre l’IA ». Classifier des messages de support, extraire des champs de factures ou répondre à des questions à partir de documents approuvés fournit des entrées et sorties observables. Décrivez à quoi ressemble un bon résultat avant de choisir un modèle ou un outil.
Les interfaces sans code peuvent enseigner le prompting, la préparation des données, l’évaluation et la conception de flux de travail, mais elles n’éliminent pas le besoin de jugement technique. Apprenez les tableaux, les fichiers, les API, l’authentification, les variables, les conditions et les statistiques de base. Ces concepts expliquent comment les données circulent, pourquoi les intégrations échouent et ce que signifie (ou ne signifie pas) le résultat d’un modèle.
Construisez une ligne de base avec une règle simple, une méthode de recherche, une feuille de calcul ou un petit modèle. Comparez ensuite une approche IA sur les mêmes cas de test. Une ligne de base révèle si la complexité ajoute de la valeur et fournit aux débutants une cible de débogage concrète. Gardez les données de test séparées des exemples utilisés pour configurer ou inciter le système.
Prompting, API et transition vers le code
Une invite utile indique la tâche, le contexte pertinent, les contraintes, le schéma de sortie et des exemples si nécessaire. Les modifications d’invite sont des modifications logicielles: versionnez‑les, testez‑les sur un jeu d’évaluation fixe et inspectez les échecs. Ne considérez pas les explications fluides du modèle comme une preuve que la réponse ou les preuves citées sont correctes.
Les constructeurs de flux de travail connectent les appels de modèle aux formulaires, bases de données, fichiers et applications métier. Comprenez quelles données chaque étape envoie à des tiers, comment les identifiants sont stockés et ce qui se passe en cas de délai d’attente ou de nouvelle tentative. Ajoutez validation des entrées, sorties structurées, limites de débit, approbation humaine et journaux avant d’utiliser un prototype avec de vrais utilisateurs.
Le code devient précieux lorsque le flux de travail nécessite une logique personnalisée, des tests reproductibles, de l’échelle, des performances, de la portabilité ou des contrôles de sécurité détaillés. Python et JavaScript sont des points d’entrée courants, mais le langage importe moins que les fondamentaux: fonctions, structures de données, paquets, erreurs, gestion de version et tests. N’utilisez le code généré qu’après l’avoir lu et exécuté en toute sécurité.
Projets de portfolio, évaluation et développement de carrière
Un projet débutant solide documente le problème, les utilisateurs, les autorisations sur les données, la ligne de base, l’architecture, le jeu d’évaluation, les métriques, les échecs, les risques et les étapes suivantes. Une interface soignée sans évaluation montre moins qu’une petite expérience reproductible. Supprimez les données privées et les secrets avant de publier le code, les captures d’écran, les invites ou les journaux.
Évaluez le succès de la tâche plutôt que l’impression du modèle. La classification nécessite une précision et un rappel spécifiques à chaque classe ; l’extraction nécessite une exactitude des champs ; la recherche nécessite une couverture des preuves ; la génération nécessite la factualité, l’utilité, la sécurité, la latence et le coût. Examinez les performances selon les langues, les cas limites et les groupes affectés, et définissez quand un humain doit décider.
Le travail en IA comprend la gestion de produit, l’expertise métier, les opérations de données, l’évaluation, la conception, la sécurité, la politique et la gestion du changement ainsi que le développement de modèles. Acquérez une profondeur dans un domaine et une littératie technique suffisante pour collaborer entre les rôles. Des portfolios crédibles expliquent les compromis et les limites plutôt que de présenter chaque prototype comme une automatisation prête pour la production.
Exemple pratique: un débutant crée un assistant de tri de documents
Un apprenant rassemble un petit ensemble de documents publics ou autorisés et définit trois catégories ainsi qu’un résultat « incertain ». Il étiquette les exemples à l’aide d’une règle écrite, réserve un jeu de test et met en œuvre une ligne de base à mots‑clés dans une feuille de calcul. Un modèle sans code ou une API renvoie alors une catégorie structurée et une confiance, qui sont comparées aux mêmes cas. Les exemples incorrects et ambigus deviennent le matériel d’apprentissage, et non un élément caché dans une démonstration.
Le flux de travail accepte un fichier, extrait le texte, supprime les formats non pris en charge, appelle le modèle avec un schéma fixe, valide la réponse et envoie les cas incertains à la révision. Il ne conserve que les champs nécessaires et n’inclut jamais d’identifiants dans les invites ou les captures d’écran partagées. L’apprenant consigne le nom du modèle, la version de l’invite, la latence, le coût et la sortie afin que les changements puissent être testés plutôt que jugés de mémoire.
Un rapport de portfolio indique la précision et le rappel par classe, les hypothèses de confidentialité, les exemples d’échec et la frontière entre prototype et production. L’étape de codage suivante peut remplacer une intégration manuelle fragile par une petite fonction ou API testée. Cette progression enseigne des compétences transférables: définition du problème, qualité des données, évaluation, interfaces, gestion des erreurs, sécurité et communication. Ces fondamentaux comptent davantage que de prétendre avoir construit un agent sophistiqué après un seul exemple réussi.
Checklist de mise en œuvre pratique
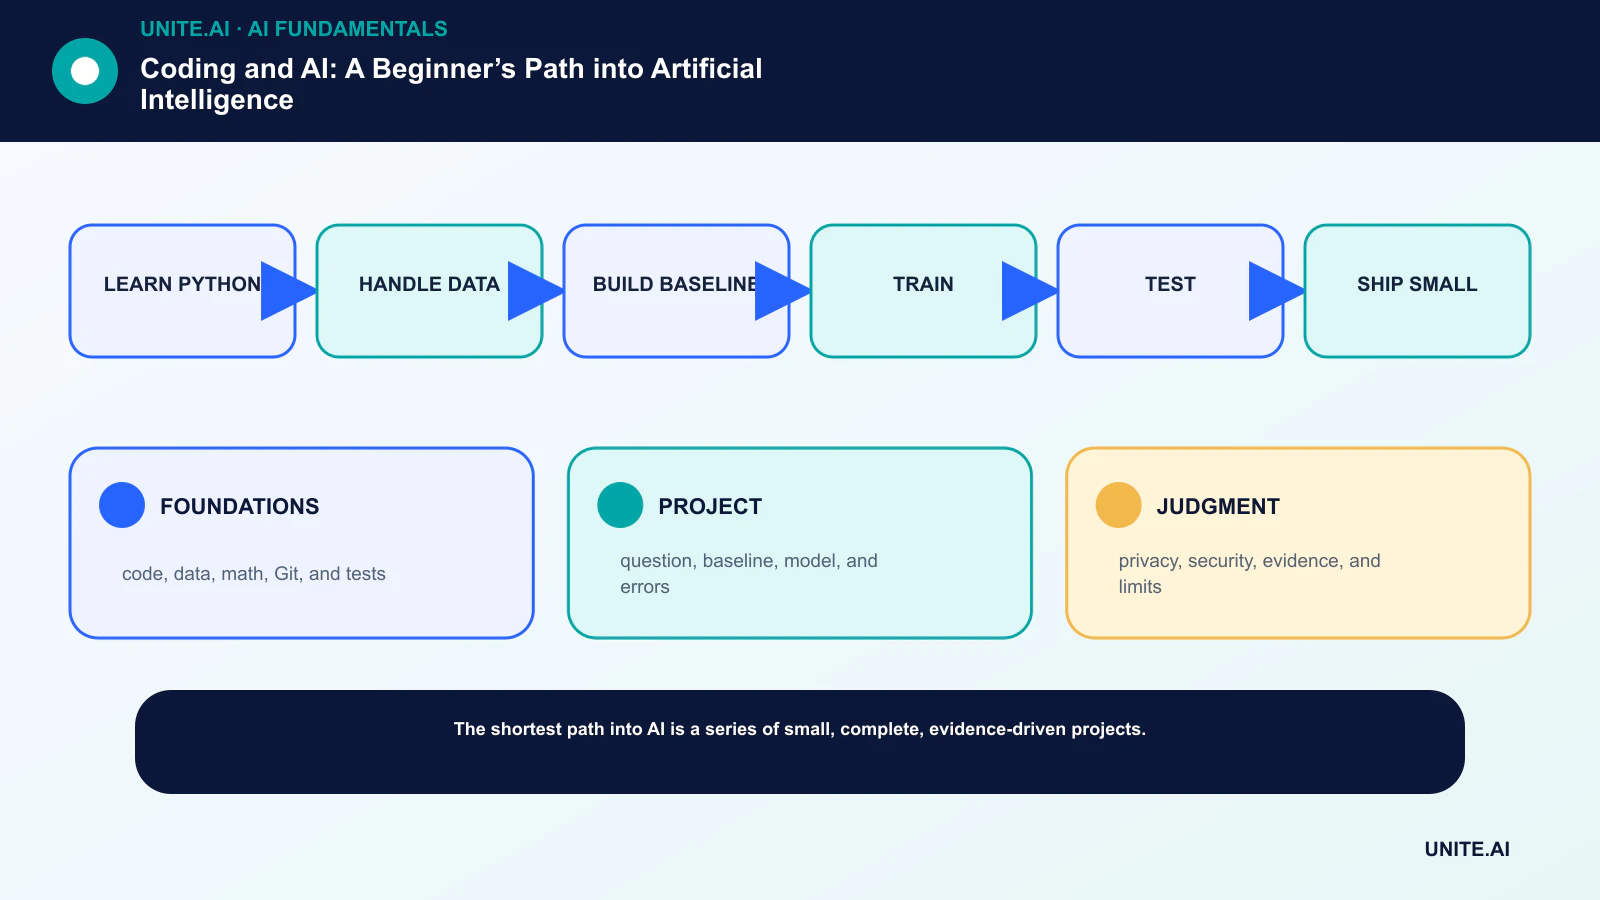
Transformez le concept en un flux de travail limité et testable: apprenez python → gérez les données → créez une ligne de base → entraînez → testez → livrez petit. Désignez un responsable imputable, documentez les données et les dépendances, établissez une ligne de base simple, définissez les critères d’acceptation et d’arrêt, testez des échecs représentatifs et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Consignez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre ce qui a changé.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les défaillances de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, annuler une sortie ou arrêter l’opération. Reconsidérez la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- FONDATIONS: code, données, mathématiques, Git et tests.
- PROJET: question, ligne de base, modèle et erreurs.
- JUGEMENT: confidentialité, sécurité, preuves et limites.
Foire aux questions
Ai‑je besoin d’un diplôme en informatique pour travailler dans l’IA ?
Non. Les rôles comprennent l’ingénierie, la recherche, le produit, le design, les opérations, les données, l’évaluation, la politique et l’expertise métier. Chacun nécessite un niveau de codage différent.
Quel langage de programmation un débutant devrait‑il apprendre ?
Python est un choix pratique en premier lieu parce que sa syntaxe est accessible et que son écosystème de données et d’IA est vaste. Les compétences de résolution de problèmes sous‑jacentes se transfèrent à d’autres langages.
Références principales