AI:n perusteet
Mitä RNN:t ja LSTM:t ovat syväoppimisessa?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Recurrent neural networks (RNNs) prosessoi sekvenssejä päivittämällä piilotilan ajan myötä. Long short-term memory (LSTM) verkot ovat porttitoiminnolla varustettuja RNN:itä, jotka on suunniteltu säilyttämään ja hallitsemaan informaatiota tehokkaammin kuin perus toistoyksikkö.
RNN:t ja LSTM:t hallitsivat aikoinaan monia kielitehtäviä, mutta nykyaikaiset suuret chatbotit perustuvat pääosin transformereihin. Toistuvat mallit ovat edelleen hyödyllisiä suoratoistoon, aikasarjoihin, puheeseen, ohjaukseen ja resurssirajoitteisiin järjestelmiin, joissa inkrementaalinen tila ja matala latenssi ovat tärkeitä.
Keskeiset havainnot
- RNN käyttää samoja parametreja jokaisessa sekvenssivaiheessa ja siirtää piilotilan eteenpäin.
- Ajan yli tapahtuva koulutus voi aiheuttaa katoavia tai räjähtäviä gradientteja.
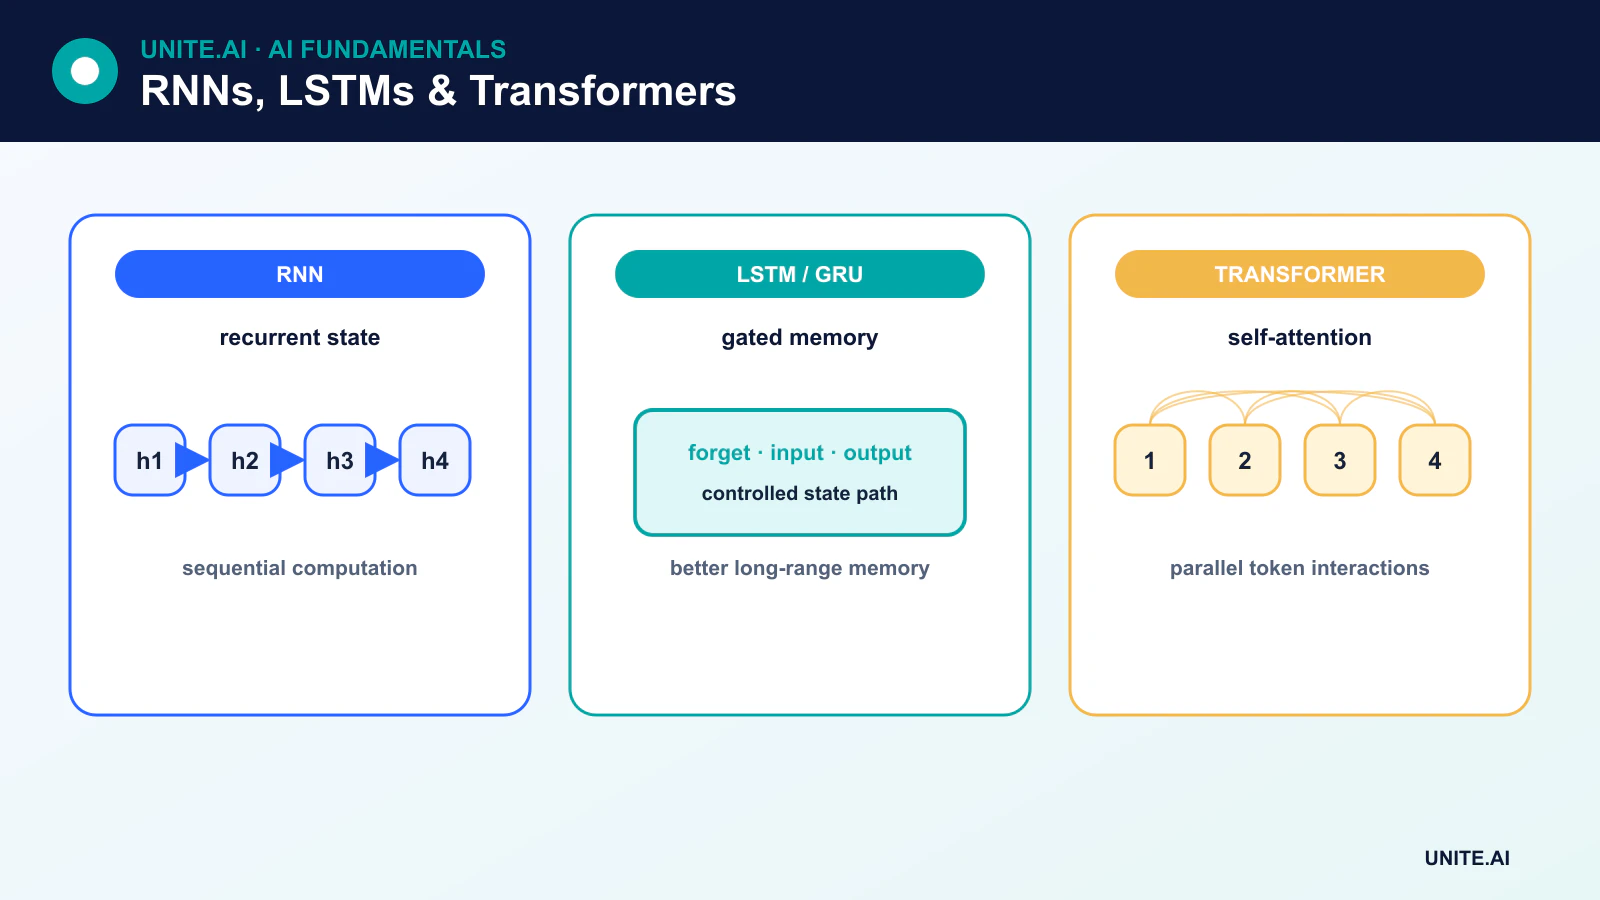
- LSTM lisää solutilan sekä sisään-, unohtamis- ja ulostulogateja.
- Transformerit käsittelevät pitkän kantaman suhteita ja rinnakkaiskoulutusta eri tavoin; kumpikaan arkkitehtuuri ei ole paras kaikissa käyttötapauksissa.
Kuinka perus-RNN toimii
Vaiheessa t yksinkertainen toistoyksikkö yhdistää nykyisen syötteen xₜ edellisen piilotilan hₜ₋₁ kanssa:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Piilotila on opittu yhteenveto, jota käytetään seuraavassa vaiheessa ja tehtävästä riippuen myös lähtönä. “Unrolled”-kaavio piirtää yhden kopion jokaiselle aikavälille, mutta kaikki kopiot jakavat parametrit. Lähtöä ei yksinkertaisesti kopioida takaisin uutena raakasyötteenä; toisto siirtää piilotilan määritellyn muunnoksen läpi.
Takaisinkytkentä ajan yli
RNN:t koulutetaan takaisinkytkennällä ajan yli (BPTT). Unrolled-sekvenssi muodostaa syvän laskennallisen graafin, ja takaisinkytkentä laskee, miten häviö riippuu jaetuista toistoparametreista.
Toistuva kertolasku voi saada gradientit kutistumaan kohti nollaa tai kasvamaan rajoittamattomasti. Katoavat gradientit estävät pitkien riippuvuuksien oppimisen; räjähtävät gradientit aiheuttavat epävakaita päivityksiä. Gradienttien leikkaus (clipping) torjuu räjähtäviä gradientteja, kun taas porttaus, alustus, normalisointi ja lyhyemmät koulutusikkunat voivat auttaa.
LSTM-solun sisällä
LSTM ylläpitää cell state cₜ piilotilan hₜ lisäksi. Sen portit ovat opittuja, data‑riippuvaisia ohjaimia:
- The forget gate ohjaa, kuinka paljon edellistä solutilaa säilytetään.
- The input gate ohjaa, kuinka paljon ehdokastietoa kirjoitetaan.
- The output gate ohjaa, kuinka paljon solutieto vaikuttaa piilotilaan.
Sigmoid-funktiosta saadut arvot nollan ja yhden välillä toimivat pehmeinä porteina, kun taas tanh‑muunneltu ehdokas tarjoaa uutta sisältöä. Lisäyksellinen solutilapolku auttaa gradientteja säilymään, mutta LSTM:t eivät takaa rajoittamatonta muistia eivätkä poista kaikkia optimointiongelmia.
GRU:t ja kaksisuuntainen toisto
Porttitoiminnallinen toistoyksikkö (GRU) yhdistää porttimekanismit yksinkertaisempaan toistokantaan ilman erillistä LSTM‑tyylistä solutilaa. GRU:t voivat kouluttautua nopeammin ja saavuttaa samankaltaista suorituskykyä joissakin tehtävissä.
Kaksisuuntainen RNN käsittelee valmiin sekvenssin molempiin suuntiin ja yhdistää tilat. Se voi hyödyntää tulevaa kontekstia merkkaamiseen tai koodaukseen, mutta se ei sovellu kausaaliseen suoratoistoon, kun tulevia syötteitä ei ole vielä saatavilla.
Sekvenssi‑sekvenssi -mallit
Kooderi‑dekooderi RNN:t kartoittavat yhden sekvenssin toiseen. Huomio (attention) otettiin käyttöön, jotta dekooderi voi tarkastella eri kooderin tiloja sen sijaan, että se perustuisi yhteen kiinteään vektoriin. Tämä tutkimuslinja johti transformer-arkkitehtuuriin, joka korvasi toiston huomioon‑pohjaisilla lohkoilla.
RNN:t vs. transformerit
Transformerit käsittelevät koulutusasemia rinnakkain ja luovat lyhyet huomion polut kaukaisten tokenien välillä. RNN:t käsittelevät tilan peräkkäin, mikä rajoittaa rinnakkaisuutta, mutta tarjoaa vakiokokoisen toistotilan suoratoiston aikana. Transformer‑inferencia saattaa tarvita kasvavan avain‑arvo‑välimuistin, kun taas RNN tiivistää historian piilotilaansa ja voi menettää yksityiskohtia.
Valinta perustuu sekvenssin pituuteen, datan mittakaavaan, laitteistoon, latenssiin, muistiin ja siihen, onko tehtävä offline‑ vai suoratoisto‑tilassa. Hybrid- ja tilatila‑arkkitehtuurit tarjoavat lisäkompromisseja.
Nykyiset käyttötapaukset
RNN:t ja LSTM:t ovat edelleen merkityksellisiä ennustamiseen, poikkeavuuksien havaitsemiseen, anturien käsittelyyn, puhekomponentteihin, käsinkirjoitukseen, sulautettuun ohjaukseen ja matalan latenssin sekvenssimallinnukseen. Ne eivät ole oletusselitys nykyisille suurille kielimalleille tai AI‑chatboteille.
Toisto, portit ja sekvenssimuisti
Toistuva neuroverkko käsittelee sekvenssiä yhdistämällä nykyisen syötteen piilotilaan, joka kulkee edellisistä vaiheista. Jaetut painot mahdollistavat muuttuvan sekvenssipituuden, ja unrolling paljastaa laskennan ajan yli koulutusta varten. Perus‑RNN:t voivat mallintaa ajallista riippuvuutta, mutta pitkien sekvenssien yli toistuva gradienttien kertominen johtaa usein niiden katoamiseen tai räjähtämiseen. Katkaistu takaisinkytkentä rajoittaa muistia ja laskentaa, kun taas gradienttien leikkaus hallitsee äärimmäisiä päivityksiä. Piilotila on opittu yhteenveto, ei tarkka tallennus jokaisesta aikaisemmasta tokenista.
LSTM‑verkot lisäävät solutilan sekä sisään-, unohtamis- ja ulostulogateja, jotka säätelevät tiedon kirjoittamista, säilyttämistä ja paljastamista. Porttitoiminnalliset toistoyksiköt (GRU) käyttävät yksinkertaisempaa nollaus‑ ja päivitysrakennetta. Kaksisuuntaiset variantit hyödyntävät tulevaa kontekstia, eikä niiden vuoksi voida suoratoistaa kausaalisesti ilman viivettä. Pinottuja, residuaalisia ja huomio‑lisättyjä toistomalleja käytetään kapasiteetin kasvattamiseen. Täyte (padding) ja maskit on estettävä vaikuttamasta tilaan tai häviöön, ja tila tulisi nollata todellisissa sekvenssin rajoissa vuotojen välttämiseksi esimerkkien välillä.
Koulutus, vertailu ja tilallinen palvelu
RNN:t ja LSTM:t ovat edelleen hyödyllisiä suoratoistoon, kompakteihin laitteessa toimiviin malleihin, aikasarjoihin ja työkuormiin, joissa peräkkäinen tila on tehokas. Transformerit rinnakkaistavat koulutuksen ja mallintavat pitkän kantaman vuorovaikutuksia eri tavoin, mutta ne voivat vaatia enemmän muistia ja välimuistia. Vertaa arkkitehtuureja tarkkuuden, latenssin, läpimenon, muistin, tehon ja suorituskyvyn suhteen sekvenssipituuden muuttuessa. Arvioi ennustamista pyörivillä aikajaksoilla, kieltä sekvenssi‑tietoisilla mittareilla ja poikkeavuuksien havaitsemista tapahtumatason mittareilla. Tarkastele epäonnistumisia pitkien aukkojen, toimintaympäristön muutosten, puuttuvien näytteiden ja äkillisten sekvenssirajojen jälkeen.
Tilallinen käyttöönotto on liitettävä piilotila oikeaan istuntoon, vanhentaa se, salata se tarvittaessa ja nollata sen virheiden tai mallin muutosten jälkeen. Järjestyksestä poikkeavat tai kaksinkertaiset tapahtumat voivat korruptoida tilan; sisällytä aikaleimat, sekvenssinumerot ja idempotenssi. Seuraa tilan ikää, sekvenssipituutta, puuttuvuutta, lähtövirtausta ja latenssia. Kvantisointi vaatii porttiherkkää validointia, koska pienet numeeriset muutokset voivat kertyä ajan myötä. RNN‑muisti mahdollistaa kontekstin, mutta se voi myös säilyttää yksityistä tai vanhentunutta tietoa, joten säilytys- ja käyttäjänhallintatoiminnot kuuluvat suunnitteluun.
Käytännön esimerkki: LSTM suoratoistoon anturisekvensseille
Yhtiö käyttää LSTM:ää ennustamaan lyhyen aikavälin kuormitusta viimeaikaisista mittauksista, kalenterista ja säästä. Sekvenssit rakennetaan tiukassa aikajärjestyksessä; piilotila nollataan syöttörajalla, ja täyte (padding) maskataan. Kausittain naiivi- ja gradientti‑boostatut perusmallit verrataan LSTM:ään pyörivien ikkunoiden yli. Testit kattavat puuttuvat aikavälit, viivästetyn sään, lomat, katkoksia ja sekvenssien pituudet, jotka ylittävät tyypillisen koulutuksen.
Suoratoistopalvelu liittää tilan yhteen syöttöön, hylkää järjestyksestä poikkeavat duplikaatit ja vanhentaa tilan pitkien aukkojen tai mallipäivitysten jälkeen. Turvallinen tilastollinen ennuste korvaa lähtön, kun anturit tai tila ovat virheellisiä. Kvantisoitu inferenssi tarkistetaan pitkien sekvenssien aikana kertynyttä virhettä vastaan. Valvonta seuraa tilan ikää, puuttuvuutta, latenssia, harhaa ja aikavälin virhettä. Mallia uudelleenkoulutetaan vain verkon muutosten jälkeen, ja tarkastellut tulokset osoittavat, että opitut ajalliset suhteet eivät enää yleisty.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, lähtötiedot, riippuvuudet, omistaja ja jokaisen tärkeän virheen seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen säätöä. Testaa tavallisia tapauksia, rajaehtoja, virheellisiä tai puuttuvia syötteitä, jakauman muutoksia, riippuvuuksien katkoja, väärinkäyttöä sekä ryhmiä tai ympäristöjä, jotka todennäköisesti jäävät alipalveluiksi. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, latenssin, läpimenon, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnysarvo, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta määritä vastuuhenkilöt julkaisuun, poikkeuksiin, muutoksiin, palautukseen ja poistoon. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista valvonta tarkoituksellisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, lähtökäyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeettomia arkaluontoisia tietoja. Määritä hälytyskynnysarvot ja vastuu, ja tarkastele todellisia todisteita käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina, kun tietolähteet, käyttäjät, mallit, toimittajat, käytännöt, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapaustiedon oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa tai korvata.
Usein kysytyt kysymykset
Onko LSTM aina parempi kuin perus‑RNN?
Ei. Porttitoiminta auttaa monissa pitkän riippuvuuden ongelmissa, mutta lisää laskentaa ja parametreja. Perus‑RNN voi olla riittävä lyhyille, yksinkertaisille sekvensseille, ja toinen arkkitehtuuri voi olla parempi erittäin pitkälle kontekstille.
Voiko LSTM käsitellä rajoittamatonta historiaa?
Ei. Sen tilalla on rajallinen kapasiteetti, gradientit ja koulutusdata asettavat rajoituksia, ja merkitykselliset yksityiskohdat voivat ylikirjoittua. Pitkän kontekstin suorituskyky on mitattava eikä pääteltävä arkkitehtuurin nimestä.
Ensisijaiset viitteet