
Andersonin kulma
Nvidian eDiffi-diffuusiomalli mahdollistaa “maalaamisen sanoilla” ja paljon muuta

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
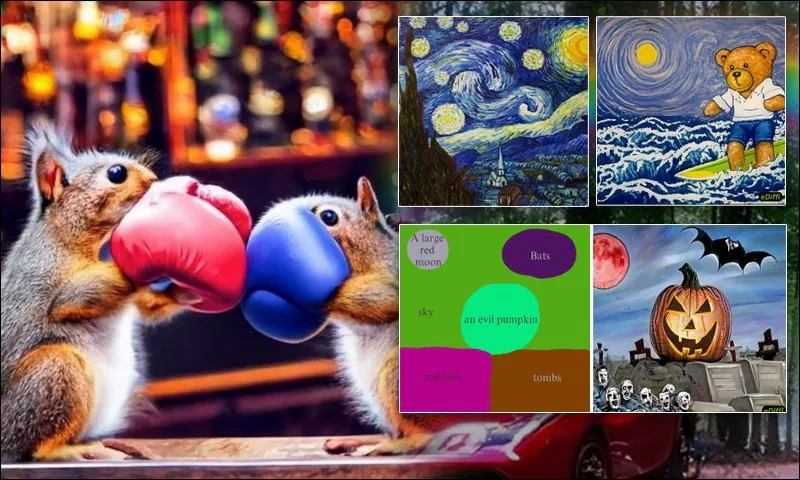
Keskeiset kohdatNVIDIAn eDiffi käyttää asiantuntijakohinanpoistajien kokonaisuutta parempaan tekstistä…
Näytä lisää
- NVIDIAn eDiffi käyttää asiantuntijakohinanpoistajien kokonaisuutta parempaan tekstistä kuvaksi -ohjaukseen.
- Malli integroi T5- ja CLIP-kooderit parantaakseen hienojakoisia yksityiskohtia ja kokonaiskompositiota.
- eDiffi mahdollistaa maalaamisen sanoilla yhdistämällä värit kehotuksen elementteihin tarkan asettelun saavuttamiseksi.
Tarkkojen sommitelmien luominen latentti-diffuusiogeneratiivisilla kuvamalleilla, kuten Stable Diffusion, voi olla kuin kissojen ajamista; samoja mielikuvituksen ja tulkinnan kykyjä, joilla järjestelmä luo poikkeuksellisia yksityiskohtia ja kuvia melko yksinkertaisista tekstikehotteista, on myös vaikea sammuttaa, kun kuvan luomista halutaan ohjata Photoshopin tarkkuudella.
Nyt, NVIDIA (NVDA ) -tutkimuksen esittämä uusi lähestymistapa, joka on nimeltään ensemble-diffuusio kuville (eDiffi), käyttää useita upotus- ja tulkintamenetelmiä (sen sijaan, että sama menetelmä olisi koko putken ajan) jotta luotua sisältöä voidaan hallita huomattavasti tarkemmin. Esimerkiksi alla olevassa kuvassa käyttäjä maalaa alueita, joissa jokainen väri edustaa yhtä sanaa tekstipromptista:
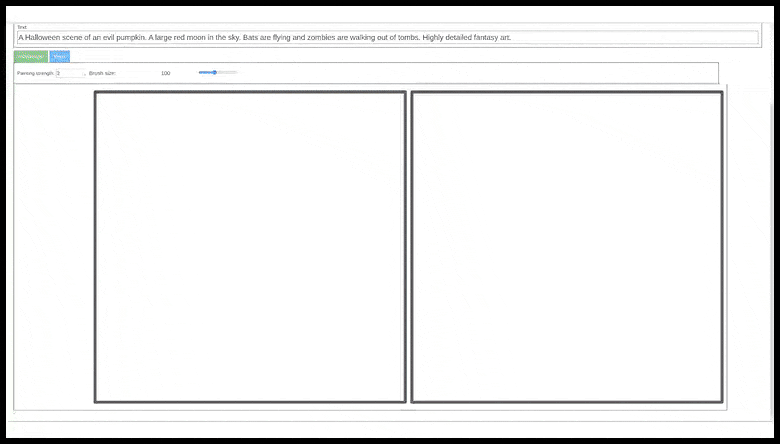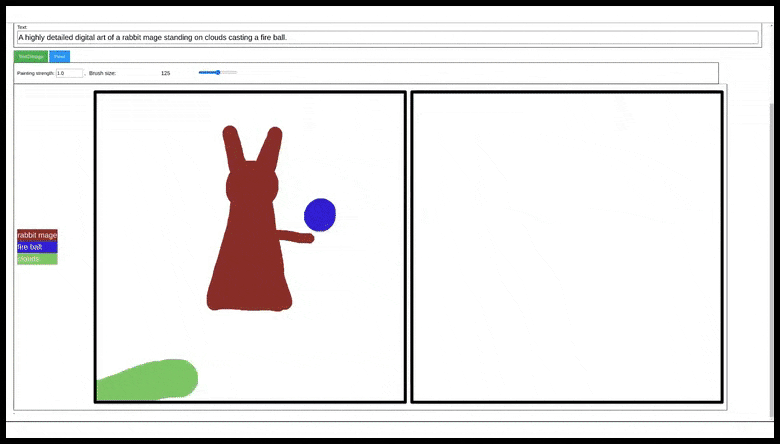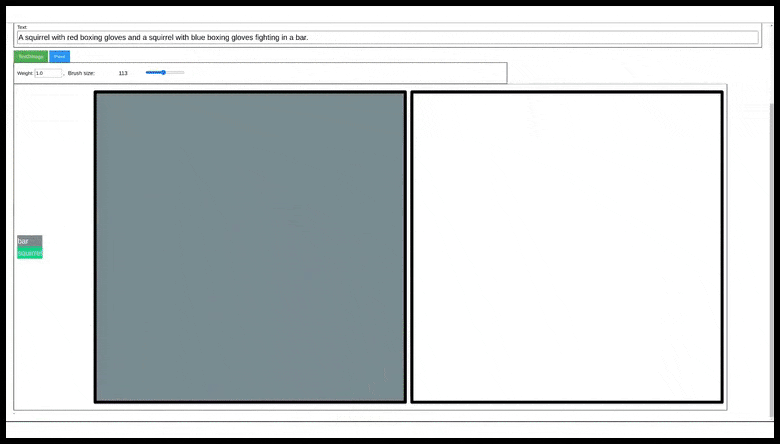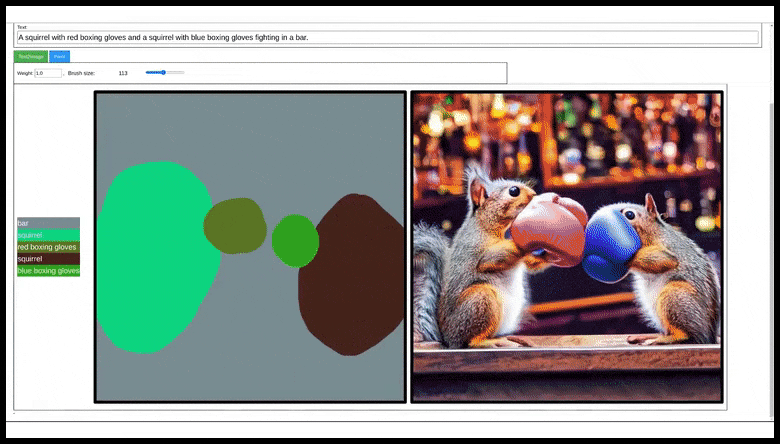
‘Maalaaminen sanoilla’ on yksi kahdesta uudesta kyvystä Nvidian eDiffi-diffuusiomallissa. Jokainen maalattu väri edustaa sanaa promptista (näe ne esiintyvät vasemmalla puolella luomisen aikana), ja sovellettu alueen väri koostuu vain kyseisestä elementistä. Katso virallinen video, jossa on enemmän esimerkkejä ja parempi resoluutio osoitteessa https://www.youtube.com/watch?v=k6cOx9YjHJc
Tämä on käytännössä “maalaaminen maskeilla”, ja kääntää Stable Diffusionin inpainting-paradigman ylösalaisin, joka perustuu korjaamaan rikkoontuneita tai epätarkoituksenmukaisia kuvia tai laajentamaan kuvia, jotka voisivat olla haluttu koko alusta alkaen.
Tässä maalatun värialueen reunat määrittävät yhden käsitteen yksittäisen elementin sallitut likimääräiset rajat. Käyttäjä voi siis määrittää lopullisen kuvapinnan koon heti alussa ja lisätä elementit erikseen.

Esimerkkejä uudesta tutkimuksesta. Lähde: https://arxiv.org/pdf/2211.01324.pdf
eDiffin käyttämät moninaiset menetelmät tarkoittavat myös, että järjestelmä tekee paljon paremman työn sisällyttäessä jokaisen elementin pitkiin ja yksityiskohtaisiin prompteihin, kun taas Stable Diffusion ja OpenAI:n DALL-E 2 priorisoi tiettyjä osia promptista, riippuen siitä, miten aikaisin kohde-sanat ilmaantuvat promptissa, tai muista tekijöistä, kuten mahdollisesta vaikeudesta erottaa eri elementtejä, jotka ovat tarpeen täydellisen ja kattavan (suhteessa tekstipromptiin) sommitelmuksen luomiseksi:

Tutkimuksesta: eDiffi pystyy käymään kehotteen tarkemmin läpi, kunnes mahdollisimman moni elementti on tuotettu. Vaikka parannetut tulokset eDiffille (oikeanpuoleisin sarake) ovat valikoituja, myös vertailukuvat Stable Diffusionista ja DALL-E 2:sta ovat valikoituja.
Lisäksi omistetun T5-teksti-teksti-encoderin käyttö mahdollistaa eDiffille luoda ymmärrettävää englannin kieltä, joko abstraktina pyynnöltä promptista (esim. kuvassa on tekstiä [x]) tai eksplisiittisesti pyydettynä (esim. t-paita sanoo ‘Nvidia Rocks’):

Omistettu teksti-teksti-prosessointi eDiffissä tarkoittaa, että teksti voidaan renderöidä sanasta sanaan kuvissa, sen sijaan, että se suoritettaisiin vain teksti-kuva-tulkintakerroksen kautta, joka vääristää tulosta.
Uuden kehyksen lisäetuna on mahdollista antaa yksittäinen kuva tyyli-prompttina, sen sijaan, että tarvitsisi kouluttaa DreamBooth-mallia tai tekstuaalista upotusta useista esimerkeistä genrestä tai tyylistä.

Tyyli-siirto voidaan soveltaa viitekuvasta teksti-kuva-prompttiin tai jopa kuva-kuva-prompttiin.
Uusi tutkimus on nimeltään eDiffi: Teksti-kuva-diffuusiomallit asiantuntija-denoisereiden joukolla, ja
T5-teksti-encoderi
Googlen Text-to-Text Transfer Transformer (T5) -mallin käyttö on ratkaiseva elementti parannetuissa tuloksissa, jotka on havaittu eDiffissä. Keskimääräinen latentti-diffuusioputki keskittyy yhdistämään opetusaineiston kuvat niihin liittyviin kuvateksteihin (joko internetistä poimittuina tai myöhemmin manuaalisesti mukautettuina, vaikka tämä on kallista ja siten harvinaista).

Heinäkuun 2020 tutkimuksesta T5 – tekstipohjaiset muunnokset, jotka voivat auttaa generatiivista kuvavirran työssä eDiffissä (ja mahdollisesti muissakin latentti-diffuusiomalleissa). Lähde: https://arxiv.org/pdf/1910.10683.pdf
Lähtötekstin uudelleenmuokkaamalla ja suorittamalla T5-moduuli, voidaan saada tarkemmat yhdistymiset ja edustukset kuin ne, jotka on koulutettu malliin alun perin, melkein kuin post facto manuaalinen merkintä, suuremmalla tarkkuudella ja soveltuvuudella tekstipromptin määräyksiin.
Kirjoittajat selittävät:
‘Useimmissa olemassa olevissa tutkimuksissa diffuusiomalleista denoising-malli on jaettu kaikille melun tasolle, ja aikadynamiikka edustetaan yksinkertaisella aikaupottumalla, joka syötetään denoising-malliin MLP-verkon kautta. Väitämme, että kohinanpoistodiffuusion monimutkaista ajallista dynamiikkaa ei ehkä voida oppia datasta tehokkaasti yhdellä jaetulla mallilla, jonka kapasiteetti on rajallinen.
‘Sen sijaan, ehdotamme denoising-mallin kapasiteetin kasvattamista esittämällä asiantuntija-denoisereiden joukon; jokainen asiantuntija-denoiser on denoising-malli, joka on erikoistunut tiettyyn kohinatasojen vaihteluväliin. Tällä tavoin voidaan lisätä mallin kapasiteettia ilman, että se hidastaa näytteenottoa, koska jokaisen melun tasolla suoritettavan prosessoinnin laskennallinen monimutkaisuus säilyy samana.’

Käsitteellinen arkkitehtuuri eDiffille.
Olemassa olevat CLIP-koodausmodulit, jotka ovat osa DALL-E 2:ta ja Stable Diffusionia, pystyvät myös löytämään vaihtoehtoisia kuvatulkintoja tekstiin, joka liittyy käyttäjän syötteeseen. Ne kuitenkin koulutetaan samalla tiedolla kuin alkuperäinen malli, eivätkä ne ole käytössä erillisenä tulkintakerroksena eDiffin tapaan.
Kirjoittajat toteavat, että eDiffi on ensimmäinen kerta, kun sekä T5- että CLIP-encoder on otettu yhteen putkeen:
’Nämä kaksi koodausta ovat koulutettu eri tavoitteilla, ja niiden upotukset suosivat eri kuvien muodostumista samasta syötteestä. Vaikka CLIP-teksti-upotukset auttavat määrittämään luodun kuvan yleisen ulkonäön, ne usein jättävät puuttumaan yksityiskohtaiset tiedot tekstistä.
’Toisaalta, T5-teksti-upotusten kanssa luodut kuvat heijastavat paremmin yksittäisiä esineitä, jotka on kuvattu tekstissä, mutta niiden yleinen ulkonäkö on vähemmän tarkka. Niiden yhteinen käyttö tuottaa parhaat kuvanluontitulokset mallissamme.’
Diffuusion prosessin keskeyttäminen ja täydentäminen
Tutkimus toteaa, että tyypillinen latentti-diffuusiomalli aloittaa matkan puhtaasta kohinasta kuvaksi riippuen pelkästään tekstistä varhaisessa vaiheessa luomisprosessia.
Kun melu muuttuu joksikin karkeaksi sommitelmuksi, joka edustaa tekstipromptin kuvausta, tekstiohjattu prosessi käytännössä loppuu, ja prosessi siirtyy visuaalisten ominaisuuksien täydentämiseen.
Tämä tarkoittaa, että mikä tahansa elementti, jota ei ratkaistu tekstiohjatun melun tulkinnan alkuvaiheessa, on vaikea injektoida kuvaan myöhemmin, koska nämä kaksi prosessia (teksti-sommitelma ja sommitelma-kuva) ovat suhteellisen vähän limittäin, ja perussommitelma on melko sekoittunut, kun se saapuu kuvan täydentämiseen.

Tutkimuksesta: eri osien huomio-kartat putken aikana, kun melu muuttuu kuvaksi. Voidaan nähdä, kuinka CLIP:n vaikutus kuvassa laskee nopeasti alempaan riviin, kun taas T5 jatkaa vaikuttamista kuvan luomisprosessiin paljon pidempään.
Ammattimainen potentiaali
Esimerkit projektisivulla ja YouTube-videossa keskittyvät PR-ystävällisiin, meme-mäisiin, söpöihin kuvien luomiseen. Kuten tavallisesti, Nvidian tutkimus vähättelee uusimman innovaation potentiaalia parantaa fotorealistisia tai VFX-työvirran kuvia, sekä parantaa deepfake-kuvien ja -videoiden laatua.
Esimerkeissä, aloittelija tai harrastaja käyttäjä piirtää karkeat ääriviivat sijoittelulle tietyn elementin osalta, kun taas järjestelmällisemmässä VFX-työvirrassa eDiffiä voisi käyttää useiden videoframejen tulkintaan teksti-kuvaksi, jossa ääriviivat ovat hyvin tarkkoja ja perustuvat esimerkiksi hahmoihin, joista tausta on poistettu vihreän näytön tai algoritmisten menetelmien avulla.

Runway ML tarjoaa jo nyt AI-pohjaisen rotoskooppauksen. Tässä esimerkissä ‘vihreä näyttö’ aiheen ympärillä edustaa alfa-kerrosta, ja poisto on tehty koneoppimismenetelmällä, ei algoritmisen vihreän näytön taustan poistamisella. Lähde: https://twitter.com/runwayml/status/1330978385028374529
Käyttämällä koulutettua DreamBooth-hahmoa ja kuva-kuvaksi-pipelinea eDiffin kanssa, on mahdollista aloittaa yksi minkä tahansa latenttidiffuusiomallin keskeisistä haasteista: ajallinen vakaus. Tässä tapauksessa sekä asetetun kuvan reunat että kuvan sisältö olisivat ‘esiohjattu’ käyttäjän kankaalle, ja ajallinen jatkuvuus renderöidystä sisällöstä (esim. muuttaminen oikeasta maailman Tai Chi -harjoittelijasta robottiin) olisi turvattu lukittavalla DreamBooth-mallilla, joka on ‘muistanut’ koulutusdatansa – huono tulkittavuudelle, mutta hyvä toistettavuudelle, alkuperäisen sisällön säilymiselle ja jatkuvuudelle.
Menetelmä, data ja testit
Tutkimus toteaa, että eDiffi-malli koulutettiin ‘julkisten ja yksityisten aineistojen kokoelmalla’, joka on voimakkaasti suodatettu esikoulutetulla CLIP-mallilla, jotta poistettaisiin kuvat, jotka voivat alentaa yleisen esteettisen arvosanan tuloksissa. Lopullinen suodatettu kuva-aineisto koostuu ‘noin miljardista’ teksti-kuva-parista. Koulutettujen kuvien koko on kuvattu ‘lyhyimmän sivun ollessa yli 64 pikseliä’.
Monta mallia koulutettiin prosessille, ja sekä perus- että super-resoluutio-mallit koulutettiin AdamW-optimoinnilla oppimisnopeudella 0,0001, painoja rapauttamalla 0,01, ja vaikuttavalla batch-koolle 2048.
Perusmalli koulutettiin 256 Nvidian A100-grafiikkaprosessorilla, ja kaksi super-resoluutio-mallia 128 Nvidian A100-grafiikkaprosessoreilla kullekin mallille.
Järjestelmä perustui Nvidian omalle Imaginaire-PyTorch-kirjastoon. COCO– ja Visual Genome -aineistot käytettiin arviointiin, vaikka ne eivät sisälly lopullisiin malleihin, ja MS-COCO oli tarkempi variantti, jota käytettiin testaamiseen. Vastakkaiset järjestelmät, joita testattiin, olivat GLIDE, Make-A-Scene, DALL-E 2, Stable Diffusion, ja Google:n kaksi kuvasynteesijärjestelmää, Imagen ja Parti.
Aikaisempien tutkimusten mukaisesti, työssä käytettiin zero-shot FID-30K:ta arviointimittarina. FID-30K:ssa 30 000 kuvatekstiä poimitaan satunnaisesti COCO:n validointijoukosta (ts. ei kuvia tai tekstiä, joita käytettiin koulutuksessa), ja ne käytettiin teksti-promptteina kuvien synteesiin.
Frechet Inception -etäisyys (FID) luoduista ja todellisista kuvista laskettiin, ja samalla tallennettiin CLIP-pisteet luoduille kuville.

Tulokset zero-shot FID-testeistä nykyisiin huipputasoihin COCO 2014 -validointijoukossa, jossa alempi tulos on parempi.
Tuloksissa eDiffi pystyi saavuttamaan alhaisimman (parhaimman) tuloksen zero-shot FID:llä, jopa järjestelmiin verrattuna, joissa on paljon enemmän parametrejä, kuten Parti, jossa on 20 miljardia parametrejä, verrattuna eDiffi-malliin, jossa on 9,1 miljardia parametrejä.
Johtopäätös
Nvidian eDiffi edustaa tervetullutta vaihtoehtoa yksinkertaisesti lisäämällä enemmän ja enemmän dataa ja monimutkaisuutta olemassa oleviin järjestelmiin, sen sijaan käyttäen älykkäämpää ja kerroksellisempaa lähestymistapaa joillekin haasteellisimmista esteistä, jotka liittyvät sekoittumiseen ja muokkaamattomuuteen latentti-diffuusiogeneratiivisissa kuvajärjestelmissä.
On jo keskustelua Stable Diffusionin subreddit- ja Discord-keskusteluissa siitä, tulisiko eDiffin koodia ottaa suoraan käyttöön tai tulisiko sen periaatteita uudelleen toteuttaa erillisessä toteutuksessa. Uusi putki on kuitenkin niin radikaalisti erilainen, että se edustaisi kokonaan uuden versionmuutoksen SD:lle, joka hylkäisi osan taaksepäin yhteensopivuudesta, mutta tarjoaisi mahdollisuuksia huomattavasti parannetuille tasolle lopullisen synteettisen kuvan hallintaa ilman latentti-diffuusion mielikuvituksellisten voimien uhraamista.
Julkaistu ensimmäisen kerran 3. marraskuuta 2022.


