
Andersonin kulma
Kolme Stable Diffusionin edessä olevaa haastetta

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Keskeiset kohdatStable Diffusion kamppailee ihmisten raajojen kanssa riittämättömän yksityiskohtaisten…
Näytä lisää
- Stable Diffusion kamppailee ihmisten raajojen kanssa riittämättömän yksityiskohtaisten harjoitusdata-merkintöjen vuoksi.
- Laatupohjaiset suurennostusmenetelmät saattavat tuottaa epäyhtenäisiä kuvia ilman laajempaa kontekstuaalista tietoisuutta.
- Mallin 512x512 -natiiviresoluutio rajoittaa tulosteen laatua ja vaatii monimutkaisia kiertotapoja.
Parin viikon takainen julkaisu stability.ai-yhtiön Stable Diffusion -mallista, joka perustuu latenttidiffuusioon , saattaa olla yksi merkittävimmistä teknologisista julkistuksista vuoden 1999 DeCSS:n jälkeen; se on varmasti suurin tekoälyllä tuotettujen kuvien tapahtuma sen jälkeen, kun vuonna 2017 deepfake-koodi kopioitiin GitHubiin ja siitä haarautuivat sittemmin DeepFaceLab ja FaceSwapsekä reaaliaikaiseen deepfake-suoratoistoon tarkoitettu DeepFaceLive.
Kertaheitolla käyttäjien turhautuminen DALL-E 2:n kuvantuotantorajapinnan sisältörajoituksiin pyyhkäistiin syrjään, kun kävi ilmi, että Stable Diffusionin NSFW-suodattimen sai pois käytöstä muuttamalla yhden ainoan koodirivin. Pornografiaan keskittyneitä Stable Diffusion -Reddit-yhteisöjä syntyi lähes välittömästi, ja ne suljettiin yhtä nopeasti. Kehittäjät ja käyttäjät jakautuivat Discordissa virallisiin ja NSFW-yhteisöihin, ja Twitter alkoi täyttyä mielikuvituksellisista Stable Diffusion -luomuksista.
Järjestelmää käyttäviltä kehittäjiltä näyttää nyt tulevan päivittäin hämmästyttäviä innovaatioita. Lisäosia ja kolmansien osapuolten laajennuksia kirjoitetaan kiireesti esimerkiksi seuraaviin ohjelmiin: Krita, Photoshop, Cinema4D, Blender, sekä monille muille sovellusalustoille.
Samaan aikaan kehotteiden muotoilu – nykyisin ammattimainen ”tekoälylle kuiskaamisen” taito, josta voi tulla lyhytikäisin ammatti sitten Filofax-kansion kokoajan – on jo kaupallistumassa, ja Stable Diffusionin varhainen kaupallistaminen tapahtuu Patreon-tasolla. Kehittyneempiä palveluja on varmasti tulossa niille, jotka eivät halua perehtyä Conda-pohjaisiin lähdekoodiasennuksiin tai verkkototeutusten rajoittaviin NSFW-suodattimiin.
Kehitys ja käyttäjien vapaa kokeilu etenevät niin huimaa vauhtia, että pitkälle tulevaisuuteen on vaikea nähdä. Emme pohjimmiltaan vielä tarkasti tiedä, minkä kanssa olemme tekemisissä tai mitkä kaikki rajat ja mahdollisuudet ovat.
Tarkastellaan silti kolmea ehkä kiinnostavinta ja haastavinta estettä, jotka nopeasti muodostuneen ja kasvavan Stable Diffusion -yhteisön on kohdattava ja toivottavasti voitettava.
1: Laattapohjaisten käsittelyketjujen optimointi
Rajalliset laitteistoresurssit ja koulutuskuvien resoluution tiukat rajat kannustavat kehittäjiä todennäköisesti etsimään kiertoteitä Stable Diffusionin tulosten laadun ja resoluution parantamiseen. Monissa hankkeissa hyödynnettäneen järjestelmän rajoituksia, esimerkiksi vain 512×512 pikselin natiiviresoluutiota.
Kuten konenäkö- ja kuvansynteesihankkeissa yleensä, Stable Diffusion koulutettiin neliökuvilla, jotka tässä tapauksessa uudelleennäytteistettiin kokoon 512×512. Näin lähdekuvat voitiin yhdenmukaistaa ja sovittaa mallin kouluttaneiden grafiikkasuorittimien rajoihin.
Siksi Stable Diffusion ”ajattelee”, jos se ylipäätään ajattelee, 512×512-muodossa ja ainakin neliöinä. Järjestelmän rajoja kokeilevat käyttäjät kertovat sen tuottavan luotettavimmat ja vähiten virheitä sisältävät tulokset tällä melko rajoitetulla kuvasuhteella (katso raajojen käsittely jäljempänä).
Monet toteutukset tarjoavat ylösskaalauksen RealESRGAN -järjestelmällä (ja voivat korjata huonosti muodostuneita kasvoja GFPGANilla) , mutta useat käyttäjät kehittävät parhaillaan menetelmiä kuvien jakamiseksi 512×512 pikselin osiin ja yhdistämiseksi suuremmiksi kokonaisuuksiksi.

Tämä 1024×576-kuva, jonka resoluutio on tavallisesti mahdoton yhdellä Stable Diffusion -generoinnilla, luotiin kopioimalla attention.py-Python-tiedosto DoggettX -haarasta toiseen Stable Diffusion -haaraan. Kyseinen versio toteuttaa laattapohjaisen ylösskaalauksen. Lähde: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Osa tällaisista hankkeista käyttää omaa koodia tai muita kirjastoja, mutta GOBIGin txt2imghd-siirroksen odotetaan tuovan toiminnallisuuden pian päähaaraan. GOBIG on paljon näyttömuistia kuluttavan ProgRockDiffusionin tila. txt2imghd on erityinen GOBIG-siirros, kun taas muut yhteisökehittäjät toteuttavat GOBIGia eri tavoin.

Sopivan abstrakti kuva alkuperäisenä 512×512-versiona (vasemmalla ja toisena vasemmalta); ESGRANilla ylösskaalattuna, mikä on nykyisin lähes kaikkien Stable Diffusion -jakelujen vakio-ominaisuus; ja GOBIG-toteutuksen ”erityishuomiolla” käsiteltynä. Ainakin kuvan rajatun osan sisällä yksityiskohdat näyttävät skaalautuvan paremmin. Lähde: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Yllä olevan abstraktin esimerkin monet pienet yksityiskohtien ”valtakunnat” sopivat tähän vain omaa osaansa tarkastelevaan skaalaustapaan. Yhtenäinen, toistumaton ylösskaalaus voi kuitenkin vaatia haastavampia koodipohjaisia ratkaisuja, jotta tulos ei näytä monista osista kootulta. Tämä koskee erityisesti ihmiskasvoja, joiden poikkeamat ja häiritsevät artefaktit huomaamme poikkeuksellisen herkästi. Kasvot saattavat siksi lopulta tarvita oman ratkaisunsa.
Stable Diffusionissa ei nyt ole mekanismia, joka keskittäisi huomion kasvoihin generoinnin aikana kuten ihminen painottaa kasvojen tietoja. Vaikka osa Discord-yhteisöjen kehittäjistä pohtii tällaisen tehostetun huomion toteuttamista, kasvoja on toistaiseksi paljon helpompi parantaa käsin ja myöhemmin automaattisesti alkuperäisen generoinnin jälkeen.
Ihmiskasvoilla on sisäinen, ehjä semanttinen logiikka, jota ei löydy vaikkapa rakennuksen alakulman laatasta. Siksi Stable Diffusionin luonnosmaisia kasvoja voidaan nyt tehokkaasti suurentaa ja generoida uudelleen.

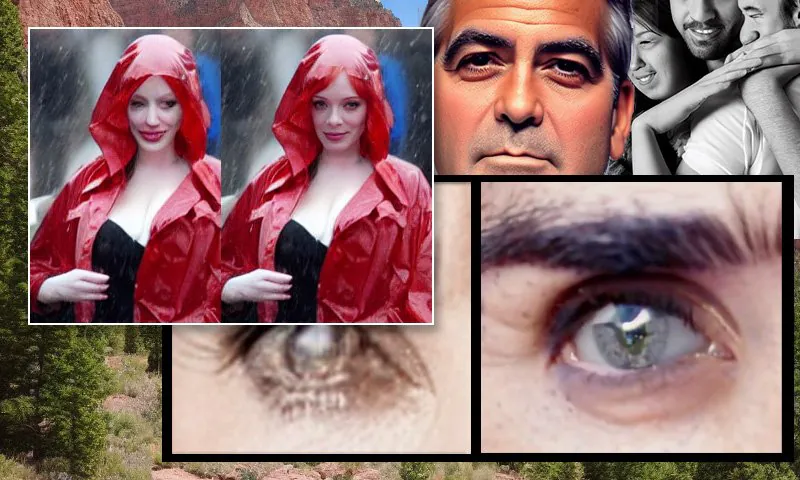
Vasemmalla Stable Diffusionin ensimmäinen yritys kehotteella ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’. Oikealla parannetut kasvot: ensimmäisen kuvan sumeat ja luonnosmaiset kasvot syötettiin Img2Img-toiminnolla takaisin Stable Diffusionin koko huomion kohteeksi (katso animaatiot jäljempänä).
Ilman erillistä Textual Inversion -ratkaisua (katso jäljempänä) tämä toimii vain julkisuuden henkilöillä, jotka ovat jo hyvin edustettuina Stable Diffusionin koulutuksessa käytetyissä LAION-osajoukoissa. Menetelmä toimii siis esimerkiksi Tom Cruisen, Brad Pittin ja Jennifer Lawrencen kaltaisilla tähdillä sekä rajallisella joukolla muita mediakuuluisuuksia, joista lähdedatassa on paljon kuvia.
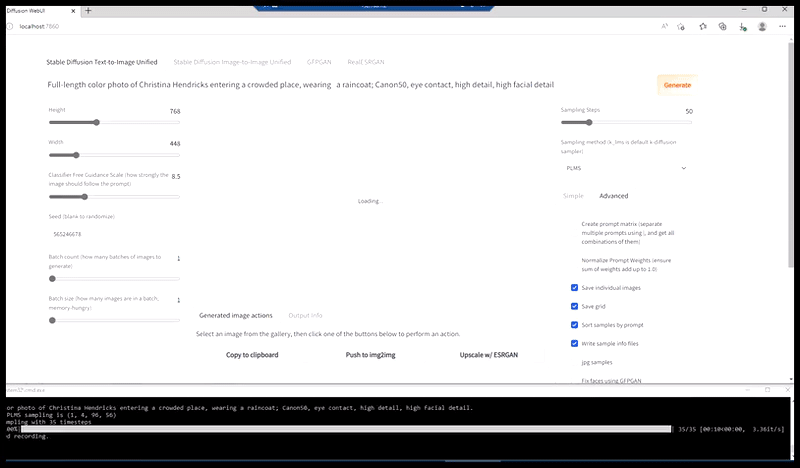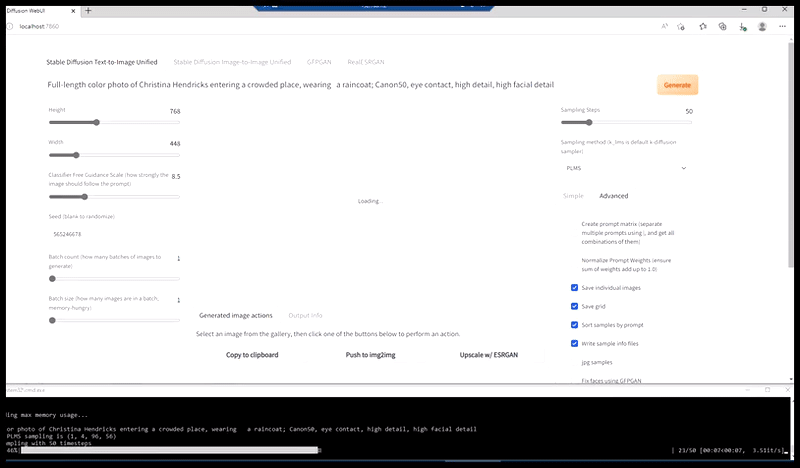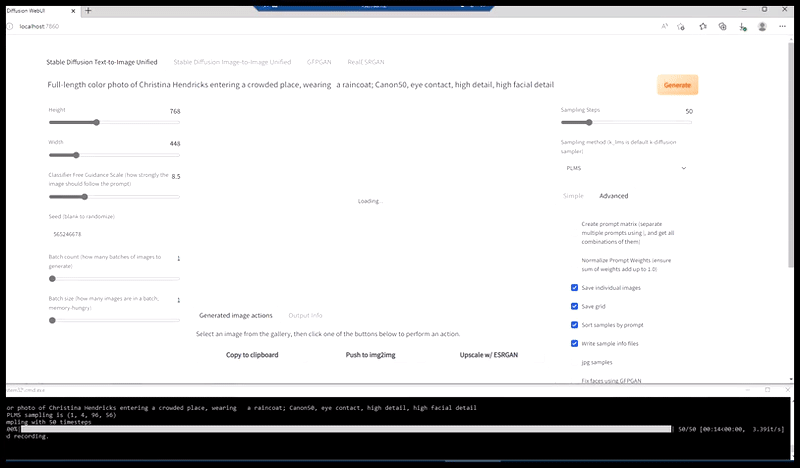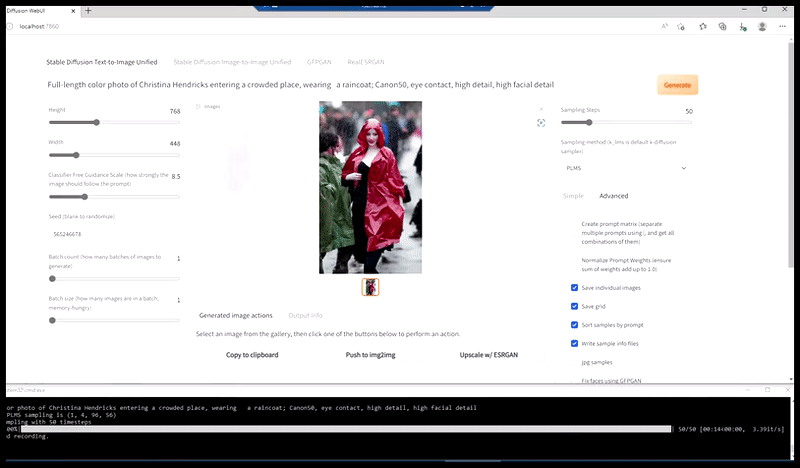
Uskottavan lehtikuvan generointi kehotteella ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’.
Pitkän uran tehneistä julkisuuden henkilöistä Stable Diffusion tuottaa yleensä kuvan viimeaikaisessa eli vanhemmassa iässä. Nuorekkaampia kuvia varten kehotteeseen on lisättävä esimerkiksi ‘young’ tai ‘in the year [YEAR]’ .

Näyttelijä Jennifer Connelly on tehnyt lähes 40 vuoden mittaisen näkyvän, runsaasti kuvatun ja tasaisen uran. Hän on yksi harvoista LAIONin julkisuuden henkilöistä, joita Stable Diffusion pystyy esittämään eri ikäisinä. Lähde: paikallinen valmispakattu Stable Diffusion, v1.4-tarkistuspiste; ikään liittyvät kehotteet.
Tämä johtuu suurelta osin digitaalisen lehtikuvauksen yleistymisestä 2000-luvun puolivälistä alkaen kalliin filmipohjaisen kuvauksen sijaan sekä myöhemmästä kuvamäärien kasvusta laajakaistayhteyksien nopeutuessa.
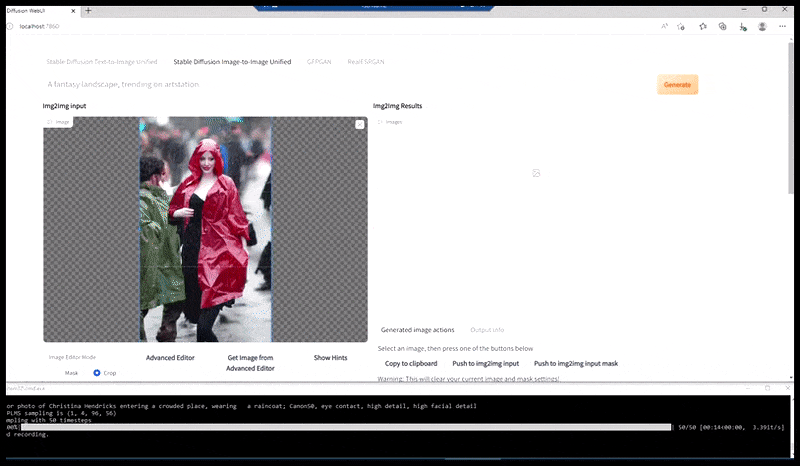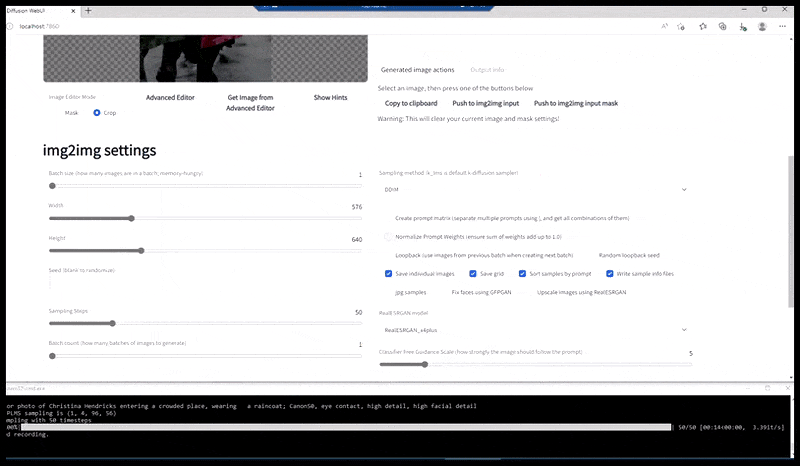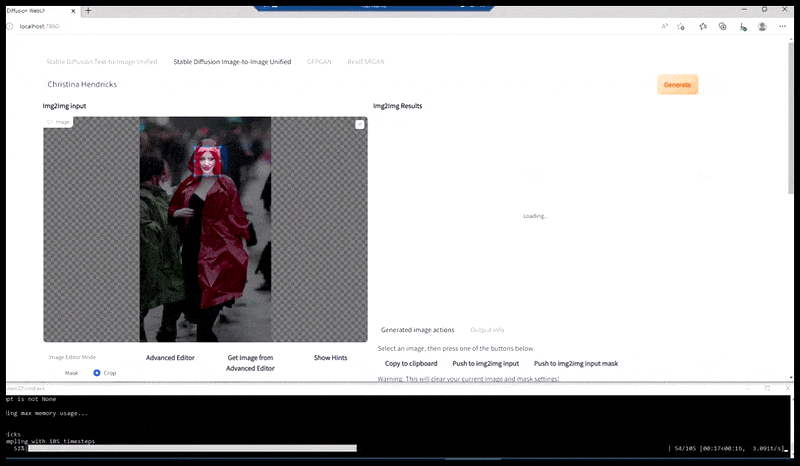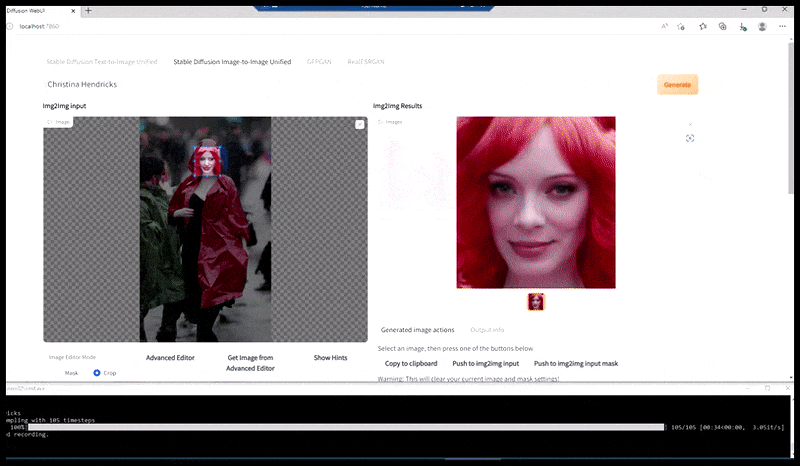
Generoitu kuva siirretään Stable Diffusionin Img2Img-toimintoon, jossa valitaan kohdealue. Vain tästä alueesta tehdään uusi suurimman koon generointi, jolloin kaikki käytettävissä olevat resurssit voidaan keskittää kasvojen uudelleenluontiin.
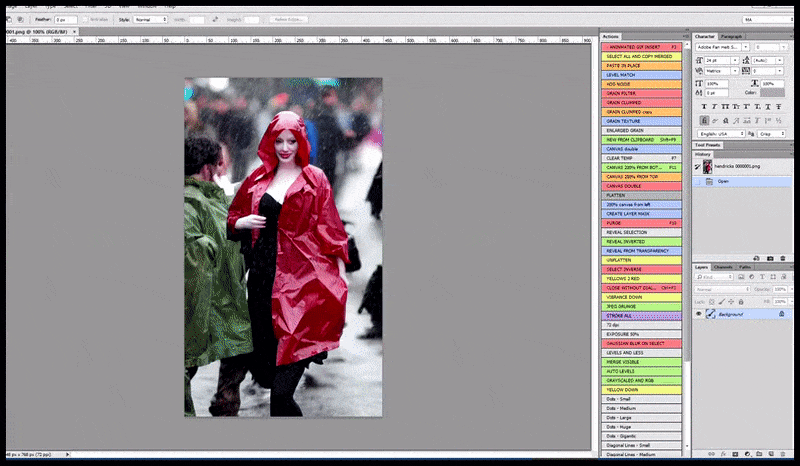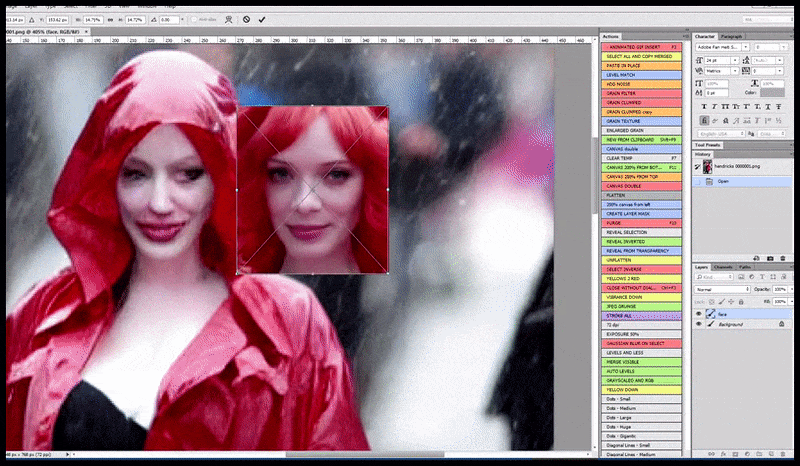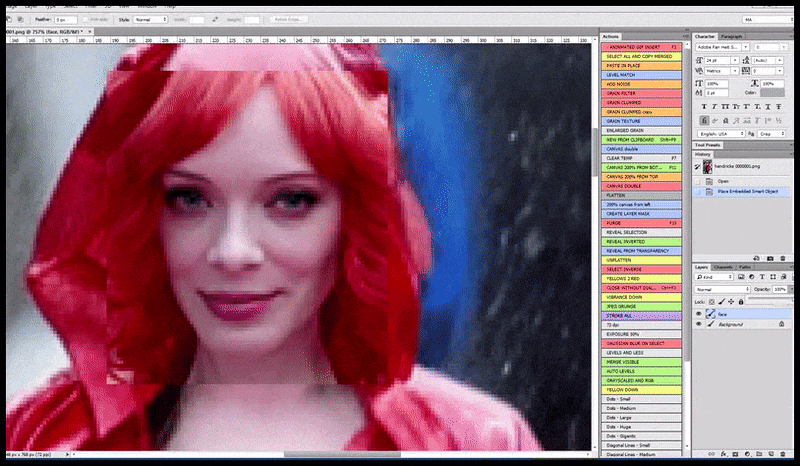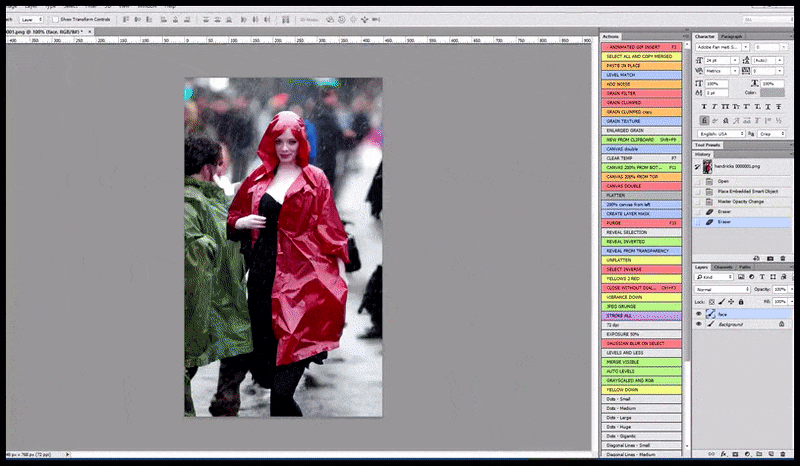
Tehostetulla huomiolla tuotetut kasvot yhdistetään takaisin alkuperäiseen kuvaan. Kasvojen lisäksi tämä toimii vain kohteilla, joilla on tunnettu, yhtenäinen ja ehjä ulkoasu, kuten alkuperäisen kuvan erillisellä kellolla tai autolla. Esimerkiksi seinän osan ylösskaalaus johtaa hyvin oudon näköiseen koottuun seinään, koska laattageneroinneilla ei ollut tämän ”palapelin palan” laajempaa asiayhteyttä.
Jotkin tietokannan julkisuuden henkilöt ovat ikään kuin valmiiksi pysähtyneet aikaan: he kuolivat nuorina, kuten Marilyn Monroe, tai olivat suuren yleisön tietoisuudessa vain lyhyen aikaa, jolloin heistä syntyi paljon kuvia rajatulla ajanjaksolla. Stable Diffusionin kysely voisi siis toimia eräänlaisena nykyisten ja vanhempien tähtien tämänhetkisenä suosioindeksinä. Joistakin entisistä ja nykyisistä kuuluisuuksista ei ole tarpeeksi lähdekuvia hyvään yhdennäköisyyteen, mutta tiettyjen kauan sitten kuolleiden tai muuten unohtuneiden tähtien pysyvä suosio mahdollistaa kohtuullisen yhdennäköisyyden.

Stable Diffusionin tulokset paljastavat nopeasti, ketkä tunnetut kasvot ovat hyvin edustettuina koulutusdatassa. Vaikka Millie Bobby Brown on kirjoitushetkellä vanhempana teini-ikäisenä valtavan suosittu, hän oli nuorempi ja vähemmän tunnettu LAION-aineistojen verkkokeruun aikaan. Siksi laadukas yhdennäköisyys on nyt vaikea saavuttaa.
Kun dataa on saatavilla, laattapohjaiset resoluutionparannukset voisivat mennä kasvoihin keskittymistä pidemmälle. Kasvonpiirteet voitaisiin pilkkoa ja paikallisten grafiikkasuorittimien koko teho kohdistaa merkittäviin piirteisiin yksitellen ennen uudelleenyhdistämistä. Tämäkin on tällä hetkellä käsityötä.

Menetelmä ei rajoitu kasvoihin, mutta se rajoittuu kohteen osiin, joiden sijainti on yhtä ennustettava kokonaisuuden laajemmassa yhteydessä ja jotka vastaavat suurista aineistoista kohtuudella odotettavia korkean tason upotuksia.
Todellinen raja on aineiston vertailudatan määrä. Lopulta pitkälle toistetut yksityiskohdat muuttuvat kokonaan ”hallusinoiduiksi” eli kuvitteellisiksi ja vähemmän aidoiksi.
Tällaiset hienojakoiset suurennukset toimivat Jennifer Connellylla, koska hän on eri ikäisenä hyvin edustettuna LAION-aesthetics -aineistossa, joka on Stable Diffusionin käyttämän LAION 5B -aineiston tärkein osajoukko, sekä yleisemmin LAIONissa. Monissa muissa tapauksissa datan puute heikentäisi tarkkuutta ja vaatisi joko hienosäätöä eli lisäkoulutusta (katso Mukauttaminen jäljempänä) tai Textual Inversion -menetelmää.
Laatat ovat tehokas ja melko halpa tapa tuottaa Stable Diffusionilla korkean resoluution kuvia. Ilman laajempaa, korkeamman tason huomiomekanismia tällainen algoritminen ylösskaalaus voi silti jäädä toivotuista laatuvaatimuksista monissa sisältötyypeissä.
2: Ihmisen raajojen ongelmien käsittely
Stable Diffusion ei ole nimensä mukaisen vakaa ihmisen raajojen monimutkaisuuden kuvaamisessa. Käsiä voi ilmestyä lisää satunnaisesti, sormet sulautuvat yhteen, kolmas jalka ilmestyy pyytämättä ja olemassa olevat raajat katoavat jäljettömiin. Sen puolustukseksi sama vaivaa muitakin alan järjestelmiä ja aivan varmasti DALL-E 2:ta.

Muokkaamattomia DALL-E 2:n ja Stable Diffusion 1.4:n tuloksia elokuun 2022 lopulta. Molemmissa on raajojen ongelmia. Kehote on ‘A woman embracing a man’.
Stable Diffusionin seuraajat, jotka toivovat tulevan 1.5-tarkistuspisteen ratkaisevan raajasekaannuksen, pettynevät. Se on perusteellisemmin koulutettu versio paremmilla parametreilla. Uusi malli julkaistaan noin kahden viikon kuluttua, mutta sitä esitellään jo stability.ai-yhtiön kaupallisessa DreamStudio-palvelussa. Se käyttää oletuksena 1.5:tä, ja käyttäjät voivat verrata tuloksia paikallisten tai muiden 1.4-järjestelmiensä generointeihin:

Lähde: paikallinen 1.4-valmispaketti ja https://beta.dreamstudio.ai/

Lähde: paikallinen 1.4-valmispaketti ja https://beta.dreamstudio.ai/

Lähde: paikallinen 1.4-valmispaketti ja https://beta.dreamstudio.ai/
Kuten usein, datan laatu voi hyvinkin olla tärkein taustasyy.
Stable Diffusionin ja DALL-E 2:n kaltaisia kuvansynteesijärjestelmiä ruokkivat avoimen lähdekoodin tietokannat tarjoavat monia tunnisteita sekä yksittäisille ihmisille että ihmisten väliselle toiminnalle. Tunnisteet opitaan yhdessä niihin liittyvien kuvien tai kuvanosien kanssa.

Stable Diffusionin käyttäjät voivat tutkia malliin opittuja käsitteitä hakemalla järjestelmän käyttämästä LAION-aesthetics-aineistosta, joka on suuremman LAION 5B:n osajoukko. Kuvia ei järjestetä tunnisteiden aakkosjärjestyksessä vaan esteettisen pistemäärän mukaan. Lähde: https://rom1504.github.io/clip-retrieval/
Ihmiskäsivarren kuvaamiseen osallistuvien yksittäisten tunnisteiden ja luokkien hyvä hierarkia voisi olla esimerkiksi body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

Käden osien hienojakoinen semanttinen segmentointi. Jopa tämä poikkeuksellisen tarkka erittely jättää jokaisen sormen yhdeksi kokonaisuudeksi eikä huomioi sormen kolmea tai peukalon kahta osaa. Lähde: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
Todellisuudessa lähdekuvien näin johdonmukainen merkintä koko aineistossa on epätodennäköistä. Ohjaamattomat tunnistusalgoritmit pysähtyvät luultavasti ylemmälle tasolle, esimerkiksi käteen, ja jättävät sen sisäiset pikselit – jotka teknisesti sisältävät sormitietoa – merkitsemättömäksi massaksi. Siitä piirteet johdetaan mielivaltaisesti ja voivat myöhemmissä kuvissa näkyä häiritsevänä osana.

Miltä pitäisi näyttää (ylhäällä oikealla, ellei kyse ole yläkoukusta) ja miltä yleensä näyttää (alhaalla oikealla), koska resursseja merkintään on vähän tai arkkitehtuuri ei hyödynnä aineistossa mahdollisesti olevia tunnisteita riittävästi.
Jos latenttidiffuusiomalli pääsee käsivarren generointiin asti, se yrittää lähes varmasti tehdä käsivarren päähän ainakin käden, koska arm>hand on tarvittava vähimmäishierarkia, varsin korkealla siinä, mitä arkkitehtuuri tietää ihmisen anatomiasta.
Sen jälkeen sormet saattavat olla pienin ryhmä, vaikka ihmiskäden esittämisessä pitäisi huomioida vielä 14 sormen ja peukalon alaosaa.
Jos teoria pitää paikkansa, varsinaista korjauskeinoa ei ole: alalla puuttuu rahaa käsin tehtävään annotointiin, eikä riittävän tehokkaita, pienen virhemäärän tuottavia automaattisen merkinnän algoritmeja ole. Malli saattaa nykyisin nojata ihmisen anatomian johdonmukaisuuteen peittääkseen koulutusaineistonsa puutteita.
Yksi mahdollinen syy siihen, miksi se ei voi nojata tähän, esitettiin hiljattain Stable Diffusionin Discordissa: malli voi sekoittaa realistisen ihmiskäden oikean sormimäärän, koska LAION-pohjaisessa tietokannassa on piirroshahmoja, joilla on vähemmän sormia. Se on itsessään työtä säästävä oikotie).

Kaksi mahdollista syyllistä Stable Diffusionin ja vastaavien mallien puuttuvien sormien ongelmaan. Alla piirroshahmojen käsiä Stable Diffusionin käyttämästä LAION-aesthetics-aineistosta. Lähde: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Jos tämä pitää paikkansa, ainoa ilmeinen ratkaisu on mallin uudelleenkoulutus siten, että epärealistinen ihmispohjainen sisältö poistetaan ja todelliset poikkeukset, esimerkiksi amputoidut ihmiset, merkitään asianmukaisesti poikkeuksiksi. Jo pelkästään datan kuratoinnin kannalta tämä olisi vaikea tehtävä, etenkin vähäresurssiselle yhteisölle.
Toinen lähestymistapa olisi estää suodattimilla tällaisen sisällön, esimerkiksi kolmi- tai viisisormisen käden, muodostuminen generoinnin aikana samaan tapaan kuin OpenAI on jossain määrin suodattanut GPT-3:n ja DALL-E 2tuloksia, jolloin niiden tuotoksia voidaan säädellä kouluttamatta lähdemalleja uudelleen.

Stable Diffusionissa sormien ja jopa raajojen semanttiset erot voivat hämärtyä kauhistuttavasti ja tuoda mieleen esimerkiksi David Cronenbergin 1980-luvun ruumiskauhuelokuvat. Lähde: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Tämäkin vaatisi kuitenkin tunnisteita, joita ei ehkä ole kaikissa asiaan liittyvissä kuvissa. Jäljelle jäisi sama logistinen ja taloudellinen haaste.
Voisi väittää, että vaihtoehtoja jää kaksi: ongelmaan lisätään dataa tai käytetään kolmannen osapuolen tulkintajärjestelmiä, jotka puuttuvat tässä kuvattuihin fyysisiin virheisiin ennen niiden näyttämistä loppukäyttäjälle. Jälkimmäinen antaisi ainakin OpenAI:lle tavan hyvittää ruumiskauhuksi muuttuneet kuvat, jos yritys haluaisi niin tehdä.
3: Mukauttaminen
Yksi Stable Diffusionin tulevaisuuden kiehtovimmista mahdollisuuksista on käyttäjien tai organisaatioiden kehittämät muokatut järjestelmät. Niihin voitaisiin sisällyttää valmiiksi koulutetun LAION-piirin ulkopuolista sisältöä, ihannetapauksessa ilman koko mallin uudelleenkoulutuksen hallitsematonta hintaa tai riskiä, joka syntyy lisättäessä paljon uusia kuvia valmiiseen, kypsään ja kykenevään malliin.
Vertaus: jos 30 oppilaan edistyneelle luokalle tulee kaksi vähemmän lahjakasta oppilasta, he joko sopeutuvat ja kurovat eron kiinni tai jäävät poikkeuksiksi. Kummassakaan tapauksessa luokan keskimääräinen suoritus ei luultavasti muutu. Jos uusia vähemmän lahjakkaita oppilaita tulee 15, koko luokan arvosanajakauma todennäköisesti heikkenee.
Samoin pitkän ja kalliin koulutuksen aikana rakentunut yhteistoiminnallinen ja melko herkkä suhdeverkko voi vaurioitua tai joissakin tapauksissa käytännössä tuhoutua liiallisesta uudesta datasta. Mallin tulosten laatu heikkenee silloin kauttaaltaan.
Menettely on perusteltua lähinnä silloin, kun halutaan ottaa mallin käsitteellinen ymmärrys suhteista ja asioista kokonaan omaan käyttöön ja tuottaa yksinomaan lisättyä aineistoa muistuttavaa sisältöä.
Niinpä 500 000 Simpsons -ruudun kouluttaminen olemassa olevaan Stable Diffusion -tarkistuspisteeseen tuottaa luultavasti lopulta paremman Simpsons -simulaattorin kuin alkuperäinen versio. Tämä edellyttää, että tarpeeksi laajoja semanttisia suhteita säilyy prosessissa, esimerkiksi Homer Simpson eating a hotdog. Tällainen kehote voi tarvita hot dogeja koskevaa aineistoa, jota lisädatassa ei ollut mutta joka tarkistuspisteessä jo oli. Lisäksi oletuksena on, ettet halua yhtäkkiä vaihtaa Simpsons -sisällöstä kehotteen fabulous landscape by Greg Rutkowski mukaiseen kuvaan. Lisäkoulutuksen läpikäyneen mallin huomio on ohjattu voimakkaasti muualle, eikä se enää tee tällaista yhtä hyvin kuin aiemmin.
Huomionarvoinen esimerkki on waifu-diffusion, joka on onnistuneesti jatkokouluttanut 56 000 animekuvaa valmiiseen, koulutettuun Stable Diffusion -tarkistuspisteeseen. Harrastajalle tehtävä on vaikea, sillä malli vaatii vähintään huimat 30 gigatavua näyttömuistia, paljon enemmän kuin NVIDIAn tulevien 40XX-sarjan kuluttajajulkaisujen odotetaan tarjoavan.

Oman sisällön kouluttaminen Stable Diffusioniin waifu-diffusionin avulla: malli vaati kaksi viikkoa jatkokoulutusta saavuttaakseen tämän kuvitustason. Vasemmanpuoleiset kuusi kuvaa näyttävät, miten malli oppi koulutuksen edetessä tuottamaan uuden aineiston pohjalta aiheeltaan yhtenäisiä tuloksia. Lähde: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Stable Diffusionin tarkistuspisteiden tällaisiin haaroihin voidaan käyttää valtavasti työtä, joka sitten kompastuu tekniseen velkaan. Virallisen Discordin kehittäjät ovat jo kertoneet, etteivät myöhemmät tarkistuspisteet välttämättä ole taaksepäin yhteensopivia edes aiemmissa versioissa toimineiden kehotteiden logiikan kanssa. Ensisijainen tavoite on paras mahdollinen malli, ei vanhojen sovellusten ja prosessien tukeminen.
Siksi tarkistuspisteestä kaupallisen tuotteen haarauttavalla yrityksellä tai yksityishenkilöllä ei käytännössä ole paluureittiä. Versio on siinä vaiheessa erillinen, yhteensopimaton haara, joka ei pysty hyödyntämään stability.ai-yhtiön myöhempien julkaisujen parannuksia. Sitoumus on melkoinen.
Tällä hetkellä suurempaa toivoa mukauttamiseen tarjoaa Textual Inversion. Siinä käyttäjä kouluttaa pienen joukon CLIP-yhteensovitettuja kuvia.

Tel Avivin yliopiston ja NVIDIAn yhteistyönä kehitetty Textual Inversion mahdollistaa erillisten uusien kohteiden opettamisen tuhoamatta lähdemallin kykyjä. Lähde: https://textual-inversion.github.io/
Textual Inversionin ilmeinen päärajoitus on, että kuvamääräksi suositellaan hyvin vähän, jopa vain viittä. Näin syntyy rajallinen kohde, joka voi sopia tyylinsiirtoon paremmin kuin fotorealististen esineiden lisäämiseen.
Stable Diffusionin eri Discord-yhteisöissä kokeillaan kuitenkin parhaillaan paljon suurempia koulutuskuvamääriä, ja menetelmän hyödyllisyys jää nähtäväksi. Tekniikka vaatii jälleen paljon näyttömuistia, aikaa ja kärsivällisyyttä.
Rajoittavien tekijöiden vuoksi saatamme joutua odottamaan kehittyneempiä harrastajien Textual Inversion -kokeita. Samalla selviää, pystyykö lähestymistapa sijoittamaan käyttäjän kuvaan Photoshopin leikkaa ja liimaa -menetelmää uskottavammin säilyttäen virallisten tarkistuspisteiden hämmästyttävän toiminnallisuuden.
Julkaistu ensimmäisen kerran 6. syyskuuta 2022.


