
Μοντέλα και πλατφόρμες AI
Mistral 7B: Νέα σημεία αναφοράς πέρα από το Llama 2 στον χώρο του ανοικτού κώδικα

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Βασικά σημείαΤο μοντέλο 7B της Mistral AI ξεπερνά το μοντέλο 13B της Llama 2 σε όλα τα σημεία…
Δείτε περισσότερα
- Το μοντέλο 7B της Mistral AI ξεπερνά το μοντέλο 13B της Llama 2 σε όλα τα σημεία αναφοράς με μεγαλύτερη υπολογιστική αποδοτικότητα.
- Το μοντέλο χρησιμοποιεί την τεχνική της ομαδοποιημένης προσοχής ερωτημάτων (Grouped-query attention) για εξισορρόπηση ταχύτητας και ποιότητας, μια σημαντική τεχνική καινοτομία.
- Η άδεια Apache 2.0 προσφέρει πρωτοφανή ευελιξία ανάπτυξης για οποιονδήποτε χρήστη χωρίς περιοριστικούς εμποδισμούς.
Τα Μεγάλα Γλωσσικά Μοντέλα (LLMs) έχουν πρόσφατα καταλάβει την κεντρική σκηνή, χάρη σε εξαιρετικές επιδόσεις όπως το ChatGPT. Όταν η Meta εισήγαγε τα μοντέλα Llama, αυτό ξαναέδωσε ζωή στο ενδιαφέρον για τα ανοικτά LLMs. Ο στόχος; Να δημιουργηθούν προσιτά, ανοικτά LLMs που είναι τόσο καλά όσο τα κορυφαία μοντέλα όπως το GPT-4, αλλά χωρίς το υψηλό κόστος ή την πολυπλοκότητα.
Αυτό το μείγμα προσιότητας και αποδοτικότητας άνοιξε όχι μόνο νέους δρόμους για ερευνητές και προγραμματιστές, αλλά και έθεσε τη σκηνή για μια νέα εποχή τεχνολογικών προόδων στην επεξεργασία φυσικής γλώσσας.
Πρόσφατα, οι νεοφυείς επιχειρήσεις παραγωγικής τεχνητής νοημοσύνης έχουν προσελκύσει σημαντική χρηματοδότηση. Η Together συγκέντρωσε 20 εκατομμύρια δολάρια, με στόχο να διαμορφώσουν τα ανοικτά AI. Η Anthropic συγκέντρωσε επίσης το εντυπωσιακό ποσό των 450 εκατομμυρίων δολαρίων, και η Cohere, σε συνεργασία με τη Google Cloud, εξασφάλισε 270 εκατομμύρια δολάρια τον Ιούνιο αυτό το χρόνο.
Εισαγωγή στο Mistral 7B: Μέγεθος & Διαθεσιμότητα

Το Mistral AI, που εδρεύει στο Παρίσι και ιδρύθηκε από πρώην στελέχη της DeepMind της Google και της Meta, ανακοίνωσε το πρώτο του μεγάλο γλωσσικό μοντέλο: Mistral 7B. Αυτό το μοντέλο μπορεί να κατεβαστεί εύκολα από οποιονδήποτε από το GitHub και ακόμη μέσω ενός 13.4-gigabyte torrent.
Αυτή η εταιρεία κατάφερε να εξασφαλίσει ρεκόρ χρηματοδότησης ακόμη και πριν από την κυκλοφορία του προϊόντος. Το πρώτο μοντέλο του Mistral AI με 7 δισεκατομμύρια παραμέτρους υπερβαίνει τις επιδόσεις του Llama 2 13B σε όλες τις δοκιμές και ξεπερνά το Llama 1 34B σε πολλά μετρικά.
Σε σύγκριση με άλλα μοντέλα όπως το Llama 2, το Mistral 7B παρέχει παρόμοιες ή καλύτερες ικανότητες με μικρότερη υπολογιστική επιβάρυνση. Ενώ τα θεμελιώδη μοντέλα όπως το GPT-4 μπορούν να επιτύχουν περισσότερα, έρχονται με υψηλότερο κόστος και δεν είναι τόσο φιλικά προς τον χρήστη, επειδή είναι κυρίως προσβάσιμα μέσω API.
Όταν πρόκειται για εργασίες κωδικοποίησης, το Mistral 7B ανταγωνίζεται το CodeLlama 7B στις επιδόσεις. Επιπλέον, είναι αρκετά συμπαγές σε 13.4 GB για να τρέξει σε τυπικές μηχανές.
Επιπλέον, το Mistral 7B Instruct, που έχει ρυθμιστεί ειδικά για σύνολα δεδομένων οδηγιών στο Hugging Face, έχει δείξει εξαιρετικές επιδόσεις. Ξεπερνά άλλα μοντέλα 7B στο MT-Bench και στέκεται ώμο με ώμο με τα 13B chat μοντέλα.

Hugging Face Mistral 7B — Παράδειγμα
Συγκριτική αξιολόγηση επιδόσεων
Σε μια λεπτομερή ανάλυση επιδόσεων, το Mistral 7B μετρήθηκε ενάντια στα μοντέλα Llama 2. Τα αποτελέσματα ήταν σαφή: το Mistral 7B υπερβαίνει σημαντικά το Llama 2 13B σε όλους τους δείκτες. Πράγματι, ταιριάζει με τις επιδόσεις του Llama 34B, ιδιαίτερα ξεχωρίζοντας σε δείκτες κώδικα και συλλογισμού.
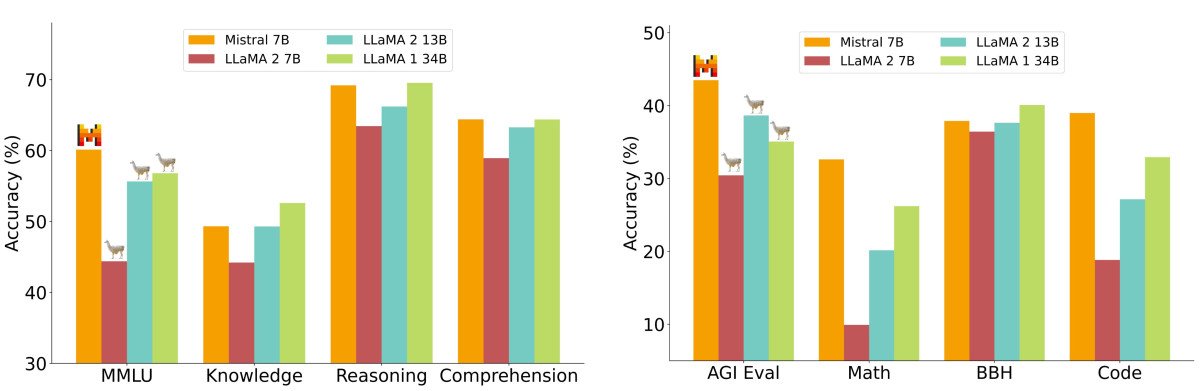
Οι δείκτες οργανώθηκαν σε διάφορες κατηγορίες, όπως Κοινή Λογική, Παγκόσμια Γνώση, Κατανόηση Ανάγνωσης, Μαθηματικά και Κώδικας, μεταξύ άλλων. Μια ιδιαίτερα αξιοσημείωτη παρατήρηση ήταν το μετρικό κόστους-επιδόσεων του Mistral 7B, που ονομάζεται «ισοδύναμο μέγεθος μοντέλου». Σε περιοχές όπως ο συλλογισμός και η κατανόηση, το Mistral 7B έδειξε επιδόσεις παρόμοιες με ένα μοντέλο Llama 2 τρεις φορές μεγαλύτερο, υποδηλώνοντας πιθανές οικονομίες σε μνήμη και αύξηση της απόδοσης. Ωστόσο, στους δείκτες γνώσης, το Mistral 7B ευθυγραμμίστηκε στενά με το Llama 2 13B, το οποίο πιθανότατα οφείλεται στις περιορισμένες παραμέτρους που επηρεάζουν την συμπίεση γνώσης.
Τι πραγματικά κάνει το μοντέλο Mistral 7B καλύτερο από τα περισσότερα άλλα Γλωσσικά Μοντέλα;
Απλοποίηση των Μηχανισμών Προσοχής
Ενώ οι λεπτομέρειες των μηχανισμών προσοχής είναι τεχνικές, η θεμελιώδης ιδέα είναι σχετικά απλή. Φανταστείτε να διαβάζετε ένα βιβλίο και να υπογραμμίζετε σημαντικές προτάσεις· αυτό είναι ανάλογο με τον τρόπο που οι μηχανισμοί προσοχής «υπογραμμίζουν» ή δίνουν σημασία σε συγκεκριμένα δεδομένα σε μια ακολουθία.
Στο πλαίσιο των γλωσσικών μοντέλων, αυτοί οι μηχανισμοί επιτρέπουν στο μοντέλο να εστιάσει στις πιο σχετικές περιοχές των εισοδικών δεδομένων, εξασφαλίζοντας ότι η έξοδος είναι συνεπής και ακριβής ως προς το πλαίσιο.
Στους τυπικούς μετασχηματιστές, οι βαθμοί προσοχής υπολογίζονται με τον τύπο:

Τύπος προσοχής μετασχηματιστών
Ο τύπος για αυτούς τους βαθμούς περιλαμβάνει ένα κρίσιμο βήμα – τον πολλαπλασιασμό των πινάκων Q και K. Η πρόκληση εδώ είναι ότι καθώς το μήκος της ακολουθίας αυξάνεται, και οι δύο πίνακες επεκτείνονται αναλόγως, οδηγώντας σε μια υπολογιστικά εντατική διαδικασία. Αυτή η ανησυχία για κλιμάκωση είναι ένας από τους κύριους λόγους για τους οποίους οι τυπικοί μετασχηματιστές μπορούν να είναι αργοί, ιδιαίτερα όταν αντιμετωπίζουν μεγάλες ακολουθίες.

Η προσοχή πολλαπλών ερωτημάτων (MQA) ταχύνει τα πράγματα χρησιμοποιώντας ένα σύνολο ‘κλειδιών-τιμών’ κεφαλών, αλλά μερικές φορές θυσιάζει την ποιότητα. Τώρα, μπορείτε να σκεφτείτε, γιατί δεν συνδυάζουμε την ταχύτητα της MQA με την ποιότητα της πολυκεφαλικής προσοχής; Αυτό είναι όπου έρχεται η Ομαδοποιημένη Προσοχή Ερωτήματος (GQA).
Ομαδοποιημένη Προσοχή Ερωτήματος (GQA)

Ομαδοποιημένη Προσοχή Ερωτήματος
Η GQA είναι μια ενδιάμεση λύση. Αντί να χρησιμοποιεί μόνο μία ή πολλές κεφαλές κλειδιών-τιμών, τις οργανώνει σε ομάδες. Με αυτόν τον τρόπο, η GQA επιτυγχάνει απόδοση κοντά στη λεπτομερή πολυκεφαλική προσοχή, αλλά με την ταχύτητα της MQA. Για μοντέλα όπως το Mistral, αυτό σημαίνει αποτελεσματική απόδοση χωρίς να θυσιάζεται πολύ στην ποιότητα.
Προσοχή συρόμενου παραθύρου (SWA)

Το συρόμενο παράθυρο είναι μια άλλη μέθοδος που χρησιμοποιείται στη επεξεργασία ακολουθιών προσοχής. Αυτή η μέθοδος χρησιμοποιεί ένα σταθερό μέγεθος παραθύρου προσοχής γύρω από κάθε token στην ακολουθία. Με πολλαπλά στρώματα που στοιβάζουν αυτήν την προσοχή, τα ανώτερα στρώματα τελικά αποκτούν μια ευρύτερη προοπτική, που περιλαμβάνει πληροφορίες από όλη την είσοδο. Αυτή η μέθοδος είναι ανάλογη με τα πεδία υποδοχής που παρατηρούνται στα Συνελικτικά Νευρωνικά Δίκτυα (CNNs).
Από την άλλη πλευρά, η «διατεταμένη προσοχή συρόμενου παραθύρου» του μοντέλου Longformer, που είναι εννοιολογικά παρόμοια με τη μέθοδο συρόμενου παραθύρου, υπολογίζει μόνο μερικές διαγώνιες του πίνακα. Αυτή η αλλαγή οδηγεί σε αύξηση της χρήσης μνήμης που αυξάνεται γραμμικά και όχι τετραγωνικά, καθιστώντας την μια πιο αποτελεσματική μέθοδο για μεγαλύτερες ακολουθίες.
Διαφάνεια του Mistral AI vs. Προβλήματα Ασφάλειας στη Αποκέντρωση
Στην ανακοίνωσή τους, το Mistral AI τόνισε επίσης τη διαφάνεια με την αναφορά: «Χωρίς κόλπα, χωρίς ιδιόκτητα δεδομένα». Αλλά ταυτόχρονα, το μόνο διαθέσιμο μοντέλο τους αυτή τη στιγμή, το ‘Mistral-7B-v0.1’, είναι ένα προ-εκπαιδευμένο βασικό μοντέλο, και επομένως μπορεί να παράγει μια απάντηση σε οποιαδήποτε ερώτηση χωρίς φιλτράρισμα περιεχομένου, το οποίο δημιουργεί πιθανές ανησυχίες ασφάλειας. Ενώ μοντέλα όπως το GPT και το Llama έχουν μηχανισμούς για να καταλάβουν πότε να απαντήσουν, κακόβουλοι χρήστες θα μπορούσαν να εκμεταλλευτούν την πλήρως αποκεντρωμένη φύση του Mistral.
Ωστόσο, η αποκέντρωση των Μεγάλων Γλωσσικών Μοντέλων έχει τα πλεονεκτήματά της. Ενώ κάποιοι θα μπορούσαν να την εκμεταλλευτούν, οι άνθρωποι μπορούν να την αξιοποιήσουν για κοινωνικό καλό και να κάνουν την ευφυΐα προσβάσιμη σε όλους.
Ευελιξία ανάπτυξης και χρήσης
Ένα από τα πιο σημαντικά χαρακτηριστικά είναι ότι το Mistral 7B είναι διαθέσιμο με την άδεια Apache 2.0. Αυτό σημαίνει ότι δεν υπάρχουν πραγματικά εμπόδια για τη χρήση του – είτε το χρησιμοποιείτε για προσωπικούς σκοπούς, είτε για μια μεγάλη εταιρεία, είτε ακόμη και για μια κυβερνητική οντότητα. Απλά χρειάζεστε το σωστό σύστημα για να το τρέξετε, ή μπορεί να πρέπει να επενδύσετε σε πόρους cloud.
Ενώ υπάρχουν άλλες άδειες όπως η απλή άδεια MIT και η συνεργατική άδεια CC BY-SA-4.0, που απαιτεί αναφορά δημιουργού και παρόμοια άδεια για παράγωγα, η άδεια Apache 2.0 παρέχει μια ισχυρή βάση για μεγάλης κλίμακας επιχειρήσεις.
Τελικές Σκέψεις
Η άνοδος των ανοικτών Μεγάλων Γλωσσικών Μοντέλων όπως το Mistral 7B σηματοδοτεί μια σημαντική στροφή στη βιομηχανία AI, καθιστώντας τα υψηλής ποιότητας γλωσσικά μοντέλα προσβάσιμα σε ένα ευρύτερο κοινό. Οι καινοτόμες προσεγγίσεις του Mistral AI, όπως η Ομαδοποιημένη Προσοχή Ερωτήματος και η Προσοχή συρόμενου παραθύρου, υπόσχονται αποτελεσματική απόδοση χωρίς να θυσιάζουν την ποιότητα.
Ενώ η αποκεντρωμένη φύση του Mistral δημιουργεί ορισμένες προκλήσεις, η ελαστικότητα και η ανοικτή άδεια του υπογραμμίζουν το δυναμικό για εκδημοκρατισμό της τεχνητής νοημοσύνης. Όσο εξελίσσεται το τοπίο, η εστίαση θα είναι αναπόφευκτα στη βελτίωση της ισορροπίας μεταξύ της δύναμης αυτών των μοντέλων και των ηθικών συνεπαγωγών και μηχανισμών ασφάλειας.
Τι έρχεται επόμενο για το Mistral; Το μοντέλο 7B ήταν μόνο η αρχή. Η ομάδα στοχεύει να κυκλοφορήσει ακόμη μεγαλύτερα μοντέλα σύντομα. Αν αυτά τα νέα μοντέλα ταιριάζουν με τις επιδόσεις του 7B, το Mistral μπορεί να ανέβει γρήγορα ως ένας από τους κορυφαίους παίκτες στη βιομηχανία, όλα μέσα στο πρώτο έτος.


